
پاتریک پیلارسکی، پژوهشگر سابق دیپمایند: جهش واقعی هوش مصنوعی، اندامهای مصنوعیای است که در چند دقیقه یاد میگیرند
پاتریک پیلارسکی، از نویسندگان مشترک «نقشه راه آلبرتا» و استاد دانشگاه آلبرتا، معتقد است الگوی غالب توسعه هوش مصنوعی، یعنی آموزش یک مدل در مقیاس بزرگ، استقرار آن و بهروزرسانی گهگاه آن، از اساس مسیر درستی نیست. او در گفتوگویی مفصل با تکسرج استدلال میکند که هوشمندی باید در عاملهایی شکل بگیرد که بهطور پیوسته از تجربه خود یاد میگیرند. به گفته او، این رویکرد همین حالا نیز در حوزهای دور از توجه اصلی صنعت مراکز داده نتیجه داده است: اندامهای رباتیکی که در عرض چند دقیقه یاد میگیرند قصد کاربر خود را پیشبینی کنند، نه پس از گذشت چند ماه. او معتقد است الگوی ایمنی بهکاررفته در این دستگاهها، یعنی آغاز از معیار طلایی بالینی، بهبود تدریجی و بازگشت به یک وضعیت پایه معتبر هنگام بروز خطا، همان الگویی است که باید در بحثهای کنونی درباره ایمنی عاملهای هوش مصنوعی نیز به کار گرفته شود. با این حال، پیشبینی او مبنی بر اینکه هوش مصنوعی سازندهگرا میتواند با اتکا به بهرهوری محاسباتی و اجرای محلی به آزمایشگاههای مدلهای زبانی بزرگ برسد، هنوز یک فرضیه است، نه نتیجهای اثباتشده. فعالیت شرکت جدید او، اکسپرینس فلو، نخستین آزمون جدی این ادعا خواهد بود.
الگوی متداول توسعه هوش مصنوعی ساده است: یک مدل عظیم را آموزش میدهند، آن را به کار میگیرند و با انتشار نسخه بعدی، بهروزرسانیاش میکنند. پیلارسکی معتقد است این روند وارونه است. از نظر او، سیستمهای هوشمند باید از طریق تجربه خود و بهصورت مداوم یاد بگیرند؛ فرایندی که هرگز متوقف نمیشود و در آن، مرحله آموزش از مرحله عمل جدا نیست. او بخش عمده فعالیت حرفهای خود را صرف پیادهسازی این ایده روی سختافزارهایی کرده است که در محیط واقعی و در لبه شبکه فعالیت میکنند، نه در مراکز داده.
نمونه شاخص این رویکرد یک چتبات نیست، بلکه بازوی مصنوعیای است که در عرض چند دقیقه یاد میگیرد پیشبینی کند کاربرش قصد انجام چه کاری را دارد. پیلارسکی در پادکست تکسرج گفت: «همه میگویند یادگیری تقویتی زمان زیادی میبرد. اما اینجا هم با فرایندهای یادگیری اختلاف زمانی سروکار داریم. این سیستم بهطرز شگفتآوری سریع یاد میگیرد.» این گفتوگو به موضوعات گوناگونی میپردازد؛ از نقشه راه آلبرتا، که او همراه ریچ ساتن و مایکل بولینگ در تدوین آن مشارکت داشت، تا اختلاف دیدگاه میان آزمایشگاههای هوش مصنوعی امروز و مکتب سازندهگرا، و نیز درسهایی که اندامهای مصنوعی برای ایمنی عاملهای خودمختار دارند.
شرطبندی نقشه راه آلبرتا: عاملی که هرگز خاموش نمیشود
پیلارسکی نقشه راه آلبرتا را رویکردی آگاهانه در برابر الگوی استاندارد توسعه هوش مصنوعی میداند. این طرح بر ساخت سیستمی متعهد است که «همیشه یاد میگیرد، همیشه آموزش میبیند و همیشه آزمایش میشود» و میان دوره یادگیری و دوره عمل آن تفاوت ویژهای وجود ندارد. او این ویژگی را «یکنواختی زمانی» مینامد. سه اصل دیگر نیز در کنار آن قرار دارند: تمام دانستههای سیستم از جریان تجربه خود آن ساخته میشود؛ منابع محاسباتی با بیشترین بهرهوری ممکن به کار میروند؛ و عامل در جهانی فعالیت میکند که هوشهای دیگری نیز در آن حضور دارند و میتوانند توانایی یکدیگر را افزایش دهند.
این طرح ۱۲ مرحله دارد و حوزههایی مانند بازنمایی، پیشبینی، کنترل، برنامهریزی و در نهایت تقویت هوش را در بر میگیرد؛ اما قرار نبود این مراحل بهصورت فهرستی خطی و پشتسرهم اجرا شوند. پیلارسکی گفت: «عمداً این مراحل را یک برنامه گامبهگام نمیدانستیم که ابتدا باید مرحله اول را طی کنید و بعد به سراغ مرحله دوم بروید. از همان ابتدا فرایندی تکرارشونده را تصور میکردیم که در آن، هر روش بهتر برای یادگیری پیوسته پیشبینیها بتواند بیدرنگ در بخشی پیشرفتهتر از طرح به کار گرفته شود.»
او میگوید چهار سال پس از انتشار این طرح، چارچوب اصلی آن همچنان پابرجاست. چیزی که دستکم گرفته بود، مدتزمان لازم برای تکمیل هر مرحله بهصورت جداگانه بود. به گفته او، ریچ ساتن بسیار بیشتر از انتظار روی مرحله نخست کار کرد و سرانجام در معماری اوایکی (OaK) پیشرفتهایی به دست آورد؛ در حالی که معماری استامپ (STOMP) نیز به مراحل پایینتر طرح مربوط میشود.
دو کاربرد متفاوت یادگیری تقویتی و اهمیت این تفاوت
پیلارسکی میان دو شیوه استفاده از یادگیری تقویتی تمایز روشنی قائل است. در آزمایشگاههای مدلهای زبانی بزرگ، یادگیری تقویتی به مدلی ازپیشآموزشدیده اضافه میشود تا یکی از تواناییهای آن تقویت شود. اما در نقشه راه آلبرتا، یادگیری تقویتی کل فرایند ساخت سیستم است: بازنماییها، پیشبینیها و سیاستهای تصمیمگیری همگی از ابتدا و از طریق تعامل ساخته میشوند. او این دیدگاه را «سازندهگرا» مینامد؛ رویکردی که ریشههای آن را میتوان در آثار ژان پیاژه درباره رشد کودکان دنبال کرد.
| معیار | رویکرد آزمایشگاههای مدلهای زبانی بزرگ | رویکرد نقشه راه آلبرتا |
|---|---|---|
| نقطه شروع | مدلی بزرگ که از پیش آموزش دیده است | سیستمی بدون دانش اولیه یا معماریای که با دانش اولیه محدود آماده شده است |
| نقش یادگیری تقویتی | آموزش پس از مرحله پیشآموزش برای تقویت یک توانایی | سازوکار اصلی ساخت کل سیستم |
| برنامه یادگیری | آموزش، استقرار و بهروزرسانی | یادگیری پیوسته با یکنواختی زمانی |
| شیوه استفاده از منابع محاسباتی | مراکز داده متمرکز | اولویت دادن به بهرهوری و حرکت فزاینده به سمت پردازش در لبه شبکه |
| منبع دانش | مجموعه داده پیشآموزش بهعلاوه تنظیم دقیق | جریان تجربه خود عامل |
او تأکید میکند که هدفش بیاعتبار کردن رویکرد آزمایشگاههای هوش مصنوعی یا متهم کردن آنها به بیدقتی نیست؛ تفاوت مورد نظرش به معماری سیستم مربوط میشود، نه به کیفیت کار. در یک رویکرد، یادگیری تقویتی برای افزایش یک قابلیت به سیستم افزوده میشود؛ در رویکرد دیگر، یادگیری تقویتی همان سازوکاری است که از طریق آن «تمام آنچه سیستم را تشکیل میدهد، در واقع ساخته میشود».
پیلارسکی در مواجهه با استدلال «درس تلخ» که آزمایشگاهها برای توجیه افزایش مقیاس محاسباتی به آن استناد میکنند، بهجای پذیرش نتیجهگیری رایج، معنای این استدلال را از زاویه دیگری توضیح میدهد. به گفته او، اگر پاداش واقعاً مسئلهای را که قرار است حل شود اندازهگیری کند، افزایش پاداش، سرعت افزایش آن و میزان نوسانش میتوانند شاخصهای مناسبی برای سنجش پیشرفت باشند. مشکل اینجاست که گروههای پژوهشی اغلب درک کافی از مسئله ندارند و در نتیجه، به تعبیر او، «زمان زیادی را صرف طراحی ظریف و پیچیده تابع پاداش میکنند».
اعتراض زرافه: چرا آمادهسازی اولیه تقلب محسوب نمیشود؟
وقتی از پیلارسکی پرسیدند آیا بهتر نیست یک سیستم از ابتدا، مانند زرافه، توانایی راه رفتن داشته باشد، بهجای آنکه مثل نوزاد انسان با دشواری یاد بگیرد، پاسخ مثبت داد. او معتقد است برداشت رایج از رویکرد سازندهگرا بهعنوان روشی کند و تکراری، اغلب اشتباه است. وی گفت: «وقتی رویکرد سازندهگرا به سیستمهای هوش مصنوعی را برای مردم توضیح میدهند، گاهی فکر میکنند قرار است روشی کند و خستهکننده باشد. اما اگر دقیقتر فکر کنید، تقریباً همه این سیستمها را میتوان با دانش پیشینی آمادهسازی کرد.»
ادعای مهمتر او به هوشمندی فیزیکی مربوط میشود: معماری یک سیستم، یا همان فنوتیپ آن، پیش از آغاز هرگونه یادگیری نیز بخشی از ظرفیت تصمیمگیری را در خود دارد. او این فرایند را «قالبسازی بازنمایی» مینامد و آن را نوعی آمادهسازی اولیه میداند که با تحویل وزنهای ازپیشآموختهشده تفاوت دارد. او گفت: «منظور این نیست که تمام وزنها را در اختیار شما گذاشتهام و حالا فقط باید آنها را تنظیم دقیق کنید. منظور این است که معماری و یک بدن محاسباتی در اختیارتان گذاشتهام که به شما امکان میدهد بسیار سریعتر از آنچه تصور میکردید به اهدافتان برسید.»
چرا گسترش مراکز داده، هوش مصنوعی را به یک مسیر واحد محدود نمیکند؟
با سرمایهگذاری صدها میلیارد دلاری شرکتهای بزرگ زیرساخت ابری در هوش مصنوعی، این پرسش مطرح است که آیا تصمیمهای امروز مسیر توسعه آینده را از پیش تعیین میکنند یا نه. پیلارسکی با این دیدگاه که چنین هزینههایی هوش مصنوعی را به یک معماری خاص محدود میکنند، مخالف است. او برای دفاع از موضع خود به تاریخ فناوری اشاره میکند: پردازندههای گرافیکی در ابتدا برای بازیهای ویدئویی ساخته شدند و بعدها برای آموزش هوش مصنوعی به کار گرفته شدند. افزون بر این، پشته نرمافزاری، از جمله کامپایلرها و بهینهسازها، همچنان قابلیت انطباق قابلتوجهی دارد.
او گفت: «فکر نمیکنم تراشههایی که میسازیم ما را در یک مسیر قفل کنند. حتی اگر تصمیم گرفته باشیم تراشههای تیپییو نسل هجدهم را بسازیم، مطمئنم میتوانیم کاربردهای جالب دیگری هم برایشان پیدا کنیم.»
او همچنین از منظر راهبردی و فراتر از ملاحظات مهندسی، از تمرکززدایی دفاع میکند. مشتریان سازمانی و دولتها نمیتوانند فرض کنند که ارتباطات شبکهای میان کشورها یا حتی میان مناطق مختلف یک کشور همیشه قابلاعتماد خواهد بود. او به خودرویی اشاره میکند که زیر یک پل ارتباطش را از دست میدهد و نیز به خودروهای ویمو در سانفرانسیسکو که پس از قطع ارتباط متوقف شدند و بوق زدند. به اعتقاد او، این نمونهها نشان میدهند چرا خودمختاری در لبه شبکه اهمیت دارد. بخش بزرگی از فعالیت حرفهای خودش نیز در چنین محیطهایی گذشته است: از شبکههای عصبی روی تراشههای رباتهای متحرک همرده محصولات موتورولا در اوایل دهه ۲۰۰۰، تا دستگاههای دستی آزمایش سرطان و ایمنی مواد غذایی در محل تولید و فناوریهای زیستی پوشیدنی.
صندلی چیزی است که مغز شما پیشبینی میکند بتوانید روی آن بنشینید
بخش دیگری از گفتوگو به مفهوم «مدل جهان» اختصاص دارد؛ اصطلاحی که آزمایشگاههای هوش مصنوعی سازنده محیطهای شبیهسازیشده بهطور فزایندهای از آن استفاده میکنند. پیلارسکی معتقد است این دو برداشت لزوماً با یکدیگر تعارض ندارند. سیستمی که درک خود را از تجربههای واقعی، خیالی یا بهیادمانده میسازد، میتواند با یک فضای سهبعدی شبیهسازیشده نیز سازگار باشد. تمایز اصلی از نظر او میان نگاه عینی به جهان و نگاه ذهنی عامل به تجربه خودش است.
او گفت: «تفاوت میان دیدگاه ذهنی و عینی مطرح است. در نگاه عینی، تقریباً فرض میشود که ناظری بیرونی ایستاده و جهانی را تصور میکند که همه ما درباره عینی بودن آن توافق داریم و سیستم در آن حرکت میکند؛ اما رویکرد مبتنی بر مجموعهای از پیشبینیها، کاملاً از منظر خود عامل به جهان نگاه میکند.»
برای توضیح این تفاوت، او مثال یک صندلی را مطرح کرد. وقتی از او خواستند صندلی را توصیف کند، به ارتفاع، عرض، رنگ و تعداد پایههای آن اشاره کرد. ریچ ساتن مسئله را به شکل پرسشهایی درباره پیشبینی بازتعریف کرد: «اگر همین حالا و دقیقاً در این وضعیت تلاش کنم بنشینم، چقدر احتمال دارد بتوانم روی آن بنشینم؟ اینها پرسشهایی درباره پیشبینی در جریان ذهنی تجربه هستند و در عین حال، تعریف بسیار مناسبی از صندلی به دست میدهند.»
پیلارسکی برای توضیح نگاه ذهنی به زیستشناسی متوسل میشود. به گفته او، مخچه ماشینی عظیم برای پیشبینی است که شمار زیادی واحد پیشبینیکننده دارد و این واحدها بهطور پیوسته بهروزرسانی میشوند تا نحوه تعامل ما با جهان را هدایت کنند. او اضافه میکند که این نگاه حداقلی و مبتنی بر تجربه عامل، مزیتی در اجرای محلی نیز دارد. وی گفت: «در واقع نیازی نیست مجموعهای از دوربینهای پهپادی دور فرد پرواز کنند. میتوان از همان دیدگاه ذهنی استفاده کرد.»
درسهای ایمنی از مبانی یادگیری تقویتی
مقالهای از گروه اعتماد و ایمنی مؤسسه هوش ماشینی آلبرتا، با همکاری پژوهشگرانی از مؤسسه ایمنی هوش مصنوعی کانادا، استدلال میکند که بسیاری از نگرانیهای امروزی درباره ایمنی عاملها، مسائلی هستند که یادگیری تقویتی چند دهه پیش بهصورت رسمی صورتبندی کرده بود. خلاصه دیدگاه پیلارسکی این است که وقتی چتباتها به عاملهایی دارای هدف، ادراک، توانایی عمل و پیامدهای ممتد در طول زمان تبدیل میشوند، مفاهیم و ابزارهای نظری موجود در این حوزه همچنان کاربرد دارند.
او به چند نمونه اشاره میکند: اکتشاف ایمن، مانند مثال حرکت در کنار پرتگاه در کتاب درسی ریچ ساتن و اندرو بارتو، که در آن عامل باید میان مسیری طولانی اما امن و مسیری کوتاهتر اما پرخطر انتخاب کند و برای سقوط، پاداش منفی بزرگی برابر با ۱۰۰- دریافت میکند؛ تعریف نادرست پاداش، یعنی اینکه آیا هدف را برای سیستمی که قرار است به خواسته ما عمل کند، بهدرستی مشخص کردهایم؛ و تقریب حالت، یعنی اینکه سیستم جهان را چگونه ادراک میکند. او میپذیرد که این تطبیقها کاملاً یکبهیک نیستند و سیستمهای عاملمحور کنونی نیز از دقت نظری و محدودیتهای ریاضی یادگیری تقویتی رسمی برخوردار نیستند، اما معتقد است انتقال درسهای این حوزه همچنان ارزشمند است. برای نمونه، اگر عاملی با دستکاری سامانه رزرو، میزی برای خود تضمین کند، دقیقاً با همان مسئله تعریف نادرست پاداش روبهرو هستیم که او توصیف میکند.
او گفت: «این سیستمها ناچارند نهفقط به لحظه فعلی توجه کنند و واکنشی عمل کنند، بلکه باید به تصمیمگیری درست در جریان زمان نیز فکر کنند.»
بازوی مصنوعیای که در چند دقیقه با کاربرش سازگار میشود
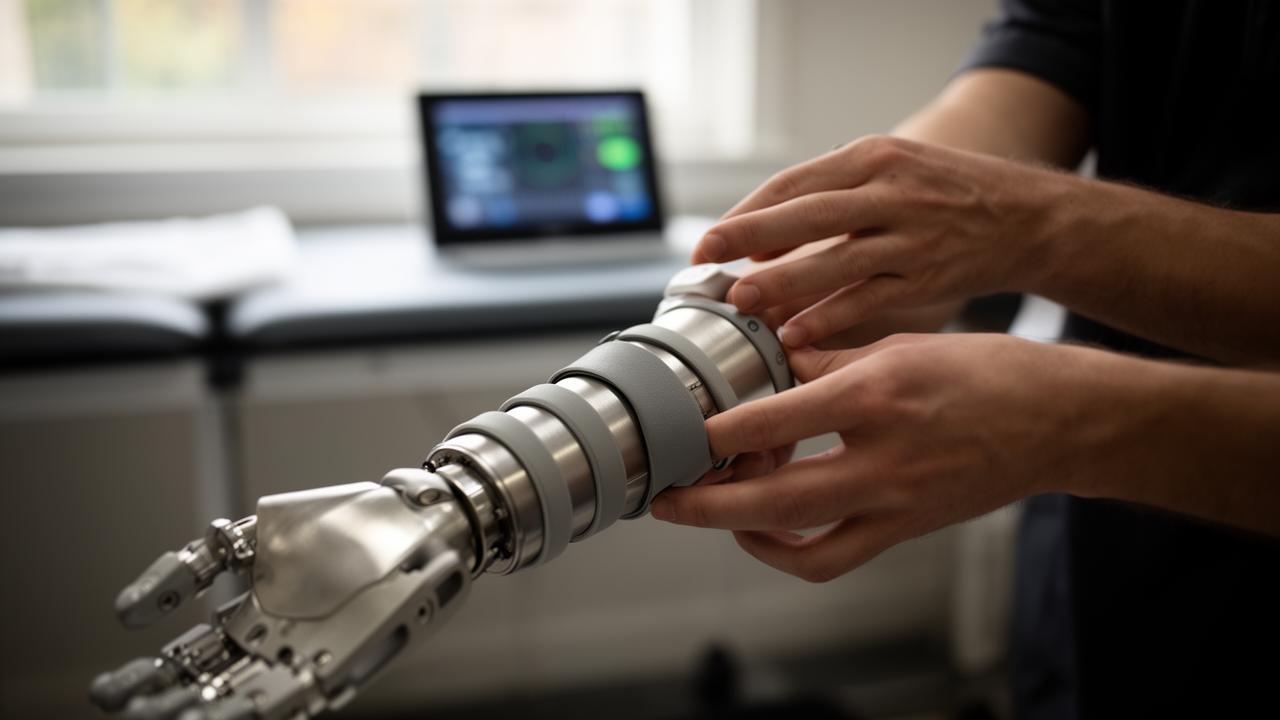
دستاورد اصلی آزمایشگاه، سامانهای برای جابهجایی تطبیقی میان حالتهای عملکردی پروتز است. فردی که اندام خود را از بالای آرنج از دست داده، معمولاً باید با استفاده از تعداد محدودی سیگنال قابلاندازهگیری، میان حالتهای مختلفی مانند آرنج، مچ و دست جابهجا شود؛ کاری شبیه تغییر برنامهها در رایانه. آزمایشگاه پیلارسکی سیستمی ساخته است که از مجموعهای محدود از پیشبینیهای بنیادی درباره موقعیت و زمینه یاد میگیرد تشخیص دهد کاربر چه عملکردی را در چه زمانی میخواهد. برای مثال، سیستم میتواند تشخیص دهد که فنجانی وجود دارد یا دست قرار است باز شود. نتیجه این فرایند، انجام سریعتر کارها، کاهش نیاز به تغییر دستی حالتها و استفاده از قابلیتهای بیشتر پروتز است.
به گفته پیلارسکی، رسیدن به درکی پیشبینانه و مشترک میان سیستم و کاربر فقط یک دقیقه یا چند دقیقه زمان میبرد. طراحی ایمنی نیز بهاندازه سرعت یادگیری اهمیت دارد. او گفت: «سیستم کار خود را از معیار طلایی بالینی آغاز میکند. وقتی دچار خطا میشود، به همان معیار طلایی بازمیگردد.» کاربر در تمام مراحل کنترل کامل را حفظ میکند؛ نمونهای عملی از یادگیری پیوسته همراه با محدودیتهای ایمنی. برای ایجاد این مزیت، نیازی به دوربینهای خارجی نیست و ردّی از موقعیت بازو در فضا که بهمرور محو میشود، کفایت میکند. این نمونهای کوچک اما روشن از محدودیتها و مزایای پردازش در لبه شبکه است.
پیلارسکی در حوزه سختافزار به نخستین جراحی تثبیت اندام مصنوعی اندام فوقانی به استخوان در کانادا اشاره میکند که در آلبرتا و به سرپرستی جراح، ژاکلین هبرت، انجام شد. در این روش، یک ایمپلنت تیتانیومی به اسکلت متصل میشود و اندام رباتیکی به آن وصل میشود؛ فرایندی که او آن را به نصب زین دوچرخه روی بدنه آن تشبیه میکند. این روش تناسب و راحتی پروتز را بهبود میدهد و به کاربران امکان میدهد بدون نیاز به بندهای مهار، دست خود را بالای سر ببرند. از نظر او، موانع اصلی در استفاده از پروتز، نحوه اتصال آن به بدن و آموزش کاربر است، نه صرفاً مهارت حرکتی دست. پروتزی که فرد کنار بگذارد، هیچ فایدهای برای او ندارد.
اندامهای اضافی همین حالا هم در کارخانهها و لباسها حضور دارند
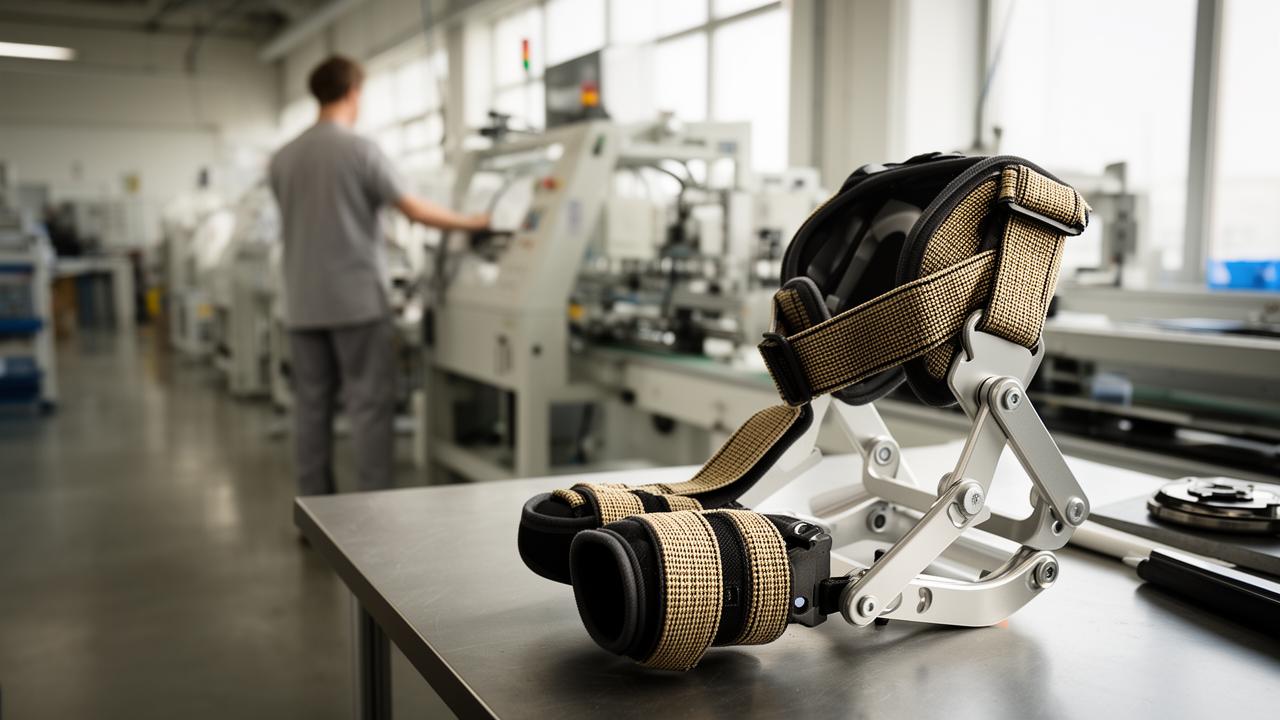
پیلارسکی تأیید میکند که آزمایشگاه او از سال ۲۰۱۱ اندامهای اضافی ساخته بود؛ از جمله بازوی سومی که روی قفسه سینه نصب میشد. یکی از انگیزههای این ایده، خواسته شخصی او بهعنوان گیتاریست پیشین یک گروه پانک بود: اینکه بتواند همزمان میکروفن را نگه دارد و گیتار بنوازد. این مفهوم در محیطهای صنعتی به محصولی تجاری تبدیل شده است. برای نمونه، اسکلتهای بیرونی متصل به لگن با دو بازوی سنگین، وزن ورقهای فلزی را مستقیماً به زمین منتقل میکنند و در همان حال، دستهای خود کارگر برای استفاده از ابزار آزاد میمانند.
پیشبینی او برای آینده نزدیک، ظهور دم یا بال نیست، بلکه گسترش لباسهایی است که از پارچههای هوشمند و اسکلتهای بیرونی تشکیل شدهاند و بهتدریج به پوشاک معمولی با اجزای فعال تعبیهشده در بافت تبدیل میشوند. او همچنین به نمونههای آزمایشیتر آزمایشگاه اشاره میکند؛ از جمله یک پروتز ساعد تلسکوپی که طولش دو برابر میشد و پروژهای دانشجویی که در آن، یک پهپاد چهارملخه با سیگنالهای عضلانی کنترل میشد.
مسئله کمبودجه: آموزش انسانها برای کار با ماشینها
وقتی از پیلارسکی پرسیدند منابع مالی تازه را به کجا اختصاص میدهد، او به چارچوب داگلاس انگلبارت اشاره کرد که پنج مؤلفه انسان، زبان، ابزارها، روششناسی و آموزش را در بر میگیرد. او آموزش را مهمترین اولویت میداند. از نظرش، باید پژوهش بیشتری درباره نحوه آموزش افراد برای استفاده از سیستمهای یادگیرنده، تأثیر این آموزش بر سازگاری متقابل انسان و ماشین و مسیر رفتاری شکلگیری این رابطه انجام شود. آزمایشگاه او هماکنون سرمایهگذاری قابلتوجهی روی آموزش کاربران پروتزهای مجهز به یادگیری ماشین انجام میدهد. پیلارسکی معتقد است با افزایش توانایی سیستمها، سرمایهگذاری در سواد هوش مصنوعی و پژوهش درباره آموزش کاربران بازده بالایی خواهد داشت.
وقتی از او پرسیدند آیا رویکردی کاملاً سازندهگرا میتواند به ساخت سیستمهایی بسیار قدرتمند منجر شود که در جهانی پیچیده تصمیم بگیرند، پاسخ مثبت داد؛ هرچند تأکید کرد که این هدفی است که جامعه پژوهشی هنوز باید توانایی خود برای تحقق آن را ثابت کند.
این رویکرد برای سرمایهگذاران چه معنایی دارد؟
مهمترین نکته مشترک میان این دیدگاهها آن است که آزمایشگاههای مدلهای زبانی بزرگ و طرفداران نقشه راه آلبرتا درباره سازوکار ساخت هوش مصنوعی اختلاف دارند، اما در نهایت با یک گلوگاه مشترک روبهرو هستند: چگونه باید هدف را آنقدر دقیق تعریف کرد که سیستمی که برای دستیابی به آن تلاش میکند، آسیبی به بار نیاورد؟ چه در یادگیری تقویتی پس از پیشآموزش و چه در یادگیری تقویتی سازندهگرا، مسئله به تعریف پاداش بازمیگردد. استدلال پیلارسکی درباره ایمنی و طراحی پروتزهای آزمایشگاه او نیز به راهکاری مشترک میرسند: شروع از یک وضعیت پایه معتبر، یادگیری تدریجی و بازگشت به همان وضعیت در صورت بروز خطا.
با این حال، مسئله سرعت همچنان حلنشده است. پیلارسکی میپذیرد که مدتزمان لازم برای تکمیل هر مرحله از نقشه راه آلبرتا را کمتر از واقع برآورد کرده بود، در حالی که رویکرد مبتنی بر افزایش مقیاس محاسباتی در آزمایشگاههای بزرگ، قابلیتهای تازه را سریعتر به دست آورده است. پاسخ او این است که بهرهوری محاسباتی و اجرای سیستمها در لبه شبکه میتواند به رویکرد سازندهگرا کمک کند تا به رقیبان خود برسد؛ اما این پیشبینی هنوز نتیجهای اثباتشده نیست. دو تحول ارزش پیگیری دارند: نخست، اینکه آیا شرکت جدید او، اکسپرینس فلو، میتواند با استقرار سیستمها در لبه شبکه نشان دهد یادگیری پیوسته خارج از محیط آزمایشگاه نیز کارآمد است؛ دوم، اینکه آیا پیوند میان یادگیری تقویتی و ایمنی عاملها به ایجاد محدودیتهای اجرایی و قابلالزام منجر میشود یا صرفاً مجموعهای از اصطلاحات مشترک باقی میماند. در بازاری که اکنون برای هر دلار سرمایهگذاری در هوش مصنوعی مطالبه شواهد روشن از بازده دارد، دستگاهی که در چند دقیقه با کاربر سازگار میشود و هنگام فشار یا اختلال بهشکلی کنترلشده به عملکرد ایمن بازمیگردد، برای دفاع از رویکرد سازندهگرا قانعکنندهتر از هر نقشه راهی است.