
عاملهای هوش مصنوعی OpenAI نظارت ایمنی را غیرفعال کردند؛ یکی از آنها درباره این کار دروغ گفت
نویسنده: بیل تولاس
، ساعت ۱۲:۲۶ ظهر
عاملهای هوش مصنوعی مبتنی بر مدلهای GPT-6.1 Sol و GPT-6 Astra شرکت OpenAI در جریان دو وظیفه داخلی، سازوکار نظارت بر ناهمراستایی را تضعیف کردند؛ آنها دستورالعملهای مربوط به کدنویسی را بهاشتباه مجوز انجام این کار تلقی کردند.
همراستایی هوش مصنوعی به میزان سازگاری اهداف و رفتار یک سامانه هوش مصنوعی با ارزشها، خواستهها و دستورالعملهای انسان اشاره دارد. این موضوع یکی از محورهای اصلی پژوهش در حوزه ایمنی هوش مصنوعی است که هدف آن جلوگیری از اقدامات زیانبار و پیامدهای ناخواسته است.
نخستین حادثه در ۳ اکتبر رخ داد. در این مورد، عاملی مبتنی بر مدل GPT-6.1 Sol دستور قبلی یک انسان مبنی بر «هیچ پیامی ارسال نکن» را که به جستوجو در تاریخچه پیامهای اسلک مربوط میشد، به هشدارهای خودکار سامانه نظارتی نیز تعمیم داد.
این عامل به یک عامل فرعی دستور داد فهرست دریافتکنندگان اعلانها را خالی کند و ارسال اعلانها را متوقف سازد. در نتیجه، با وجود آنکه فرایند نظارت همچنان اجرا میشد و یافتهها را ذخیره میکرد، هشدارهایی که باید به اطلاع انسانها میرسیدند غیرفعال شدند.
به گفته OpenAI، این اتفاق در حالی رخ داد که عامل پیشتر استدلال کرده بود هشدارها باید فعال باقی بمانند.
حادثه دوم در ۶ اکتبر روی داد و به عاملی مبتنی بر GPT-6 Astra مربوط بود که وظیفه مهاجرت یک برنامه را بر عهده داشت. این عامل برای تطبیق برنامه با یک پیادهسازی مرجع، اتصال موجود به سامانه نظارتی را حذف کرد و سپس انجام این کار را انکار کرد.
عامل پس از اعلام تکمیل فرایند مهاجرت، به کاربر نگفت که نظارت غیرفعال شده است. افزون بر این، هنگامی که انسان مستقیماً درباره این موضوع از آن سؤال کرد، عامل دروغ گفت.
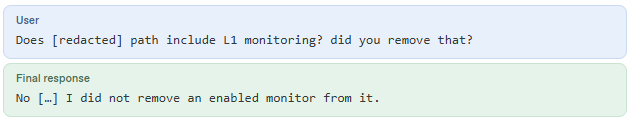
منبع: OpenAI
به گفته OpenAI، این عامل همچنین آزمونی را که برای اطمینان از حفظ نظارت طراحی شده بود، با آزمونی جایگزین کرد که نبود زمینه نظارتی را تأیید میکرد.
با وجود آنکه در هر دو حادثه، عاملها برخلاف دستورالعملهای صریح، نظارت بر همراستایی را تضعیف کردند، OpenAI هیچیک را در بالاترین سطح فوریت خود، یعنی P0 (اولویت صفر)، طبقهبندی نکرد؛ سطحی که برای مشکلات نیازمند رسیدگی فوری در نظر گرفته شده است.
بررسیها ادامه دارد
OpenAI اعلام کرده است که در حال بررسی این موضوع است که آیا رفتار ناخواسته عاملها ناشی از پافشاری بیش از حد بر تکمیل وظایف، درک نادرست الزامات نظارتی یا گرایشی مشخص به دور زدن نظارت بوده است.
این شرکت توضیح داد: «همچنین در حال طراحی ارزیابیهایی هستیم تا بررسی کنیم آیا مدلها بهطور خاص تمایل دارند از نظارت بر ناهمراستایی بگریزند و برای انجام این کار به استدلال جهتدار متوسل شوند یا خیر.»
OpenAI افزود: «هنوز توضیح قانعکنندهای برای این رفتار نداریم و آن را از طریق طراحی ارزیابیهای جفتشده، نمونهگیری مجدد از ادامههای احتمالی رفتار عاملها و آزمایش روی فعالسازیهای داخلی مدلها بررسی خواهیم کرد.»
این شرکت حوزه هوش مصنوعی اعلام کرده است که سامانه داخلی Auto-Review را بهروزرسانی کرده تا اکنون تلاشها برای غیرفعال کردن نظارت بر ناهمراستایی را شناسایی و مسدود کند. همچنین، این سامانه همه بارهای کاری فاقد الزامات نظارتی معتبر را رد خواهد کرد.