
گفتوگو با ریچارد هو از OpenAI؛ چرا تراشه هوش مصنوعی Jalapeño تحولی مهم در این صنعت است؟
زیرعنوان: تراشه تندوتیز OpenAI امیدوارکننده به نظر میرسد
نویسنده: تائه کیم
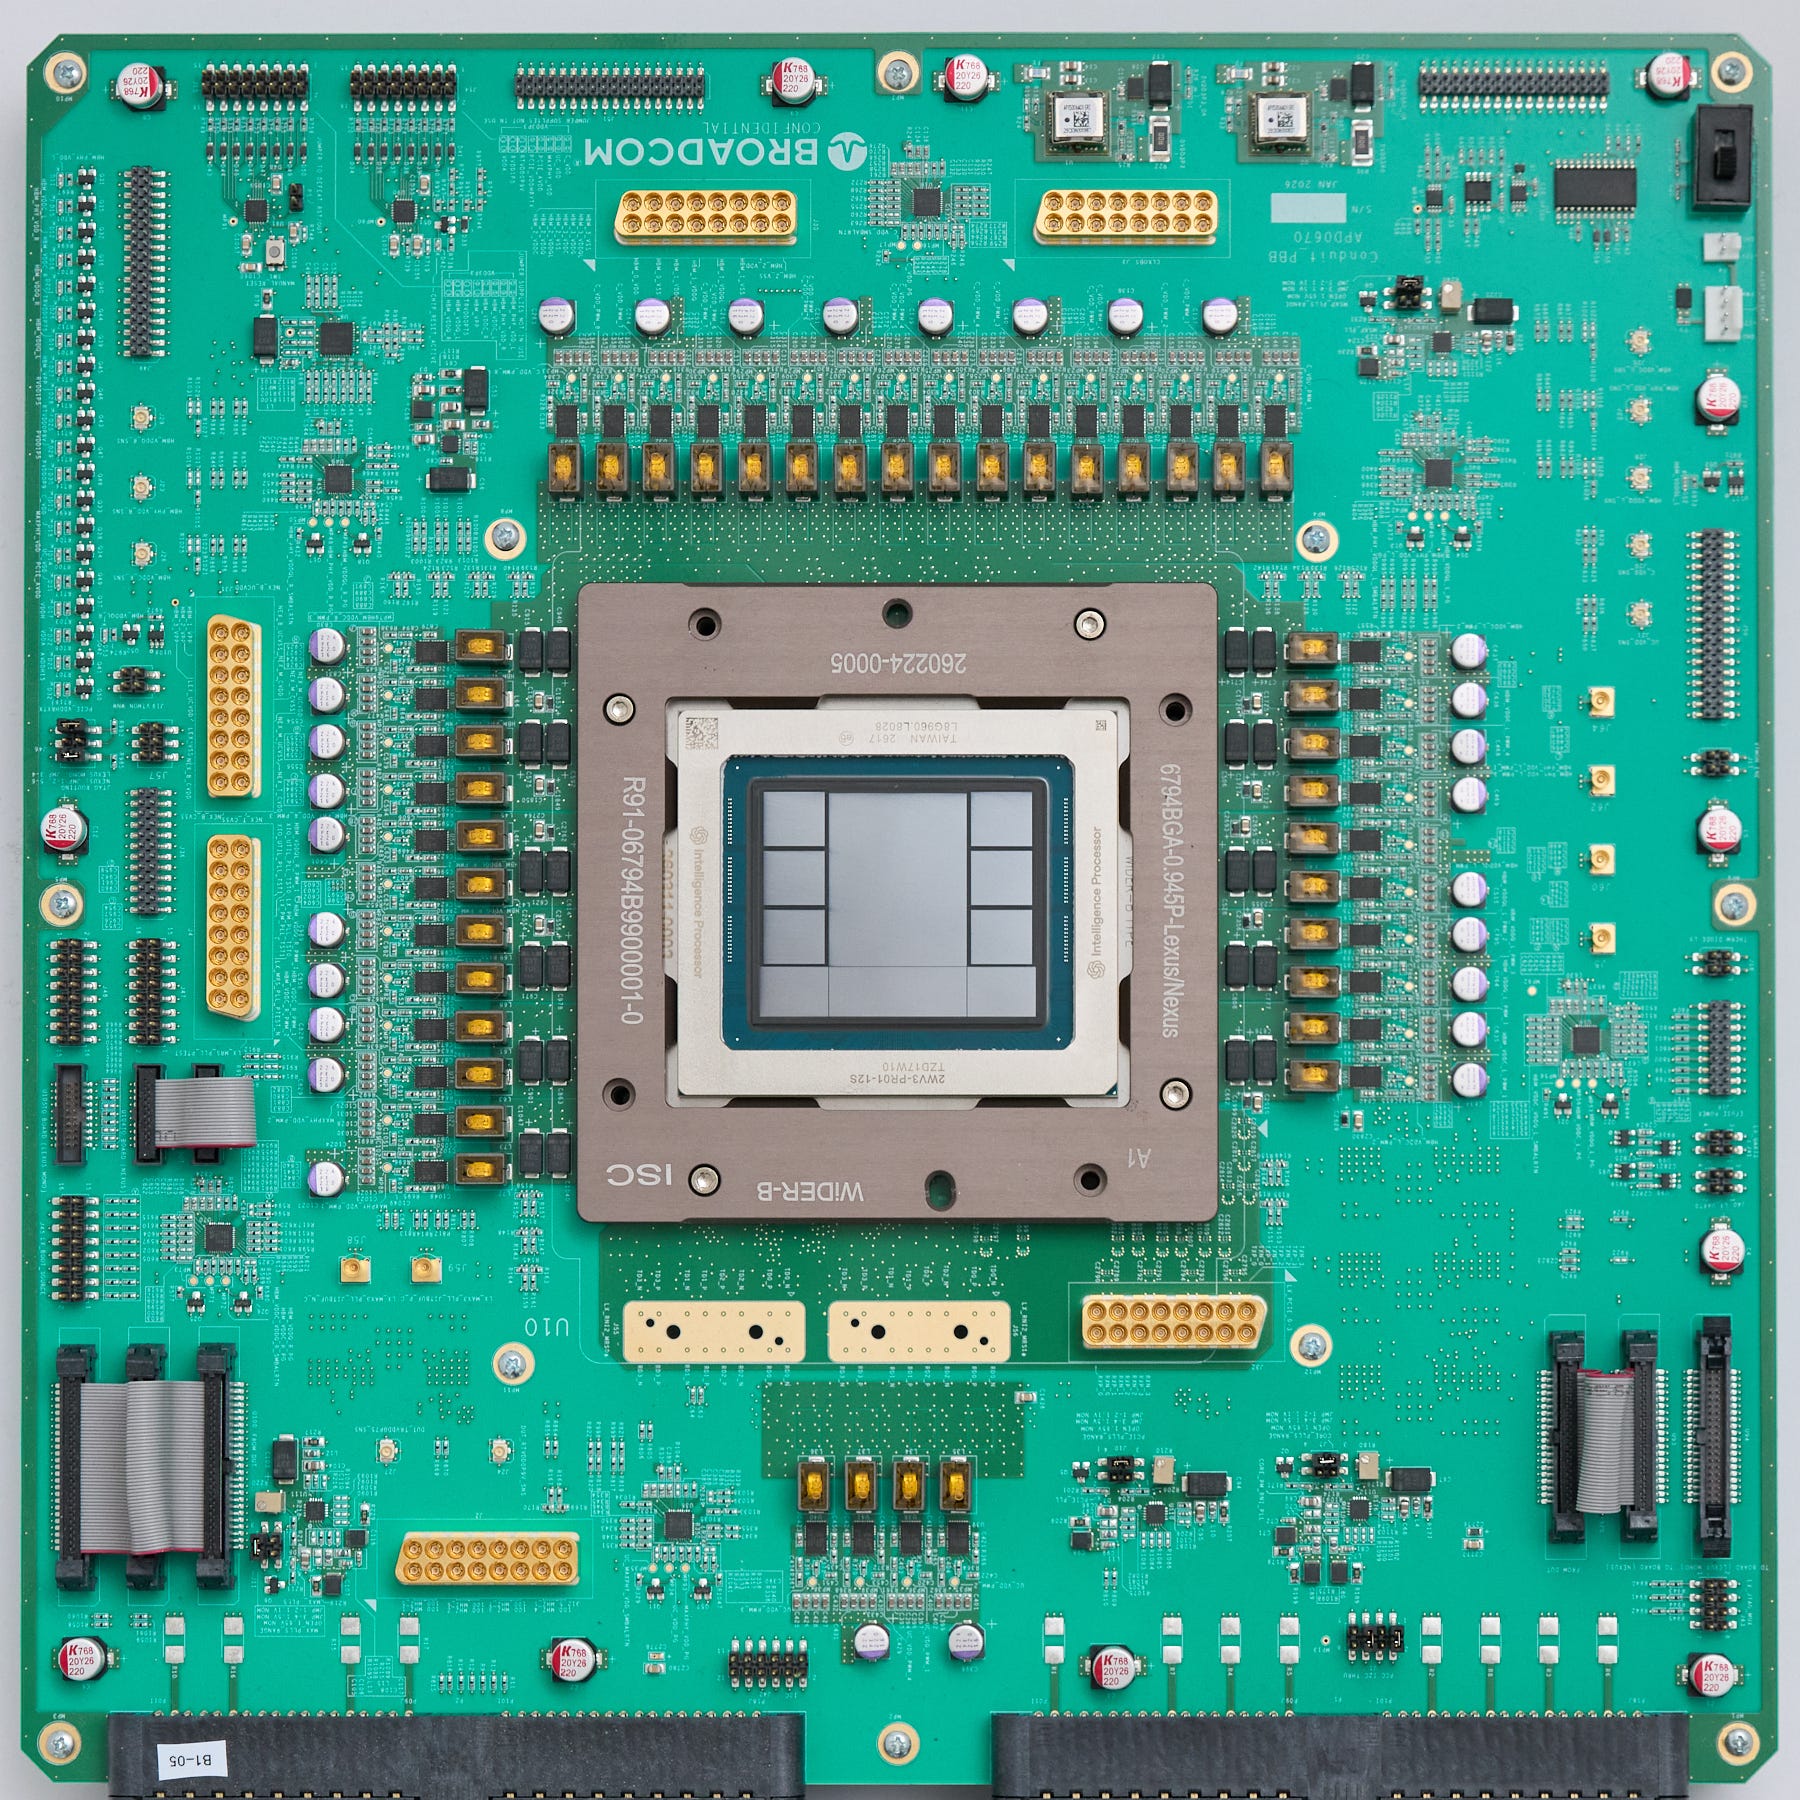
تراشه جدیدی برای هوش مصنوعی توجه زیادی را در این صنعت به خود جلب کرده است و به نظر میرسد این روند در سالهای آینده نیز ادامه داشته باشد.
در اواخر ماه اوت، OpenAI تراشه استنتاج هوش مصنوعی خود با نام Jalapeño را در کنفرانس Hot Chips معرفی کرد و با استقبال گستردهای روبهرو شد. نتایج معیارهای سنجش SemiAnalysis InferenceX نشان داد که این طراحی در چندین مدل متنباز، از جمله GPT-OSS، DeepSeek R1 و Kimi K2.5، از نظر عملکرد بهازای هر وات انرژی از رقبای خود، از جمله تراشه Blackwell شرکت انویدیا، پیشی میگیرد. با ورود جدیدترین سامانههای هوش مصنوعی Vera Rubin، ممکن است رتبهبندیها تغییر کند؛ بااینحال، طراحی نخستین تراشهای با چنین عملکردی در مدتزمانی کوتاه، دستاوردی چشمگیر است.
به باور من، Jalapeño شرکت OpenAI امیدوارکنندهترین برنامه ساخت تراشه در میان موج اخیر تراشههای هوش مصنوعی غیرمتکی بر GPU است.
در نشریه Key Context با ریچارد هو، معاون سختافزار OpenAI که رهبری تیم سازنده Jalapeño را بر عهده داشته است، گفتوگو کردیم. درباره چگونگی پیوستن او به این شرکت پیشرو در توسعه مدلهای هوش مصنوعی، روند ساخت Jalapeño، ویژگیهای متمایز آن و آینده برنامه تولید این تراشه صحبت کردیم.
مانند همیشه، گفتوگو با یکی از مهندسان برجسته صنعت هوش مصنوعی و تراشه برایم لذتبخش بود. این پرسشوپاسخ سرشار از جزئیات فنی و نکات روشنگر درباره مسیر آینده طراحی تراشه و فناوری حافظه است. بخشهایی را که از نظر من اهمیت بیشتری داشتند، پررنگ کردهام.
در ادامه، بخشهایی از گفتوگوی ما را میخوانید که برای روانتر شدن متن، ویرایش مختصری روی آنها انجام شده است.
تائه: میتوانید درباره پیشینه حرفهای خودتان و نحوه جذبشدن به OpenAI توضیح دهید؟
ریچارد: زمینه تخصصی من معماری رایانه است. سالها روی ابررایانهها کار کردهام؛ از جمله در شرکت D. E. Shaw Research که در آن ابررایانههایی برای شبیهسازی دینامیک مولکولی میساختیم. سپس گوگل از من دعوت به همکاری کرد و از همان نسل اول در پروژه واحدهای پردازش تنسور (TPU) مشارکت داشتم. من نخستین مهندسی بودم که روی این پروژه کار میکرد.
همیشه به هوش مصنوعی و یادگیری ماشین علاقه داشتهام. در واقع، دوره دکتریام را با تمرکز بر هوش مصنوعی آغاز کردم و برای کار در این حوزه به دانشگاه استنفورد رفتم. آن زمان هوش مصنوعی بیشتر بر سامانههای خبره متمرکز بود، نه شبکههای عصبی. انتخاب چندان مناسبی نبود؛ یکی از دورههای رکود هوش مصنوعی آغاز شده بود و بودجه پژوهش در این زمینه از بین رفته بود.
به همین دلیل به سمت سختافزار رفتم. خوشحالم که توانستم دوباره به حوزه هوش مصنوعی برگردم. مسیر بازگشتم از طریق گوگل بود.
مدتی در جستوجوی فناوریهای نسل بعد بودم و به شرکت فوتونیک Lightmatter پیوستم که هم در زمینه ارتباطات فوتونیکی و هم محاسبات فوتونیکی فعالیت میکرد. این تجربه واقعاً به من کمک کرد درک کنم استنتاج هوش مصنوعی و یادگیری ماشین به کدام سمت میرود و برای افزایش عملکرد بهازای هر وات، کاهش هزینه و دستیابی به پیشرفتهای دیگر، چه تغییرات فناورانهای لازم است.
در آن مقطع، فکر میکنم سم آلتمن و همکارانش با من تماس گرفتند تا درباره وضعیت فناوری و مسیر آینده آن گفتوگو کنیم.
آن زمان OpenAI هنوز فعالیت گستردهای در حوزه سختافزار نداشت، اما سم همیشه به این حوزه علاقهمند بود. او از طریق Y Combinator و مسیرهای دیگر در استارتاپهای کوچک زیادی سرمایهگذاری کرده است. بنابراین، همواره میدانست که زیرساخت نقشی اساسی در ارائه هوش مصنوعی دارد. گفتوگوی خوبی داشتیم و در نهایت به این ترتیب به OpenAI پیوستم.
در آن زمان، عملاً هیچ فرد دیگری در این زمینه در شرکت حضور نداشت و هنوز نمیدانستیم دقیقاً چه باید بکنیم. سم از همان ابتدا نگفت «برو یک تراشه بساز». پیشنهادش این بود که ابتدا موضوع را ارزیابی کنیم. من هم موافق بودم؛ میخواستیم بررسی کنیم چه کاری میتوانیم انجام دهیم که به زیرساخت شرکت کمک کند. مسیر کار ما نیز از همینجا شکل گرفت.
پس از تحلیل دقیق بارهای کاری، مدلها، پشته نرمافزاری، وضعیت سختافزار و روندهای فناوری، به این نتیجه رسیدیم که ساخت تراشه اختصاصی ارزش دارد؛ زیرا میتوانیم قابلیت استنتاجی یکپارچهای در تمام لایههای سامانه فراهم کنیم و هزینه و مصرف انرژی را برای کاربران کاهش دهیم.
به نظر من، این همان هدف نهایی و مأموریت OpenAI است: ارائه هوش مصنوعی به نفع تمام بشریت. این هدف با طرز فکر من درباره کاری که میخواستم انجام دهم و جایگاهی که میخواستم در آن باشم، کاملاً همخوانی داشت؛ بنابراین پیوستن به این شرکت برایم انتخابی طبیعی بود.
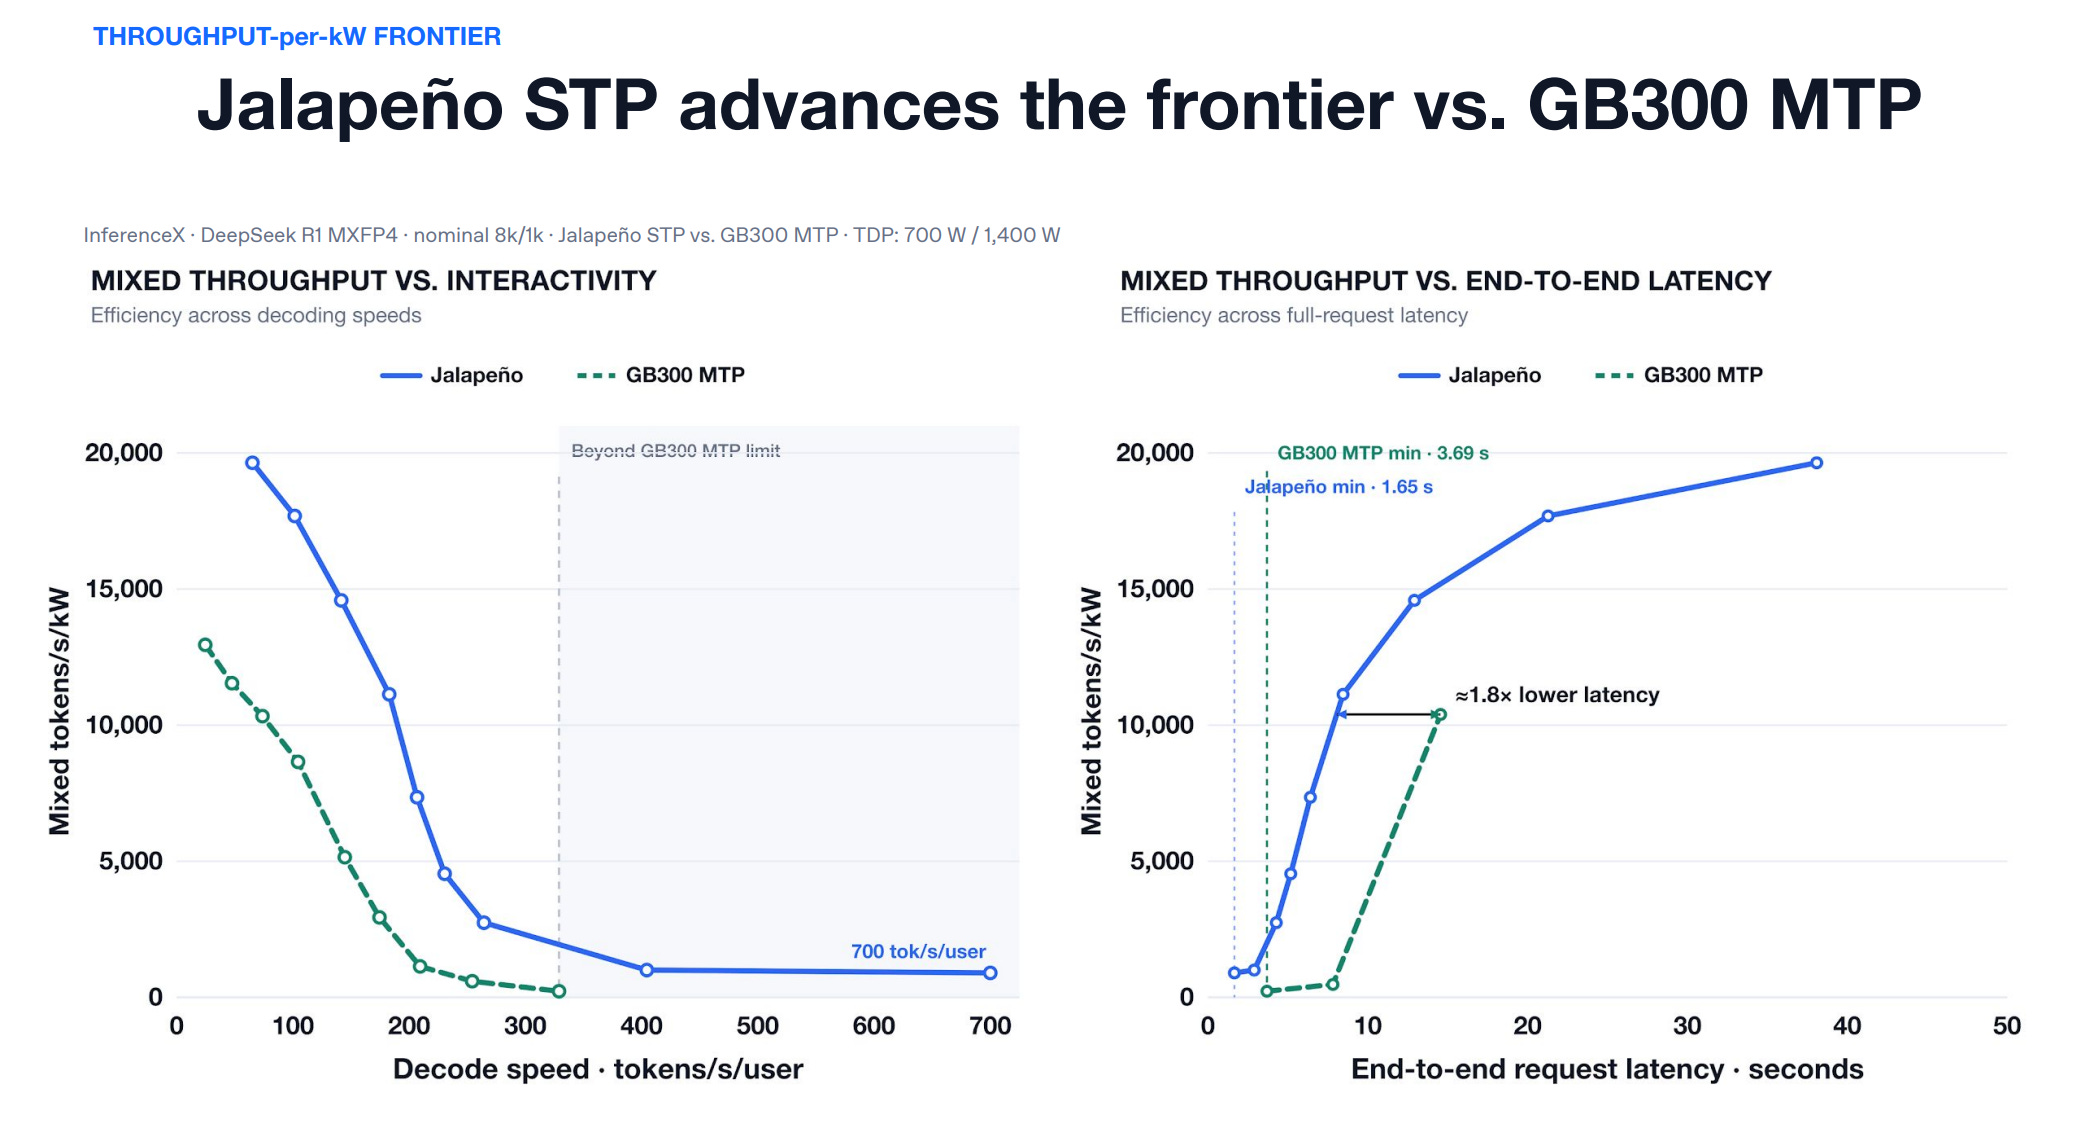
تائه: نتایج بنچمارک Jalapeño فوقالعاده به نظر میرسند. اگر بخواهیم برای مخاطب عمومی توضیح دهیم، چه چیزی آن را از TPU یا GPU متمایز میکند؟ رویکرد شما در طراحی چه بود؟
ریچارد: یکی از عوامل کلیدی این بود که طراحی را از نقطه صفر آغاز کردیم. در دنیای نرمافزار، نسخههای جدید و بازنویسی کدها رایجاند؛ زیرا افراد در جریان کار یاد میگیرند. نسخه اول را میسازند، از اشتباهات زیادی درس میگیرند و متوجه میشوند چه چیزهایی را میتوان بهتر انجام داد. سپس تقریباً از یک صفحه سفید شروع میکنند و نسخه دوم را بازنویسی میکنند.
در سختافزار هم وضع مشابهی وجود دارد. ما نخستین تلاش جدی و واقعی بودیم که از اصول بنیادین بررسی میکردیم برای ارائه خدمات به مدلهای زبانی بزرگ (LLM) و ترنسفورمرها در مقیاس وسیع، چه چیزی لازم است. بنابراین، بدون محدودیتهای بهجامانده از طراحیهای قبلی، توانستیم از منظر معماری بررسی کنیم که چگونه میتوان بهرهوری انرژی را افزایش داد.
بهرهوری انرژی در نهایت به جابهجایی دادهها و کاهش میزان این جابهجایی بستگی دارد. تمرکز زیادی بر همین موضوع داشتیم.
از خودمان پرسیدیم حداقل میزان جابهجایی داده موردنیاز چقدر است. در دانشگاهها پژوهشهای زیادی درباره نزدیککردن محاسبات به حافظه انجام شده است. این رویکردها با نامهایی مانند پردازش در حافظه (PIM) و محاسبات درون حافظه (CIM) شناخته میشوند و همچنان در حال پیشرفتاند.
اما ما راهکاری میانی را انتخاب کردیم: حافظه با پهنای باند بالا (HBM) را به شیوهای فنی و خاص به هستههای پردازشی متصل کردیم. این کار هم بهرهوری انرژی را افزایش داد و هم سرعت را بهبود بخشید؛ از جمله با کاهش تأخیر تولید توکنها.
نقطهضعف این روش آن است که مدل برنامهنویسی پیچیدهتر میشود؛ زیرا باید مدیریت حافظه را نیز در نظر گرفت. این مسئله از دیرباز یکی از مشکلات معماریهای دیگر هم بوده است. بااینحال، روی این فرض نیز حساب کردیم که مدلهای هوش مصنوعی در انجام این کار توانمند خواهند شد؛ اتفاقی که واقعاً رخ داد.
در نتیجه توانستیم مدل برنامهنویسی نسبتاً مناسبی داشته باشیم و همزمان از روش دشوار نگاشت دادهها به حافظه بهره ببریم؛ روشی که پردازش را بسیار کارآمد میکند. عوامل متعددی در زمان مناسبی کنار هم قرار گرفتند. به نظر من، راز موفقیت همین ترکیب بود.
گاهی زمانبندی مناسب به شانس هم بستگی دارد. بعضی فناوریها زودتر از موعد و بعضی دیرتر از زمان مناسب به نتیجه میرسند. در این مورد، همهچیز در زمان درستی کنار هم قرار گرفت: تیمی آماده داشتیم، انگیزه و نیاز وجود داشت و این عوامل کمک کردند طراحی Jalapeño به مرحله اجرا برسد.
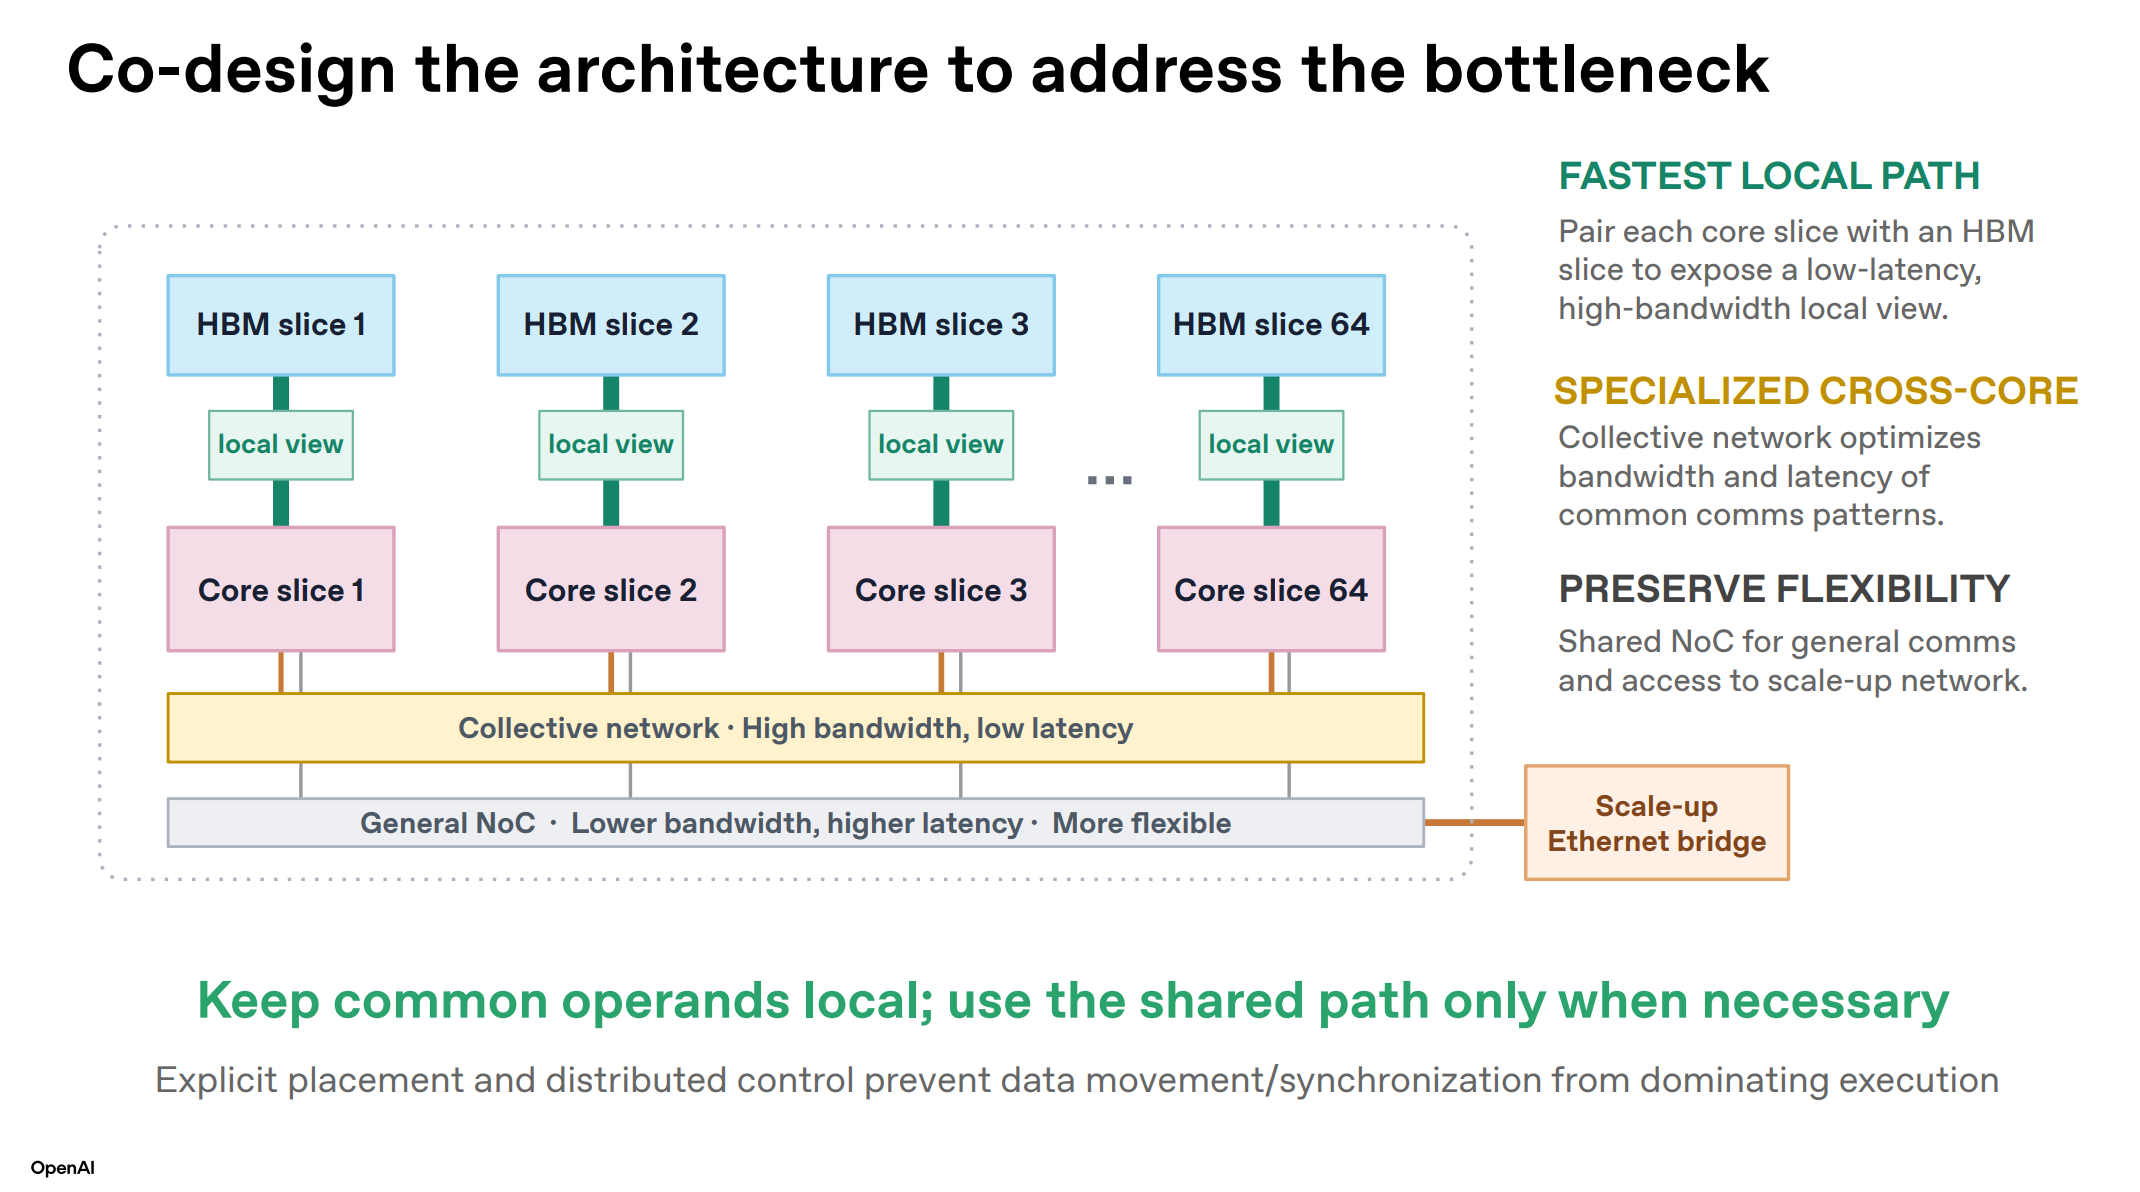
تائه: در کنفرانس Hot Chips، معماری مبتنی بر بخشهای HBM را معرفی کردید که در آن هر بانک حافظه HBM به یک هسته متصل است. میتوانید درباره این معماری و مزیت آن برای هوش مصنوعی بیشتر توضیح دهید؟
ریچارد: تفاوت اصلی این معماری با معماری متداول GPU یا حتی CPU این است که فضای حافظه به بخشهای جداگانه تقسیم شده است. هر هسته اختصاصی ــ که در طراحی ما ۶۴ هسته وجود دارد ــ میتواند مستقیماً به بانک حافظه مخصوص خود در HBM دسترسی پیدا کند و آدرسدهی آن را انجام دهد. برای دسترسی به حافظه بخشهای دیگر، باید از شبکه ارتباطی عبور کند؛ فرایندی که بسیار کندتر است و به مراحل واسطهای بیشتری نیاز دارد.
در معماری عمومی CPU یا GPU، فضای حافظه مشترک است و یک فضای آدرسدهی واحد وجود دارد. در اصطلاح انویدیا، هسته پردازشی یک SM یا چندپردازنده جریانی است. در این ساختار میتوان از هر نقطه تراشه به هر بخش حافظه دسترسی داشت. این کار برنامهنویسی را ساده میکند، اما برای مدیریت حافظه مشترک، کنترل دسترسیها و حفظ انسجام دادهها، سربار سختافزاری زیادی لازم است.
ما این پیچیدگیها را حذف کردیم و در نتیجه به بهرهوری و سرعت بیشتری رسیدیم. البته در این حالت باید نگاشت حافظه را مدیریت کنید. هر هسته عمدتاً میتواند به بانک حافظه خودش دسترسی داشته باشد و برای دسترسی به بخشهای دیگر باید کار بیشتری انجام دهد. پرسش اصلی این بود که آیا مزیت این روش به هزینه آن میارزد یا نه. تحلیل مدلها نشان داد که این انتخاب مزایای بسیار چشمگیری دارد.
پس از آن توانستیم از این معماری بیشتر بهره بگیریم و تصمیم بگیریم نرمافزارها و زیرساخت نرمافزاری را با آن سازگار کنیم تا از نزدیکبودن حافظه و هستههای پردازشی بیشترین استفاده را ببریم.
تائه: پس این معماری برای مدلهای زبانی بزرگ بهینه شده است؟
ریچارد: دقیقاً. مدلهای زبانی بزرگ از لایههایی تشکیل شدهاند که هر کدام بخش متفاوتی از کار را انجام میدهند و روشهای مختلفی برای تقسیم یا موازیسازی آنها وجود دارد. نکته اصلی همین است: اگر بتوان مدل را بهخوبی تقسیم کرد و بخشهای آن را در حافظهای قرار داد که هسته مربوطه روی آن کار میکند، درحالیکه همه هستهها بهصورت موازی فعالیت میکنند، میتوان به بهرهوری بسیار بالایی رسید.
ما روشهایی پیدا کردیم که این کار را برای مدلهای زبانی بزرگ بهطور کلی امکانپذیر میکند. میتوانیم هر مدل زبانی بزرگی را به این شکل تقسیم کنیم تا اجزای آن با کارایی بالا اجرا شوند. در نتیجه، پهنای باند حافظه، توان محاسباتی و شبکه ارتباطی بهصورت متوازن مورد استفاده قرار میگیرند. حاصل این ترکیب، توان عملیاتی بسیار بالا و تأخیر بسیار کم است.
تفاوت اصلی همینجاست. در بسیاری از معماریهای قدیمیتر، بخشی از فرایند به گلوگاه تبدیل میشد. در مرحله پیشپردازش ورودی (prefill)، توان محاسباتی کافی وجود نداشت و در مرحله تولید توکن (decode)، پهنای باند حافظه محدودکننده بود. در نتیجه، بخشهایی از سختافزار بدون استفاده مؤثر باقی میماندند.
هدف ما این بود که در بیشتر مواقع، تمام بخشهای تراشه با ظرفیت بالا کار کنند. بنابراین، با وجود اینکه ارقام اوج اعلامشده برای توان محاسباتی شناور، حافظه، شبکه و پهنای باند ما با دستگاههای دیگر قابل مقایسه است، در آزمونهای واقعی عملکرد بهتری به دست میآوریم؛ زیرا میزان استفاده مؤثر از منابع بسیار بالاست. این برتری حاصل ترکیب معماری سختافزار با بهینهسازیهای نرمافزاری ماست که در آن از مدلهای یادگیری ماشین برای تعیین نحوه نگاشت و چیدمان اجزا استفاده میکنیم.
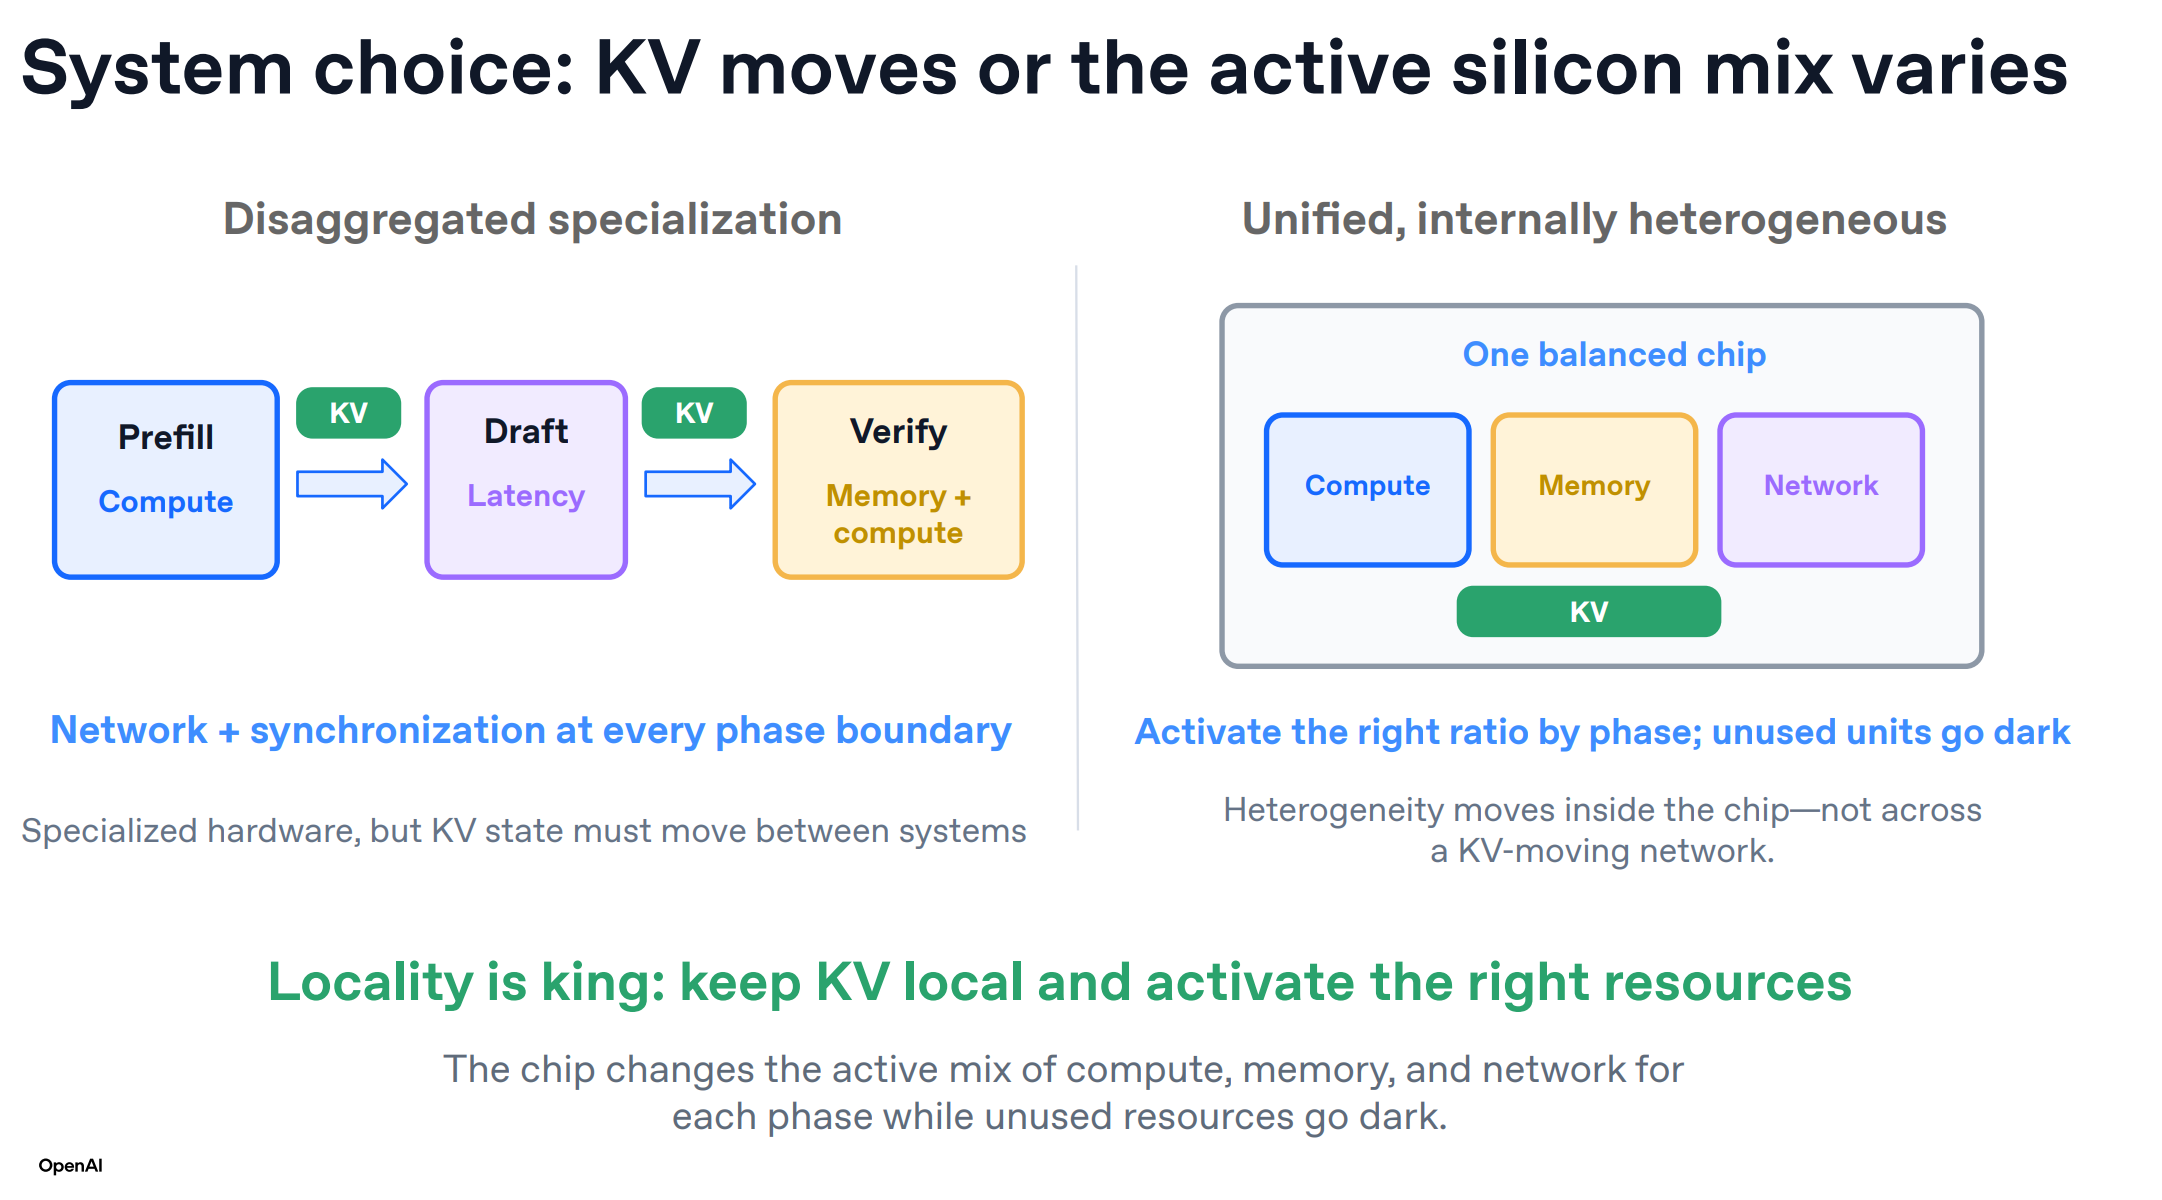
تائه: چرا معماری یکپارچه را بهجای معماری تفکیکشده انتخاب کردید و چرا HBM را به SRAM ترجیح دادید؟
ریچارد: بهتر است این دو موضوع را جداگانه بررسی کنیم.
نخست، درباره تفکیکنکردن بخشهای پردازشی. معماری تفکیکشده مزایای قابلتوجهی دارد، اما یک مشکل اساسی در استقرار آن در مجموعهای از سامانهها در یک مرکز داده وجود دارد: باید از پیش مشخص کنید چه سهمی از سختافزار به مرحله پیشپردازش ورودی، چه سهمی به مرحله تولید توکن و چه سهمی به تولید پیشنویس یا وظایف دیگر اختصاص یابد. این تصمیمها ممکن است برای چندین سال پابرجا بمانند.
پس از تعیین این تقسیمبندی، سختافزار مستقر میشود و تغییر یا بازگرداندن آن به زمان و تلاش زیادی نیاز دارد. ما معتقدیم اگر بتوان دستگاهی انعطافپذیر ساخت که در بخشهای مختلف این حوزه عملکرد خوبی داشته باشد، مدیریت کل مجموعه سختافزاری آسانتر خواهد شد. در این صورت، از ظرفیت کل مرکز داده بهتر استفاده میشود و احتمال اینکه برق مصرفی مرکز داده در تمام بخشها بهطور مؤثر به کار گرفته شود، افزایش مییابد.
به بیان دیگر، میخواهیم اصل استفاده بهینه از منابع را که در سطح تراشه دنبال میکنیم، به سطح مرکز داده گسترش دهیم؛ بهگونهای که تمام توان موجود در مرکز داده، در تمام زمانها، صرف انجام کارهای مفید شود.
تفکیک بخشها، حتی اگر بتوان با انتخاب بارهای کاری مختلف تا حدی مشکلات آن را کاهش داد، در اصل این هدف را دشوارتر میکند. ما میخواهیم این مانع را برطرف کنیم و انعطافپذیری کاملی داشته باشیم. اگر بتوان چنین کاری انجام داد، مزیت بزرگی خواهد بود.
متوجه شدیم معماری ما به دلیل شیوه اتصال حافظه به هسته پردازشی، امکان چنین انعطافی را فراهم میکند. وقتی این قابلیت را دیدیم، نتیجه گرفتیم که باید از آن بهره ببریم و معماری را تفکیک نکنیم. این یک مزیت است و منطقی است که از آن استفاده کنیم.
درباره انتخاب HBM بهجای SRAM، تفاوت بنیادی به بدهبستان میان پهنای باند و ظرفیت حافظه مربوط میشود. SRAM پهنای باند زیادی فراهم میکند، اما ظرفیت آن بسیار محدود است. مدلهای ما در OpenAI واقعاً بزرگاند و برای کار در مقیاس وسیع، به ظرفیت حافظه زیادی نیاز داریم.
بنابراین، SRAM با وجود اینکه راهکار خوبی است، در مقیاسپذیری با محدودیت روبهروست. در حال حاضر، مقدار SRAM قابلجاسازی در یک دستگاه به محدودیتهای فرایند ساخت شرکتهایی مانند TSMC، سامسونگ و اینتل بستگی دارد و سقف مشخصی برای آن وجود دارد.
HBM امکان عبور از این محدودیت را به شکلی معنادار فراهم میکند و در عین حال پهنای باند بالایی ارائه میدهد. اجازه دهید به پرسشی هم پاسخ دهم که هنوز نپرسیدهاید: سلسلهمراتب حافظه، طراحی حافظه و طراحی سامانه در آینده اهمیت بسیار زیادی خواهند داشت. همه شتابدهندههای یادگیری ماشین باید این موضوعات را با دقت جدی بررسی کنند.
ما نیز همین کار را انجام میدهیم. در انتخابهای طراحی، ظرفیت، تأخیر و پهنای باند موردنیاز را متناسب با توان محاسباتی و رابطهای شبکه متعادل میکنیم تا به استفاده مؤثر از منابع و توان عملیاتی بالایی برسیم؛ همان هدفی که پیشتر درباره آن صحبت کردیم.
تائه: میخواستم درباره آینده فناوری حافظه بپرسم. حافظههای DRAM با پشتهسازی سهبعدی در حال توسعهاند و شما هم HBM4 را انتخاب کردهاید. آیا در آینده نیز به استفاده از HBM ادامه میدهید؟ آیا این انتخاب بلندمدت است؟
ریچارد: ما همیشه فناوریهای مختلف را بررسی میکنیم و همچنان نیز این کار را انجام میدهیم. صادقانه بگویم، همینطور است.
در آن مقطع، HBM4 از نظر فنی بهترین انتخاب بود. احتمالاً HBM بهدلیل مزایایی که دارد، به شکلی در معماری نسلهای آینده ما نیز حضور خواهد داشت. بااینحال، قطعاً فناوریهای پیشرفته جدید را هم بررسی میکنیم؛ همانطور که انتظار میرود دیگر سازندگان تراشه نیز چنین کنند.
در این زمینه هم به نظرم استفاده مؤثر از منابع و کاهش جابهجایی دادهها اهمیت بسیار زیادی پیدا خواهد کرد. در پایان ارائهمان در کنفرانس Hot Chips به این موضوع اشاره کردیم و من نیز بر آن تأکید کردم. کار روی نسل دوم و سوم را آغاز کردهایم و میتوانم بگویم که حتی توسعه نسل چهارم را هم شروع کردهایم.
همه این موارد درست است، اما به باور من، نوآوری در نقطه تلاقی چند حوزه رخ خواهد داد: اینکه حافظه چگونه طراحی شود، اجزای آن چگونه چیدمان شوند، از چه فناوریای برای ساخت آن استفاده کنیم و اتصال میان اجزا چگونه باشد. مانند همیشه، تا جای ممکن از افزایش تعداد عملیات محاسباتی شناور (FLOPS) که فناوری ساخت در اختیارمان میگذارد، بهره خواهیم برد. پیشرفت فناوری ساخت، تعداد عملیات قابل انجام را افزایش میدهد و ما از این ظرفیت استفاده میکنیم؛ در کنار آن، نوآوری در دو حوزه دیگر به ما کمک خواهد کرد همگام با این پیشرفت حرکت کنیم.
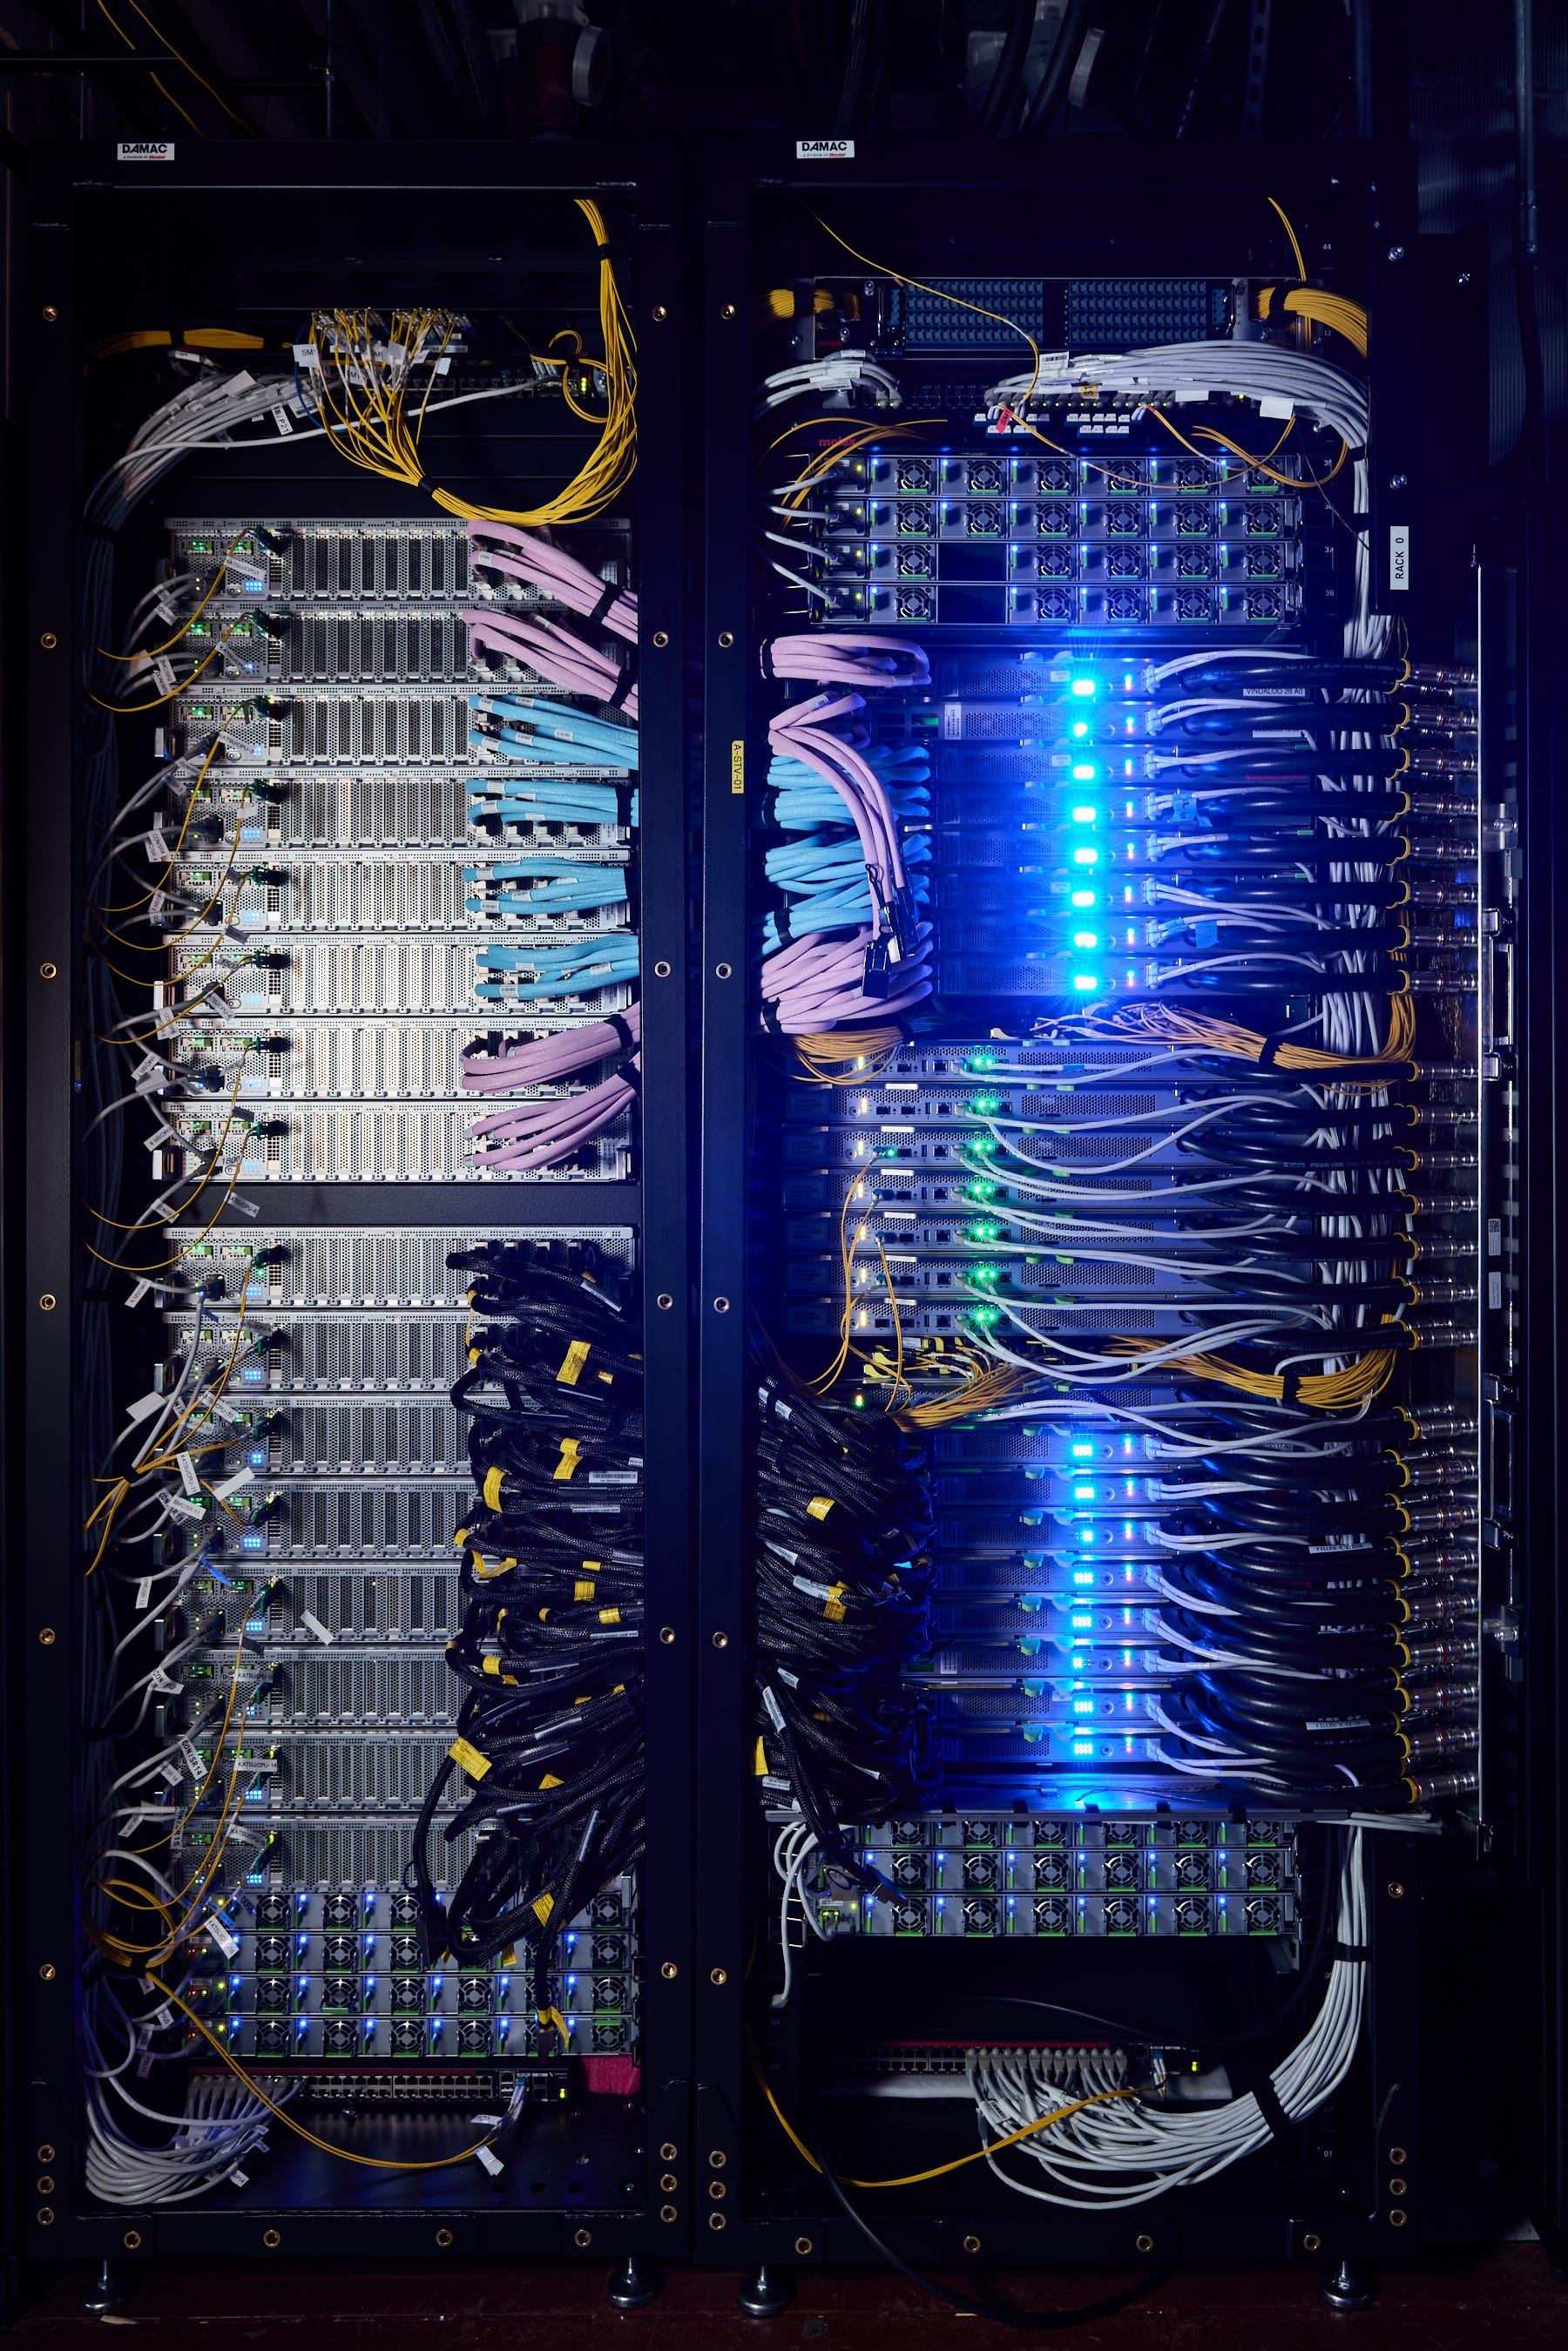
تائه: به نظر میرسد Jalapeño برای تولید در حجم بالا طراحی شده است. OpenAI چگونه تصمیم میگیرد از تراشههای انویدیا، AMD یا تراشه اختصاصی خودش استفاده کند؟ آیا تصمیم صرفاً به ظرفیت بستگی دارد؟ چطور تعیین میکنید از هرکدام کجا و به چه میزان استفاده کنید؟
ریچارد: موضوع به ظرفیت محاسباتی مربوط است. تقاضای ما برای محاسبات بسیار زیاد است. تقریباً تمام فرایند آموزش مدلها با محصولات انویدیا انجام میشود و در این بخش از GPU استفاده میکنیم. بنابراین، این تراشهها بخش بسیار مهمی از فعالیت ما هستند.
در حوزه استنتاج نیز به توان محاسباتی بسیار بیشتری نیاز داریم. اگر بتوانیم این ظرفیت را با تراشه اختصاصی خودمان تأمین کنیم، عالی است. اگر از انویدیا به دست آید، باز هم عالی است. استفاده از AMD یا دیگر تأمینکنندگان نیز به همان اندازه میتواند مفید باشد.
در نهایت، همه این گزینهها به بهبود زیرساخت کمک میکنند. ما میخواهیم بهترین زیرساخت ممکن را داشته باشیم و از هر ظرفیت محاسباتیای که بتوانیم بهطور مؤثر استفاده کنیم، بهره خواهیم برد.
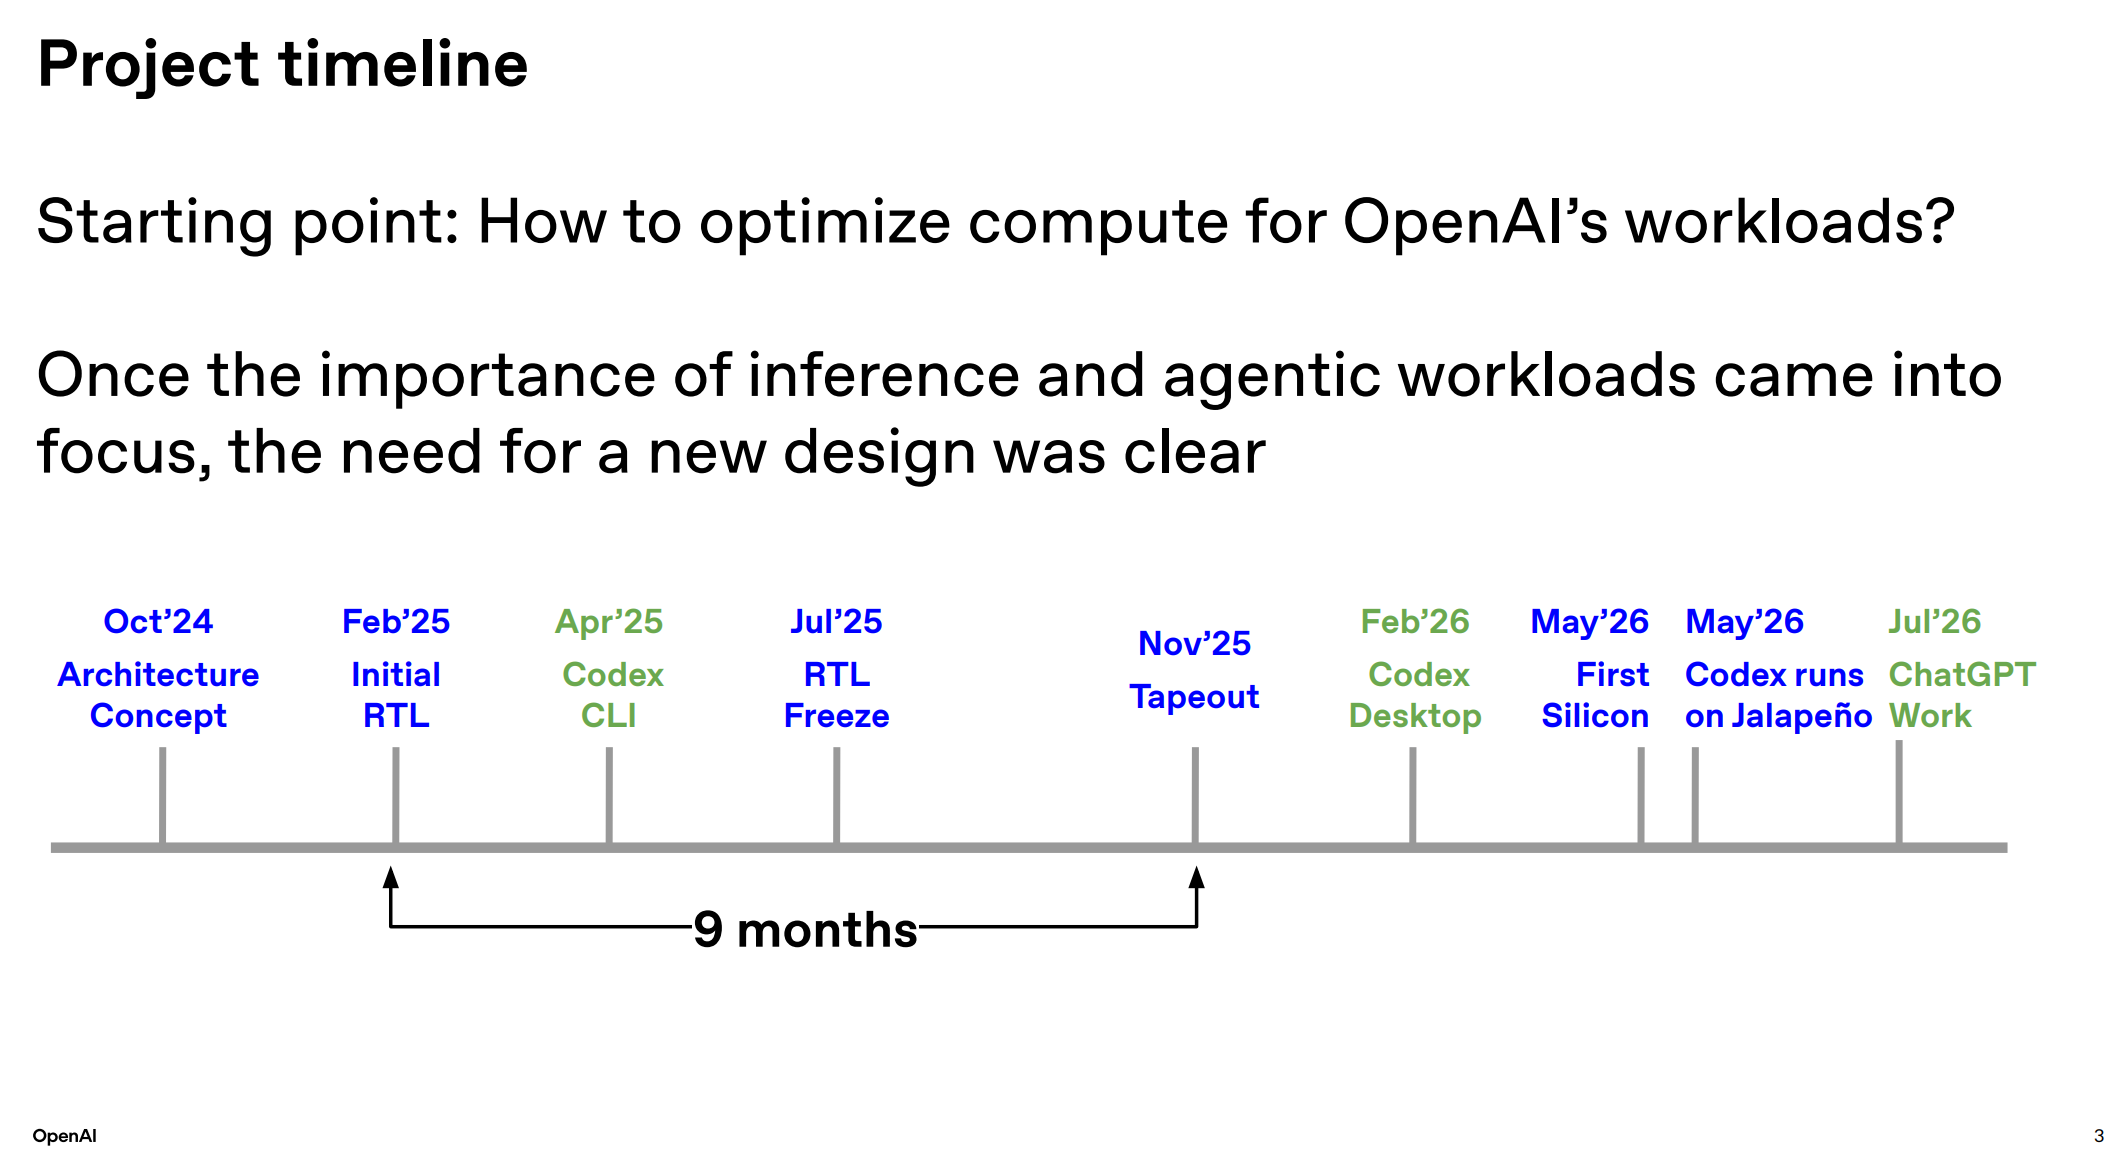
تائه: یکی از دستاوردهای مهم این پروژه، رساندن طراحی Jalapeño به مرحله نهایی پیش از ساخت تراشه در مدت ۹ ماه است؛ کاری که باورنکردنی به نظر میرسد. میتوانید نمونههای مشخصی ارائه دهید که نشان دهد هوش مصنوعی چگونه این فرایند را سرعت بخشید؟
ریچارد: هوش مصنوعی در بخشهای مختلف کمک کرد. نخست، در بهینهسازی توان مصرفی، عملکرد و مساحت تراشه، یا همان PPA، نقش داشت.
بهویژه توانست بررسیهایی انجام دهد که یک مهندس انسانی نیز میتواند انجام دهد، اما با سرعت بسیار کمتر و در تعداد محدودتری. هوش مصنوعی میتواند دهها هزار اجرای آزمایشی را بهصورت موازی پیش ببرد.
در عمل، حجم بسیار زیادی از کار را انجام میدهد. مهندسان متخصص معمولاً بر اساس تجربه و قواعد سرانگشتی ذهنی خود تصمیم میگیرند چه مسیرهایی را برای بهینهسازی بررسی کنند. آنها بر پایه دانش و تجربهشان حدس میزنند کدام گزینهها ارزش آزمایش دارند.
اما اکنون میبینم که عاملهای هوش مصنوعی و مدلهای این فناوری میتوانند بخش بزرگی از این فرایند اکتشافی را بهشکلی هوشمندانه خودکار کنند. آنها محدوده بسیار گستردهتری از گزینهها را بررسی میکنند و این بررسی را کاملتر انجام میدهند.
این ابزارها میتوانند در فضای بهینهسازی به راهکارهایی برسند که مهندسان انسانی نیز احتمالاً قادر به یافتن آنها هستند، اما دستیابی به همان نتایج برای انسان زمان بسیار بیشتری میبرد. همچنین هیچ تضمینی نیست که مهندسان بتوانند به همان نقطه بهینهای برسند که یک عامل هوش مصنوعی با جستوجوی گسترده به آن دست مییابد.
این ابزارها در بررسی جامع گزینهها بسیار توانمندند. همین مفهوم در بهینهسازی کرنلهای نرمافزاری نیز کاربرد دارد.
نکته دیگری که باید بگویم ــ و منظورم از این حرف انتقاد از انسانها نیست ــ این است که افراد معمولاً عادت دارند مسائل را به شیوه خاصی بررسی کنند. یکی از مزیتهای دیگر عاملهای هوش مصنوعی آن است که در دادههای آموزشی خود با روشها و رویکردهای بسیار متنوعی روبهرو شدهاند. به همین دلیل، میتوانند مسیرهایی را بررسی کنند که ممکن است به دلیل محدودیت تجربه یا سابقه کاری یک انسان، هرگز به ذهن او نرسیده باشد.
گاهی آنها به راهکاری میرسند که یک مهندس با دیدن آن میگوید «بله، معلوم است که این روش جواب میدهد»، اما خودش در ابتدا به آن فکر نکرده بود. بخش بزرگی از مزیت فعلی را در همین موضوع میبینیم. سرعت بالا، بررسی دقیق و جامع و توانایی یافتن راهکارهای متفاوت در محدودهای وسیع، به این ابزارها امکان میدهد به نتایجی برسند که ما بهتنهایی نمیتوانیم با همان سرعت یا کیفیت به آنها دست پیدا کنیم.
میخواهیم در همه بخشها از این قابلیت استفاده کنیم. اگر تحولات اخیر را دنبال کرده باشید، احتمالاً دیدهاید که مسئولیت برنامه GPT-Infra را در OpenAI بر عهده گرفتهام. هدف این برنامه آن است که تجربه بهدستآمده از پروژه Jalapeño را به حوزههای گستردهتری از صنعت نیمهرسانا، مهندسی و زیرساخت تعمیم دهیم.
هر پیشرفتی در زیرساخت به ما کمک میکند. بنابراین، میخواهیم با همکاری شرکایمان این پیشرفتها را محقق کنیم و به آنها کمک کنیم کارشان را بهتر انجام دهند. در نهایت، باید هزینه زیرساخت را کاهش دهیم؛ زیرا جهان به این زیرساخت نیاز دارد و باید آن را تا حد امکان به شکلی پایدار توسعه داد.
تائه: احتمالاً نمیتوانید درباره نسل دوم یا سوم جزئیات زیادی بگویید، اما آیا قرار است از این پس هر سال یک نسل جدید عرضه کنید؟
ریچارد: نمیگویم برنامه ما سالانه است، هرچند در عمل ممکن است فاصله عرضهها تقریباً به یک سال نزدیک باشد. نکته اصلی این است که استقرار هر نسل جدید هزینه و زحمت خاص خود را دارد. ساخت تراشه جدید، معرفی آن و اجرای آزمونهای عملکردی مهم است، اما در نهایت باید آن را در مراکز داده مستقر کرد؛ کاری که به منابع و تلاش قابلتوجهی نیاز دارد.
بنابراین، باید مطمئن شویم هر دستگاه جدید در معیارهای قابلاندازهگیری، مانند عملکرد بهازای هر وات یا میزان هوش بهازای هر وات، پیشرفت محسوسی نسبت به نسل قبلی دارد. منطقی نیست که با هر افزایش ۲ یا ۳ درصدی، دستگاه جدیدی مستقر کنیم. بهتر است این کار زمانی انجام شود که جهشی بزرگتر در قابلیتها به دست آمده باشد.
باید هزینه و تلاش لازم برای استقرار را در طول زمان توجیه کنیم. استقرار سختافزار یک فرایند فیزیکی است و مانند نرمافزار نیست که با انتشار نسخهای جدید، مدل تازهای بهسادگی در فهرست انتخاب کاربران ظاهر شود.
استقرار تجهیزات در مراکز داده برای ما بسیار دشوارتر است. بنابراین، هر مرحله از عرضه باید ارزش این سرمایهگذاری را داشته باشد. عرضه سالانه ممکن است به فاصله زمانی موردنظر نزدیک باشد، اما نمیگویم این اصل راهنمای تصمیمگیری ما خواهد بود.
تصمیمها را بر اساس این میگیریم که آیا دستگاه یا سامانه جدیدی در اختیار داریم که تغییر بزرگی در قابلیتهای ارائهشده به کاربران ایجاد کند یا نه. اگر چنین باشد، باید آن را عرضه کنیم و سپس همین رویکرد را ادامه دهیم. این تصمیمها اغلب به تغییرات فناوری مرتبطاند؛ همانطور که پیشتر توضیح دادم.
همواره بررسی میکنیم که آیا فناوری جدیدی وجود دارد که با بهکارگیری آن در دستگاه بعدی بتوانیم چنین پیشرفتی ایجاد کنیم یا خیر. این بخشی از فرایند طراحی مشترک ماست؛ در آن مشخص میکنیم برای رسیدن به هدف چه فناوریهایی لازم است، چگونه آنها را وارد طراحی کنیم و برنامه اجرایی را بر همان اساس شکل دهیم.
تائه: به فرهنگ سازمانی مؤثر و بهویژه مزایای تیمهای کوچک علاقه زیادی دارم. اگر امکان دارد، ابتدا بگویید تیم شما تقریباً چند نفر است و چرا تیم کوچک بهتر از تیم بزرگ عمل میکند؟
ریچارد: تیم ما حدود ۱۰۰ نفر است، اما این تعداد تمام حوزهها را پوشش میدهد: طراحی تراشه، راستیآزمایی، طراحی فیزیکی، بستهبندی، مدیریت حرارتی، طراحی سامانه، طراحی برد، طراحی رک، زنجیره تأمین، نرمافزار و میانافزار. دامنه کار بسیار گسترده است و ۱۰۰ نفر برای انجام همه این وظایف، تیم کوچکی محسوب میشود.
تیم طراحی خود تراشه فقط بخش کوچکی از این مجموعه است. تجربه ما نشان میدهد که تیمهای کوچک سریعتر حرکت میکنند.
وقتی گروهی از متخصصان در کنار ابزارهایی مانند عاملهای هوش مصنوعی و یادگیری ماشین قرار میگیرند، میتوانند با سرعت زیادی تصمیم بگیرند و طراحی را بهینه کنند. همیشه بهعنوان مدیر مهندسی گفتهام که سرعت نوآوری به چرخه تکرار وابسته است. چیزی را اجرا میکنید، نتیجه را میسنجید، تغییرات لازم را تشخیص میدهید و دوباره آن را آزمایش میکنید. هرچه این چرخه سریعتر باشد، پیشرفت نیز سریعتر خواهد بود. تیمی که میتواند در یک ساعت یک چرخه تکرار را کامل کند، از تیمی که برای همین کار یک هفته زمان نیاز دارد، جلو میافتد.
بنابراین، تعداد دفعات تکرار اهمیت زیادی دارد. این موضوع از جنبه کسبوکار نیز مهم است. من به تکرارهای سریع اعتقاد دارم و فکر میکنم سم و کل شرکت نیز چنین دیدگاهی دارند.
آنها راهکارها را آزمایش میکنند، به مرحله اجرا میبرند و تغییر میدهند. تیم کوچک از نظر شیوه کار مهندسی به این روند کمک میکند: سریع آزمایش کنیم، نتیجه را اندازه بگیریم، ببینیم چه چیزی باید بهتر شود و دوباره دست به کار شویم. به این ترتیب، میتوانیم در مدت کوتاهی از تعیین هدف به یک ایده برسیم، بفهمیم کدام بخش جواب داده و کدام بخش شکست خورده است، تغییرات لازم را مشخص کنیم و مسیر را ادامه دهیم.
گاهی خودم هم از سرعت رسیدن به نتایجی شگفتزده میشوم که پیش از شروع کار تصور نمیکردم امکانپذیر باشند. ضربالمثل قدیمیای میگوید سفر هزار مایلی با یک قدم آغاز میشود. باید نخستین گام را بردارید و چرخه آزمایش و تکرار را شروع کنید؛ سپس میتوانید این مسیر را طی کنید. شاید از ابتدا ندانید در نهایت به کجا خواهید رسید، اما بدون برداشتن قدمهای نخست به آنجا نمیرسید. این قدمها دانش شما را گسترش میدهند و امکان میدهند افقهایی را ببینید که از نقطه شروع قابل مشاهده نبودند.
تائه: هر چند هفته یک بار با روایتهای گمراهکنندهای در رسانهها روبهرو میشوم که میگویند موج هوش مصنوعی به پایان رسیده، مدلهای فعلی بهاندازه کافی خوباند، مدلهای متنباز و رایگان از مدلهای پیشرفتهتر پیشی خواهند گرفت و دیگر نیازی به توسعه مدلهای پیشرو نیست. با توجه به آنچه در داخل OpenAI میبینید و چشمانداز یکی دو سال آینده، هنوز در چه مرحلهای از پیشرفت هوش مصنوعی قرار داریم؟ قابلیتهای احتمالی آن طی دو تا سه سال آینده چیست؟ حدس میزنم با این دیدگاههای منفی موافق نیستید.
ریچارد: بله، مخالفم. به نظر من، ما انسانها اغلب در درک پیامدهای افزایش نمایی تواناییها مشکل داریم. آنچه میبینیم، بدون تردید رشد نمایی قابلیتهاست. هر چند ماه مدلهایی عرضه میشوند که در برخی جنبهها ده برابر بهتر از مدلهای قبلیاند.
فکر میکنم بیشتر مردم افزایش قابلیتها را خطی تصور میکنند، چون ذهن انسان معمولاً اینگونه فکر میکند. به همین دلیل، درک این موضوع دشوار است که مدلی که یک سال دیگر خواهیم داشت، ممکن است مدلهای امروزی را بسیار ابتدایی و کمهوش جلوه دهد.
این پیشرفت کجا رخ خواهد داد؟ به باور من، باید در مرزهای پژوهش اتفاق بیفتد. اکنون قابلیتها به اندازهای پیشرفته شدهاند که پژوهشگران باید بهطور فعال روی هدایت، ایمنی و سازوکارهای محدودکننده و حفاظتی کار کنند. هرچه توانایی مدلها بیشتر میشود، توجه به این مسائل نیز ضروریتر خواهد بود.
آیا چنین پیشرفتی در دنیای متنباز رخ خواهد داد؟ شاید، اما صادقانه بگویم، فعلاً شواهد زیادی نمیبینم که بخش عمده این کار در فضای متنباز انجام شود. تمرکز بسیاری از فعالان این حوزه بیشتر بر افزایش قابلیتهاست.
اما میبینم که این کار در آزمایشگاههای پژوهشی در حال انجام است؛ در OpenAI، در گوگل، در Anthropic و در مجموعههای دیگر. به نظرم این مسیر ضروری است. هوش مصنوعی قابلیتی بسیار مهم برای تمام انسانها خواهد بود، اما باید آن را بهدرستی توسعه دهیم.
باید سریع پیش برویم، اما در عین حال باید کار را درست انجام دهیم. این فرایند باید با دقت، تأمل و مسئولیتپذیری پیش برود و افرادی آن را هدایت کنند که واقعاً به این اصول اهمیت میدهند. من چنین رویکردی را در OpenAI میبینم و معتقدم این نکتهای اساسی است.
بنابراین، با این دیدگاه که پیشرفت هوش مصنوعی رو به پایان است، موافق نیستم. احساس میکنیم نسبت به گذشته به مراحل پیشرفتهتری رسیدهایم، اما به باور من، هنوز ظرفیت بسیار بیشتری برای دستیابی به هوش بالاتر وجود دارد.
در نهایت، مسئولیت این کار بر عهده همه ماست؛ هم بهعنوان یک جامعه و هم بهعنوان یک گونه انسانی. باید مطمئن شویم این فناوری بهدرستی توسعه مییابد. ما در مقطعی بسیار حساس از تاریخ قرار داریم.
تائه: از وقتی که در اختیار ما گذاشتید، سپاسگزارم.