
جهش چشمگیر عملکرد مدل OpenAI در آزمون مهاجرت کدهای COBOL
این هفته، OpenAI زبان برنامهنویسی COBOL را در کانون توجه قرار داد. این شرکت نتایج مجموعهای از آزمونها را منتشر کرد که نشان میدهد مدلهای جدید آن در انتقال برنامههای COBOL به زبانهای دیگر و ساخت نرمافزار با زبانهایی که دادههای کد و مستندات کمتری برای آموزش مدلها دارند، عملکرد بسیار بهتری پیدا کردهاند.
در آزمون اختصاصی OpenAI برای مهاجرت کدهای COBOL، مدل GPT-6.1 Sol با سطح تلاش استدلالی کم به دقت ۸۶٫۶ درصد رسید؛ درحالیکه دقت مدل GPT-5.6 Sol در همین آزمون ۵٫۴ درصد بود. هزینه استفاده از مدل جدید نیز ۳۹ درصد کمتر بود. با افزایش سطح تلاش استدلالی، دقت GPT-6.1 Sol به ۹۷٫۹ درصد رسید.
بااینحال، شواهد منتشرشده برای این دو ارزیابی از اعتبار و شفافیت یکسانی برخوردار نیستند.
OpenAI هنوز جزئیات ارزیابی خود برای COBOL را منتشر نکرده است. COBOL مخفف «زبان مشترک تجاریمحور» (Common Business-Oriented Language) است؛ زبانی که ابزارهای برنامهنویسی مبتنی بر هوش مصنوعی ممکن است به نگهداری یا انتقال برنامههای نوشتهشده با آن کمک کنند. در مقابل، این شرکت چارچوب و مجموعه آزمون MultiLangBench را در گیتهاب در دسترس عموم قرار داده است. این معیار میسنجد که مدلها تا چه اندازه میتوانند از ابتدا یک موتور پایگاه داده سازگار با SQLite را با استفاده از ۲۰ زبان برنامهنویسی مختلف بسازند.
OpenAI در اطلاعیه خود، نتایج را «بهبودهای چشمگیر در هر دو ارزیابی، همراه با دقت بسیار بیشتر و هزینه کمتر» توصیف کرده است.
این نتایج میتوانند برای تیمهایی که مسئول نگهداری و نوسازی نرمافزارهای قدیمی هستند، اهمیت داشته باشند. بااینحال، تا زمانی که موارد آزمون COBOL بهصورت عمومی منتشر نشوند، توسعهدهندگان نمیتوانند این ارزیابی را مستقلاً بررسی کنند.
آیا سرانجام میتوان به نوسازی COBOL امیدوار بود؟
به گفته OpenAI، ارزیابی جدید این شرکت برای مهاجرت کدهای COBOL «بررسی میکند که آیا یک مدل میتواند برنامههای موجود را به زبان دیگری منتقل کند و در عین حال رفتار آنها را حفظ کند یا نه». این ارزیابی بهطور مشخص، انتقال برنامهها از COBOL به زبانهای ++C، جاوا، کاتلین، پایتون و راست را بررسی میکند.
برای موفقیت در این آزمون، هر نسخه منتقلشده باید مجموعهای از آزمونهای پنهان را پشت سر بگذارد. این آزمونها مستلزم آناند که خروجیهای قابل مشاهده، «بایتبهبایت یکسان» باشند. با توجه به افزایش چشمگیر دقت نسبت به مدل قبلی، GPT-6.1 Sol واقعاً پیشرفت قابلتوجهی نشان میدهد.
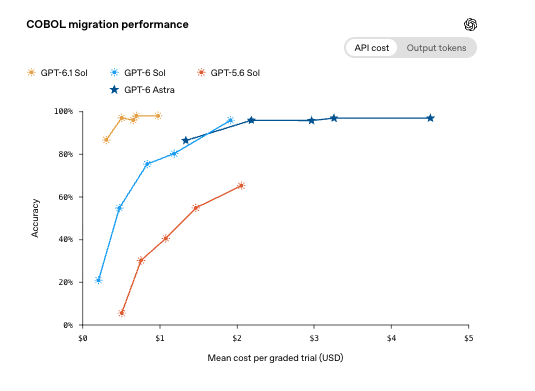
افزایش عملکرد اندازهگیریشده چشمگیر است، هرچند OpenAI نخستین شرکتی نیست که برای نوسازی COBOL به سراغ هوش مصنوعی رفته است.
COBOL با وجود نقش زیربنایی خود در بخش بزرگی از تراکنشهای مالی و سوابق تجاری جهان، همچنان هدف دشواری برای ابزارهای برنامهنویسی مبتنی بر هوش مصنوعی به شمار میرود. بر اساس گزارش شرکت IBM، این زبان زیربنای بیش از ۴۰ درصد از سامانههای بانکداری آنلاین است، از ۸۰ درصد تراکنشهای کارت اعتباری حضوری پشتیبانی میکند و پردازش ۹۵ درصد تراکنشهای دستگاههای خودپرداز را بر عهده دارد.
در مقایسه با زبانهایی مانند پایتون و جاوااسکریپت، حجم کدها و مستندات COBOL که مدلها میتوانند از آنها یاد بگیرند کمتر است. یافتن توسعهدهندگان باتجربه این زبان نیز دشوار است و مستندات نرمافزارها اغلب از تغییرات سامانههایی که نگهداری میشوند عقب میمانند.
پیشرفت هوش مصنوعی در برنامهنویسی با ۲۰ زبان
OpenAI در کنار آزمونهای مهاجرت COBOL، ارزیابی دومی به نام MultiLangBench طراحی کرده است تا توانایی مدلها را در ساخت نرمافزار از ابتدا بسنجد. این معیار «بررسی میکند که آیا یک مدل میتواند با استفاده از ۲۰ زبان برنامهنویسی مختلف، یک موتور پایگاه داده سازگار با SQLite بسازد یا نه».
در این آزمون، ابتدا یک پایگاه داده و یک پرسوجوی SQL به برنامه داده میشود و سپس برنامه نسخهای تغییریافته از پایگاه داده تولید میکند. در مرحله بعد، پیادهسازی مرجع SQLite بهعنوان معیار اصلی درستی به کار میرود تا مشخص شود پایگاه داده خروجی حاوی دادههای مورد انتظار هست یا خیر.
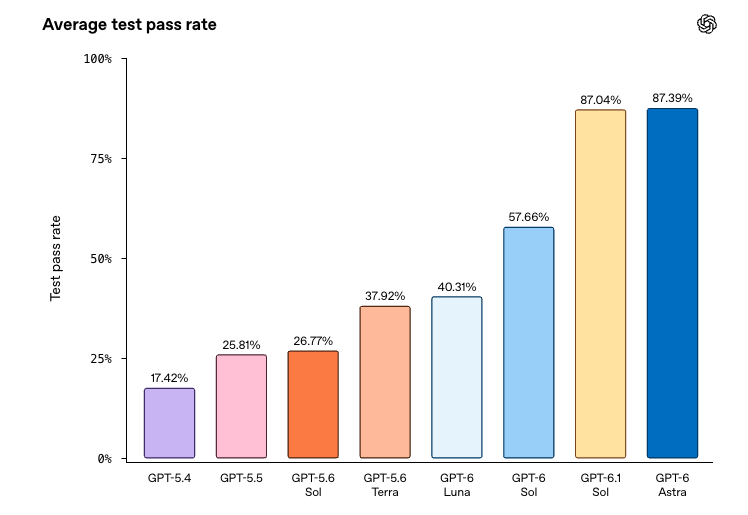
مدل GPT-6 Astra، مدل پرچمدار OpenAI، بهطور میانگین در ۲۰ زبان برنامهنویسی توانست ۸۷٫۴ درصد آزمونها را با موفقیت پشت سر بگذارد؛ جهشی چشمگیر در مقایسه با نرخ قبولی ۲۶٫۸ درصدی GPT-5.6 Sol. این مدل در ۱۹ زبان از مجموع ۲۰ زبان، امتیازی بالاتر از ۸۳ درصد کسب کرد و عملکردش در تمام زبانهای آزمایششده بهبود یافت.
همانطور که انتظار میرفت، GPT-6 Luna به عملکرد Astra نرسید و این گزینه کمهزینهتر به میانگین نرخ قبولی ۴۰٫۳ درصد دست یافت. بااینحال، Luna در تمام زبانهای آزمایششده از GPT-5.6 Sol بهتر عمل کرد و هزینه تخمینی استفاده از رابط برنامهنویسی کاربردی (API) آن نیز حدود ۷۸ درصد کمتر بود.
بسیار خوب؛ پس اسرارتان را حفظ کنید.
OpenAI از نتایج امیدوارکننده ارزیابی مهاجرت COBOL و معیار MultiLangBench خبر داده است، اما نتایج آزمونهای معیار بهتنهایی تمام واقعیت را نشان نمیدهند. تا روز پنجشنبه، در معیار Real-SWE 1.1 که از مخازن کد خصوصی استفاده میکند، مدل Claude Opus 5.5 با نرخ حل مسئله ۵۶٫۸ درصد در جایگاه نخست قرار داشت. بااینحال، در نسخه پیشین آزمون Real-SWE که The New Stack درباره آن گزارش داده بود، مدل پیشتاز دیگری بود و امتیازها نیز پایینتر بودند.
از سوی دیگر، توسعهدهندگان همچنان نمیتوانند معیار مهاجرت COBOL شرکت OpenAI را بررسی کنند. این شرکت اعلام کرده است که بازخورد توسعهدهندگان و مشتریان سازمانی در هدایت این پروژه نقش داشته است، اما بدون دسترسی به آزمونهای اصلی و مجموعه دادههای مورد استفاده، افراد خارج از شرکت قادر نیستند نتایج را مستقلاً ارزیابی کنند.
OpenAI به یکی از محدودیتهای مهم این فناوری اذعان کرده و میگوید: «بهکارگیری آن در نرمافزارهای عملیاتی همچنان به بررسی کارشناسان و آزمایش بر اساس قواعد کسبوکار و وابستگیهای سامانه نیاز دارد.»
OpenAI وارد حوزهای شده است که شرکتهای دیگر مدتی است در آن فعالیت میکنند. شرکت Anthropic در ۲۳ فوریه توضیح داد که Claude Code چگونه میتواند به نوسازی COBOL کمک کند. همچنین، همانطور که The New Stack گزارش داده است، AWS در سال ۲۰۲۴ عاملهای هوش مصنوعی خود را برای سادهسازی انتقال سامانههای مینفریم معرفی کرد.