
تعیین آستانههای مقیاسپذیری خودکار تبدیل متن به گفتار در Amazon SageMaker AI بر اساس اندازهگیری واقعی
افزایش ناگهانی ترافیک به نقطه پایانی خودمیزبان تبدیل متن به گفتار (TTS) باعث میشود درخواستها در صف منتظر بمانند. همزمان، تأخیر از هدف سطح خدمت (SLO) فراتر میرود؛ درست در زمانی که بیشترین تعداد کاربران در حال گوشدادن هستند. قرار بود سیاست مقیاسپذیری خودکار این نقطه پایانی از چنین وضعیتی جلوگیری کند، اما مقدار هدفی که مبنای مقیاسپذیری قرار گرفته بود، صرفاً حدسی بود. چنین حدسهایی ممکن است بیسروصدا شکست بخورند و تنها زمانی نادرستی آنها آشکار شود که با ترافیک واقعی روبهرو شوند.
انتخاب اشتباه این عدد دو نوع هزینه به همراه دارد و هیچکدام لزوماً هشدار سیستمی ایجاد نمیکنند. اگر مقدار را بیش از حد محافظهکارانه انتخاب کنید، مجموعه نمونههای محاسباتی شامل نمونههای GPU خواهد بود که بیشتر اوقات تقریباً بیکار میمانند. هزینه این ظرفیت در تمام صورتحسابها ظاهر میشود، اما هیچگاه به ثبت یک گزارش رخداد منجر نمیشود. در مقابل، اگر مقدار بیش از حد تهاجمی باشد، خطر پنهانی متوجه مجموعه نمونهها خواهد شد: هر نمونه درخواستهای همزمان بیشتری از توانایی خود برای پاسخگویی در محدوده تأخیر وعدهدادهشده میپذیرد. تا زمانی که افزایش واقعی ترافیک زمان انتظار در صف را از SLO فراتر نبرد، ممکن است هیچ مشکلی دیده نشود. این اتفاق درست زمانی رخ میدهد که بیشترین تعداد کاربران در حال گوشدادن هستند. این همان شکاف پنهان است؛ سیاستی که در کنسول مناسب به نظر میرسد، ممکن است از قبل در ارائه خدمت به کاربران هدف شکست خورده باشد.
در این مقاله، مدل تبدیل متن به گفتار Kokoro-82M با ۸۲ میلیون پارامتر را در قالب یک کانتینر سفارشی روی یک نقطه پایانی بلادرنگ در Amazon SageMaker AI مستقر میکنیم. پشتههای کیت توسعه ابری AWS (AWS CDK) فرایند استقرار را مدیریت میکنند. سپس حدسوگمان را با دو اندازهگیری روی نقطه پایانی فعال جایگزین میکنیم: Q_max، بیشترین تعداد درخواستهای همزمانی که یک نمونه میتواند پیش از نقض SLO تحمل کند، و T_total، مدتزمان کامل افزایش ظرفیت از آغاز درخواست آن تا آمادهشدن ظرفیت جدید برای خدمترسانی. آستانه افزایش ظرفیت، آستانه کاهش ظرفیت و هر دو زمان انتظار پس از مقیاسپذیری را با محاسباتی مبتنی بر این دو عدد به دست میآوریم. تمام اعداد این مقاله حاصل استقرار واقعی و اجرای اندازهگیریها در مخزن aws-samples معرفیشده در همین مقاله هستند.
چرا معیارهای پیشفرض مقیاسپذیری خودکار برای TTS مناسب نیستند؟
بخش عمده راهنماهای عمومی مربوط به آستانههای مقیاسپذیری خودکار در Amazon SageMaker AI، بر درخواستهای همزمان کوتاه با الگوی درخواست و پاسخ یا ارائه مدلهای زبانی بزرگ (LLM) متمرکز است؛ در حالت دوم، تعداد توکنهای تولیدشده در ثانیه معیار طبیعی به شمار میرود. سنتز گفتار با هیچیک از این دو الگو مطابقت ندارد: یک درخواست منفرد اتصال را برای چند ثانیه باز نگه میدارد و حلقه تولید توکنی وجود ندارد که بتوان معیاری را به آن متصل کرد. مدل Kokoro-82M غیرخودبازگشتی است و از خانواده مدلهای مشتقشده از StyleTTS2 با رمزگشای ISTFTNet محسوب میشود. این مدل با روش خصمانه آموزش دیده است، نه با پیشبینی خودبازگشتی توکن بعدی یا حذف نویز تکرارشونده. خروجی کامل گفتار در یک گذر همتراز با مدتزمان تولید میشود. بنابراین، اساساً حلقه تولیدی وجود ندارد که بتوان برای هر توکن آن معیاری تعریف کرد. تشخیص اضافهبار یک نمونه TTS سادهتر از آن چیزی است که به نظر میرسد: باید دید در همان لحظه چند درخواست در صف آن قرار دارند و چند درخواست در حال اجرا هستند.
سیاست مستقرشده بر اساس معیار ConcurrentRequestsPerModel مقیاسپذیری را انجام میدهد. این معیار را خود Amazon SageMaker AI بهصورت بومی منتشر میکند و نیازی نیست کد کانتینر این پروژه آن را تولید کند. استفاده از معیاری که Amazon SageMaker AI مستقیماً منتشر میکند، یک دسته کامل از خطاها را حذف میکند؛ خطاهایی که ممکن است در آنها پیکربندی یک معیار سفارشی روی کاغذ درست به نظر برسد، اما در عمل هیچ دادهای برای آن منتشر نشود.
معیار ConcurrentRequestsPerModel مقدار بیشینه را در یک بازه ۱۰ثانیهای منتشر میکند. این مقدار با میانگین تعداد درخواستهای در حال اجرا که یک کلاینت آزمون بار مستقیماً اندازه میگیرد، یکسان نیست. ابزارهای این راهکار این تفاوت را در نظر میگیرند. در هر مرحله از نردبان افزایش همزمانی، هر دو مقدار تحت بار یکسان اندازهگیری و نسبت آنها ثبت میشود. سپس این نسبت برای تبدیل آستانه اندازهگیریشده از سمت کلاینت به واحدهای Amazon CloudWatch به کار میرود و نتیجه پیش از درج در پیکربندی قابل استقرار محاسبه میشود. در اجرای Kokoro-82M که در این مقاله بررسی شده است، نسبت اندازهگیریشده در تمام مراحل دقیقاً ۱٫۰ بود؛ بنابراین، آستانههای اندازهگیریشده توسط کلاینت و گزارششده در Amazon CloudWatch مستقیماً با یکدیگر مطابقت داشتند.
مروری بر راهکار
این راهکار مدل Kokoro-82M را در یک کانتینر سفارشی روی نقطه پایانی بلادرنگ Amazon SageMaker AI مستقر میکند و سپس هدف مقیاسپذیری خودکار را که پیشتر بر اساس حدس تعیین میشد، با مقداری جایگزین میکند که از دو اندازهگیری روی همان نقطه پایانی فعال به دست آمده است: Q_max، حداکثر تعداد درخواستهای همزمانی که یک نمونه میتواند در محدوده SLO پردازش کند، و T_total، مدتزمان واقعی افزایش ظرفیت. درخواست سنتز گفتار از چهار لایه عبور میکند: کلاینت، نقطه پایانی Amazon SageMaker AI، کانتینر سفارشی مستقر روی یک نمونه GPU در پشت نقطه پایانی و مدل Kokoro-82M درون کانتینر.
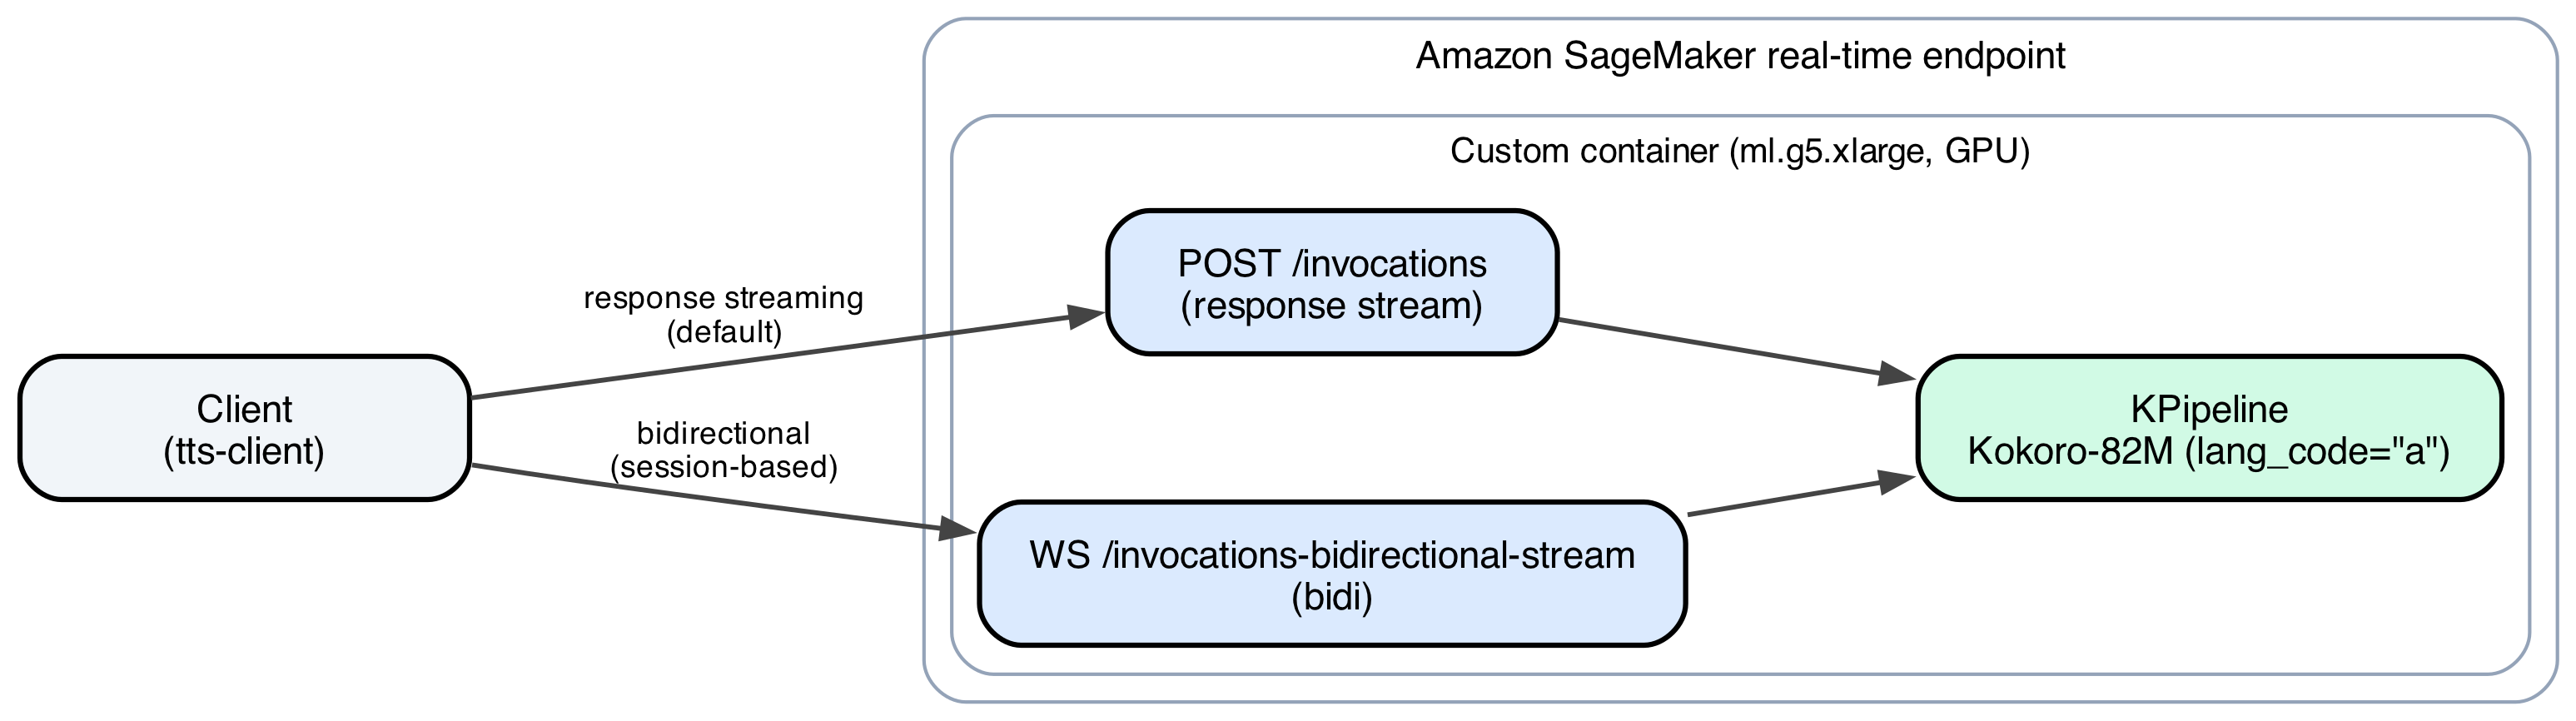
این کانتینر از دو روش انتقال داده پشتیبانی میکند: جریان پاسخ (InvokeEndpointWithResponseStream) که صدا را همزمان با سنتز به کلاینت میفرستد تا پخش پیش از تکمیل کل گفتار آغاز شود، و جریان دوسویه (InvokeEndpointWithBidirectionalStream) که یک نشست طولانیمدت را برای تبادل چندین پیام باز نگه میدارد.
اجرای Kokoro-82M در کانتینر سفارشی، بهجای استفاده از یک ابزار مدیریتشده استنتاج، امکان اجرای سایر مراحل این راهکار را فراهم میکند. کانتینری که کنترل آن در اختیار شماست، میتواند محدودیتهای پذیرش درخواست را خودش اعمال کند و سیگنال همزمانی دقیقی را در اختیار بگذارد که Amazon SageMaker AI از قبل منتشر میکند؛ در نتیجه، لازم نیست معیاری را که برای نوع دیگری از بار کاری طراحی شده است، بهزور با این کاربرد تطبیق دهید. پشتههای AWS CDK که این نقطه پایانی را مستقر میکنند، فقط زمانی منابع مقیاسپذیری خودکار را به آن متصل میکنند که یک برنامه plan واقعی و اندازهگیریشده برای مدل موجود باشد. به این ترتیب، پیکربندی مبتنی بر حدس نمیتواند بیسروصدا وارد محیط عملیاتی شود. ادامه مقاله به همین فرایند اندازهگیری میپردازد.
پیشنیازها
برای اجرای این راهنمای گامبهگام، به موارد زیر نیاز دارید:
- یک حساب AWS با مجوز ایجاد نقشهای مدیریت هویت و دسترسی AWS (IAM)، مخازن Amazon Simple Storage Service (Amazon S3)، مخازن Amazon Elastic Container Registry (Amazon ECR) و منابع Amazon SageMaker AI.
- توجه: کانتینر نمونه، نسخه قدیمیتری از PyTorch را با یک آسیبپذیری شناختهشده با شناسه
PYSEC-2026-2286ثابت نگه میدارد؛ این مشکل در torch 2.10.0 برطرف شده است. پیش از استفادهای فراتر از ارزیابی اولیه ارزش راهکار، نسخه تثبیتشده را بررسی و بهروزرسانی کنید.
- توجه: کانتینر نمونه، نسخه قدیمیتری از PyTorch را با یک آسیبپذیری شناختهشده با شناسه
- AWS CDK نسخه ۲ که در حساب و منطقه مقصد نصب و راهاندازی اولیه شده باشد.
- Python نسخه ۳٫۱۱ یا جدیدتر، ابزار uv و Docker برای ساخت تصویر کانتینر.
- سهمیه سرویس
ml.g5.xlargeبا دستکم یک ظرفیت آزاد بیشتر از ظرفیت پایه، پیش از اجرای اندازهگیری افزایش ظرفیت در این مقاله. - کد استقرار موجود در مخزن GitHub معرفیشده در این مقاله.
راهنمای اجرا
در پایان این مراحل، یک سیاست مقیاسپذیری خودکار فعال برای Kokoro-82M در Amazon SageMaker AI خواهید داشت که بهطور کامل از دو اندازهگیری روی نقطه پایانی خودتان به دست آمده است، نه از مقادیر حدسی.
استقرار پشتههای نقطه پایانی
استقرار نقطه پایانی از طریق سه پشته AWS CDK و به ترتیب مشخص انجام میشود. SpeechFoundationStack نقشهای IAM و مخزن Amazon S3 مورد استفاده برای ذخیره موقت وزنهای مدل را ایجاد میکند. SpeechModelCacheStack وزنهای مدل را از Hugging Face یک بار در آن مخزن همگامسازی میکند. در نهایت، SpeechEndpointStack تصویر کانتینر را میسازد، آن را به Amazon ECR میفرستد و مدل، پیکربندی نقطه پایانی و خود نقطه پایانی را در Amazon SageMaker AI ایجاد میکند.
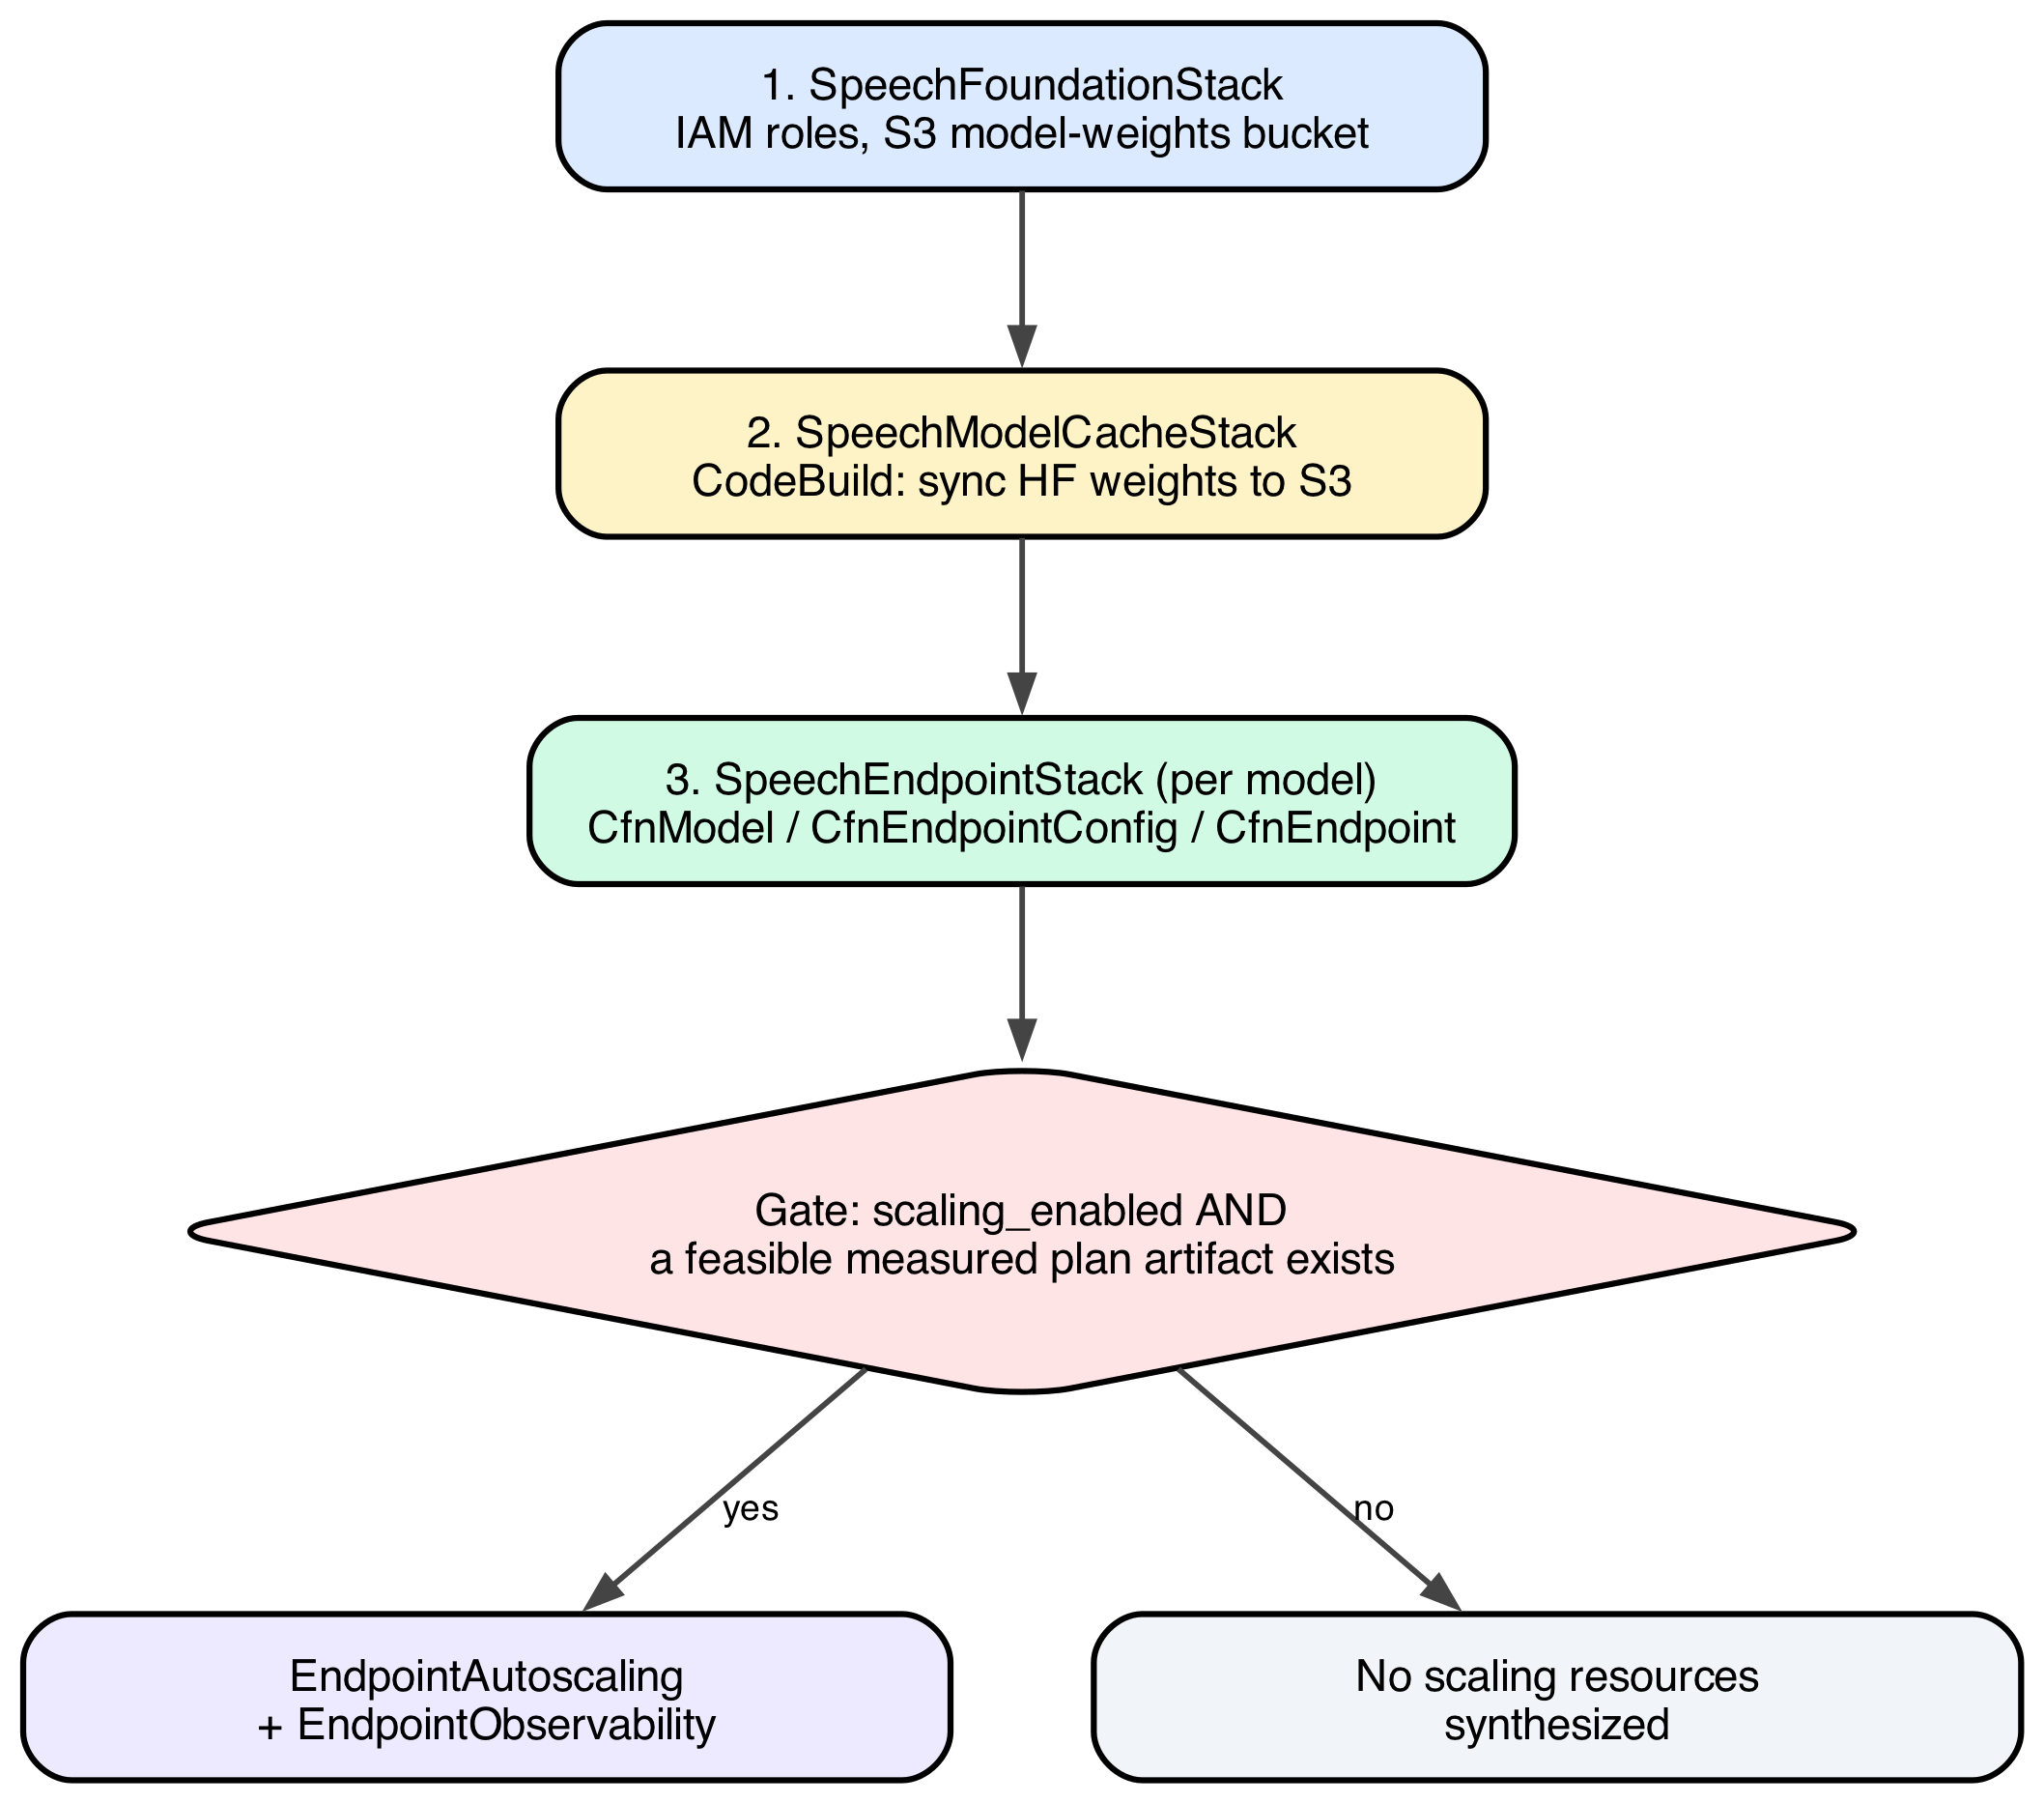
شرطی که در پشته سوم تعبیه شده است، مانع ورود پیکربندی پیشفرض و اندازهگیرینشده مقیاسپذیری به محیط عملیاتی میشود. scaling_enabled یک پرچم ایستا است که هرگاه max_instances بزرگتر از min_instances تنظیم شده باشد، مقدار درست میگیرد. این پرچم بهتنهایی هیچ اطلاعاتی درباره اندازهگیریشدن یا نشدن اعداد مبنای پیکربندی نمیدهد. پشته هنگام ساخت نیز یک بررسی مستقل دیگر انجام میدهد: آیا برای این مدل، یک فایل واقعی و امکانپذیر از نوع plan وجود دارد؟ تنها در صورت برقرار بودن هر دو شرط، منابع مقیاسپذیری ساخته میشوند: سازه EndpointAutoscaling که سیاست مقیاسپذیری و هشدارها را به هم متصل میکند، و سازه EndpointObservability که داشبوردها و هشدارهای لازم برای پایش را اضافه میکند. اگر برای مدلی scaling_enabled=True باشد اما هیچ اندازهگیریای انجام نشده باشد، خروجی آن نیز مانند حالتی که scaling_enabled=False است، شامل عبارت no scaling resources خواهد بود؛ یعنی هیچ منبع مقیاسپذیری ساخته نمیشود.
رابط خط فرمان پروژه، اجرای هر سه پشته را در یک دستور واحد و با رعایت ترتیب وابستگیها امکانپذیر میکند:
uv run speech-infra deploy kokoro-82mپشته SpeechModelCacheStack یک پروژه AWS CodeBuild را اجرا میکند که وزنهای مدل را از Hugging Face یک بار با مخزن کششده Amazon S3 همگام میسازد. به این ترتیب، هنگام راهاندازی سرد نقطه پایانی نیازی به دریافت وزنها از اینترنت نیست. سپس، مشروط به بررسی قبلی scaling_enabled، پشته SpeechEndpointStack تصویر کانتینر را میسازد، آن را به Amazon ECR میفرستد و مدل، پیکربندی نقطه پایانی و خود نقطه پایانی را در Amazon SageMaker AI ایجاد میکند.
روش کار در قالب زنجیرهای از ابزارهای خط فرمان پیادهسازی شده است که باید به ترتیب مشخص اجرا شوند:

مرحله اول: بررسی اختلاف وضعیت
فرمان drift باید هر بار در ابتدای کار اجرا شود؛ پیش از انجام هر کاری که هزینه ایجاد میکند یا نقطه پایانی را زیر بار قرار میدهد. این فرمان بدون تغییر منابع، وضعیت واقعی استقرار، از جمله اهداف مقیاسپذیر، سیاستهای مقیاسپذیری و وضعیت هشدارها را با آنچه در فایل پیکربندی تعریف شده است، مقایسه میکند. در غیر این صورت، یک سیاست باقیمانده از مدل قبلی یا اجرای متوقفشده یا لغوشده qmax یا ttotal ممکن است بیسروصدا ظرفیت را در میانه اندازهگیری تغییر دهد و نتایج را مخدوش کند.
uv run tts-bench driftاگر وضعیت پاک باشد، فرمان هیچ مغایرتی گزارش نمیکند و با وضعیت preflight-ok پایان مییابد؛ در این صورت میتوان به سراغ qmax رفت. اجرای متوقفشده یا لغوشده qmax یا ttotal رایجترین علت گزارش مغایرت است، زیرا ممکن است مقیاسپذیری خودکار را در وضعیتی باقی بگذارد که فقط یک نمونه فعال باشد. دستور uv run tts-bench thaw --endpoint speech-kokoro-82m سیاست مستقرشده را به حالت تعریفشده در پیکربندی بازمیگرداند. پیش از ادامه باید این کار انجام شود، زیرا هر دو فرمان qmax و ttotal فرض میکنند وضعیت واقعی استقرار دقیقاً با فایل پیکربندی مطابقت دارد.
مرحله دوم: اندازهگیری Q_max، سقف درخواستهای همزمان
Q_max بیشترین تعداد درخواستهای همزمان، شامل درخواستهای در صف و درخواستهای در حال اجرا روی یک نمونه، است که در آن زمان رسیدن نخستین بایت صوتی به صدک ۹۵ همچنان در محدوده SLO باقی میماند. این مقدار با یک آزمون بار حلقهبسته و نردبانی اندازهگیری میشود: تعداد ثابتی از درخواستهای همزمان با مقدار N دقیقاً حفظ میشود و سپس N مرحلهبهمرحله افزایش مییابد تا SLO نقض شود. حلقهبسته بودن آزمون از پدیده حذف هماهنگشده (coordinated omission) جلوگیری میکند؛ مشکلی که در آزمونهای دارای نرخ ورود ثابت رخ میدهد، زیرا با کندشدن سرور، کلاینت درخواستهای کمتری میفرستد و در نتیجه تأخیر واقعی ناشی از انتظار در صف بهدرستی آشکار نمیشود.
uv run tts-bench qmax --model kokoro-82m --dry-run
uv run tts-bench qmax --model kokoro-82m
گزینه --dry-run برنامه اجرا و برآورد مدتزمان واقعی آن را بدون هیچ فراخوانی به AWS نمایش میدهد تا پیش از اجرای زنده بتوانید هزینه اجرای تقریباً ۳۶دقیقهای را برآورد کنید. فرمان اصلی، مقیاسپذیری خودکار را در طول آزمون متوقف میکند و ظرفیت را روی یک نمونه ثابت نگه میدارد. پس از پایان اجرا، وضعیت بهطور خودکار بازگردانده میشود؛ بنابراین عدد حاصل واقعاً سقف ظرفیت یک نمونه را نشان میدهد.
آزمون نردبانی بار، نتایج زیر را ثبت کرد:
| تعداد درخواستهای همزمان | صدک ۹۵ زمان رسیدن نخستین بایت صوتی (میلیثانیه) | رعایت SLO برابر با ۳۰۰۰ میلیثانیه؟ |
|---|---|---|
| ۱ | ۶۵٫۴ | بله |
| ۵ | ۲۸۶٫۲ | بله |
| ۱۰ | ۵۶۸٫۵ | بله |
| ۲۰ | ۱٬۱۲۹٫۳ | بله |
| ۳۰ | ۱٬۶۸۹٫۸ | بله |
| ۴۰ | ۲٬۲۴۵٫۰ | بله |
| ۵۰ | ۲٬۸۰۵٫۷ | بله؛ مقدار Q_max |
| ۶۰ | ۳٬۳۷۴٫۸ | خیر؛ نقض SLO |
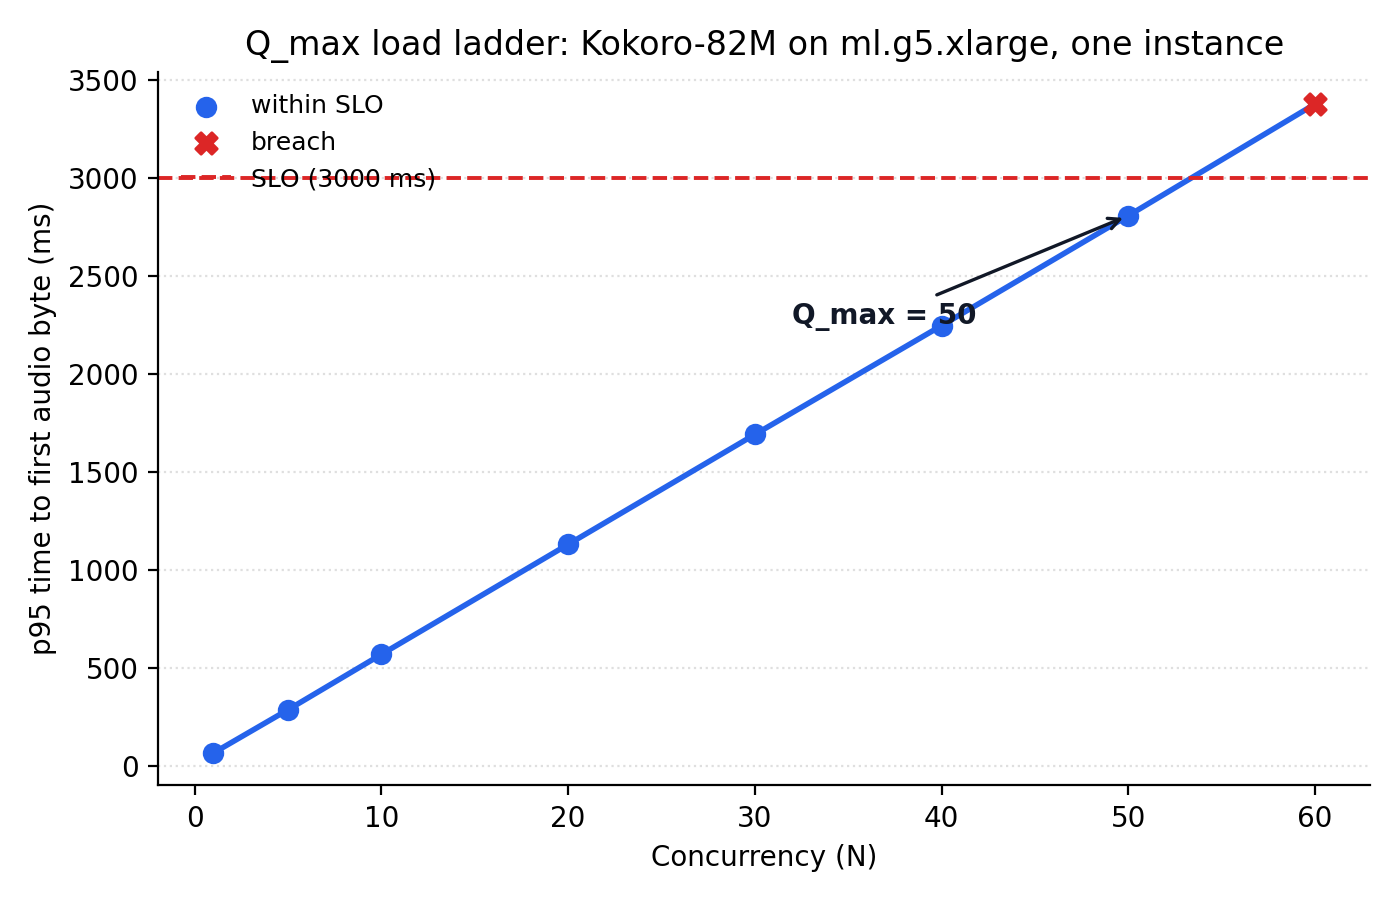
نتیجه این است که Q_max = 50. این مقدار با آزمونی مشخص در دو سوی آستانه تأیید شده است: مرحله ۶۰ درخواست همزمان واقعاً از SLO عبور کرد؛ بنابراین، عدد ۵۰ یک سقف اندازهگیریشده است، نه صرفاً یک حد پایین. در همین اجرا، زمان خدمترسانی بدون رقابت نیز اندازهگیری شد؛ یعنی زمانی که یک درخواست بدون انتظار در صف پردازش میشود. میانگین این زمان ۶۱٫۳ میلیثانیه و مقدار صدک ۹۵ آن ۶۶٫۱ میلیثانیه بود. این عدد دوم مبنای یک هشدار مستقل دیگر خواهد بود که در ادامه توضیح داده میشود.
مرحله سوم: اندازهگیری T_total، زمان واقعی افزایش ظرفیت
T_total مدتزمان سپریشده از لحظه درخواست ظرفیت بیشتر تا زمانی است که ظرفیت جدید بتواند ترافیک سالم را پردازش کند. برای اندازهگیری آن، افزایش ظرفیت را مستقیماً وادار به اجرا میکنیم و منطق تشخیص و تصمیمگیری سیاست مستقرشده را دور میزنیم؛ سپس زمان هر مرحله قابل تشخیص را ثبت میکنیم.
uv run tts-bench ttotal --model kokoro-82m --qmax <qmax-artifact>فرمان ttotal به فایل خروجی qmax نیاز دارد، زیرا ارزیابی بازیابی سرویس بر اساس مراحل اندازهگیریشده در همان آزمون نردبانی انجام میشود. همچنین، این فرمان از اجرا روی آزمونی که با روش انتقال داده متفاوتی اندازهگیری شده باشد، خودداری میکند.
فرایند افزایش اجباری ظرفیت به هشت مرحله اندازهگیریشده تقسیم شد:
| مرحله | مدتزمان | سهم از T_total |
|---|---|---|
| از درخواست ظرفیت تا ثبت desired_set | ۳۰٫۰ ثانیه | ۹٫۴٪ |
| از desired_set تا مشاهده نمونه در گزارشها | ۱۸۰٫۸ ثانیه | ۵۶٫۵٪؛ مرحله غالب |
| از مشاهده نمونه تا شروع کانتینر | ۳٫۷ ثانیه | ۱٫۲٪ |
| از شروع کانتینر تا framework_init | ۰٫۰ ثانیه | ۰٫۰٪ |
| از framework_init تا آمادهشدن وزنها | ۶٫۵ ثانیه | ۲٫۰٪ |
| از آمادهشدن وزنها تا پایان گرمسازی | ۱٫۰ ثانیه | ۰٫۳٪ |
| از پایان گرمسازی تا ورود به سرویس | ۲۰٫۷ ثانیه | ۶٫۵٪ |
| از ورود به سرویس تا بازیابی ترافیک | ۴۷٫۴ ثانیه | ۱۴٫۸٪ |
| مجموع اندازهگیریشده (t_total_s) | ۲۶۰٫۲ ثانیه | |
| بهعلاوه تأخیر تشخیص سیاست؛ مقدار محدودشده و اندازهگیرینشده | ۶۰٫۰ ثانیه | |
| مقدار مبنای برنامهریزی T_total | ۳۲۰٫۲ ثانیه |
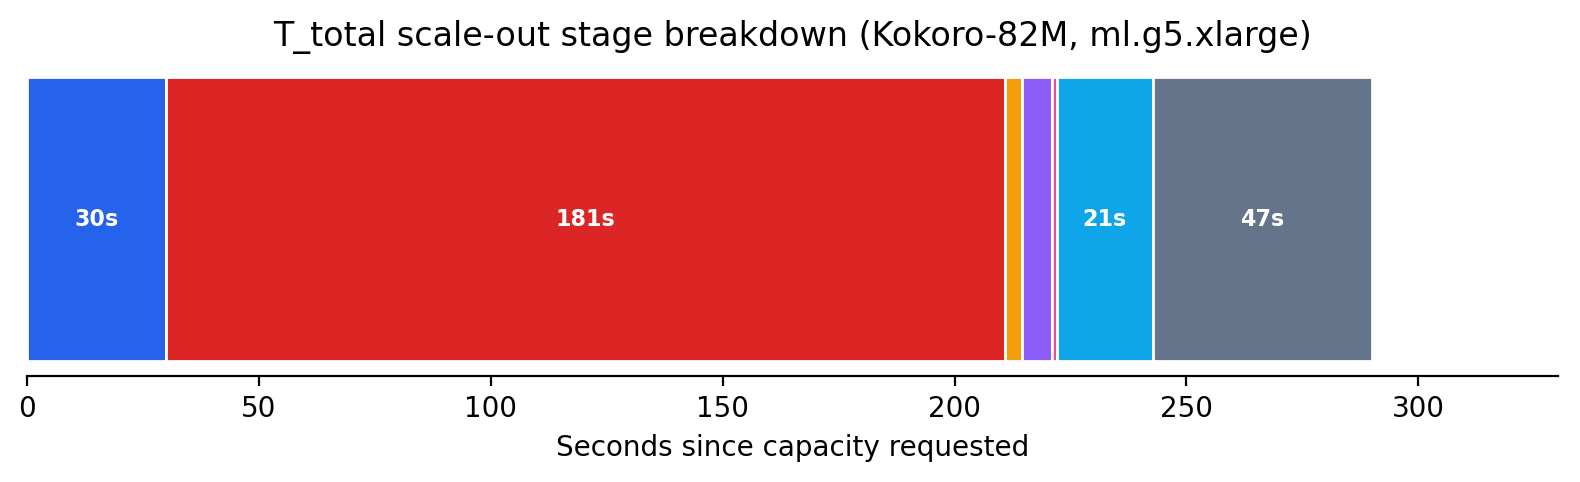
طولانیترین مرحله، تأمین نمونه در Amazon Elastic Compute Cloud (Amazon EC2) بهعلاوه دریافت تصویر کانتینر است که ۱۸۱ ثانیه طول میکشد و ۵۶ درصد از کل زمان مبنای برنامهریزی را تشکیل میدهد. مؤثرترین راه برای کاهش T_total، تغییر کد برنامه نیست، بلکه کاهش حجم تصویر کانتینر یا استفاده از مخازن ظرفیت گرم است. مجموع تمام مراحل پس از «مشاهده نمونه در گزارشها» در مقایسه با آن، تنها ۷۹ ثانیه است.
۶۰ ثانیهای که به زمان اندازهگیریشده ۲۶۰٫۲ ثانیه افزوده شده، در این اجرا مستقیماً اندازهگیری نشده است. این مقدار بر اساس پیکربندی خود سیاست محدود شده و از حاصلضرب دوره ارزیابی هشدار در تعداد دورههای ارزیابی، بهعلاوه زمان انتظار پس از مقیاسپذیری، به دست آمده است. دلیل این کار آن است که منطق تشخیص سیاست عمداً دور زده شد تا زمان خالص تأمین ظرفیت جداگانه اندازهگیری شود. بااینحال، فرمان plan فضای ظرفیت اضافی مورد نیاز را بر اساس کل ۳۲۰٫۲ ثانیه محاسبه میکند، زیرا این زمان واکنش بخشی واقعی از افزایش ظرفیت در محیط عملیاتی است، حتی اگر در اندازهگیری حاضر لحاظ نشده باشد.
مرحله چهارم: استخراج سیاست نهایی با فرمان plan
فرمان plan تنها فرمانی است که هیچ تغییری در منابع AWS ایجاد نمیکند. این فرمان فایلهای خروجی qmax و ttotal را میخواند و با دو ورودی انتخابشده توسط اپراتور ترکیب میکند: SLO برابر با ۳۰۰۰ میلیثانیه برای صدک ۹۵ زمان رسیدن نخستین بایت صوتی، و نسبت ظرفیت اضافی ۱٫۲۵ برابر؛ یعنی مجموعه نمونهها باید بتواند افزایش ۲۵درصدی ترافیک را در طول یک چرخه افزایش ظرفیت، بدون نقض SLO تحمل کند. سپس محاسبات زیر را انجام میدهد و گزارشی ارائه میکند که برای هر نتیجه یکی از وضعیتهای ok، warn یا، در صورت غیرقابلاجرا بودن واقعی برنامه، stop را مشخص میکند.
uv run tts-bench plan --qmax <qmax-artifact> --ttotal <ttotal-artifact> --peak-rps 5000گزینه --peak-rps که در این مثال برابر با ۵۰۰۰ درخواست در ثانیه است و در کنار نرخ فرضی ۱۰ درخواست در ثانیه در کمترین سطح ترافیک به کار میرود، تعداد نمونههای مورد نیاز را تعیین میکند. این گزینه در محاسبه آستانههای زیر دخالتی ندارد.
h = surge_ratio - 1 = 1.25 - 1 = 0.25
C_scale_max = (1 - h) x Q_max = 0.75 x 50 = 37.50
C_scale_min = (1 - 2h) x Q_max = 0.50 x 50 = 25.00

W_max = SLO - S_p95 = 3.000s - 0.066s = 2.934s
مقدار C_scale_max سطح همزمانیای است که با رسیدن به آن یک نمونه دیگر اضافه میشود. این مقدار بهاندازه نسبت ظرفیت اضافی h پایینتر از Q_max قرار میگیرد تا هنگام درخواست ظرفیت بیشتر، همچنان فضای کافی برای افزایش صف وجود داشته باشد. مقدار C_scale_min سطحی است که در آن یا پایینتر از آن یک نمونه حذف میشود. این آستانه برابر با (1 - 2h) ضربدر Q_max است تا کاهش ظرفیت تنها پس از افت محسوس بار و فاصلهگرفتن آن از آستانه افزایش ظرفیت انجام شود.
پیکربندی نهایی مستقرشده، دقیقاً مطابق خروجی ابزار، به این صورت است:
"kokoro-82m": ModelEndpointConfig(
 model_name="kokoro-82m",
 instance_type="ml.g5.xlarge",
 min_instances=1, # trough 10 rps; 3 is the smallest safe floor for scale-in
 max_instances=9, # peak 5000 rps
 scaling_target_value=37.500, # C_scale_max, in Amazon CloudWatch units (ratio measured as 1.0)
 scale_in_threshold=25.000, # C_scale_min, in Amazon CloudWatch units
 ttfab_slo_ms=3000,
 queue_max_depth=50, # enforced by the container's own admission gate
 scale_out_cooldown_s=30, # short: one instance added at a time
 scale_in_cooldown_s=960, # long: see below
)
دو زمان انتظار پس از مقیاسپذیری عمداً با یکدیگر متفاوتاند. در افزایش ظرفیت، اشتباهکردن هزینه نسبتاً کمی دارد: در بدترین حالت، هزینه یک نمونه غیرضروری را برای ۳۰ ثانیه اضافی میپردازید. اما کاهش ظرفیت چنین وضعیتی ندارد؛ اگر ظرفیتی حذف شود و بعد دوباره مورد نیاز باشد، جایگزینی آن به کل زمان T_total، یعنی حدود ۳۲۰ ثانیه، نیاز دارد. به همین دلیل، زمان انتظار کاهش ظرفیت تقریباً سه برابر T_total تنظیم شده است تا تصمیم به کاهش ظرفیت فقط پس از افت واقعی و پایدار بار اجرا شود.
کنترل پذیرش درخواست در خود کانتینر نیز بهطور مستقل queue_max_depth=50 را اعمال میکند که با Q_max برابر است. وقتی عمق صف از این مقدار عبور کند، درخواست بلافاصله با پاسخ 503 queue_saturated رد میشود، بهجای آنکه در صف باقی بماند و از نقطهای عبور کند که دیگر امکان رعایت SLO وجود ندارد. هشدار FirstChunkLatencyP95 نیز با آستانه ۶۵ میلیثانیه تنظیم شده است؛ این مقدار بر اساس زمان خدمترسانی اندازهگیریشده در صدک ۹۵، در همزمانی یک درخواست، تعیین شده است. این هشدار زمان خدمترسانی یک نمونه فعال را پایش میکند و از SLO سرتاسری که زمان انتظار در صف را نیز شامل میشود، سختگیرانهتر است.
دو نتیجه حاصل از اجرای Kokoro-82M نیز شایان توجهاند، زیرا ابزار بهدرستی یک مصالحه شناختهشده و پذیرفتهشده را آشکار میکند، نه یک نقص فنی را:
surge_survivalبا وضعیت warn: تنظیمC_scale_maxروی ۳۷٫۵ در مقایسه باQ_maxبرابر با ۵۰ باعث میشود همان لحظه که افزایش ظرفیت آغاز میشود، میزان استفاده از یک نمونه به ۹۷٫۴ درصد برسد؛ درحالیکه رسیدن نمونه جایگزین به سرویس به کل زمانT_totalنیاز دارد. نسبت ظرفیت اضافی فضای بیشتری در صف رزرو میکند، اما تحمل یک افزایش واقعی ترافیک به جریان درخواستها و سرعت تخلیه صف نیز وابسته است. در سطح استفاده ۹۷٫۴درصدی، فضای اندکی برای مدیریت جریان باقی میماند.scale_in_safetyبا وضعیت warn: حذف یک نمونه از مجموعهای شاملNنمونه، همزمانی هر نمونه باقیمانده را به ضریبN / (N-1)افزایش میدهد. کاهش ظرفیت تنها زمانی پایدار میماند که این نسبت ازC_scale_max / C_scale_min، که در این مثال ۱٫۵ است، بیشتر نباشد؛ شرطی که بهN >= 3نیاز دارد. اگر حداقل ظرفیت یک نمونه باشد، کاهش از دو نمونه به یک نمونه، بار نمونه باقیمانده را دقیقاً بهQ_maxمیرساند؛ یعنی دوباره به سقفی که افزایش ظرفیت را فعال میکند. زمان انتظار طولانی، نوسان مکرر بین افزایش و کاهش ظرفیت را مهار میکند، اما آن را کاملاً از بین نمیبرد. افزایش حداقل ظرفیت به سه نمونه، این مشکل را از نظر ساختاری برطرف میکند، اما هزینه نگهداشتن ظرفیت در زمان کمبودن ترافیک را افزایش میدهد.
نام فایل هر خروجی qmax یا ttotal پیکربندیای را که اندازهگیری بر اساس آن انجام شده است، مشخص میکند. نوع نمونه و شناسه خلاصهشده اثرانگشت تصویر کانتینر در قالب یک شناسه متنی در نام فایل قرار میگیرند؛ برای مثال، g5xlarge-8b1b96bc. هر دو فرمان ttotal و plan در صورت ناسازگاری اثرانگشت فایلها، از ترکیب آنها خودداری میکنند. میتوان این الزام را با گزینه --allow-config-mismatch به یک هشدار تنزل داد، اما رفتار پیشفرض ابزار، ردکردن ترکیب ناسازگار است.
مرحله پنجم: تأیید سیاست مستقرشده با validate
فرمان validate آخرین مرحله زنجیره است و در کنار drift دومین فرمانی محسوب میشود که هیچ منبعی را تغییر نمیدهد. این فرمان سیاست مقیاسپذیری مستقرشده را با مقادیر ثبتشده در فایل خروجی plan مقایسه میکند و پیش از آنکه پیکربندی را فعال و معتبر تلقی کنید، مطابقت آنها را تأیید میکند.
uv run tts-bench validate --model kokoro-82m --plan <plan-artifact>در صورت موفقیت، فرمان تأیید میکند که scaling_target_value، scale_in_threshold و هر دو زمان انتظار پس از مقیاسپذیری در هدف مقیاسپذیر مستقرشده با مقادیر محاسبهشده توسط plan مطابقت دارند. هرگونه مغایرت به این معناست که سیاست مستقرشده و برنامه مبتنی بر اندازهگیری از یکدیگر فاصله گرفتهاند؛ پیش از اتکا به رفتار مقیاسپذیری خودکار نقطه پایانی، باید این اختلاف برطرف شود.
آزمون و اعتبارسنجی
تمام فایلهای خروجی qmax، ttotal و plan که در این مقاله به آنها اشاره شده، فایلهای ثبتشده در مخزن هستند، نه خروجیهای موقتی که فقط روی یک دستگاه محلی تولید شده باشند. مثال کامل بالا، شامل تمام اعداد، با اجرای دوباره plan روی دو فایل اندازهگیری ثبتشده، بدون هیچ فراخوانی به AWS و بدون ایجاد هزینه جدید، مستقلاً قابل بازتولید است:
$ uv run tts-bench plan --qmax <qmax-artifact> --ttotal <ttotal-artifact> --peak-rps 5000
scaling_target_value : 37.500 (C_scale_max)
scale_in_threshold : 25.000 (C_scale_min)
surge_survival : warn
scale_in_safety : warnپاکسازی منابع
برای حذف منابع ایجادشده در این راهنما، پشتهها را به ترتیب معکوس و با یک فرمان حذف کنید:
uv run speech-infra destroy kokoro-82mفرمان speech-infra destroy مدل، پیکربندی نقطه پایانی، خود نقطه پایانی و هرگونه منابع مقیاسپذیری خودکار یا Amazon CloudWatch متصل به آن را حذف میکند. اما این فرمان مخزن Amazon S3 حاوی وزنهای مدل یا مخزن Amazon ECR نگهدارنده تصویر کانتینر را پاک یا حذف نمیکند، زیرا هر دو ممکن است میان چند مدل مشترک باشند. اگر دیگر به آنها نیازی ندارید، باید مخزن Amazon S3 را بهصورت دستی خالی و حذف کنید و مخزن Amazon ECR را نیز جداگانه از بین ببرید؛ در غیر این صورت، فایل وزنهای ذخیرهشده مدل و تصویر کانتینر تا زمان حذف همچنان هزینه اندکی برای فضای ذخیرهسازی ایجاد میکنند.
جمعبندی
با استقرار Kokoro-82M در قالب یک کانتینر سفارشی روی نقطه پایانی بلادرنگ Amazon SageMaker AI میتوان حدسوگمان را با دو اندازهگیری روی نقطه پایانی فعال جایگزین کرد: Q_max، حداکثر تعداد درخواستهای همزمانی که یک نمونه پیش از نقض SLO تحمل میکند، و T_total، زمان واقعی افزایش ظرفیت. آستانه افزایش ظرفیت، آستانه کاهش ظرفیت و هر دو زمان انتظار میان تصمیمهای مقیاسپذیری از این دو عدد محاسبه میشوند. استفاده از معیار بومی ConcurrentRequestsPerModel که AWS منتشر میکند و اندازهگیری مستقیم تبدیل واحد آن، بهجای فرضگرفتن این تبدیل، پیکربندی را به میزان واقعی همزمانی درخواستها متصل نگه میدارد.
نتیجه، سیاست مقیاسپذیری خودکاری است که هر عدد آن به اندازهگیری واقعی روی نقطه پایانی خود کاربر بازمیگردد، نه فرضی که از نوع دیگری از بار کاری به ارث رسیده باشد. همین تفاوت، پیکربندی حدسی را که ممکن است بیسروصدا هزینه اضافی ایجاد کند یا SLO را نقض کند، به سیاستی قابل دفاع تبدیل میکند؛ سیاستی که هم سقف همزمانی و هم زمان افزایش ظرفیت آن اندازهگیری شدهاند، نه اینکه صرفاً ادعا شوند.
این مدل چهارعددی، شامل SLO و نسبت ظرفیت اضافی انتخابشده، مقادیر اندازهگیریشده Q_max و T_total و سایر مقادیر محاسبهشده از آنها، به TTS محدود نیست. این روش برای نقاط پایانی بلادرنگ Amazon SageMaker AI که به تأخیر حساساند و ظرفیت آنها به تعداد درخواستهای همزمان بستگی دارد نیز قابل استفاده است. برای مثال، یک نقطه پایانی بلادرنگ تولید بردارهای تعبیه تصویری که هر درخواست را در طول اجرای گذر رو به جلوی GPU باز نگه میدارد، با همان سقف همزمانی محدود میشود، نه لزوماً با معیار توان عملیاتی. همان زنجیره qmax، ttotal و plan بدون تغییر قابل استفاده است. در چنین حالتی نیز گلوگاه اصلی، تعداد درخواستهای همزمان در حال پردازش است، نه یک معیار توان عملیاتی که از نوع دیگری از بار کاری اقتباس شده باشد. اعداد این مثال، یعنی Q_max=50 و T_total=320s، برای مدل Kokoro-82M روی ml.g5.xlarge معتبرند. این اعداد برای مدل یا نوع نمونه دیگری متفاوت خواهند بود، اما روش و ابزارهای تولید آنها تغییری نمیکنند. زنجیره پنجفرمانی drift، qmax، ttotal، plan و validate برای مدل بعدی که به همین روش مستقر میکنید نیز قابل استفاده است.
مخزن نمونه پروژه را دریافت کنید و سپس پنج فرمان drift، qmax، ttotal، plan و validate را روی نقطه پایانی خود اجرا کنید تا سیاستی مبتنی بر اندازهگیری به دست آورید. برای تطبیق آستانهها با SLO مورد نظر خود، مستندات مقیاسپذیری خودکار Amazon SageMaker AI را بررسی کنید و سپس در کنسول SageMaker AI واکنش سیاست به ترافیک زنده را زیر نظر بگیرید. اگر برای ساخت استقراری مشابه با رویکرد مبتنی بر اندازهگیری به کمک نیاز دارید، با تیم حساب AWS خود تماس بگیرید.