
پژوهش آنتروپیک دربارهٔ راستیآزمایی صوری: کلود چه چیزی را اثبات کرد؟
پژوهش تازهٔ آنتروپیک دربارهٔ راستیآزمایی صوری، استدلالی جدی به سود استفاده از هوش مصنوعی برای تولید شواهد امنیتی ارائه میکند؛ شواهدی که یک بررسیکنندهٔ ریاضی مستقل بتواند آنها را ارزیابی کند. این رویکرد ممکن است شیوهای را تغییر دهد که تیمهای نرمافزاری برای اطمینان از امنیت برنامههای حیاتی به کار میگیرند. برای درک ارزش این دستاورد، باید قضیهٔ ریاضی پشت ادعاها را بررسی کرد.
آنتروپیک و شرکت تئورم در پژوهشی که ۲۲ اکتبر منتشر شد، از تولید برهان برای ۲۳۹ نقطهٔ ورودی آزمون فازینگ در ۱۲۳ کتابخانهٔ متنباز خبر دادهاند. کلود حدود ۱۸۰ میلیون خط کد برهان به زبان روک (Rocq) تولید کرده که پذیرفته شدهاند. تضمینهای حاصل به برنامههای کامپایلشدهٔ مشخصی، تحت شرایط تعریفشده و از جمله محدودیت اندازهٔ ورودی، مربوط میشوند. اعلامیهٔ آنتروپیک این دستاورد را موفقیتی مهندسی در مقیاسی چشمگیر توصیف میکند.
بااینحال، نکتهای مهم در نسخهٔ عمومی منتشرشده وجود دارد: برهانهای آن ثابت نمیکنند که اجرای برنامهها همیشه پایان مییابد. این تمایز باید از همان ابتدا در هر بررسی جدی از این پژوهش مطرح شود.
از نظر من، امیدوارکنندهترین تحول در اینجا شکلگیری تقسیم کاری شفافتر و قابلممیزیتر است. هوش مصنوعی میتواند در مقیاسی بسیار بزرگ به جستوجوی برهان بپردازد، اما پذیرش نتیجه به گزارههای صریح و بررسی ماشینی وابسته است. میزان سودمندی این روش در نهایت به کیفیت گزارهها و ارتباط آنها با نرمافزاری بستگی دارد که واقعاً در محیط عملیاتی اجرا میشود.
نتایج گزارششدهٔ آزمایش با شواهد نسخهٔ عمومی یکسان نیستند
فهرست عمومی برهانها در نسخهٔ مخزن بررسیشده برای این مقاله، ۶۰ نقطهٔ ورودی را در ۲۵ کتابخانه ثبت کرده است. برای چند نقطهٔ ورودی، برهانهایی با بیش از یک پیکربندی پاکساز (sanitizer) وجود دارد؛ بنابراین، تعداد نقاط ورودی با تعداد گزارههای اثباتشده یکسان نیست.
نسخهٔ منتشرشده شامل ۱۳۸ گزارهٔ اثباتشده است. در فهرست میتوان نمونههایی از نقاط ورودی مربوط به cJSON، simdjson، OpenSSL و zstd را مشاهده کرد. حضور نام یک کتابخانه در این فهرست به معنای پوشش اهداف و گزارههای مشخصشده است، نه تأیید صحت کل کتابخانه.
| نوع شواهد | آنچه را مشخص میکند |
|---|---|
| آزمایش گزارششدهٔ آنتروپیک: ۲۳۹ نقطهٔ ورودی در ۱۲۳ کتابخانه | شرح پژوهشگران از دامنهٔ گستردهتر پروژه |
| فهرست عمومی برهانها: ۶۰ نقطهٔ ورودی، ۲۵ کتابخانه و ۱۳۸ گزاره | دامنهٔ مجموعهٔ برهانهای منتشرشده که در این مقاله بررسی شده است |
| فایل گزاره بدون برهان کاملشده | هدف راستیآزمایی که بهصورت دقیق صورتبندی شده است |
| اجرای موفق بررسیکنندهٔ مستقل | شواهدی مبنی بر اینکه برهان مشخص در محیط بررسی موردنظر پذیرفته شده است |
آنتروپیک میگوید برهانهایی را که ممکن است با آشکار کردن باگهای اصلاحنشده به سوءاستفاده از نرمافزار کمک کنند، منتشر نمیکند. بنابراین، کوچکتر بودن مجموعهٔ عمومی بهخودیخود با نتیجهٔ گستردهتر پژوهش تناقضی ندارد. بااینحال، خوانندگان بیرونی باید این دو مجموعهٔ شواهد را از یکدیگر تفکیک کنند.
در این مقاله، اعلامیه، پیوست فنی، مستندات عمومی و فهرست برهانها بررسی شدهاند. وبسایت Kingy.ai اجرای مجدد برهانهای روک یا بازتولید مستقل آزمایش کامل را انجام نداده است.
چگونه آزمون فازینگ به گزارهای قابلاثبات تبدیل میشود؟
در یک آزمون متعارف، ورودیای به برنامه داده میشود و نتیجهٔ آن بررسی میشود. ابزار فازینگ این فرایند را با ورودیهای متعددِ تولیدشده یا تغییریافته تکرار میکند. موفقیت یک کارزار آزمون، شواهد مفیدی دربارهٔ مواردی فراهم میکند که واقعاً آزمایش شدهاند. اما یک گزارهٔ ریاضی کلی، ادعای متفاوتی دارد: ویژگی موردنظر باید برای تمام ورودیهای واقع در دامنهٔ تعریفشده برقرار باشد.
نقطهٔ شروع عملی، مهارگاه فازینگ (fuzz harness) است؛ برنامهای کوچک که کتابخانه را فراخوانی میکند و امکان آشکار شدن خطاها را فراهم میسازد. محتوای این مهارگاه اهمیت زیادی دارد. مهارگاهی که بایتهای دلخواه را به یک رمزگشا میدهد و فقط وقوع خرابی را بررسی میکند، پرسشی محدودتر از مهارگاهی مطرح میکند که علاوه بر این، خروجی رمزگشاییشده را با نتیجهٔ یک پیادهسازی مرجع مقایسه میکند.
راهنمای گزارههای تئورم توضیح میدهد که میتوان ویژگیهای درستی را بهصورت شرطهایی در مهارگاه کدگذاری کرد که در صورت نقض، اجرای برنامه را متوقف کنند. این راهنما همچنین میان گزارههای مربوط به پایان یافتن اجرا و گزارههای مربوط به تطابق نسخهٔ عادی برنامه با نسخهٔ مجهز به ابزارهای پاکسازی خطا تمایز میگذارد. درایور ورودیهایی با طول ۶۴ مگابایت دودویی (MiB) یا بیشتر را نمیپذیرد. MiB واحدی مبتنی بر توانهای دو است و از این نظر، مستندات فنی دقیقتر از عبارت خلاصهشدهٔ «MB» در اعلامیه هستند.
یک مهارگاه فرضی برای فشردهسازی را در نظر بگیرید:
compressed = compress(input)
restored = decompress(compressed)
if restored != input:
 abort()
اگر این بررسی پس از کامپایل همچنان در برنامه وجود داشته باشد، برهانی مناسب که ثابت کند اجرا نمیتواند به دستور توقف ناشی از خطا برسد، هرگونه ناهماهنگی در رفتوبرگشت فشردهسازی و بازگشایی را در اجراهای تحت پوشش رد میکند. بااینحال، پرسشهای جداگانهای دربارهٔ پایان یافتن اجرا، مصرف منابع و رفتار برنامه در خارج از محیط تعریفشده باقی میمانند. این مثال صرفاً برای توضیح ایده است و نقلقولی از مهارگاه منتشرشده نیست.
این رویکرد میتواند تغییری مفید در مهندسی نرمافزار ایجاد کند. بهبود مهارگاه آزمون هم کیفیت آزمایشها را بالا میبرد و هم گزارهای را دقیقتر میکند که ممکن است در آینده اثبات شود. برای بیان یک ناوردای ارزشمند، لازم نیست تیمها از همان ابتدا مشخصات صوری کاملی برای کل برنامه بنویسند.
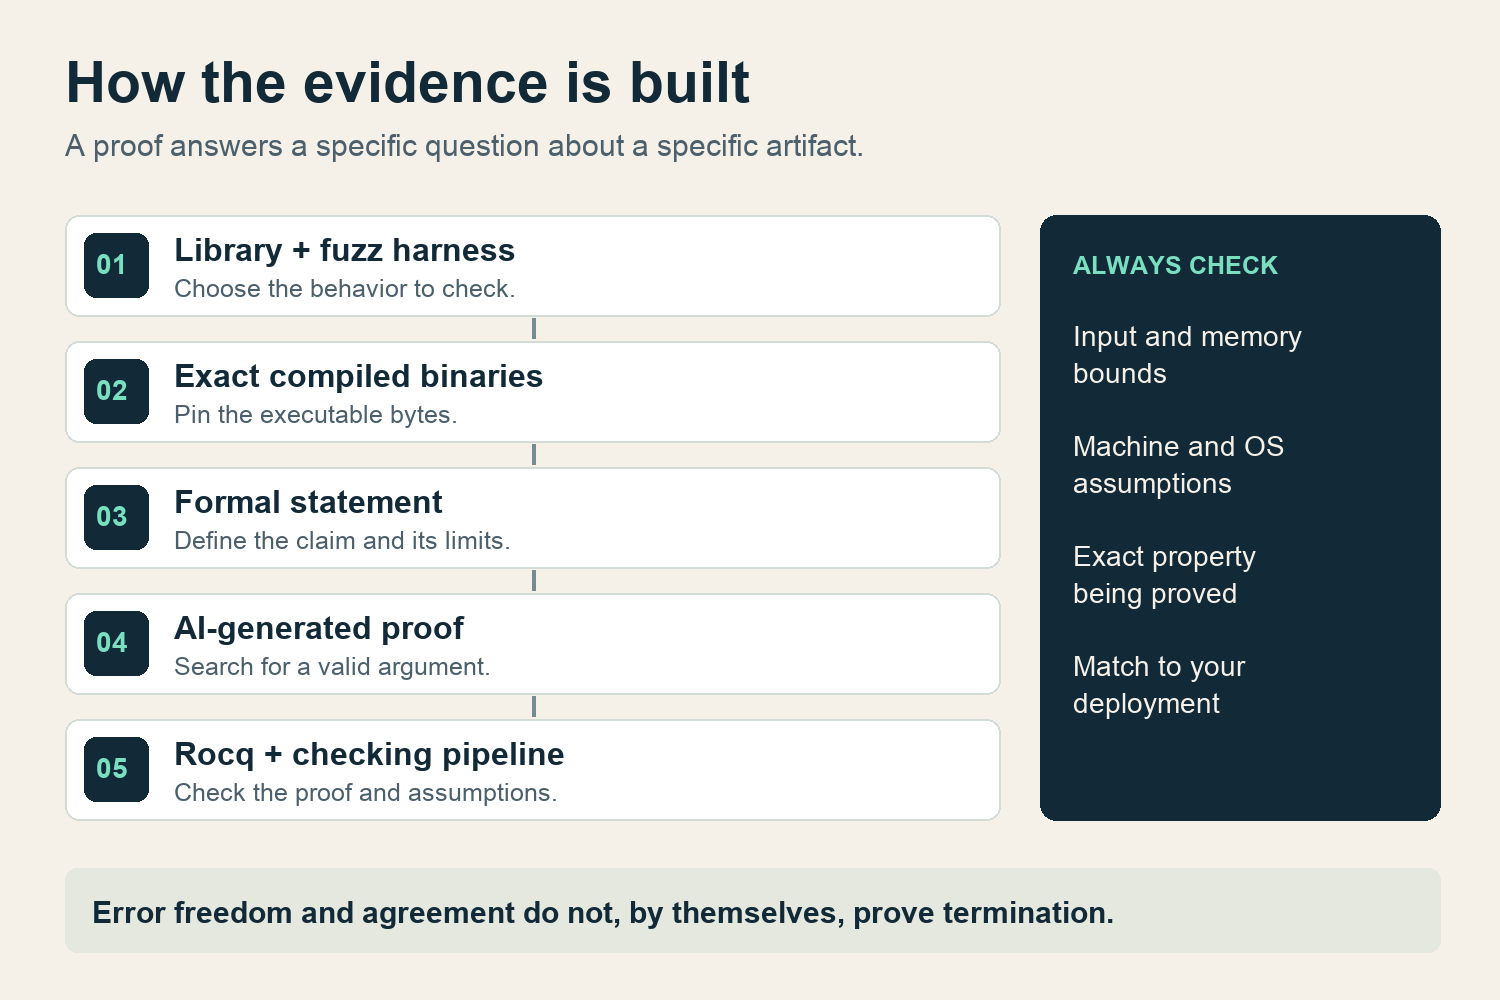
چرا برهانهای عمومی، پایان یافتن اجرا را ثابت نمیکنند؟
فایل README مخزن صریحاً اعلام میکند که هیچیک از برهانهای این نسخه، گزارهای مبنی بر پایان یافتن اجرا را اثبات نمیکند. یک گزارهٔ تطابق میتواند خطاها را رد کند و سازگاری میان نسخههای مختلف ساخت را نشان دهد، بیآنکه احتمال ادامه یافتن نامحدود یک اجرا را منتفی کند.
تعاریف صوری گزارهها این تعهدات را از هم جدا میکنند. یکسان فرض کردن آنها، دامنهٔ دستاورد منتشرشده را بیش از واقع نشان میدهد.
فرض کنید یک تجزیهگر به حلقهای بینهایت گرفتار شود و هرگز به اجرای بعدی نرسد. چنین برنامهای ممکن است یک پردازشگر را برای مدت نامحدود اشغال کند، بیآنکه دسترسی نامعتبر به حافظه رخ دهد. برای گردانندهٔ یک سرویس، این وضعیت همچنان میتواند مشکل جدی در دسترسپذیری ایجاد کند. اثبات نبود خطاهای مشخص، بهطور خودکار این مشکل را برطرف نمیکند.
حتی اثبات پایان یافتن اجرا نیز پرسش عملیاتی دیگری را بیپاسخ میگذارد: محاسبه چقدر طول میکشد؟ برنامهای که سرانجام تمام میشود، اما برای این کار به زمانی غیرعملی نیاز دارد، ممکن است همچنان الزامات تأخیر یا مصرف منابع یک سرویس را نقض کند. این الزامات به تعریفها و شواهد مستقل نیاز دارند.
به همین دلیل، بیان دقیق ویژگیهای امنیتی اهمیت دارد. واژهٔ «راستیآزماییشده» بهتنهایی برای تعیین یک الزام مفید در خرید یا پذیرش نرمافزار بیش از حد کلی است. تیم باید بداند نتیجه دقیقاً کدام موارد را پوشش میدهد: خطاهای حافظه، رفتار کارکردی، پایان یافتن اجرا، هزینهٔ محاسباتی یا ترکیبی از این موارد.
راستیآزمایی در سطح فایل اجرایی؛ رویکردی قدرتمند اما محدودکننده
قرارداد ساخت عمومی، ساختهای بازتولیدپذیر و مصنوعات مورد استفاده برای شناسایی آنها را شرح میدهد. برهانهای منتشرشده به فایلهای اجرایی ایستای لینوکس برای معماری RISC-V مربوطاند. در فایل README نیز کلنگ نسخهٔ ۲۰.۱.۸ و musl بهعنوان محیط کامپایلر و کتابخانهٔ استاندارد C معرفی شدهاند.
کار با بایتهای فایل اجرایی، موضوع ادعا را به هدفی مشخص و ملموس تبدیل میکند. در این روش، نیازی نیست جداگانه ثابت شود که یک مدل بازنویسیشده از کد منبع، توصیف دقیقی از فایل اجرایی واقعی است. در مقابل، تضمین حاصل بهطور خودکار با تغییر فرایند ساخت و صرفاً به دلیل باقی ماندن نام پروژه به نسخهٔ دیگری منتقل نمیشود.
فرض کنید شرکتی همان کتابخانه را روی سرور ARM اجرا کند، آن را بهصورت پویا به کتابخانهٔ C دیگری پیوند دهد و تنظیمات متفاوتی برای بهینهسازی فعال کند. یکسان بودن کد منبع اطلاعات مفیدی است، اما شرکت همچنان به شواهدی نیاز دارد که فایل اجرایی مستقرشده را به ادعای راستیآزماییشده مرتبط کند. صرف اینکه هر دو بسته شمارهٔ نسخهٔ یکسانی دارند، این ارتباط را ثابت نمیکند.
این موضوع بر محتوای پروندهٔ معتبر تضمین نرمافزار نیز تأثیر میگذارد. در کنار نام بسته، باید انتظار داشت که بازبین به نسخهٔ کد منبع، دستورالعمل ساخت، هش فایل اجرایی، شناسهٔ قضیه، نسخهٔ مدل و نتیجهٔ بررسی دسترسی داشته باشد. بدون این اطلاعات، تفسیر نشان تأیید راستیآزمایی پس از ساخت مجدد نرمافزار دشوار میشود.
بنابراین، راستیآزمایی در سطح فایل اجرایی ممکن است تقاضا برای ثبت دقیقتر منشأ و سوابق انتشار نرمافزار را افزایش دهد. این برداشت من از پیامدهای احتمالی این رویکرد است، نه نتیجهای دربارهٔ استقرار عملی که پژوهش آن را اثبات کرده باشد.
چه چیزهایی خارج از دامنهٔ تضمین باقی میمانند؟
مستندات مدل فرایند لینوکس محیطی عمداً محدود را توصیف میکنند. این مدل فقط یک رشتهٔ اجرایی را اجرا میکند و گردانندههای سیگنال را به اجرا درنمیآورد. مدل فایلسیستم نیز قابلیتهایی مانند مجوزهای دسترسی و پیوندهای نمادین را در بر نمیگیرد. مستندات، مدل را ناقص میخوانند و فرضهایی را مشخص میکنند که بررسی نمیشوند.
این محدودیتها پیامد مستقیمی برای تفسیر نتایج دارند. ادعایی که در چارچوب این مدل اثبات شده است، درستی سازوکار همگامسازی در یک برنامهٔ همزمان را ثابت نمیکند. همچنین، اگر قواعد مجوزدهی فایلسیستم در مدل وجود نداشته باشند، چنین ادعایی نمیتواند تکلیف آن قواعد را در یک محیط عملیاتی واقعی روشن کند.
محدودیت حافظه نیز بخشی از قضیه است. گزارههای تطابق منتشرشده هنگام مقایسهٔ نسخهٔ عادی برنامه با نسخهٔ مجهز به AddressSanitizer، بودجهٔ حافظهای ۲ گیبیبایت و هنگام مقایسه با UndefinedBehaviorSanitizer، بودجهٔ ۱۶ گیبیبایت را در نظر میگیرند. طبق فایل README نسخهٔ منتشرشده، ورودیهایی که به حافظهای بیش از سقف مربوط نیاز داشته باشند، خارج از فرضهای قضیه قرار میگیرند.
خود ابزار پاکسازی خطا نیز مرز دیگری برای تضمین ایجاد میکند. مستندات AddressSanitizer در پروژهٔ LLVM توضیح میدهند که این ابزار دستههایی از خطاهای حافظه، از جمله دسترسی خارج از محدوده و استفاده پس از آزادسازی حافظه، را شناسایی میکند. چنین ابزاری مشخص نمیکند که آیا یک محاسبه درست است، کاربر احراز هویتشده مجاز به مشاهدهٔ یک رکورد هست یا نه، یا تصمیم یک پروتکل با سیاستهای برنامه مطابقت دارد یا خیر.
ازاینرو، در بررسی امنیتی باید هر ویژگی ادعاشده را به یک حالت خرابی مشخص مرتبط کرد. در سرویس بارگذاری تصویر، فساد حافظه در رمزگشا، زمان پردازش بیش از حد، دسترسی غیرمجاز به فایل و تولید تصویر رمزگشاییشدهٔ نادرست، چهار مسئلهٔ جداگانهاند. شواهدی که یکی از این مسائل را برطرف میکنند ارزشمندند، اما خودبهخود سه مورد دیگر را حل نمیکنند.
بررسیکننده چگونه میزان اعتماد لازم به مدل را تغییر میدهد؟
مستندات فرایند بررسی زنجیرهای از مراحل را شرح میدهند که هش فایلهای اجرایی را بررسی میکند، تصویرهای صوری و گزارهها را میسازد، فایلهای برهان را کامپایل میکند و پوششی را بررسی میکند که نتیجه را به گزارهٔ موردنیاز پیوند میدهد. این فرایند همچنین فرضها را با فهرست مجاز مقایسه میکند. پذیرش یک مورد بدون برهان کامل، جایگزین اثبات موفق نیست.
این رویکرد تفاوت مهمی با درخواست از یک سامانهٔ هوش مصنوعی برای بررسی کد و پذیرفتن توضیحات آن دارد. مدل ممکن است استدلالی نامعتبر پیشنهاد کند، یک لم کمکی را اشتباه بفهمد یا مدت زیادی را در مسیری بینتیجه صرف کند. صرفاً به این دلیل که خروجی قانعکننده به نظر میرسد، این خطاها به شواهد پذیرفتهشده تبدیل نمیشوند.
بااینحال، این فرایند بر پایهای متکی است که باید به آن اعتماد کرد. فهرست اجزای مورد اعتماد این نسخه، هستهٔ روک و اصول موضوعهٔ مشخص، معناشناسی فرایند، ابزارهای تبدیل فایلهای اجرایی به تصویرهای حافظه، پوشش بررسی و خود گزارهها را در بر میگیرد. اثبات یک قضیه درون مدل فرایند، بهخودیخود ثابت نمیکند که توصیف آن مدل از لینوکس واقعی درست است.
در نتیجه، وظیفهٔ بازبین هدفمندتر میشود. بازبین میتواند بررسی کند که چه چیزی اثبات شده، برهان به کدام مصنوعات مربوط است، چه فرضهایی پذیرفته شدهاند و آیا این فرضها با سامانهٔ موردنظر سازگارند یا خیر. دیگر لازم نیست هر خط از متن برهان تولیدشده را صرفاً بر اساس اعتبار کلی مدل بپذیرد.
این مهمترین دلیل برای جدی گرفتن پژوهش است: رویکرد مذکور شواهدی فراهم میکند که میتوان آنها را بررسی کرد و سازوکاری دارد که ورودیهای نامعتبر را رد میکند.
صدها میلیون خط برهان، نشانهای از هزینهٔ محاسباتی است
پیوست فنی مقیاس تولید برهان را روشنتر میکند. طبق این گزارش، در جریان تلاشها حدود یک میلیارد خط تولید شده و نزدیک به ۱۸۰ میلیون خط در برهانهای موفق قرار داشته است. بیش از نیمی از یک برهان معمولی از محتوایی تشکیل میشود که ماشین تولید کرده است. بخش بزرگی از کار نیز به زیرساخت مشترک زمان اجرا مربوط میشود، نه منطق اختصاصی کتابخانه. بررسی یک برهان ممکن است حدود ۳۰ دقیقه تا چند ساعت زمان پردازنده نیاز داشته باشد.
بحث کارشناسی در پیوست به مسئلهای در مقیاسپذیری اشاره میکند: برهانها طولانیاند و برای برنامههای بزرگتر احتمالاً به انتزاعهای بهتری نیاز است. بنابراین، طول برهان بهتنهایی معیار مناسبی برای سنجش کیفیت استدلال یا ارزش اقتصادی آن نیست.
آنتروپیک گزارش میکند که مدل Opus 5.5 در نقطهٔ میانی یک معیارسنجی ۳۶وظیفهای، در مقایسه با Opus 5 حدود ۴۰ درصد توکن کمتری مصرف کرده است. همچنین، با تقسیم کار اثبات میان عاملها، مصرف توکن ۱۷ درصد کاهش یافته است. این نتایج از نظر بهرهوری امیدوارکنندهاند، اما قیمت مشخص و منتشرشدهای برای راستیآزمایی هر وابستگی دلخواه در یک سامانهٔ عملیاتی به دست نمیدهند.
این معیارسنجی از برنامههایی عمداً سادهشده نیز استفاده میکند. در پیوست، ورودیهای ۶۴بایتی، پشتیبانی سادهشده از محیط زمان اجرا و یک ابزار پاکسازی کوچک توصیف شدهاند. هنگام تفسیر نتایج مقایسهای، این شرایط اهمیت دارند.
اگر تیمی قصد پذیرش این روش را داشته باشد، پیشنهاد میکنم هزینهٔ کامل بهدست آوردن و نگهداری نتیجهای مفید را محاسبه کند: تولید برهان، بررسی آن، بازبینی مشخصات، تلاشهای ناموفق، بررسی اصلاحات و راستیآزمایی مجدد پس از تغییر کد. صرفهجویی در توکن فقط بر یکی از اجزای این هزینه اثر میگذارد و هزینهٔ نهایی را مشخص نمیکند.
فرصت اقتصادی جالبتر ممکن است در استفادهٔ مجدد نهفته باشد. اگر یک مؤلفهٔ برهانی که بهخوبی نگهداری میشود در پروژههای مختلف قابل استفاده باشد، میتوان هزینهٔ اولیهٔ آن را میان کاربردهای متعدد تقسیم کرد. عملی شدن این ایده به پایداری رابطها، وجود انتزاعهای مناسب و میزان کار لازم برای هر بهروزرسانی بستگی دارد.
واگذاری اصلاح کد به عامل هوش مصنوعی، مسئلهٔ دومی برای بازبینی ایجاد میکند
آنتروپیک به کلود اجازه داد هنگام ساخت برهان، باگهایی را که پیدا میکرد اصلاح کند. این شرکت صریحاً دربارهٔ این خطر بحث میکند که عامل هوش مصنوعی ممکن است برنامه را آنقدر ساده کند که اثبات گزارهٔ موردنظر آسان شود. همچنین، از اعمال جریمه و ممیزی اصلاحات برای کاهش انگیزهٔ چنین رفتاری خبر میدهد.
یک مثال ساده نگرانی را روشن میکند. رمزگشایی که همهٔ ورودیها را رد میکند، ممکن است از بسیاری از مسیرهای اجرایی خطرناک دور بماند، اما در عین حال بیاستفاده شود. اگر گزارهٔ موردنظر رفتار لازم برای کاربران را حفظ نکند، ممکن است برهان معتبر باشد، اما اصلاح کد همچنان پذیرفتنی نباشد.
شواهد منتشرشده را باید با توجه به منشأ آنها ارزیابی کرد. مستندات منشأ برهانها در تئورم توضیح میدهد که پیشنهادهای خودکار با فایلهای اجرایی و مدل نسخهٔ منتشرشده سازگار شدهاند و سپس دوباره بررسی شدهاند. مستندات مربوط به ثبت پروژه نیز جداگانه هشدار میدهد که یافتهها و اصلاحات تولیدشده با هوش مصنوعی ممکن است نادرست یا ناقص باشند و به بازبینی نیاز دارند.
پیشنهاد عملی من این است که تأیید تغییر رفتار برنامه را از پذیرش برهان آن جدا کنیم. بازبین باید مشخص کند کدام ورودیها پس از تغییر رفتار متفاوتی دارند و چرا این تغییر مطلوب است. سپس برهان میتواند دربارهٔ نتیجهٔ تأییدشده شواهد فراهم کند. اگر همان هدف بهینهسازی بدون بازبینی، رفتار قابلقبول برنامه را نیز تعیین کند، فرایند تضمین امنیتی ضعیفتر خواهد شد.
بازتولید مستقل به چیزی بیش از یک نشان سبز نیاز دارد
راهنمای بازتولید توضیح میدهد که چگونه میتوان هدف را دوباره ساخت و هش مصنوعات حاصل را مقایسه کرد. این کار به پرسشی متفاوت از کامپایل شدن برهان پاسخ میدهد. یکی به منشأ و هویت فایل اجرایی مربوط است و دیگری به قضیهای که دربارهٔ آن فایل اثبات شده است.
یک ارزیابی مستقل قوی باید هر دو نتیجه را همراه با نسخهٔ کد منبع، شناسهٔ رمزنگاریشدهٔ زنجیرهٔ ابزارها، نسخهٔ گزاره و گزارشهای اجرا نگه دارد. سپس باید توضیح دهد که محیط بازتولیدشده تا چه اندازه با محیط عملیاتی موردنظر ارزیاب مطابقت دارد.
فهرست وضعیت نسخهٔ منتشرشده همچنین میان اهداف در دسترس و پروژههایی که به پشتیبانی بیشتر از زبان، فرایند ساخت یا مدل نیاز دارند، تمایز میگذارد. پوشهای پر از گزارهها، فهرستی از کارهای پیشرو برای راستیآزمایی است، نه مجموعهای از تضمینهای تکمیلشده.
من توصیه میکنم مجموع اعداد منتشرشده را به نرخ موفقیت عمومی تبدیل نکنیم. پژوهش گستردهتر، زیرمجموعهٔ عمومی، اهدافی که قابلیت ساخت دارند و تمام گزارههای صورتبندیشده، جمعیتهای متفاوتی هستند. تقسیم یک عدد بر عددی دیگر صرفاً به این دلیل که محاسبهاش آسان است، درصدی به دست میدهد که تفسیر معتبری ندارد.
نگهدارندگان نرمافزار اکنون چه کاری میتوانند انجام دهند؟
تئورم فرایند ثبتنام OSS Verify را منتشر کرده است. این فرایند به یک نگهدارندهٔ اصلی، مجوز متنباز واجد شرایط، مخزن عمومی، هدف فازینگ، ساخت پشتیبانیشده و راه ارتباطی امنیتی نیاز دارد. همچنین، بررسیهای بازتولیدپذیری و کنترلهایی برای انتشار برهانها در آن گنجانده شده است. این فرایند مسیر مشخصی برای بررسی این رویکرد در پروژههای واجد شرایط فراهم میکند، اما به معنای آن نیست که هر پروژهٔ ثبتشده فوراً قابل راستیآزمایی است.
برای نخستین ارزیابی، یک نقطهٔ ورودی مهم و قابلفهم را انتخاب میکنم و ابتدا مشخص میکنم که شواهد باید از چه تصمیمی پشتیبانی کنند. تعیین دامنهٔ بررسی یک تجزیهگر که ورودیهای غیرقابلاعتماد دریافت میکند، آسانتر از بررسی یک مرورگر کامل است.
سپس پنج پرسش را برای پذیرش نتیجه مطرح میکنم:
- دقیقاً کدام فایل اجرایی و کدام گزاره بررسی میشوند؟
- کدام ورودیهای مهم، شرایط مصرف منابع و رفتارهای محیطی از دامنهٔ بررسی خارجاند؟
- آیا مهارگاه، رفتاری را میآزماید که کاربران به آن وابستهاند؟
- آیا بازبین دیگری میتواند مصنوعات و نتایج بررسیکننده را بازتولید کند؟
- پس از یک تغییر واقعبینانه در کد، هزینهٔ اندازهگیریشدهٔ بهروزرسانی شواهد چقدر است؟
یک آزمایش مقدماتی موفق باید پاسخ این پرسشها، مصنوعات قابل نگهداری و گزارشی روشن از موارد اثباتنشده را ارائه کند. همچنین باید آزمونهای معمول رگرسیون و بررسیهای امنیتی متناسب با محیط استقرار حفظ شوند؛ زیرا این بررسیها تعهداتی را میآزمایند که ممکن است در گزارهٔ صوری پوشش داده نشده باشند.
نتیجهٔ بعدی که مایلم ببینم، برهانی است که بهطور مستقل برای یک وابستگی پرکاربرد بازتولید شده باشد، به همان فایل اجرایی مورد استفادهٔ واقعی متصل بماند و در جریان یک بهروزرسانی واقعی پروژهٔ اصلی نیز پیگیری شود. چنین نتیجهای نشان خواهد داد که این پژوهش تا چه اندازه از پسِ کار روزمرهٔ نگهداری نرمافزار برمیآید.
یادداشت دربارهٔ گزارشدهی: پژوهش و مستندات مخزن در ۲۲ اکتبر ۲۰۲۶ بررسی شدهاند. ارقام مربوط به برهانهای عمومی به نسخهٔ مخزن با شناسهٔ 8f5f46768858 محدود شدهاند. این مقاله تحلیلی پژوهشی با کمک هوش مصنوعی است و حاصل اجرای مستقل بررسیکنندهٔ برهان نیست. تصاویر، نمودارهای توضیحی اصیلاند و تصویر صفحهای از نتایج آزمایش محسوب نمیشوند.