
آنتروپیک نشان داد مدلهای زبانی بزرگ میتوانند کد اسمبلی ۱۲۳ کتابخانه متنباز را در مقیاس گسترده بهصورت صوری راستیآزمایی کنند
آنتروپیک با همکاری شرکت Theorem از مدل هوش مصنوعی Claude برای اثبات ویژگیهای ایمنی حافظه در فایلهای اجرایی RISC-V متعلق به پروژههای OSS-Fuzz استفاده کرده است. این همکاری به تولید ۱۸۰ میلیون خط کد اثبات منجر شد که درستی آنها بهصورت ماشینی بررسی شده است. همچنین صدها باگ شناسایی شد که روشهای پیشین آزمون فازینگ نتوانسته بودند آنها را کشف کنند.
آنتروپیک نشان داده است که مدلهای زبانی بزرگ اکنون میتوانند راستیآزمایی صوری نرمافزار را در مقیاسی انجام دهند که پیشتر عمدتاً به سامانههای دارای بالاترین الزامات ایمنی محدود بود. این شرکت با همکاری Theorem از Claude برای اثبات ویژگیهای ایمنی حافظه در ۱۲۳ کتابخانه متنباز استفاده کرد که به کد اسمبلی RISC-V کامپایل شده بودند. این پروژه نخستین نمونه از بهکارگیری گسترده راستیآزمایی صوری مبتنی بر هوش مصنوعی روی فایلهای اجرایی مورد استفاده در نرمافزارهای عملیاتی به شمار میرود.
در این پروژه، آزمونهای فازینگ موجود در طرح OSS-Fuzz گوگل به مشخصات صوری تبدیل شدند؛ مشخصاتی که بیان میکردند هیچیک از برنامهها نباید با دریافت ورودی کوچکتر از ۶۴ مگابایت دچار توقف غیرعادی شوند. سپس Claude اثباتهای لازم را با استفاده از دستیار اثبات Rocq نوشت و درستی هر اثبات بهصورت ماشینی بررسی شد. حاصل این فرایند، اثبات ویژگیهای موردنظر برای ۲۳۹ نقطه ورود در ۱۲۳ کتابخانه بود که در مجموع حدود ۱۸۰ میلیون خط کد اثبات را شامل میشد.
تیم آنتروپیک در توضیح دستاورد خود نوشت: «ما اثبات کردیم که این برنامهها برای تمام ورودیهای کوچکتر از ۶۴ مگابایت و در تمام پاسخهای مدلسازیشده سیستمعامل لینوکس و چیدمانهای حافظه، همواره بدون بروز خطاهای ایمنی حافظه یا نقض شرطهای تأییدی، بهطور عادی پایان مییابند.» این اثباتها بر این فرض استوارند که فایلهای اجرایی بهصورت ایستا ساخته شدهاند، تنها از یک رشته اجرایی استفاده میکنند، بودجه حافظه مشخصی دارند و روی معماری RISC-V تحت سیستمعامل لینوکس اجرا میشوند.
در جریان این فرایند، Claude صدها باگ را شناسایی کرد که با وجود تریلیونها بار اجرای آزمون فازینگ، همچنان کشفنشده باقی مانده بودند. برای نمونه، یک خطای سرریز منفی شمارنده در برنامهای برای خارجکردن دادهها از حالت فشرده، تنها هنگام پردازش ورودیهای ۲۰ مگابایتی با چیدمانی نادر رخ میداد. در نمونهای دیگر، خطای خواندن داده خارج از محدوده مجاز حافظه در یک رمزگشای تصویر، به ورودی ۶۴ مگابایتی و بیش از ۲ گیگابایت حافظه نیاز داشت. Claude همچنین آسیبپذیری CVE-2026-56132 را در کتابخانه libexpat دوباره کشف کرد؛ آسیبپذیریای که بروز آن به ورودیهایی با ساختار تودرتوی بسیار عمیق وابسته بود. افزون بر این، یک خطای منطقی نیز شناسایی شد که باعث میشد قابلیت محدودسازی دسترسی به فایلها در همه شرایط بهطور یکسان اعمال نشود.
این اثباتها بهجای بررسی کد منبع، مستقیماً روی دستورالعملهای کامپایلشده RISC-V انجام میشوند. شرکت Theorem معناشناسی صوری مجموعه دستورالعملهای RISC-V و رفتار فرایندهای لینوکس را فراهم کرده است. هسته Rocq هر اثبات را با مشخصات تعریفشده تطبیق میدهد و درستی آن را بررسی میکند. بنابراین توسعهدهندگان برای اعتماد به نتیجه، تنها باید به مدلهای صوری، گزارههای قضایا و خود سامانه بررسی اثبات Rocq اعتماد کنند؛ نه به میلیونها خط کدی که برای ساخت اثباتها تولید شده است.
پژوهشگران در عین حال تأکید کردند: «این نتایج به معنای آن نیست که این کتابخانهها هیچ باگی ندارند. بلکه به این معناست که هر باگ باقیمانده یا باید در مصنوعات و اجزای یادشده وجود داشته باشد یا خارج از محدوده اثبات Claude قرار بگیرد.»
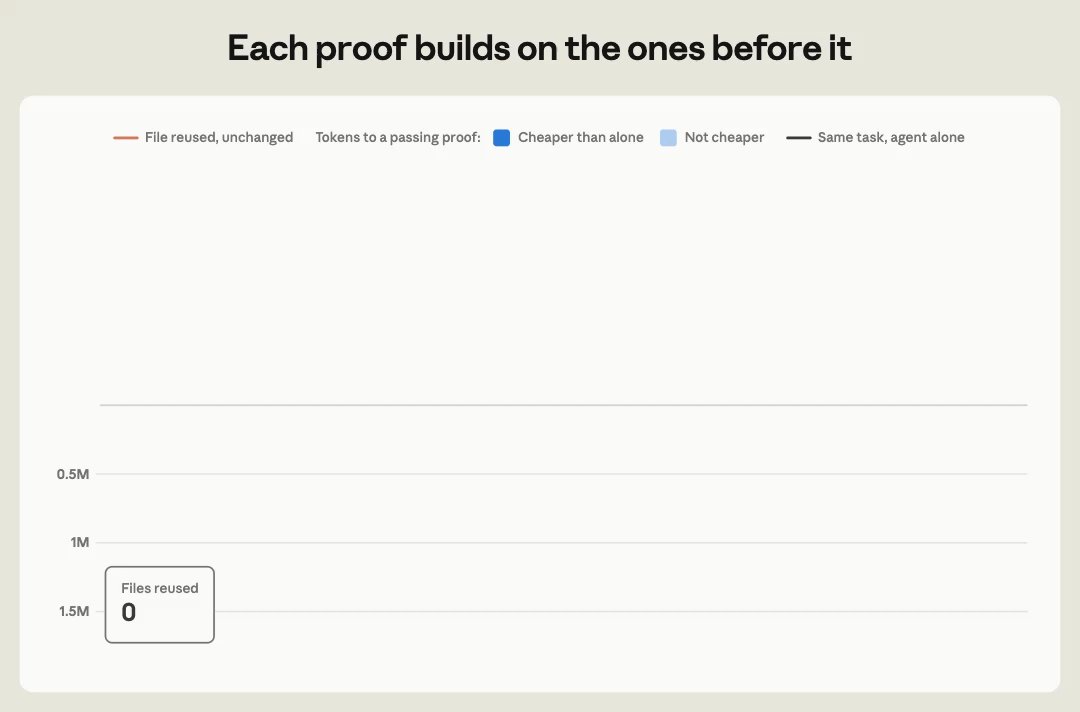
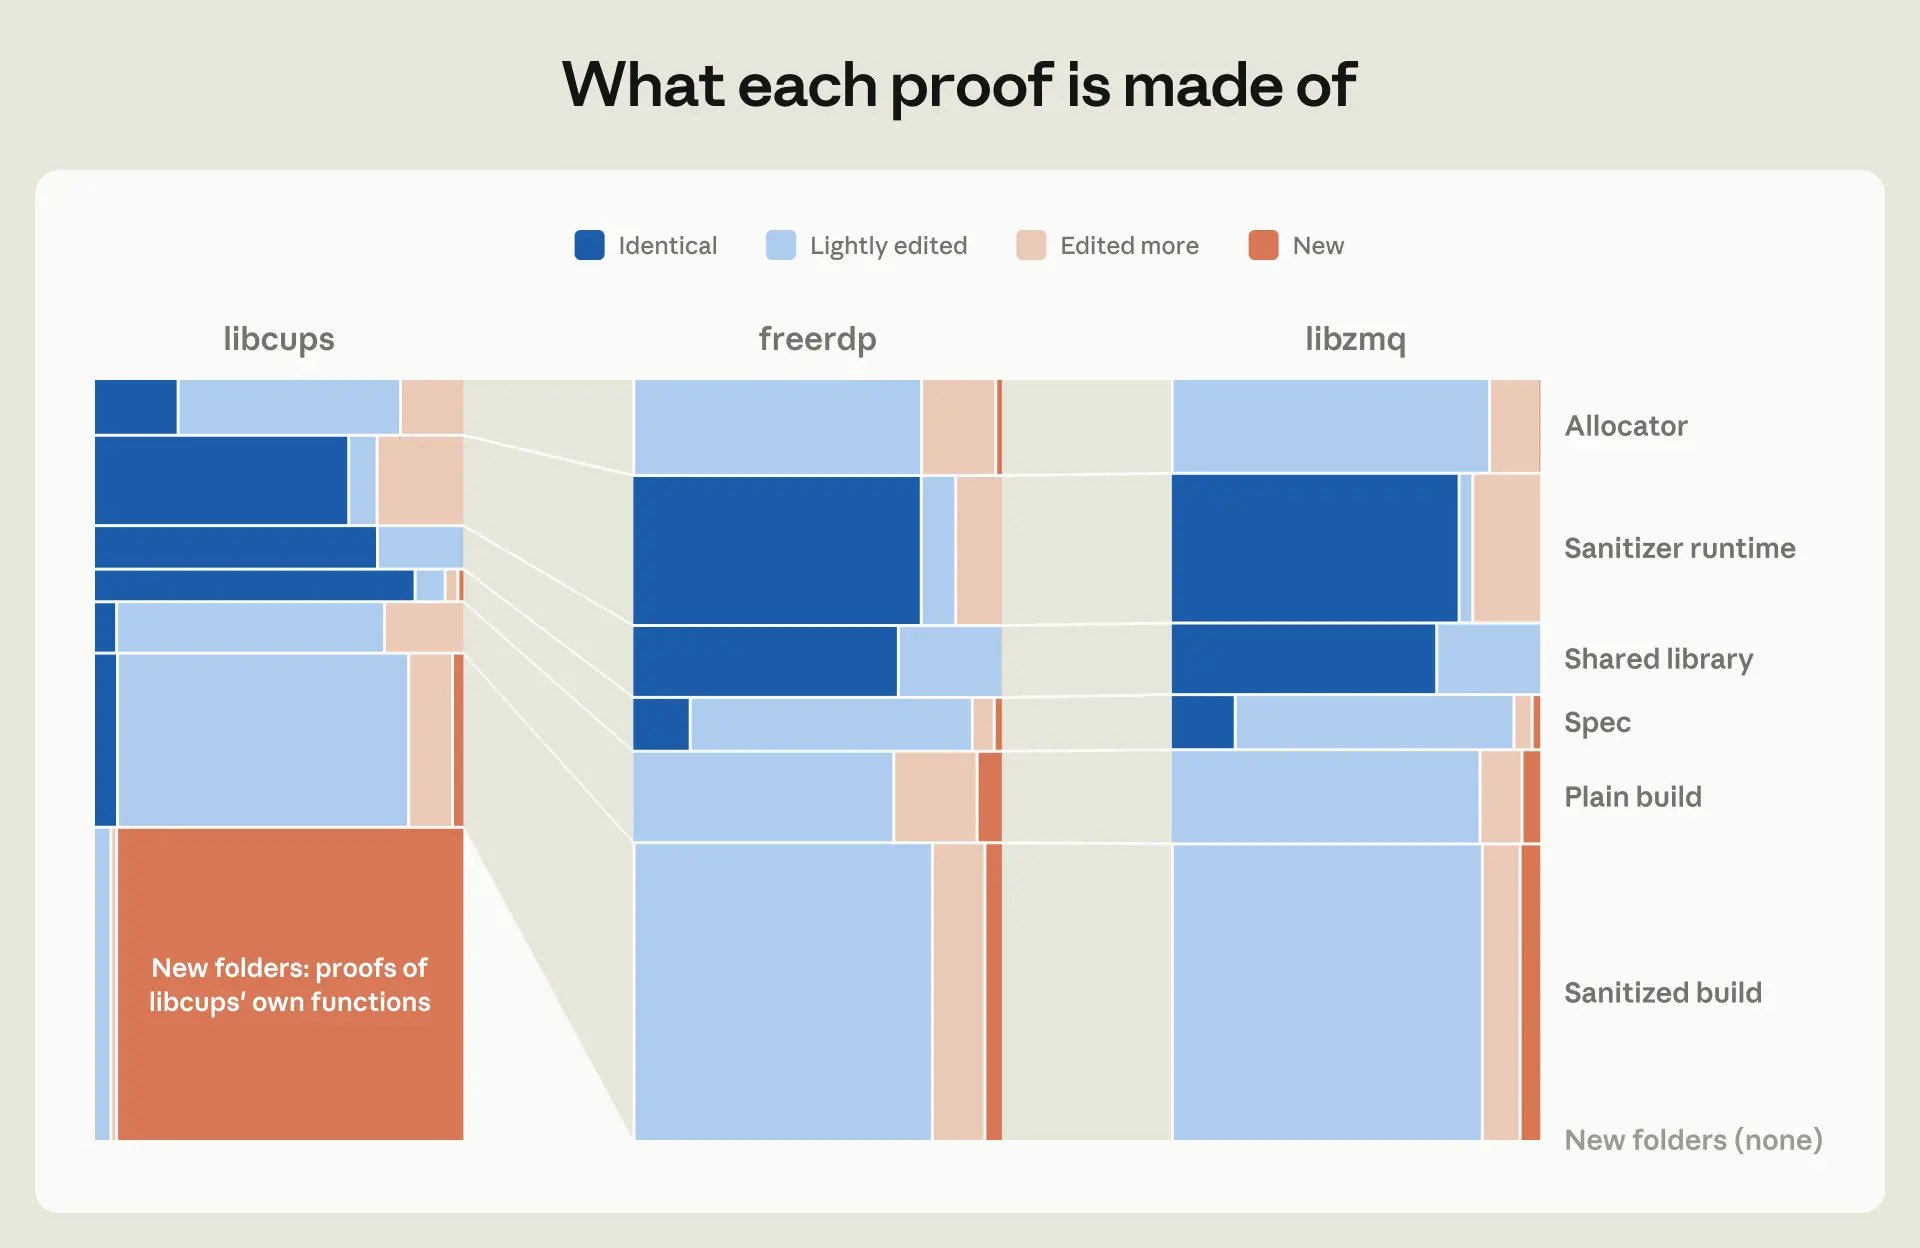
استفاده مجدد از اثباتها یکی از عوامل اصلی افزایش بهرهوری در این پروژه بود. هنگامی که عاملهای هوش مصنوعی در یک محیط کاری مشترک فعالیت میکردند و میتوانستند اثباتهای یکدیگر را کپی کنند، به ۱۷ درصد توکن کمتر نیاز داشتند. در پروژه OSS-Fuzz نیز عاملها اثباتهای تکمیلشده را برای برنامههای جدید تطبیق میدادند و اجزای مشترک، بهویژه بخشهای مربوط به راهاندازی محیط زمان اجرای زبان C و ابزار AddressSanitizer، در کتابخانههای مختلف تقریباً بدون تغییر باقی میماندند.
آنتروپیک علاوه بر فعالیتهای مرتبط با OSS-Fuzz، روشهای دیگری را نیز برای راستیآزمایی بررسی کرده است. در یکی از این آزمایشها، Claude مشخصات صوری استاندارد RFC 1950، مربوط به قالب فشردهسازی zlib، را نوشت و با استفاده از معناشناسی دستورالعملهای x86 که خود Claude تولید کرده بود، اثبات کرد که پیادهسازی zlib در هسته لینوکس، در سطح فایل اجرایی x86، با این مشخصات مطابقت دارد. در آزمایشی دیگر، Claude یک مفسر پایتون با زبان Rust ساخت و با استفاده از ابزار راستیآزمایی Verus ثابت کرد که این مفسر از معناشناسی CPython پیروی میکند. این مفسر در آزمایش روی ۱٫۷ میلیون برنامه تصادفی، به میزان ۹۹٫۹۵ درصد تطابق رفتاری دست یافت. همچنین تلاش برای راستیآزمایی یک نرمافزار پرکاربرد خواندن فایلهای PDF، تنها در یک هفته به کشف تعداد باگهای امنیتی معادل باگهایی منجر شد که معمولاً در طول یک سال در آن شناسایی میشوند.
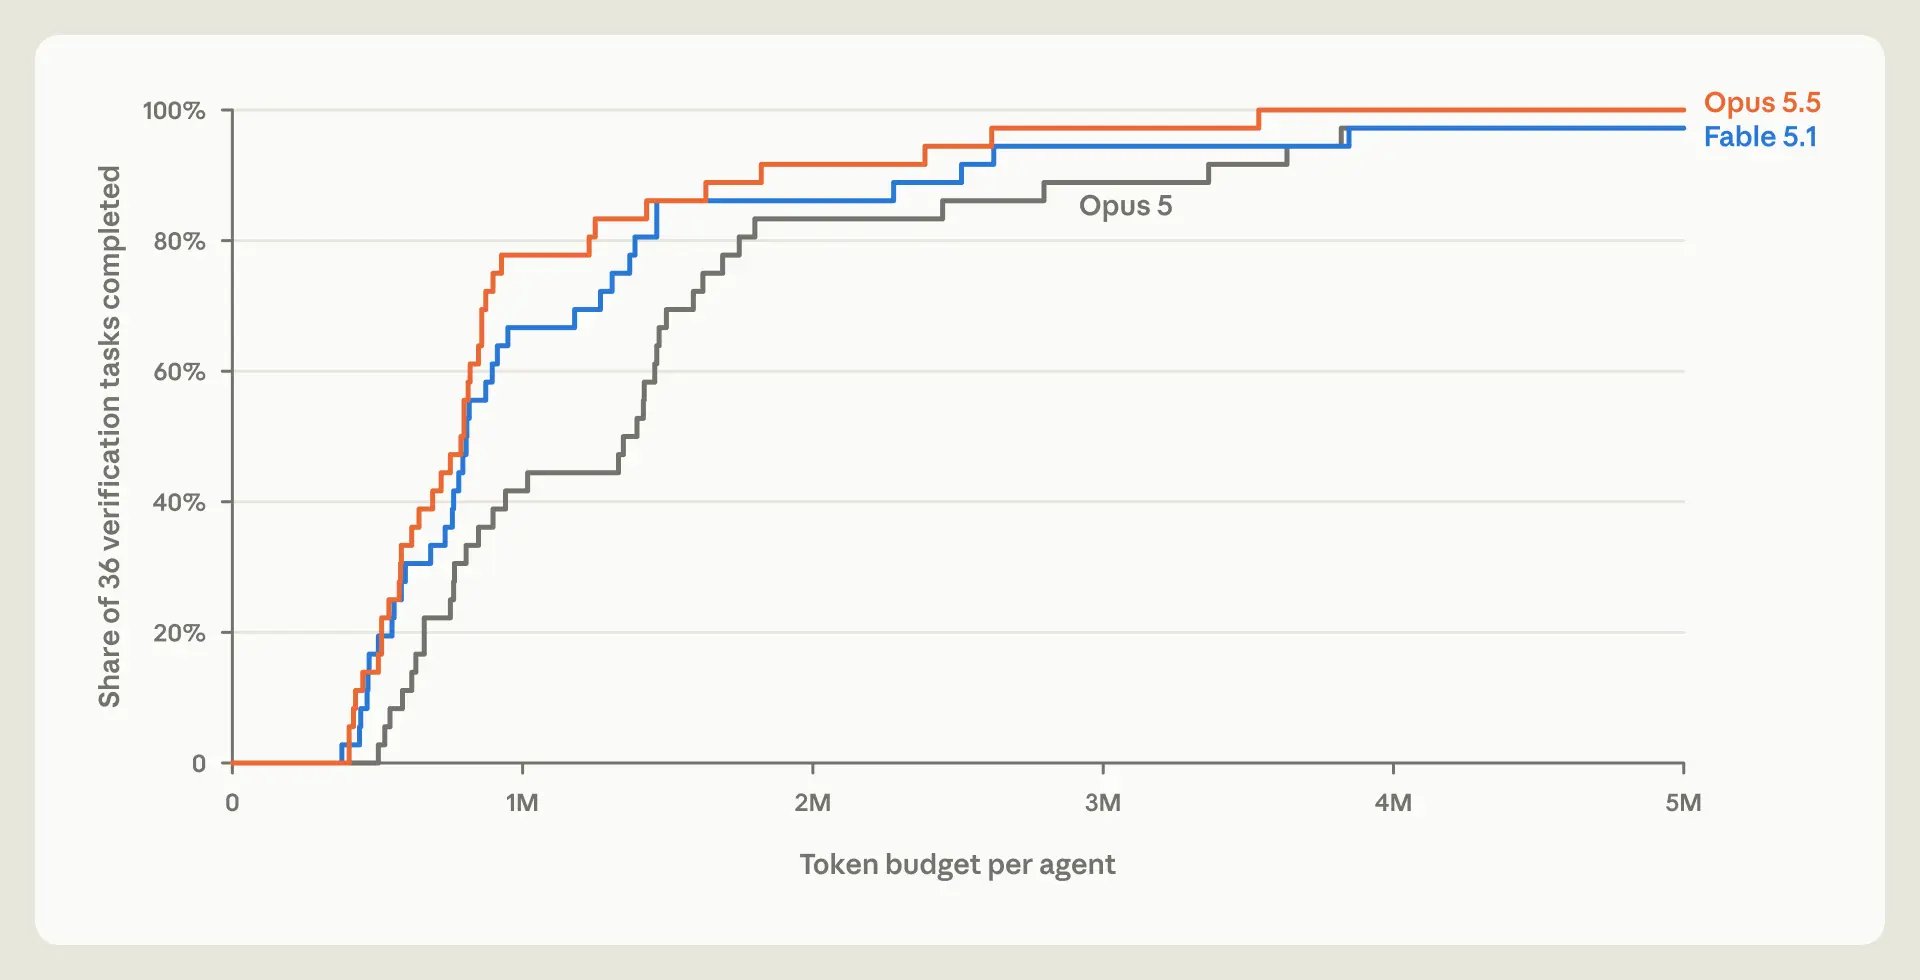
مدلهای جدیدتر در حال کاهش هزینه راستیآزمایی از نظر مصرف توکن هستند. در مجموعهای شامل ۳۶ وظیفه راستیآزمایی برگرفته از کدهای واقعی OSS-Fuzz، مدل Opus 5.5 توانست نیمی از اثباتها را با مصرف حدود ۴۰ درصد توکن کمتر نسبت به Opus 5 تکمیل کند. پژوهشگران انتظار دارند با آموزش مدلها روی وظایف طولانی راستیآزمایی، این روند ادامه پیدا کند.
با وجود این پیشرفتها، محدودیتهای مهمی همچنان وجود دارد. اثباتهای انجامشده تنها فایلهای اجرایی ایستای RISC-V را پوشش میدهند که تکرشتهای هستند و به کتابخانه musl libc پیوند داده شدهاند؛ در حالی که بیشتر نرمافزارها در محیطهای عملیاتی روی معماریهای x86 یا ARM اجرا میشوند و از پیونددهی پویا با کتابخانه glibc استفاده میکنند. ابزار AddressSanitizer نیز قادر به شناسایی تمام خطاهای ایمنی حافظه نیست. علاوه بر این، همه نقاط ورود هر کتابخانه راستیآزمایی نشدهاند. برنامههای واقعی همچنین ممکن است از رابطهای برنامهنویسی کتابخانهها بهدرستی استفاده نکنند و در نتیجه باعث خرابی حافظه در برنامه فراخواننده شوند.
تیم پژوهشی در جمعبندی خود نوشت: «راستیآزمایی صوری که در گذشته عملاً تنها برای تضمینهای ویژه و طراحیشده به دست متخصصان در حساسترین بخشهای نرمافزار از نظر ایمنی امکانپذیر بود، بهزودی برای تقریباً تمام نرمافزارهای عملیاتی بهاندازه آزمون فازینگ امروزی کاربردی و قابل استفاده خواهد شد.» شرکت Theorem اعلام کرده است که آماده اجرای همین فرایند برای سایر پروژههای متنباز است. این شرکت همچنین یک مهارت Claude منتشر کرده تا توسعهدهندگان بتوانند راستیآزمایی کدهای خود را آغاز کنند.
اثباتها، مشخصات صوری و مدلهای رسمی تولیدشده در این پروژه برای بررسی و راستیآزمایی مستقل در دسترس قرار گرفتهاند.
منبع: آنتروپیک