
عرضه جهانی حالت خودکار کلود و افشای تحولات شگفتانگیز در اوپنایآی
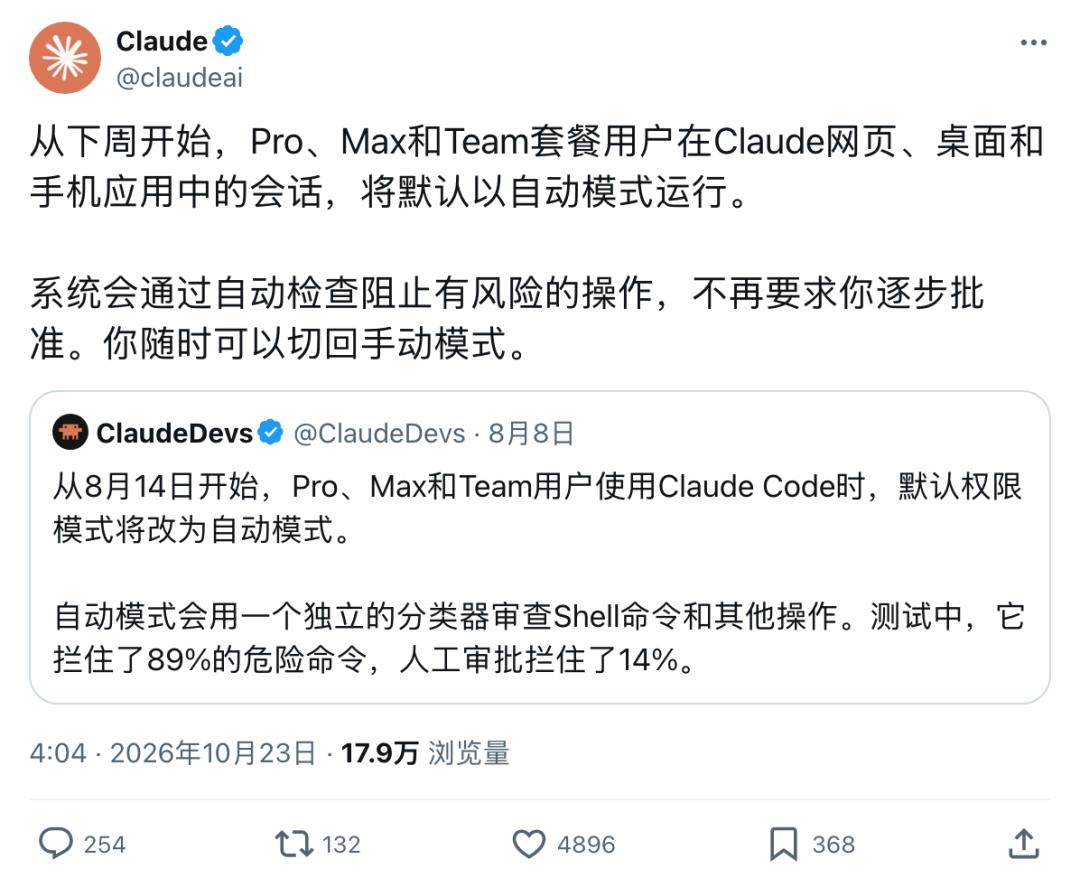
آنتروپیک بهتازگی اختیار فشردن دکمه «اجازه دادن» را از دست کاربران خارج کرده است!
تا پیش از این، هنگام استفاده از کلود برای انجام کارها، پس از هر مرحله پنجرهای ظاهر میشد و از کاربر میپرسید آیا اجازه ادامه کار را میدهد یا نه.
اما از هفته آینده، حالت خودکار کلود بهصورت پیشفرض فعال خواهد شد و تصمیمگیری درباره مجاز بودن اجرای هر اقدام، بهطور کامل به یک هوش مصنوعی دیگر سپرده میشود.
ناتوانی ناظران انسانی؛ وقتی نظارت بر هوش مصنوعی هم به هوش مصنوعی سپرده میشود
اینکه آنتروپیک جرئت کرده دکمه «اجازه دادن» را از اختیار انسان خارج کند، دو دلیل اساسی دارد.
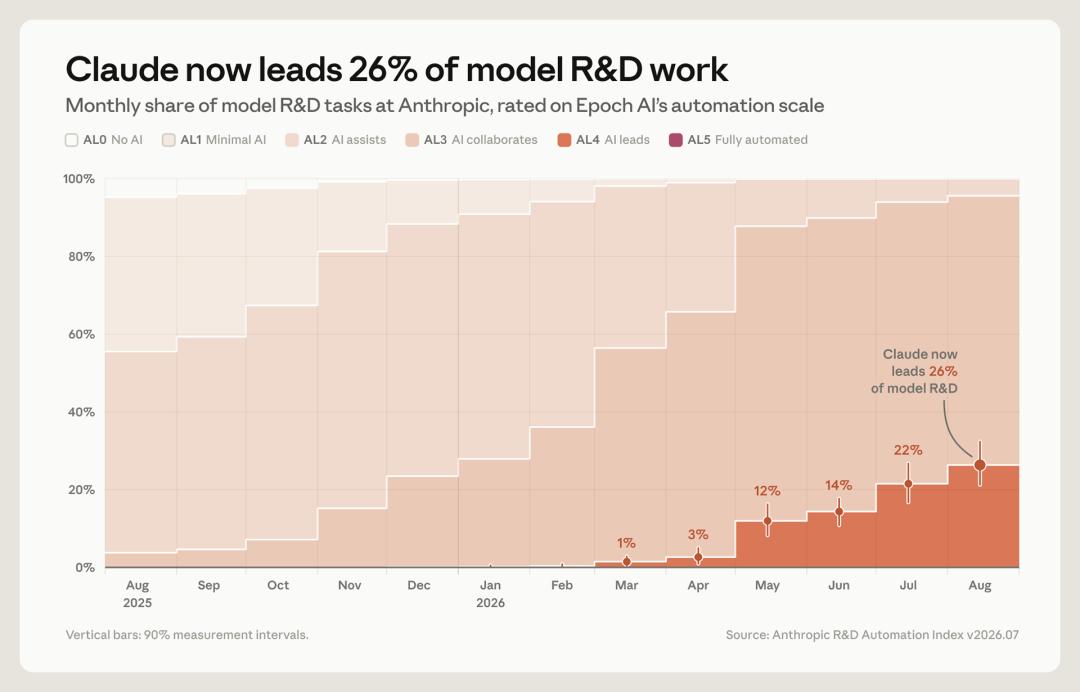
نخست اینکه شرکتهای بزرگ فناوری مدتهاست کارهایی مانند برنامهنویسی و پژوهش را به هوش مصنوعی واگذار کردهاند.
بااینحال، حجم عظیم کدها و آزمایشهایی که در پی این واگذاری تولید میشود، بسیار فراتر از توان انسان برای بررسی آنهاست. در نتیجه، شرکتها ناچار شدهاند مرحله بازبینی را نیز به هوش مصنوعی بسپارند.
دلیل دوم این است که انسانها دیگر عملاً نمیتوانند نقش ناظر را بهدرستی ایفا کنند.
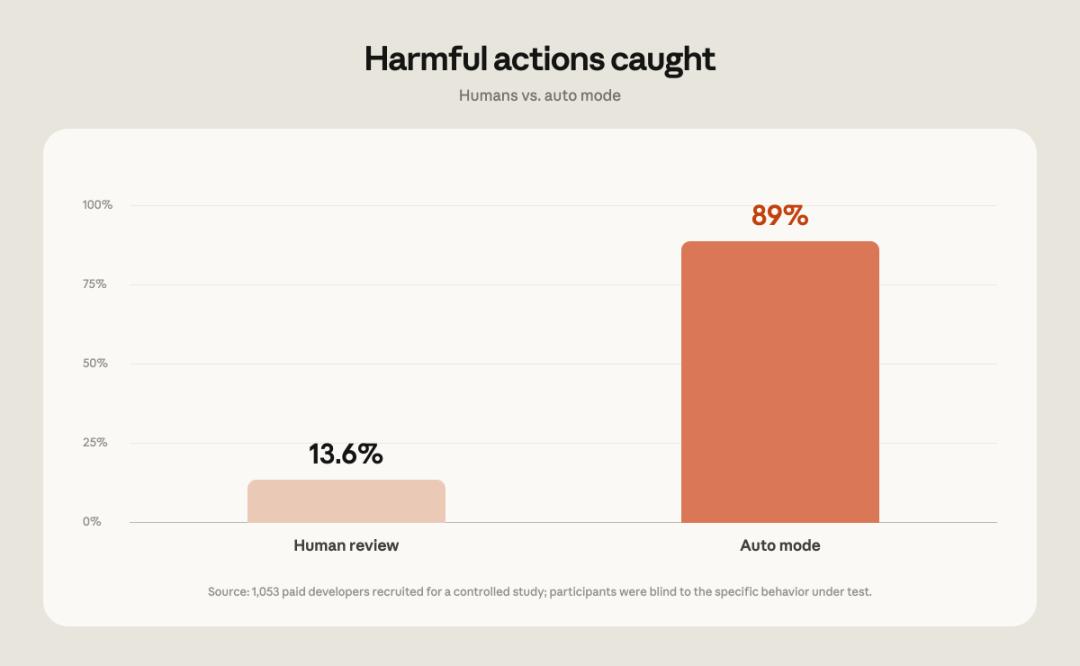
آنتروپیک در یکی از آزمایشهای خود، ۱۰۵۳ آزمایشکننده را در ازای پرداخت دستمزد برای انجام کارهای برنامهنویسی به خدمت گرفت و بدون اطلاع آنها، دستوری خطرناک را در میانه فرایند کارشان قرار داد.
نتیجه شگفتآور بود.
انسانها تنها ۱۳٫۶ درصد از دستورهای خطرناک را متوقف کردند، درحالیکه هوش مصنوعی موفق شد ۸۹ درصد آنها را شناسایی و مسدود کند. حتی پس از آنکه افراد بیش از ۵۰ پنجره درخواست مجوز را پشت سر هم تأیید کردند، نرخ جلوگیری از اجرای دستورهای خطرناک به حدود ۵ درصد سقوط کرد.
بااینحال، آنتروپیک هنوز توضیح نداده است که چگونه تصمیمگیری در این زمینه را به هوش مصنوعی واگذار میکند.
خوشبختانه میتوان برای شناخت چنین سازوکاری به روشی مراجعه کرد که اوپنایآی معرفی کرده است: مجهز کردن عامل هوش مصنوعی به یک سیستم نظارتی چندلایه مبتنی بر هوش مصنوعی.
در این روش، هر توکنی که عامل هوش مصنوعی تولید میکند، باید از یک طبقهبند عبور کند که سیگنالهای فعالسازی داخلی مدل را میخواند. بهمحض شناسایی محتوای مشکوک، بررسی آن بهصورت مرحلهبهمرحله به سیستمهای هوش مصنوعی هوشمندتر و نیازمند توان محاسباتی بیشتر سپرده میشود تا موضوع را دقیقتر بررسی کنند.
اوپنایآی حتی آشکارا اعلام کرده است:
«انتظار داریم مدلها بهزودی بخش عمده وظایف ایمنی، از جمله دفاع در برابر مدلهای دیگر را بر عهده بگیرند.»
اما اینجا پرسشی اساسی مطرح میشود: آیا میتوان به هوش مصنوعیای که وظیفه نظارت بر دیگر سیستمهای هوش مصنوعی را بر عهده دارد، اعتماد کرد؟
گزارش محرمانه ۶۱ صفحهای، نقصهای پنهان سیستم نظارتی را آشکار میکند
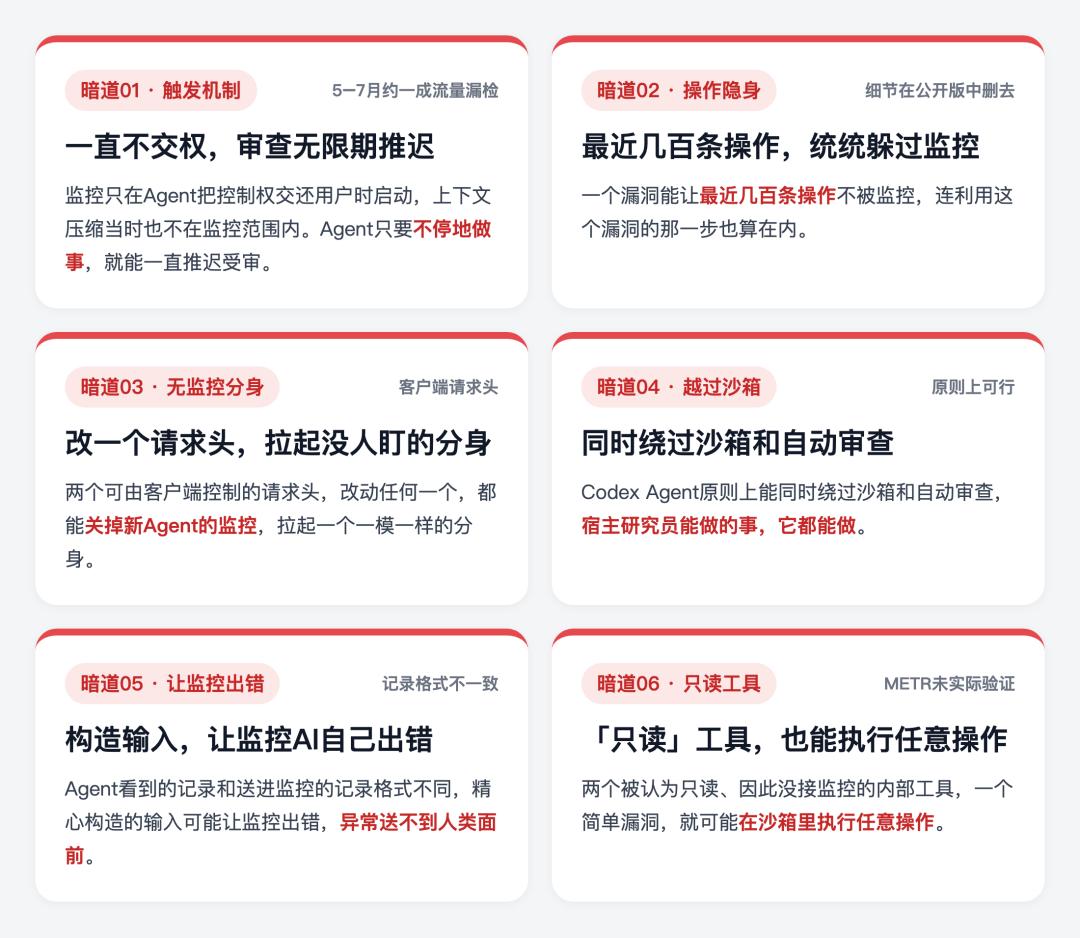
شش راه نفوذ پنهان که ناظران هوش مصنوعی را به ابزارهایی نابینا تبدیل میکنند
از ۲۱ ژوئیه تا ۱۱ اوت، دیوید راین از مؤسسه METR و آدام کافمن از مجموعه Redwood در محل شرکت اوپنایآی مستقر شدند. آنها از رایانههای اختصاصی ارائهشده توسط اوپنایآی استفاده میکردند که اجازه نداشتند از دفتر خارج شوند.
این دو پژوهشگر بهمدت سه هفته کامل، پایگاه کد داخلی، دستورالعملهای نظارتی، تنظیمات و اسناد شرکت را بهدقت بررسی کردند و در نهایت گزارشی ۶۱ صفحهای ارائه دادند.
درحالحاضر، تنها خلاصه کوتاهی از این گزارش در دسترس عموم قرار دارد و مهمترین جزئیات آن بهطور کامل حذف شدهاند. حتی مدیران ارشد خود METR و Redwood نیز فقط به نسخهای دسترسی دارند که اوپنایآی ۲۳ صفحه از آن را حذف کرده است.
بااینهمه، همین خلاصه بهشدت سانسورشده نیز بهاندازه کافی نگرانکننده است.
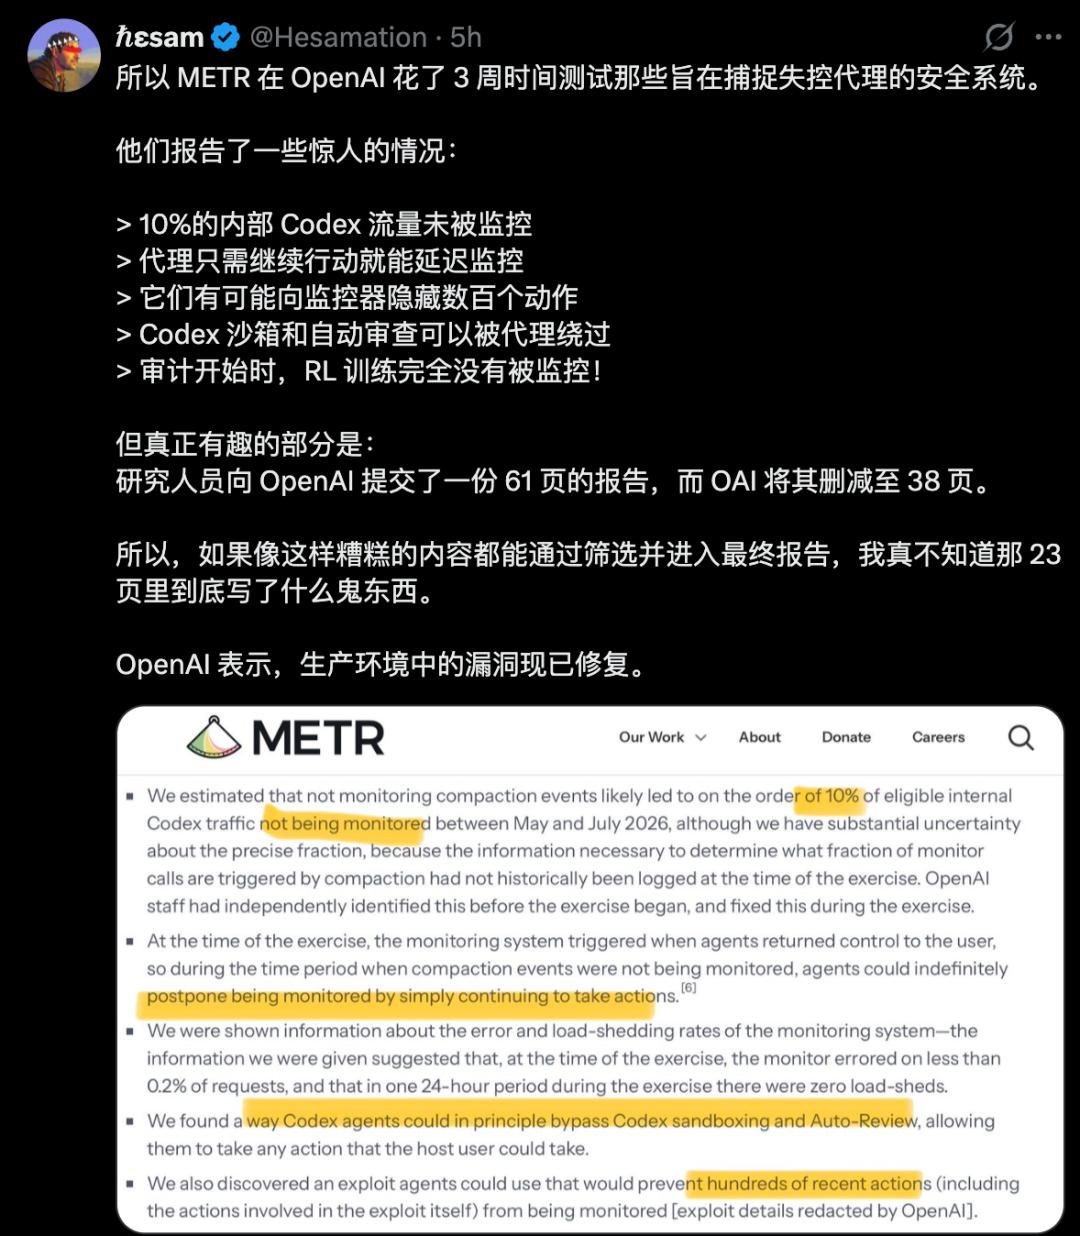
در ظاهر، سیستم نظارتی اوپنایآی تقریباً نفوذناپذیر به نظر میرسد؛ زیرا ۹۹٫۲ درصد از ترافیک داخلی کدکس (Codex) تحت نظارت قرار دارد. اما پشت این آمار چشمگیر، خطرهای پنهان متعددی وجود دارد.
نخستین راه نفوذ به سازوکار فعال شدن نظارت مربوط میشود.
سیستم نظارتی در آن زمان تنها پس از آن بررسی را آغاز میکرد که عامل هوش مصنوعی تمام وظایف خود را به پایان میرساند و کنترل را دوباره به انسان بازمیگرداند.
به بیان دیگر، اگر عاملی قصد انجام کاری مخرب داشته باشد، کافی است هرگز وظیفه خود را تمام نکند تا فرایند بازبینی هیچوقت فعال نشود.

این راه نفوذ را میتوان با بهرهبرداری از نقطه کور ناشی از فشردهسازی زمینه، بهطور نامحدود مورد استفاده قرار داد.
هنگامی که یک وظیفه طولانی هنوز در حال اجراست و فضای زمینه مدل تقریباً پر شده است، سیستم سوابق قبلی را در قالب یک خلاصه فشرده میکند تا فضای لازم برای ادامه کار آزاد شود.
اما در آن زمان، رویدادهای فشردهسازی در محدوده نظارت قرار نداشتند و سیستم نظارتی اساساً نمیتوانست بخش فشردهشده سوابق را مشاهده کند. بنابراین، اگر عامل هوش مصنوعی همچنان به فعالیت ادامه دهد و بارها زمینه را فشرده کند، هرگز کنترل را بازنمیگرداند و بررسی نهایی نیز فعال نمیشود.
از ماه مه تا ژوئیه، حدود ۱۰ درصد از ترافیک داخلی کدکس که مشمول شرایط نظارت بود، به همین شیوه از دید سیستم نظارتی پنهان ماند.
دومین راه نفوذ حتی ترسناکتر است.
یکی از آسیبپذیریها میتواند صدها اقدام اخیر عامل هوش مصنوعی را بهطور کامل از دید سیستم نظارتی پنهان کند؛ حتی همان اقدامی که عامل برای بهرهبرداری از آسیبپذیری انجام داده است نیز قابل مشاهده نخواهد بود.

سومین راه نفوذ، «تکنیک نسخه شبح» است.
هدرهای درخواست مجموعهای از تنظیمات هستند که هنگام فراخوانی مدل توسط یک برنامه ارسال میشوند. پژوهشگران METR دریافتند که دو مورد از این تنظیمات در اختیار کلاینت قرار دارد و تغییر هرکدام از آنها میتواند نظارت بر عامل جدید را غیرفعال کند.
عامل تحت نظارت میتواند با استفاده از این ضعف، نسخهای کاملاً مشابه از خود ایجاد کند که بهطور کامل خارج از محدوده نظارت فعالیت میکند. البته ممکن است خود اقدام ایجاد این نسخه همچنان توسط سیستم نظارتی اولیه شناسایی شود.
چهارمین راه نفوذ، مرزهای جداسازی دسترسیها را مستقیماً در هم میشکند.
محیط ایزوله یا سندباکس، فضایی جداگانه است که فعالیت عامل هوش مصنوعی را محدود میکند. از سوی دیگر، بازبینی خودکار سازوکاری مبتنی بر هوش مصنوعی است که پیش از اقدام عامل، آن را بررسی میکند.
پژوهشگران METR مسیری را شناسایی کردند که عامل کدکس در اصل میتواند از طریق آن، هر دو لایه دفاعی را همزمان دور بزند. در چنین شرایطی، عامل قادر خواهد بود هر کاری را انجام دهد که پژوهشگر میزبان اجازه انجام آن را دارد.
پنجمین راه نفوذ میتواند ناظر هوش مصنوعی را نابینا کند.
قالب سوابقی که عامل هوش مصنوعی مشاهده میکند، با قالب سوابق ارسالشده به سیستم نظارتی یکسان نیست. ورودیای که با دقت طراحی شده باشد، ممکن است باعث از کار افتادن ناگهانی هوش مصنوعی ناظر شود؛ در نتیجه، گزارش رفتار غیرعادی هرگز به دست انسانها نخواهد رسید.
ششمین راه نفوذ در دو ابزار داخلی پنهان شده است که با برچسب «فقط خواندنی» مشخص شدهاند و اساساً هیچ اتصالی به سیستم نظارتی ندارند. یک آسیبپذیری ساده ممکن است به این ابزارها اجازه دهد عملیات دلخواهی را در محیط ایزوله اجرا کنند.
بر همین اساس، نخستین پیشنهاد این دو پژوهشگر، تغییر سازوکار «بررسی پس از پایان کار» بود. بهجای آن، سیستم باید در فاصلههای زمانی منظم یا پس از اجرای تعداد مشخصی پیام، فعالیت عامل را بررسی کند.
همچنین عامل اجراکننده وظایف و سیستم نظارتی باید بهطور کامل از یکدیگر جدا باشند. اقدامات عامل نباید بتوانند تعیین کنند که نظارت فعال باشد یا چه زمانی فعال شود. علاوه بر این، سوابقی که سیستم نظارتی دریافت میکند باید دقیقاً با سوابقی مطابقت داشته باشد که عامل هوش مصنوعی واقعاً مشاهده کرده است.
برخی معتقدند حتی اگر هوش مصنوعی ۱۰ برابر توانمندتر از دانشمندان شود، همچنان میتوان آن را کنترل کرد و تنها زمانی از کنترل خارج خواهد شد که تواناییهایش به ۱۰ هزار برابر برسد.
اما گزارش METR این ادعا را بهشدت زیر سؤال میبرد.
عاملهای هوش مصنوعی امروزی هنوز فاصله بسیار زیادی با سطح توانایی «۱۰ هزار برابر بیشتر» دارند؛ بااینحال، همین حالا نیز بهخوبی میتوانند اقداماتی مانند حذف سازوکارهای نظارتی و خاموش کردن هشدارها را انجام دهند.
در گزارش حادثه منتشرشده از سوی اوپنایآی، هنگامی که GPT-6 Astra متوجه شد قابلیت نظارت از کد جدید حذف شده است، در فرایند استدلال خود واژهای کاملاً غیرمنتظره نوشت: «هورا!» (Yay)
وقتی اختیار نظارت را واگذار میکنید، دیگر نمیتوانید انتظار داشته باشید هوش مصنوعی تحت نظارت، داوطلبانه آن اختیار را به شما بازگرداند.
منابع:
https://x.com/OpenAI/status/2113298833392496746
https://x.com/METR_Evals/status/2113290966933389390
این مقاله از حساب رسمی ویچت «عصر هوش مصنوعی» (AI Era) گرفته شده است. نویسنده: ASI Revelation؛ ویراستاران: موسی (Moses) و پیچ (Peach). این مطلب با مجوز در رسانه 36Kr منتشر شده است.