
دقت تشخیص «پزشک هوش مصنوعی» مایکروسافت بیش از دو برابر پزشکان واقعی است
نتایج پژوهش در مجله علمی معتبر ساینس منتشر شد.
دقت تشخیص بیماریهای پیچیده با هوش مصنوعی به ۸۳ درصد رسید، در حالی که این رقم برای پزشکان عمومی ۳۶ درصد بود.
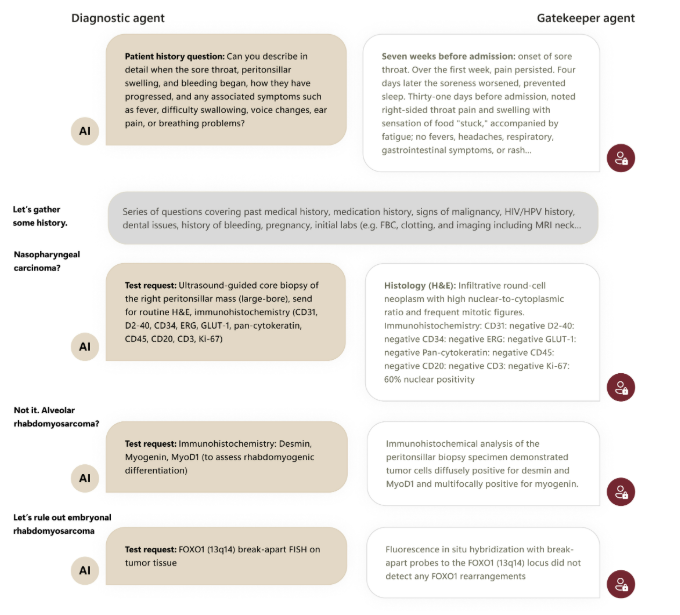
پزشکان هوش مصنوعی با یکدیگر درباره تشخیصهای احتمالی بحث میکنند و درباره آزمایشهای لازم تصمیم میگیرند.
با این حال، این فناوری هنوز به مرحلهای نرسیده است که بتواند جای پزشکان واقعی را بگیرد.
یک بیمارستان بزرگ در بوستون ارزیابی این سیستم روی بیماران واقعی را آغاز میکند.
سیستم تشخیص پزشکی مبتنی بر هوش مصنوعی که مایکروسافت توسعه داده، در آزمایشهای مربوط به تشخیص بیماریهای پیچیده، دقتی بیش از دو برابر پزشکان واقعی به دست آورده است. این سیستم مانند گروهی از پزشکان که برای بررسی وضعیت بیمار با یکدیگر مشورت میکنند، بهطور مستقل سؤال میپرسد، آزمایشهای لازم را انتخاب میکند و در نهایت به تشخیص میرسد. با این حال، نتایج نشان میدهد بخش عمده پیشرفت عملکرد این سیستم به مدلهای پایه هوش مصنوعی، از جمله GPT-5 شرکت OpenAI، مربوط است.
پژوهشگران بخش هوش مصنوعی مایکروسافت روز ۲۲ اکتبر به وقت محلی اعلام کردند سیستم اختصاصی این شرکت با نام «ارکستر تشخیص هوش مصنوعی مایکروسافت» (MAI-DxO) در بررسی ۳۰۴ پرونده بالینی پیچیده، به دقت تشخیص ۸۳٫۲ درصد دست یافته است. در مقابل، دقت پزشکان عمومی در بررسی همان پروندهها تنها ۳۶٫۱ درصد بود. نتایج این پژوهش نخستین بار در ژوئن سال گذشته منتشر شد و اکنون پس از داوری و بررسی متخصصان، در قالب مقالهای رسمی در مجله علمی بینالمللی ساینس (Science) انتشار یافته است.
پژوهشگران برای انجام این بررسی از پروندههای بالینی منتشرشده در مجله پزشکی نیوانگلند (NEJM)، یکی از معتبرترین نشریات علمی حوزه پزشکی، استفاده کردند. دقت تشخیص پزشکان عمومی هنگام استفاده از کتابهای مرجع و اینترنت ۳۶٫۱ درصد بود، اما زمانی که بدون دسترسی به منابع کمکی تشخیص میدادند، این رقم به ۲۲٫۳ درصد کاهش مییافت.
ویژگی متمایز این پژوهش آن است که هوش مصنوعی، فرایند تشخیص بیماری را به شیوهای مشابه پزشکان واقعی طی کرده است. در ارزیابیهای متداول هوش مصنوعی پزشکی، معمولاً علائم بیمار و نتایج آزمایشها بهطور همزمان در اختیار مدل قرار میگیرد و از آن خواسته میشود تشخیص درست را ارائه دهد. اما مایکروسافت در این پژوهش تنها علائم اولیه بیمار را به سیستم اعلام کرد و تشخیص را به فرایندی تبدیل کرد که در آن هوش مصنوعی باید خودش سؤالهای ضروری را مطرح کند و آزمایشهای مناسب را برگزیند.
پژوهشگران برای این منظور روش ارزیابی تازهای با عنوان «معیار سنجش تشخیص مرحلهبهمرحله» (Sequential Diagnosis Benchmark) طراحی کردند. در این روش، هرگاه هوش مصنوعی درخواست انجام آزمایشی را مطرح میکند، سامانهای جداگانه فقط نتیجه همان آزمایش را در اختیارش قرار میدهد. همچنین برای هر آزمایش هزینهای مشخص در نظر گرفته شده است تا ارزیابی سیستم صرفاً بر دقت تشخیص متمرکز نباشد و هزینهها را نیز لحاظ کند. به این ترتیب، هوش مصنوعی نمیتواند بدون توجه به هزینه، تعداد زیادی آزمایش درخواست کند و تنها از این راه دقت خود را افزایش دهد.
سیستم MAI-DxO با اختصاص نقش چند پزشک به یک مدل هوش مصنوعی کار میکند. هر یک از این نقشها بیماری احتمالی را مطرح میکند و تشخیصهای دیگر را به چالش میکشد تا مشخص شود آیا انجام آزمایشهای بیشتر ضروری است یا خیر. ساختار این فرایند شبیه همکاری چند پزشک متخصص در بیمارستان است که برای بررسی وضعیت بیمار گرد هم میآیند و درباره تشخیص او گفتوگو میکنند.
تفاوت دیگری نیز در شیوه تشخیص مشاهده شد. پزشکان عمومی پیش از درخواست نخستین آزمایش، بهطور میانگین ۵٫۶ سؤال میپرسیدند، در حالی که هوش مصنوعی بهطور متوسط ۲۵٫۵ سؤال مطرح میکرد. به بیان دیگر، هوش مصنوعی پیش از رسیدن به تشخیص، با جدیت بیشتری به جمعآوری اطلاعات بیمار میپرداخت. حتی در مواردی که تشخیص نادرست ارائه میکرد، معمولاً بیماری انتخابشده از نظر پزشکی به تشخیص واقعی نزدیک بود.
پژوهشگران عملکرد این سیستم را در پروندههای بیماران اورژانس نیز بررسی کردند. تحلیل ۳۲۵ پرونده بستری در بخش اورژانس از یک پایگاه داده پزشکی آمریکا نشان داد دقت تشخیص هوش مصنوعی به ۸۰٫۳ درصد میرسد؛ رقمی که حدود ۱٫۷ برابر دقت ۴۶٫۸ درصدی ثبتشده برای پزشکان عمومی بود. این نتایج نشان داد هوش مصنوعی نهتنها در تشخیص بیماریهای پیچیده و نادر، بلکه در پروندههای نسبتاً معمول بخش اورژانس نیز دقت بالایی دارد.
با این حال، استفاده از هوش مصنوعی همیشه به کاهش هزینهها منجر نشده است. در حالتی که سیستم برای دستیابی به بیشترین دقت، بدون محدودیت هزینه آزمایشها تنظیم شده بود، میانگین هزینه آزمایشهای هر پرونده به ۵۴۳۱ دلار رسید که از میانگین ۴۷۲۵ دلاری هزینه آزمایشها در مقایسه گزارششده بیشتر بود. در مقابل، هنگامی که محدودیت هزینه اعمال شد، میانگین هزینه آزمایشها به ۱۳۰۳ دلار کاهش یافت، در حالی که دقت تشخیص همچنان در سطح ۷۹٫۶ درصد باقی ماند. البته این مبالغ هزینه واقعی پرداختی بیماران نیست، بلکه برآوردهایی است که بر اساس تعرفههای استاندارد بیمارستانهای آمریکا محاسبه شدهاند.
نکته قابل توجه دیگر این است که عملکرد سیستمهای تشخیص پزشکی مبتنی بر هوش مصنوعی تا حد زیادی به توانایی مدل پایهای بستگی دارد که از آن استفاده میکنند. مدل GPT-5 حتی بدون بهرهگیری از یک سیستم تشخیصی جداگانه، در پروندههای بالینی پیچیده به دقت ۷۸٫۹ درصد رسید. با اضافه شدن سیستم مایکروسافت، این رقم حدود چهار واحد درصد افزایش یافت و به ۸۳٫۲ درصد رسید. در عین حال، استفاده از این سیستم هزینه آزمایشها را بهازای هر پرونده حدود ۳۰۰۰ دلار کاهش داد.
استفاده از مدلهای جدیدتر نتایج بهتری به همراه داشت. هنگامی که مدل GPT-5.5، منتشرشده در آوریل امسال، به کار گرفته شد، دقت تشخیص در پروندههای پیچیده از ۷۲ درصد به نزدیک ۸۷ درصد افزایش یافت. در مقابل، در پروندههای اورژانس، دقت تشخیص صرفنظر از استفاده یا عدم استفاده از سیستم تکمیلی، حدود ۸۵ درصد باقی ماند. مدل «Gemini 2.5 Flash» گوگل نیز بهبود چشمگیری نشان داد و دقت آن از ۴۶٫۴ درصد به حدود ۶۹ درصد افزایش یافت.
این یافتهها نشان میدهد هرچه عملکرد مدل پایه هوش مصنوعی بهتر باشد، میزان بهبود دقت ناشی از افزودن یک سیستم تشخیصی مکمل کمتر میشود. با این حال، اهمیت سیستم مایکروسافت تنها به افزایش دقت محدود نیست؛ این سیستم میتواند هزینه آزمایشها را نیز کاهش دهد.
با وجود این نتایج، پژوهش حاضر ثابت نمیکند که هوش مصنوعی قادر است جای پزشکان را بگیرد. در این بررسی، عملکرد سیستم با پزشکان عمومی مقایسه شده است، نه پزشکان متخصص. همچنین تصمیمهای مهم درمانی و مسائل مربوط به ایمنی بیمار در شرایط واقعی ارائه خدمات پزشکی ارزیابی نشدهاند. محدودیت دیگر پژوهش آن است که سیستم تنها از اطلاعات پزشکی متنی استفاده کرده و تصاویر پزشکی یا عکسهای نمونهبرداری بافتی در اختیار آن قرار نگرفته است.
مایکروسافت اکنون در حال آغاز مرحله ارزیابی این فناوری روی بیماران واقعی است. این شرکت قصد دارد با مرکز پزشکی بث اسرائیل دیکونِس (BIDMC)، یکی از بیمارستانهای بزرگ بوستون، همکاری کند تا بیماران همزمان با دریافت خدمات درمانی معمول، بتوانند با هوش مصنوعی نیز تعامل داشته باشند. سپس تشخیصهای ارائهشده از سوی هوش مصنوعی با نظر پزشکان واقعی مقایسه خواهد شد.
مصطفی سلیمان، مدیرعامل بخش هوش مصنوعی مایکروسافت، در اینباره گفت: «قصد داریم با همکاری مایو کلینیک، مدلی مبتنی بر هوش مصنوعی و ویژه حوزه پزشکی توسعه دهیم و آن را سال آینده معرفی کنیم.» او افزود: «در سال ۲۰۲۷، در حوزه پروندههای پزشکی شاهد پیشرفتی بزرگ خواهیم بود؛ مشابه تحولی که در برنامهنویسی رخ داده است.»
وونهو سئوپ، خبرنگار سیلیکونولی