
حلقه گمشده هوش مصنوعی سازمانی: معماری حاکمیت برای مدلهای زبانی بزرگ و یادگیری ماشین
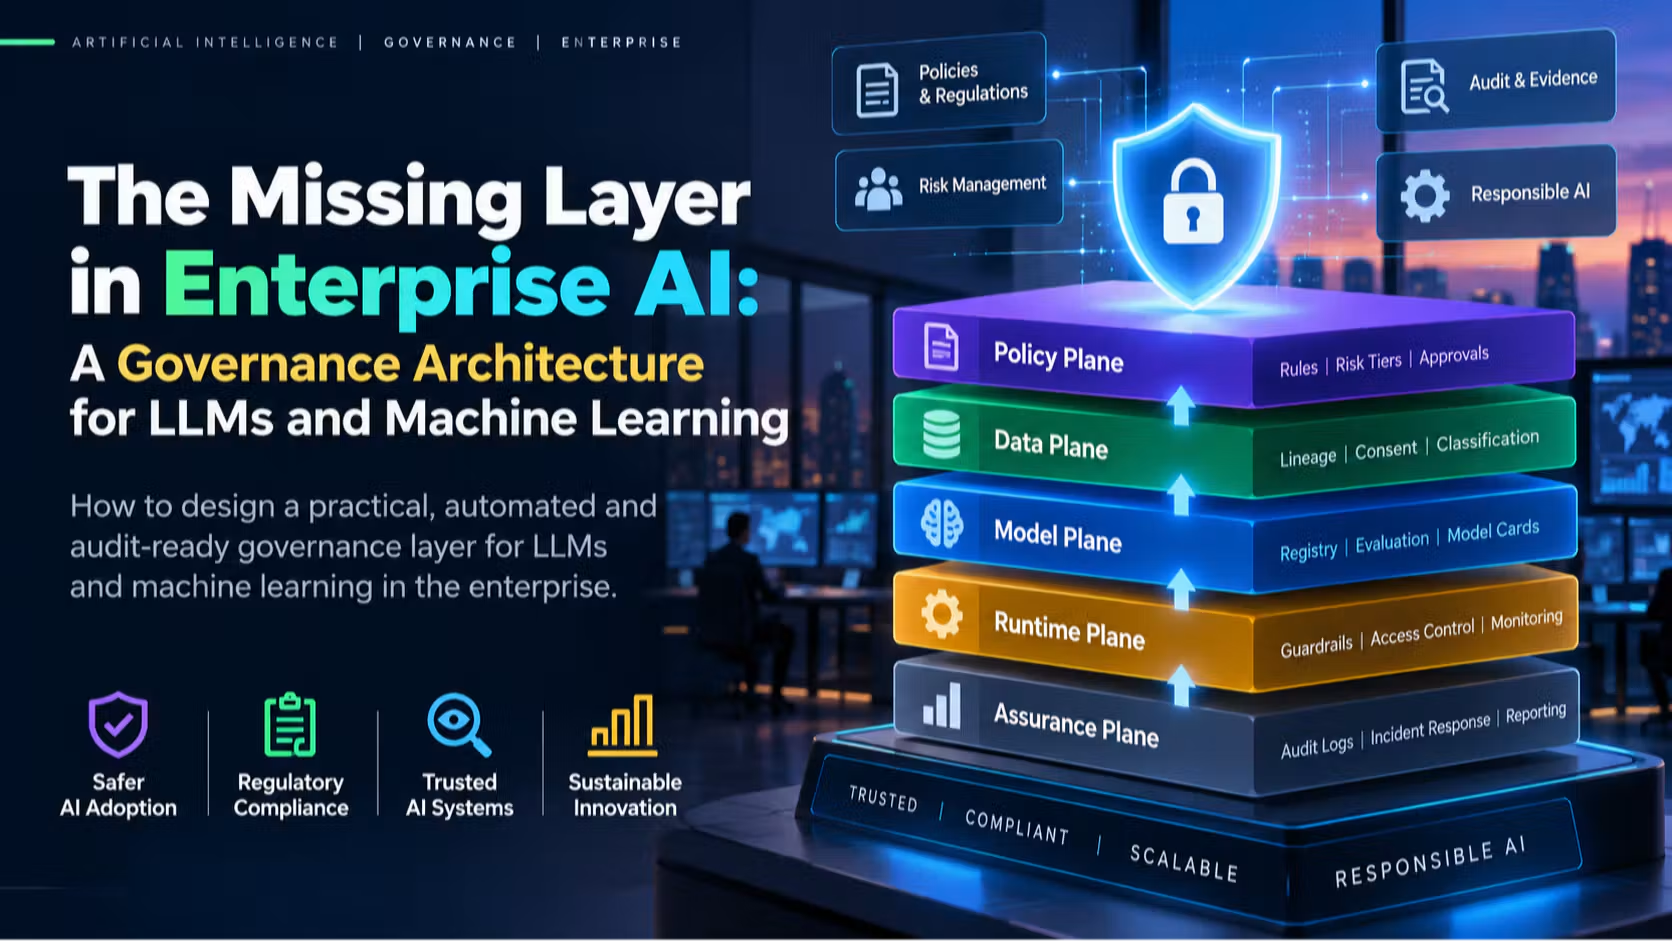
بیشتر شرکتها زیرساخت داده، پلتفرم مدلسازی و مجموعهای از پروژههای آزمایشی هوش مصنوعی دارند. اما تعداد بسیار کمتری از آنها سازوکاری دارند که مشخص کند کدامیک از این پروژهها اجازه دارند در تعامل با مشتریان به کار گرفته شوند.
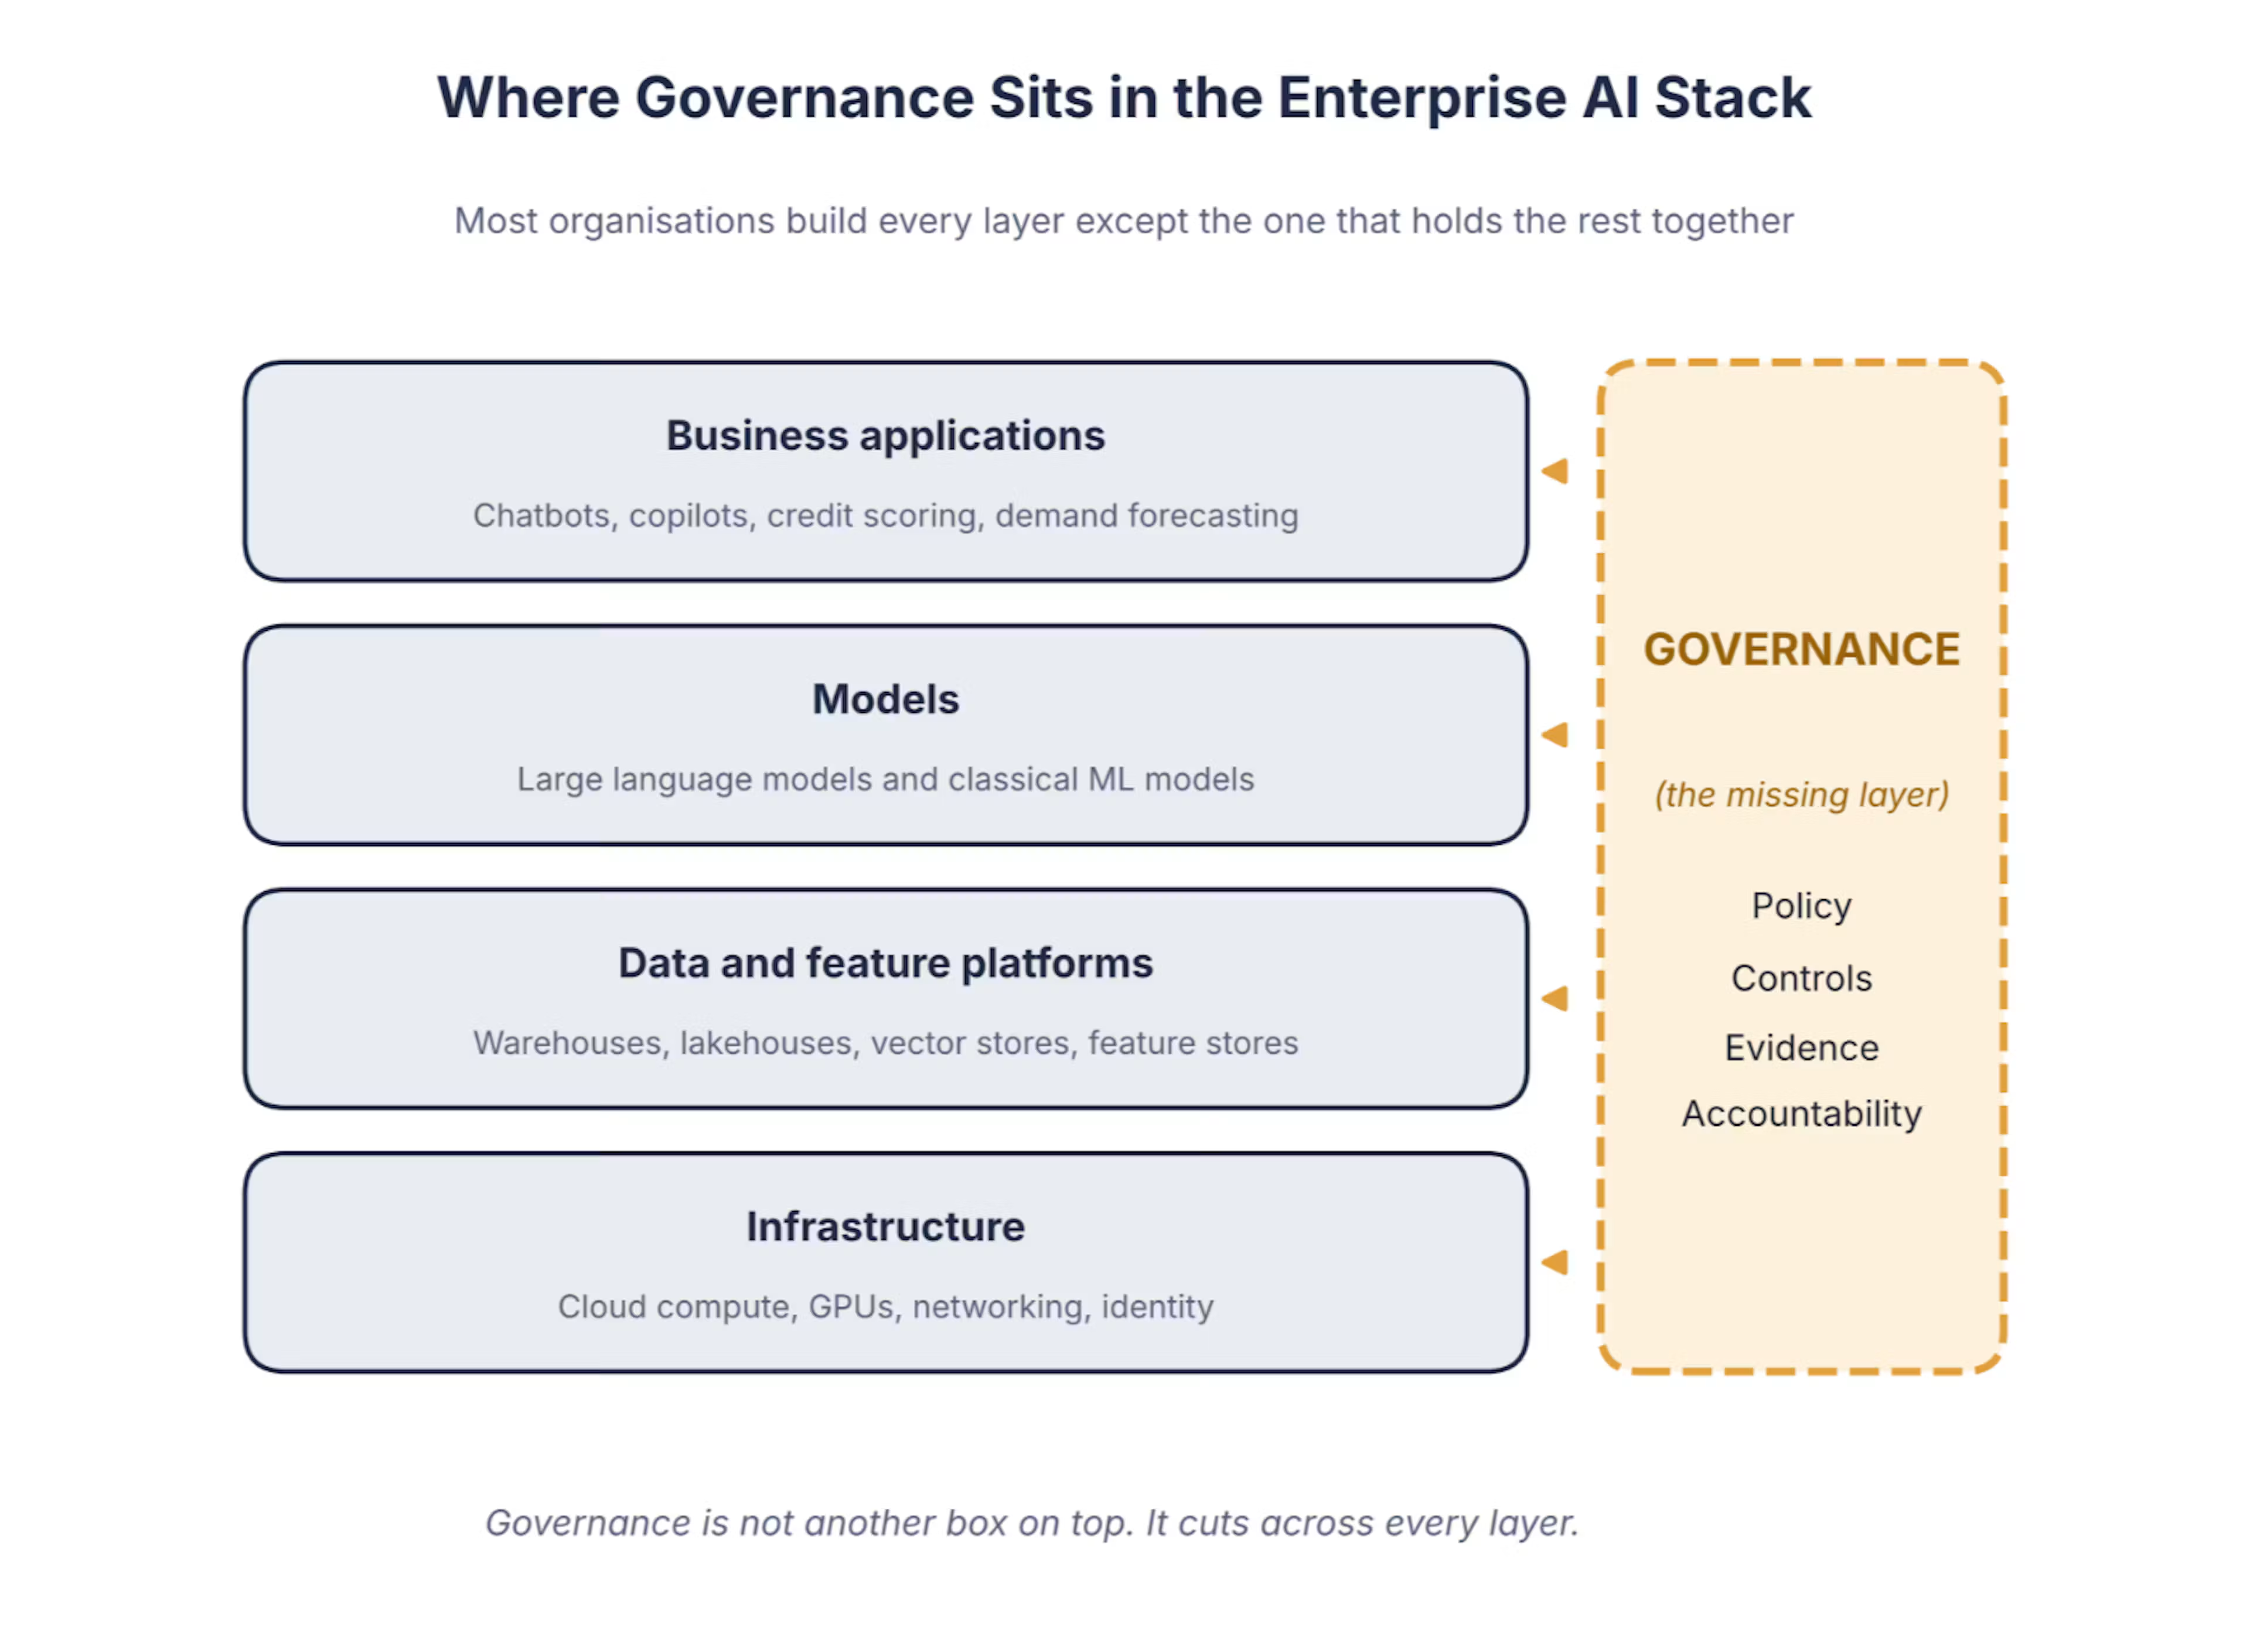
چتباتی که بیش از حد خوب کار میکرد
فرض کنید یک شرکت بیمه متوسط تنها در شش هفته، دستیار هوش مصنوعی ویژهای برای رسیدگی داخلی به پروندههای خسارت راهاندازی میکند. کارشناسان رسیدگی به خسارت از عملکرد آن بسیار راضیاند. تا اینکه روزی یکی از کارکنان، یادداشتهای پزشکی یک بیمهگذار را در کادر ورودی چتبات قرار میدهد تا خلاصهای سریع از آنها دریافت کند. یک ماه بعد، کارشناس تطبیق مقررات سؤال کاملاً منطقیای مطرح میکند: آن اطلاعات کجا رفتند، چه کسانی میتوانستند به آنها دسترسی داشته باشند و پاسخ ارسالشده برای مشتری را کدام نسخه از مدل تولید کرده بود؟
هیچکس پاسخ روشنی ندارد. از نظر فنی، گزارشهای ثبت رویداد وجود دارند، اما در سه سامانه مختلف پراکندهاند و هیچکدام نسخه مدل را ثبت نکردهاند. مجوز اجرای پروژه نیز چیزی بیشتر از یک فایل ارائه و تأیید شفاهی در جلسه نبوده است.
آنقدر نمونههای مشابه این ماجرا را دیدهام که دیگر آن را شکست یک تیم مشخص نمیدانم. چنین اتفاقی زمانی رخ میدهد که شرکتی لایه داده، لایه مدل و لایه کاربردی را میسازد و بیسروصدا فرض میکند بخش چهارم خودبهخود شکل خواهد گرفت. اما حاکمیت خودبهخود به وجود نمیآید؛ کسی باید آن را طراحی کند.
چرا راهکارهای رایج پاسخگو نیستند؟
واکنش معمول شرکتها تدوین یک سند سیاستگذاری و تشکیل کمیته بررسی است. دلیل این رویکرد را درک میکنم. داشتن یک سند سیاستگذاری، نشانه پیشرفت به نظر میرسد و تشکیل کمیته نیز این احساس را ایجاد میکند که مسئولیتپذیری برقرار شده است.
مشکل اصلی، زمانبندی است. کمیتهای که ماهی یکبار تشکیل جلسه میدهد، نمیتواند سامانهای را که هر هفته تغییر میکند بهدرستی بررسی کند. همچنین یک فایل PDF نمیتواند ساعت دو بامداد جلوی افشای شماره تلفن از طریق یک پرامپت را بگیرد. سیاستی که صرفاً در قالب متن نوشته شده، تنها بیانگر نیت سازمان است. این سیاست زمانی به یک ابزار کنترلی واقعی تبدیل میشود که بخشی از سامانه اجرای آن را تضمین کند، اجرای آن را ثبت کند و حتی یک سال بعد بتواند مستندات مربوط را به فردی خارج از مجموعه ارائه دهد.
البته استدلال مخالف معتبری هم وجود دارد. حاکمیت بیش از حد سختگیرانه میتواند همان فضای آزمون و تجربهای را از بین ببرد که هوش مصنوعی را ارزشمند میکند. اگر تیمی برای آزمایش یک پرامپت خلاصهسازی به شش تأییدیه نیاز داشته باشد، بهسادگی دیگر برای گرفتن مجوز اقدام نمیکند. نتیجه، گسترش استفاده غیررسمی و خارج از نظارت از هوش مصنوعی یا همان «هوش مصنوعی سایه» خواهد بود که وضعیت بدتری ایجاد میکند. بنابراین هدف، افزایش تشریفات اداری نیست؛ بلکه باید کنترلها بهاندازه، در نقاط مناسب و تا جایی که عملی است بهشکل خودکار اعمال شوند.
حاکمیت بهعنوان یک لایه، نه یک کمیته
تغییری که بیش از همه به من کمک کرد، این بود که دیگر حاکمیت را مانعی در انتهای مسیر تصور نکنم و آن را لایهای بدانم که مانند مدیریت هویت یا شبکه، در کنار سایر بخشهای سامانه فعالیت میکند. همانطور که اجازه نمیدهید هر تیم سامانه ورود کاربران مخصوص خود را از ابتدا طراحی کند، در حاکمیت هوش مصنوعی نیز باید از همین منطق پیروی کرد.
چارچوبهای موجود نیز به همین سمت حرکت میکنند. چارچوب مدیریت ریسک هوش مصنوعی مؤسسه ملی استاندارد و فناوری آمریکا (NIST) بر حاکمیت، شناسایی و ترسیم ریسکها، سنجش و مدیریت آنها بهعنوان فعالیتهایی مستمر تأکید دارد. قانون هوش مصنوعی اتحادیه اروپا نیز تعهدات را بر اساس سطوح ریسک تعیین میکند؛ یعنی در عمل، پیش از آنکه بتوانید الزامات قانونی را رعایت کنید، باید بدانید چه سامانههایی دارید و میزان خطر هرکدام چقدر است. بانکها نیز سالهاست تحت دستورالعملهای نظارتی مربوط به ریسک مدل، مانند دستورالعمل SR 11-7 در ایالات متحده، با رویکردی مشابه سروکار دارند. هیچیک از این چارچوبها دقیقاً مشخص نمیکنند که چه چیزی باید ساخته شود. این ویژگی هم نقطه قوت آنهاست و هم محدودیتشان. معماری حاکمیت قرار است همین خلأ را پر کند.
پنج لایه و یک مسیر مشترک ثبت شواهد
ساختاری که بارها به آن بازگشتهام، از پنج لایه تشکیل شده است. البته این تنها روش تقسیم مسئله نیست و اگر معماری سازمان شما چهار یا شش لایه داشته باشد، تعجب نمیکنم. نکته مهم این است که هر حوزه مسئولیت، جایگاه مشخص و متولی معینی داشته باشد.
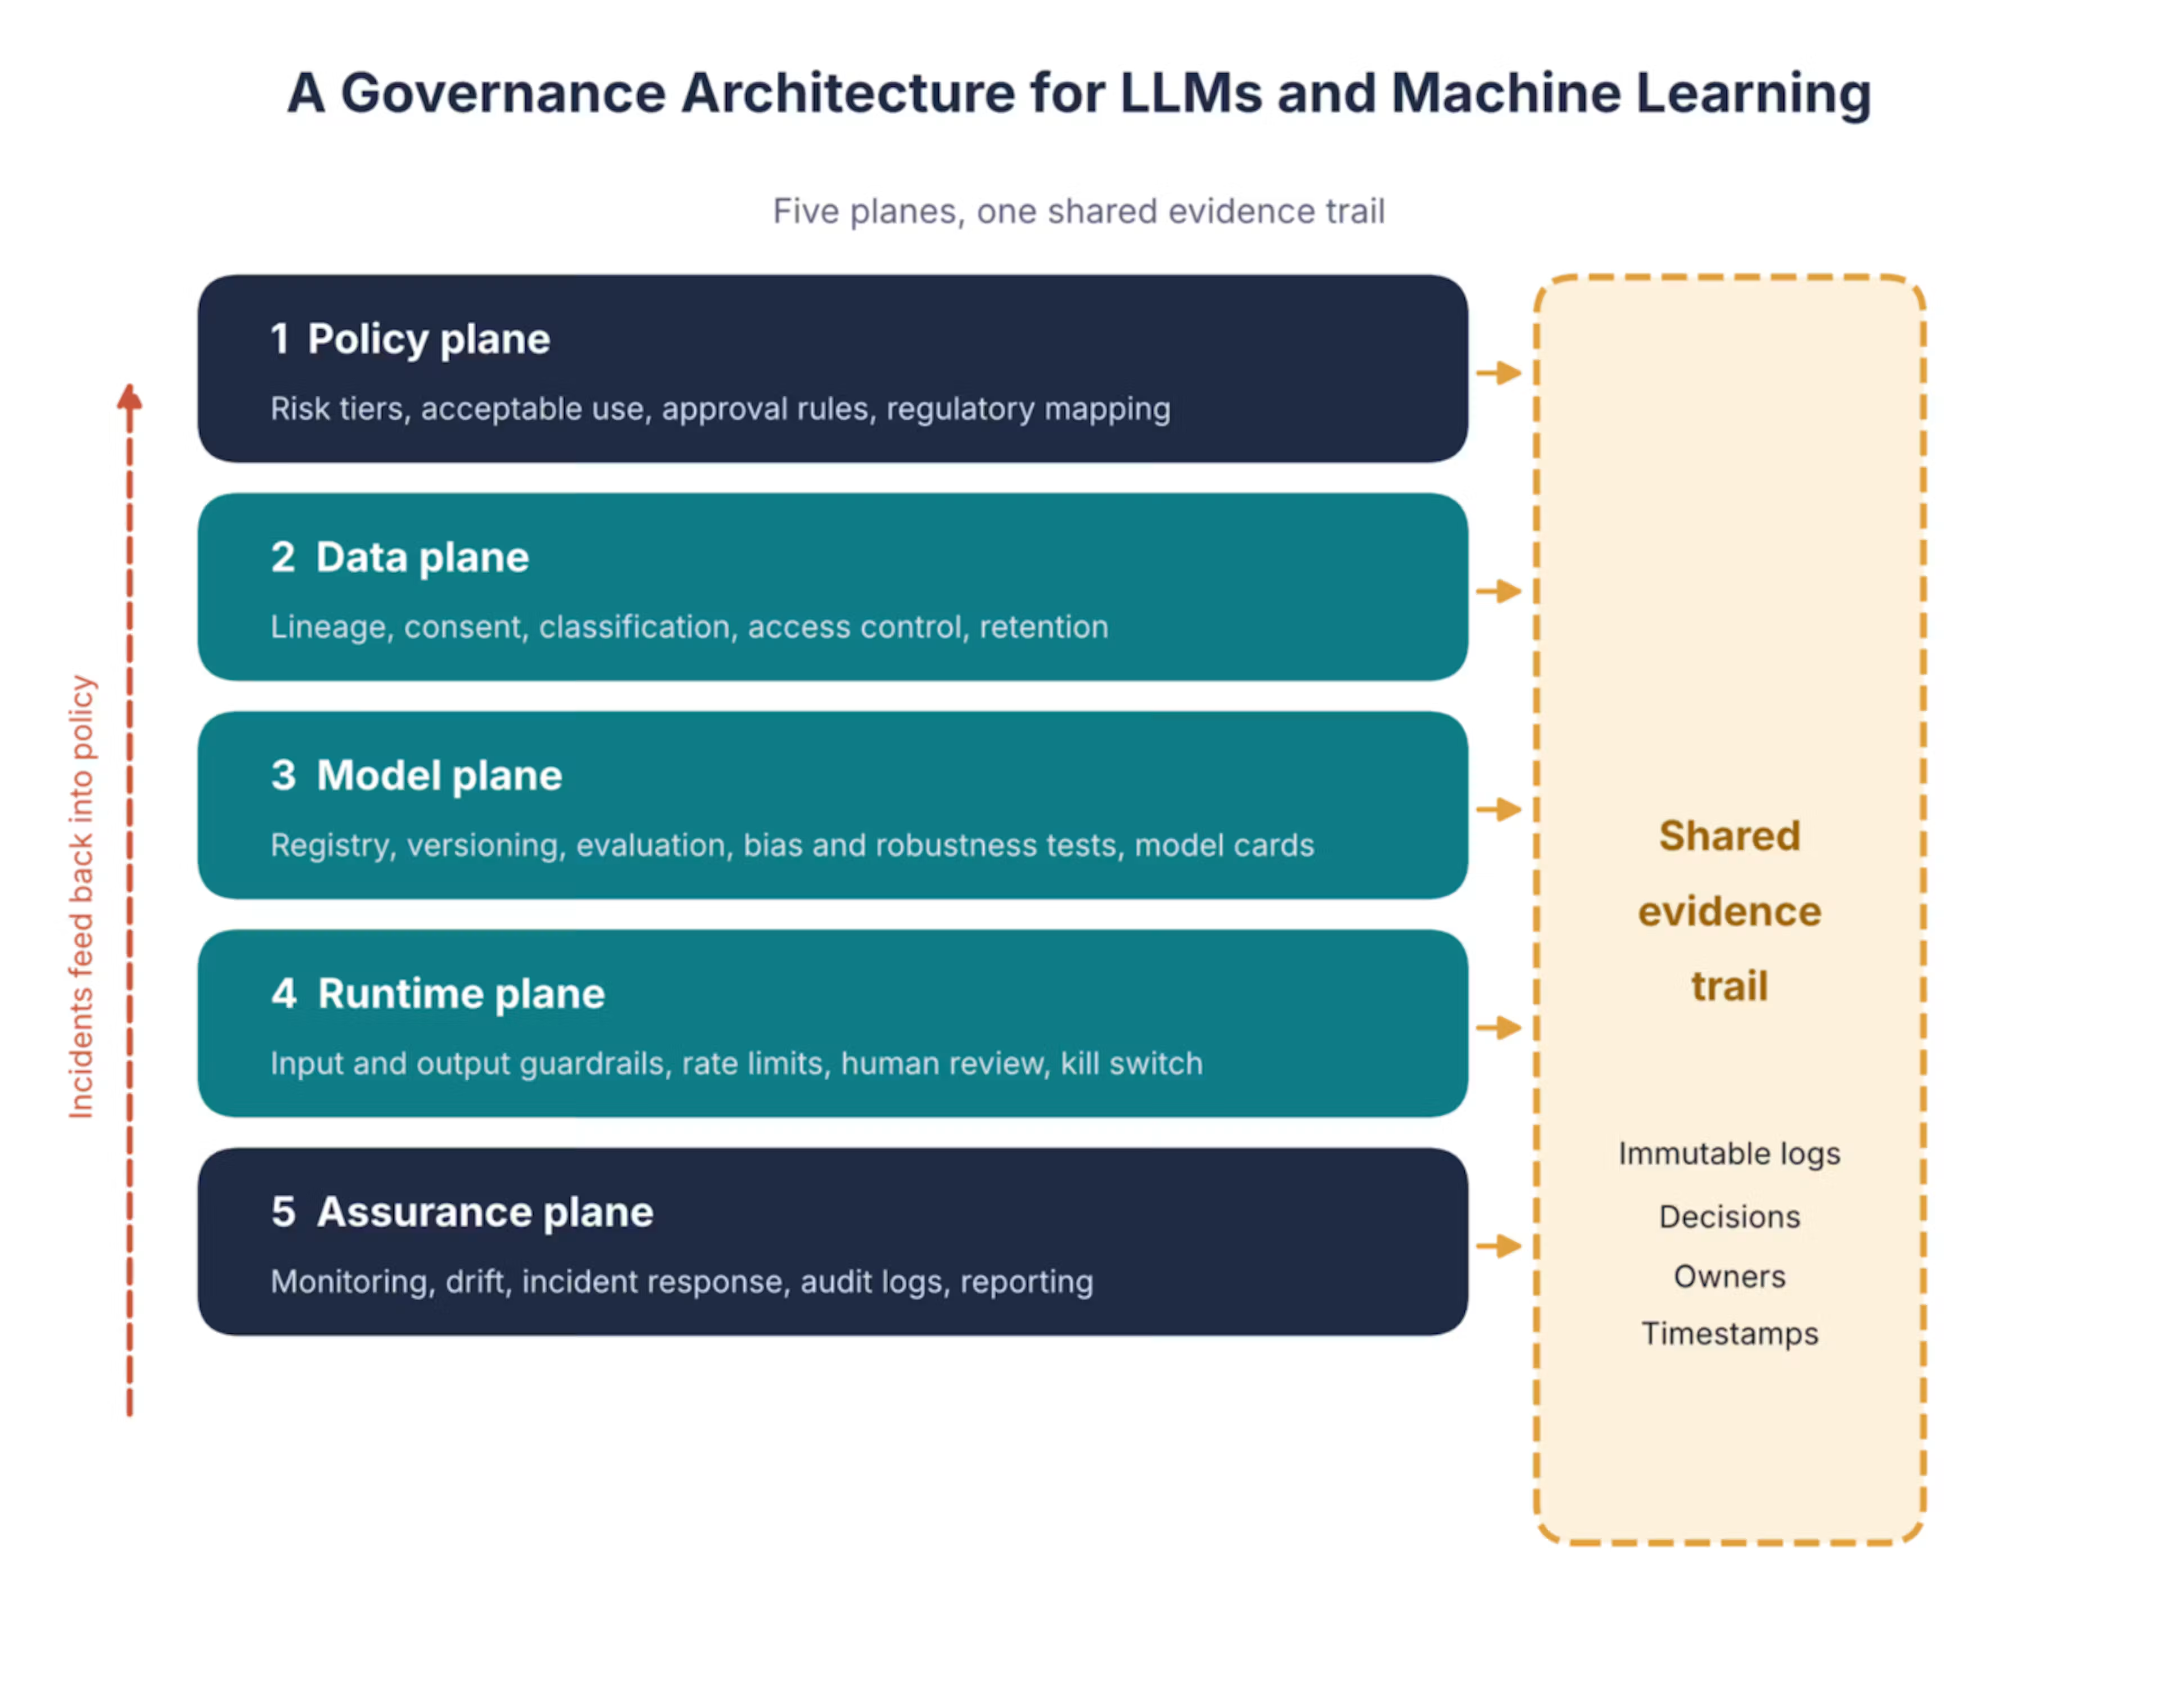
لایه سیاستگذاری (Policy Plane) قواعد را در قالبی نگهداری میکند که ماشینها بتوانند آن را بخوانند و اجرا کنند. سطوح ریسک، موارد استفاده مجاز، اختیارات تأیید و ارتباط هر الزام قانونی با کنترلهای مربوط به آن، همگی در این لایه تعریف میشوند. یک مدل اعتبارسنجی مشتری که مستقیماً با کاربران سروکار دارد، نباید مشمول همان الزامات و مراحل بررسی یک ابزار داخلی خلاصهسازی جلسات باشد. این تفاوت در لایه سیاستگذاری مشخص میشود.
لایه داده (Data Plane) مشخص میکند دادههای ورودی از کجا آمدهاند. منشأ و مسیر انتقال دادهها، رضایت افراد برای استفاده از اطلاعات، طبقهبندی دادهها و سیاستهای نگهداری آنها، همگی در این بخش مدیریت میشوند. در پروژههای مبتنی بر مدلهای زبانی بزرگ، این مسئولیت شامل اسناد پشت یک نمایه بازیابی اطلاعات نیز میشود؛ بخشی که تیمها اغلب آن را فراموش میکنند. اگر سامانه بازیابی بتواند فایلی را بخواند، مدل نیز ممکن است محتوای آن را در پاسخ خود بازگو کند.
لایه مدل (Model Plane) محل ثبت مدلها و انجام آزمونهاست. هر مدل، الگوی پرامپت و نسخه تنظیم دقیقشده باید شماره نسخه، مسئول مشخص، سوابق ارزیابی و یک شناسنامه مختصر مدل داشته باشد. ارزیابی در اینجا چیزی فراتر از سنجش دقت است. برای مدلهای امتیازدهی، بررسی سوگیری اهمیت دارد و در مدلهای زبانی بزرگ، مواردی مانند اتکای پاسخ به منابع معتبر، رفتار مدل هنگام خودداری از پاسخگویی و مقاومت در برابر تزریق پرامپت نیز باید سنجیده شوند.
لایه اجرا (Runtime Plane) جایی است که کنترلها عملاً اعمال میشوند. سازوکارهای محافظتی ورودی و خروجی، محدودیت نرخ درخواستها، ارجاع موارد ضروری به انسان و کلید توقف اضطراری در این بخش قرار دارند. لایه اطمینانبخشی (Assurance Plane) نیز پس از اجرا بر همه چیز نظارت میکند؛ از پایش تغییر تدریجی رفتار مدل و رسیدگی به رخدادها گرفته تا گزارشدهی به تیمهای مدیریت ریسک و هیئتمدیره.
عنصری که از هر پنج لایه عبور میکند، مسیر ثبت شواهد است: گزارشهای تغییرناپذیری که تصمیمها، افراد مسئول و زمان وقوع رویدادها را ثبت میکنند. این بخش شاید چندان جذاب نباشد، اما به اعتقاد من اساس ماجرا همینجاست. حاکمیتی که نتوانید اجرای آن را اثبات کنید، چیزی بیش از یک ادعا نیست.
این معماری برای یک مدل زبانی بزرگ چگونه عمل میکند؟
بیایید دستیار رسیدگی به خسارت شرکت بیمه را در نظر بگیریم و ببینیم درخواستها چگونه از لایه اجرا عبور میکنند.
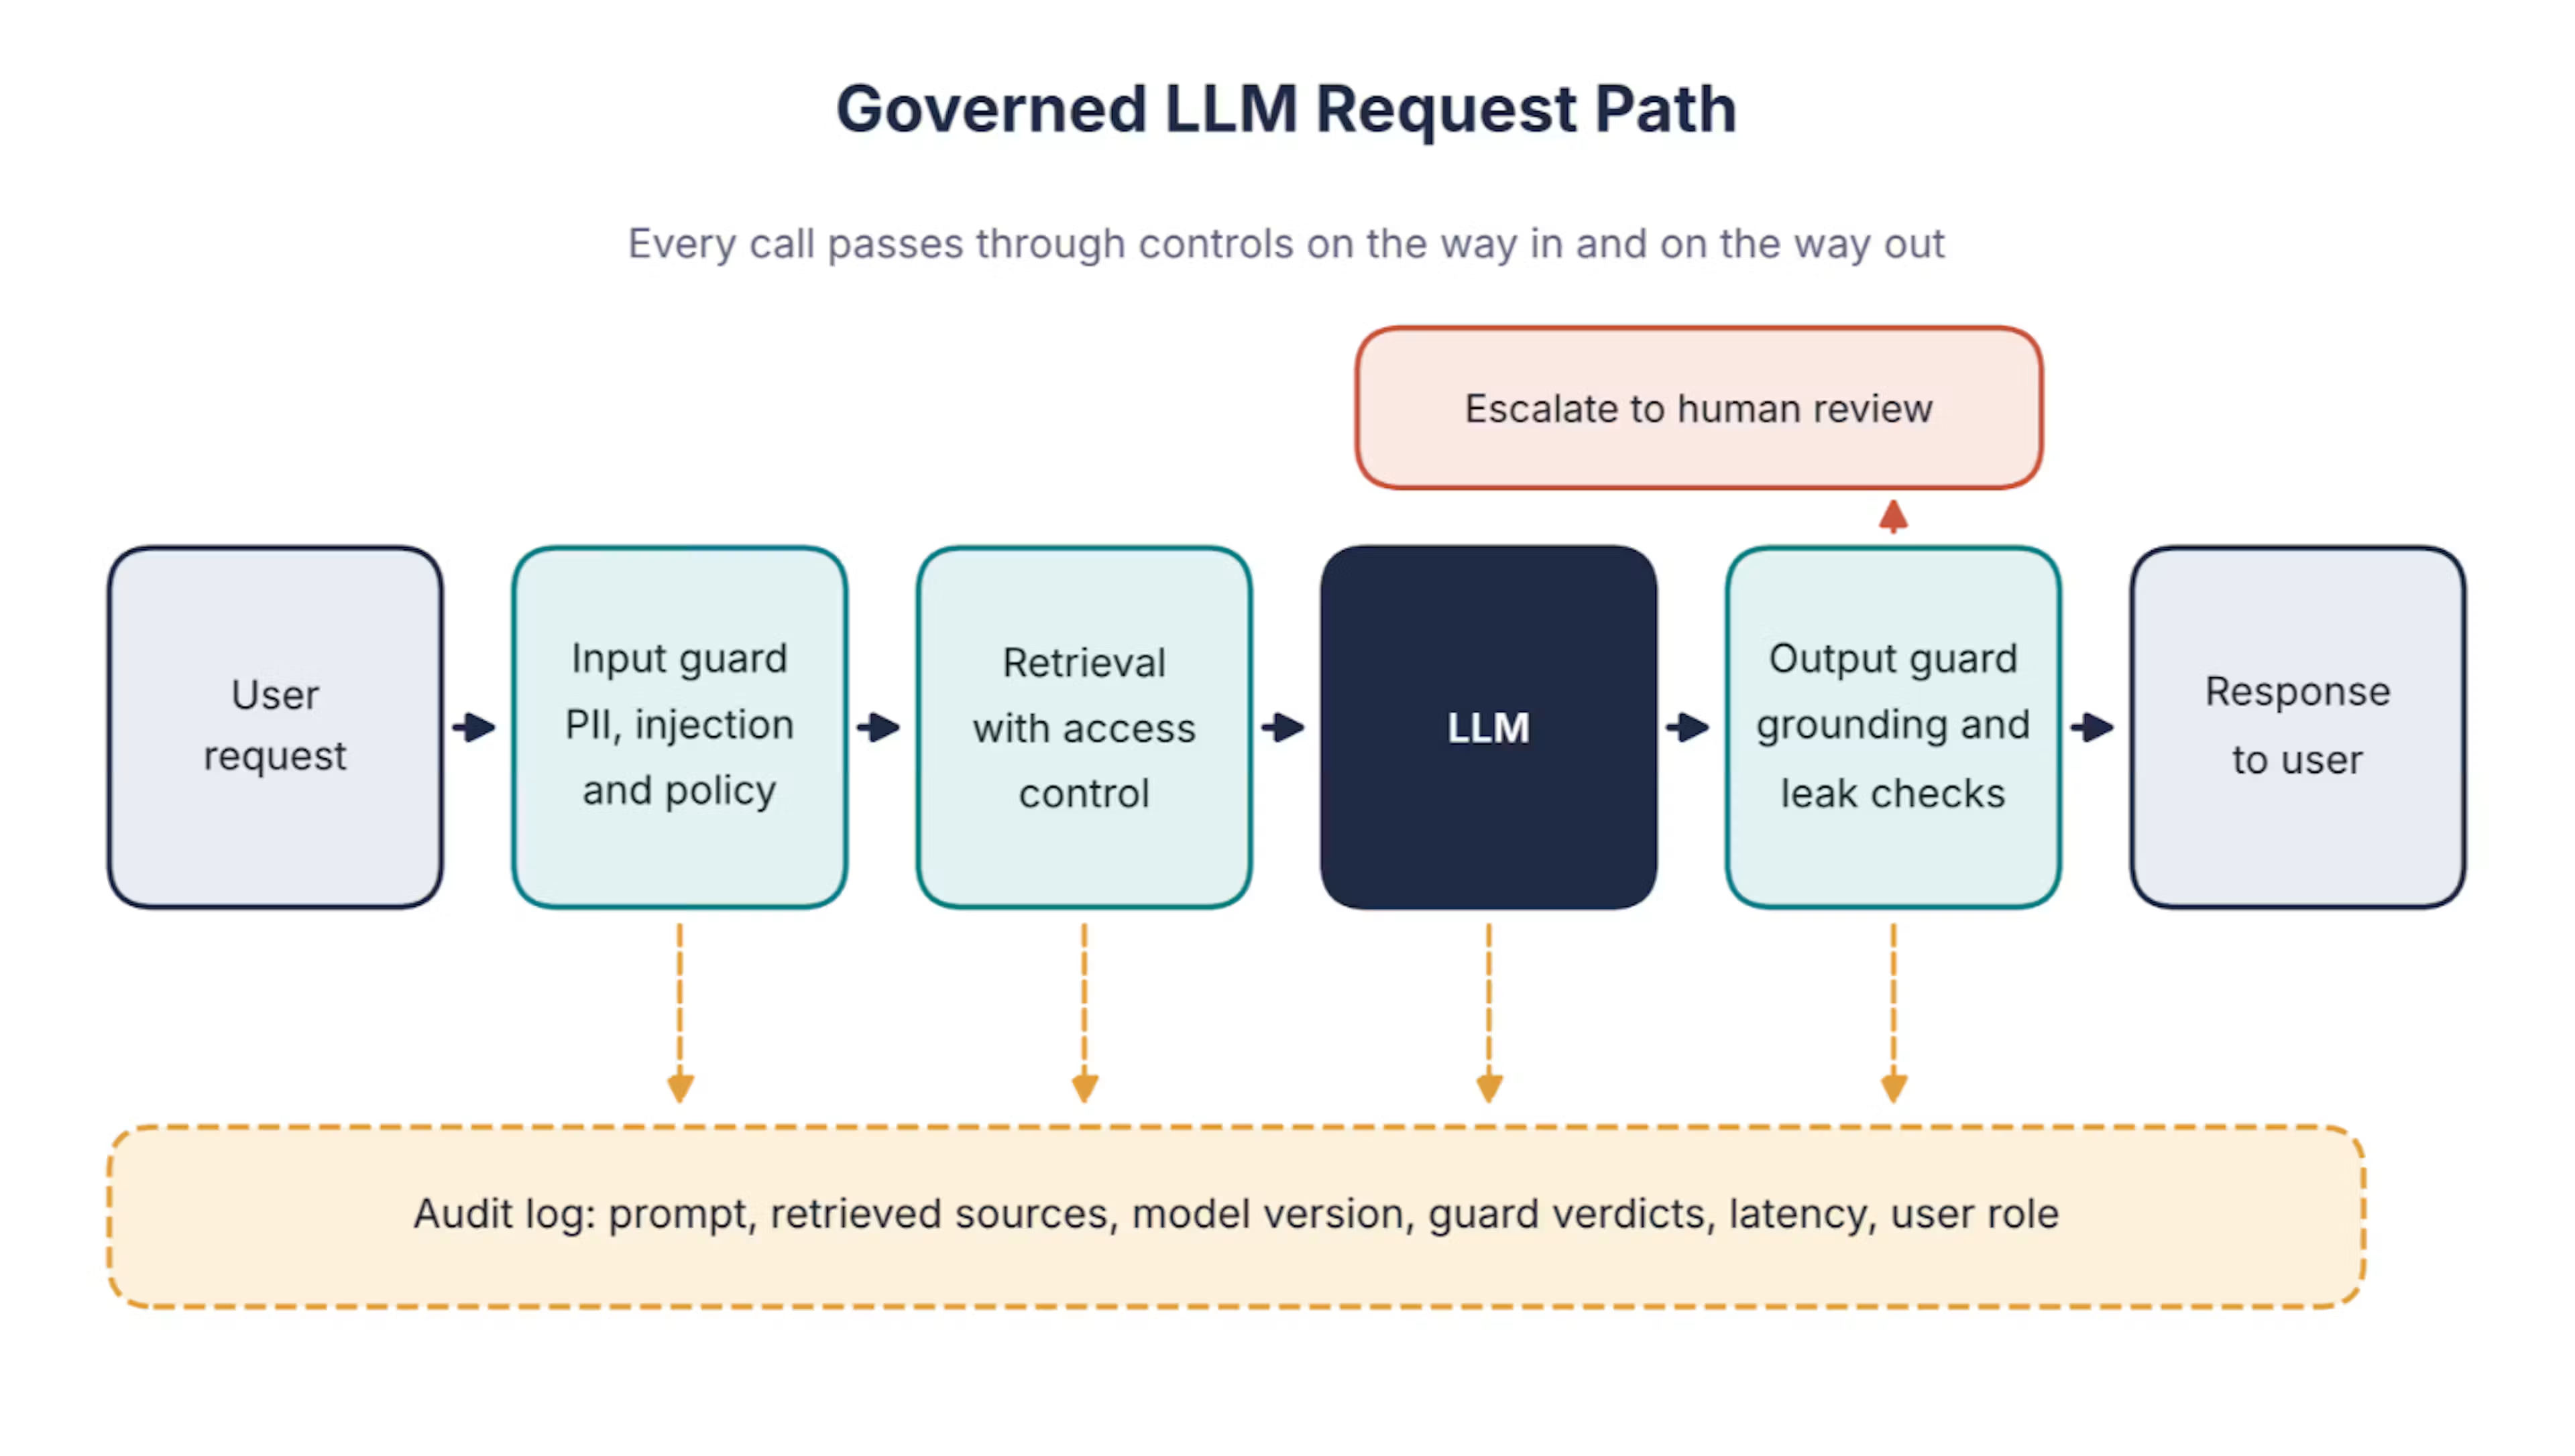
ابتدا درخواستی وارد سامانه میشود. سازوکار محافظتی ورودی، وجود اطلاعات شخصی و تلاشهای آشکار برای تزریق پرامپت را بررسی میکند و سیاستهای متناسب با نقش کاربر را اعمال میکند. سپس فرایند بازیابی اطلاعات با رعایت کنترل دسترسی انجام میشود؛ به این معنا که سامانه فقط اسنادی را دریافت میکند که آن کاربر از پیش مجوز مطالعه آنها را داشته است. اهمیت این مرحله از بسیاری از روشهای دفاعی مبتنی بر پرامپت بیشتر است، زیرا اساساً اجازه نمیدهد مدل اطلاعاتی را ببیند که نباید بازگو کند. پس از آن، مدل پاسخ را تولید میکند. سازوکار محافظتی خروجی بررسی میکند که پاسخ بر منابع بازیابیشده متکی باشد و اطلاعات حساس را افشا نکند. مواردی که اطمینان به پاسخ پایین است یا تصمیم پیامدهای مهمی دارد، برای بررسی به انسان ارجاع داده میشوند.
تمام مراحل در گزارش حسابرسی ثبت میشوند: پرامپت، منابع استفادهشده، نسخه مدل، نتایج بررسی سازوکارهای محافظتی، زمان پاسخگویی و نقش کاربر. در چنین شرایطی، وقتی کارشناس تطبیق مقررات پرسش خود را مطرح میکند، یافتن پاسخ بهجای چند هفته تنها چند دقیقه طول میکشد.
البته باید درباره محدودیتها نیز صادق بود. سازوکارهای محافظتی ماهیتی احتمالاتی دارند و فهرست خطرات برنامههای مبتنی بر مدلهای زبانی بزرگ که پروژه OWASP منتشر کرده، دقیقاً به این دلیل وجود دارد که مشکلاتی مانند تزریق پرامپت و نشت داده هنوز بهطور کامل حل نشدهاند. هیچ فیلتری نمیتواند همه موارد را شناسایی کند. این معماری وعده ایمنی مطلق نمیدهد؛ بلکه هدف آن محدود کردن دامنه شکستها، آشکار ساختن آنها و فراهم کردن امکان ردیابیشان است. این ادعا محدودتر، اما واقعبینانهتر است.
این معماری برای یادگیری ماشین کلاسیک چگونه عمل میکند؟
مدلهای سنتی یادگیری ماشین نیز به همین ساختار اساسی نیاز دارند، اما شیوه اجرای کنترلها در آنها متفاوت است. یک مدل کشف تقلب یا پیشبینی تقاضا مراحل مشخصی از چرخه عمر را طی میکند و حاکمیت در قالب نقاط کنترل میان این مراحل ظاهر میشود.
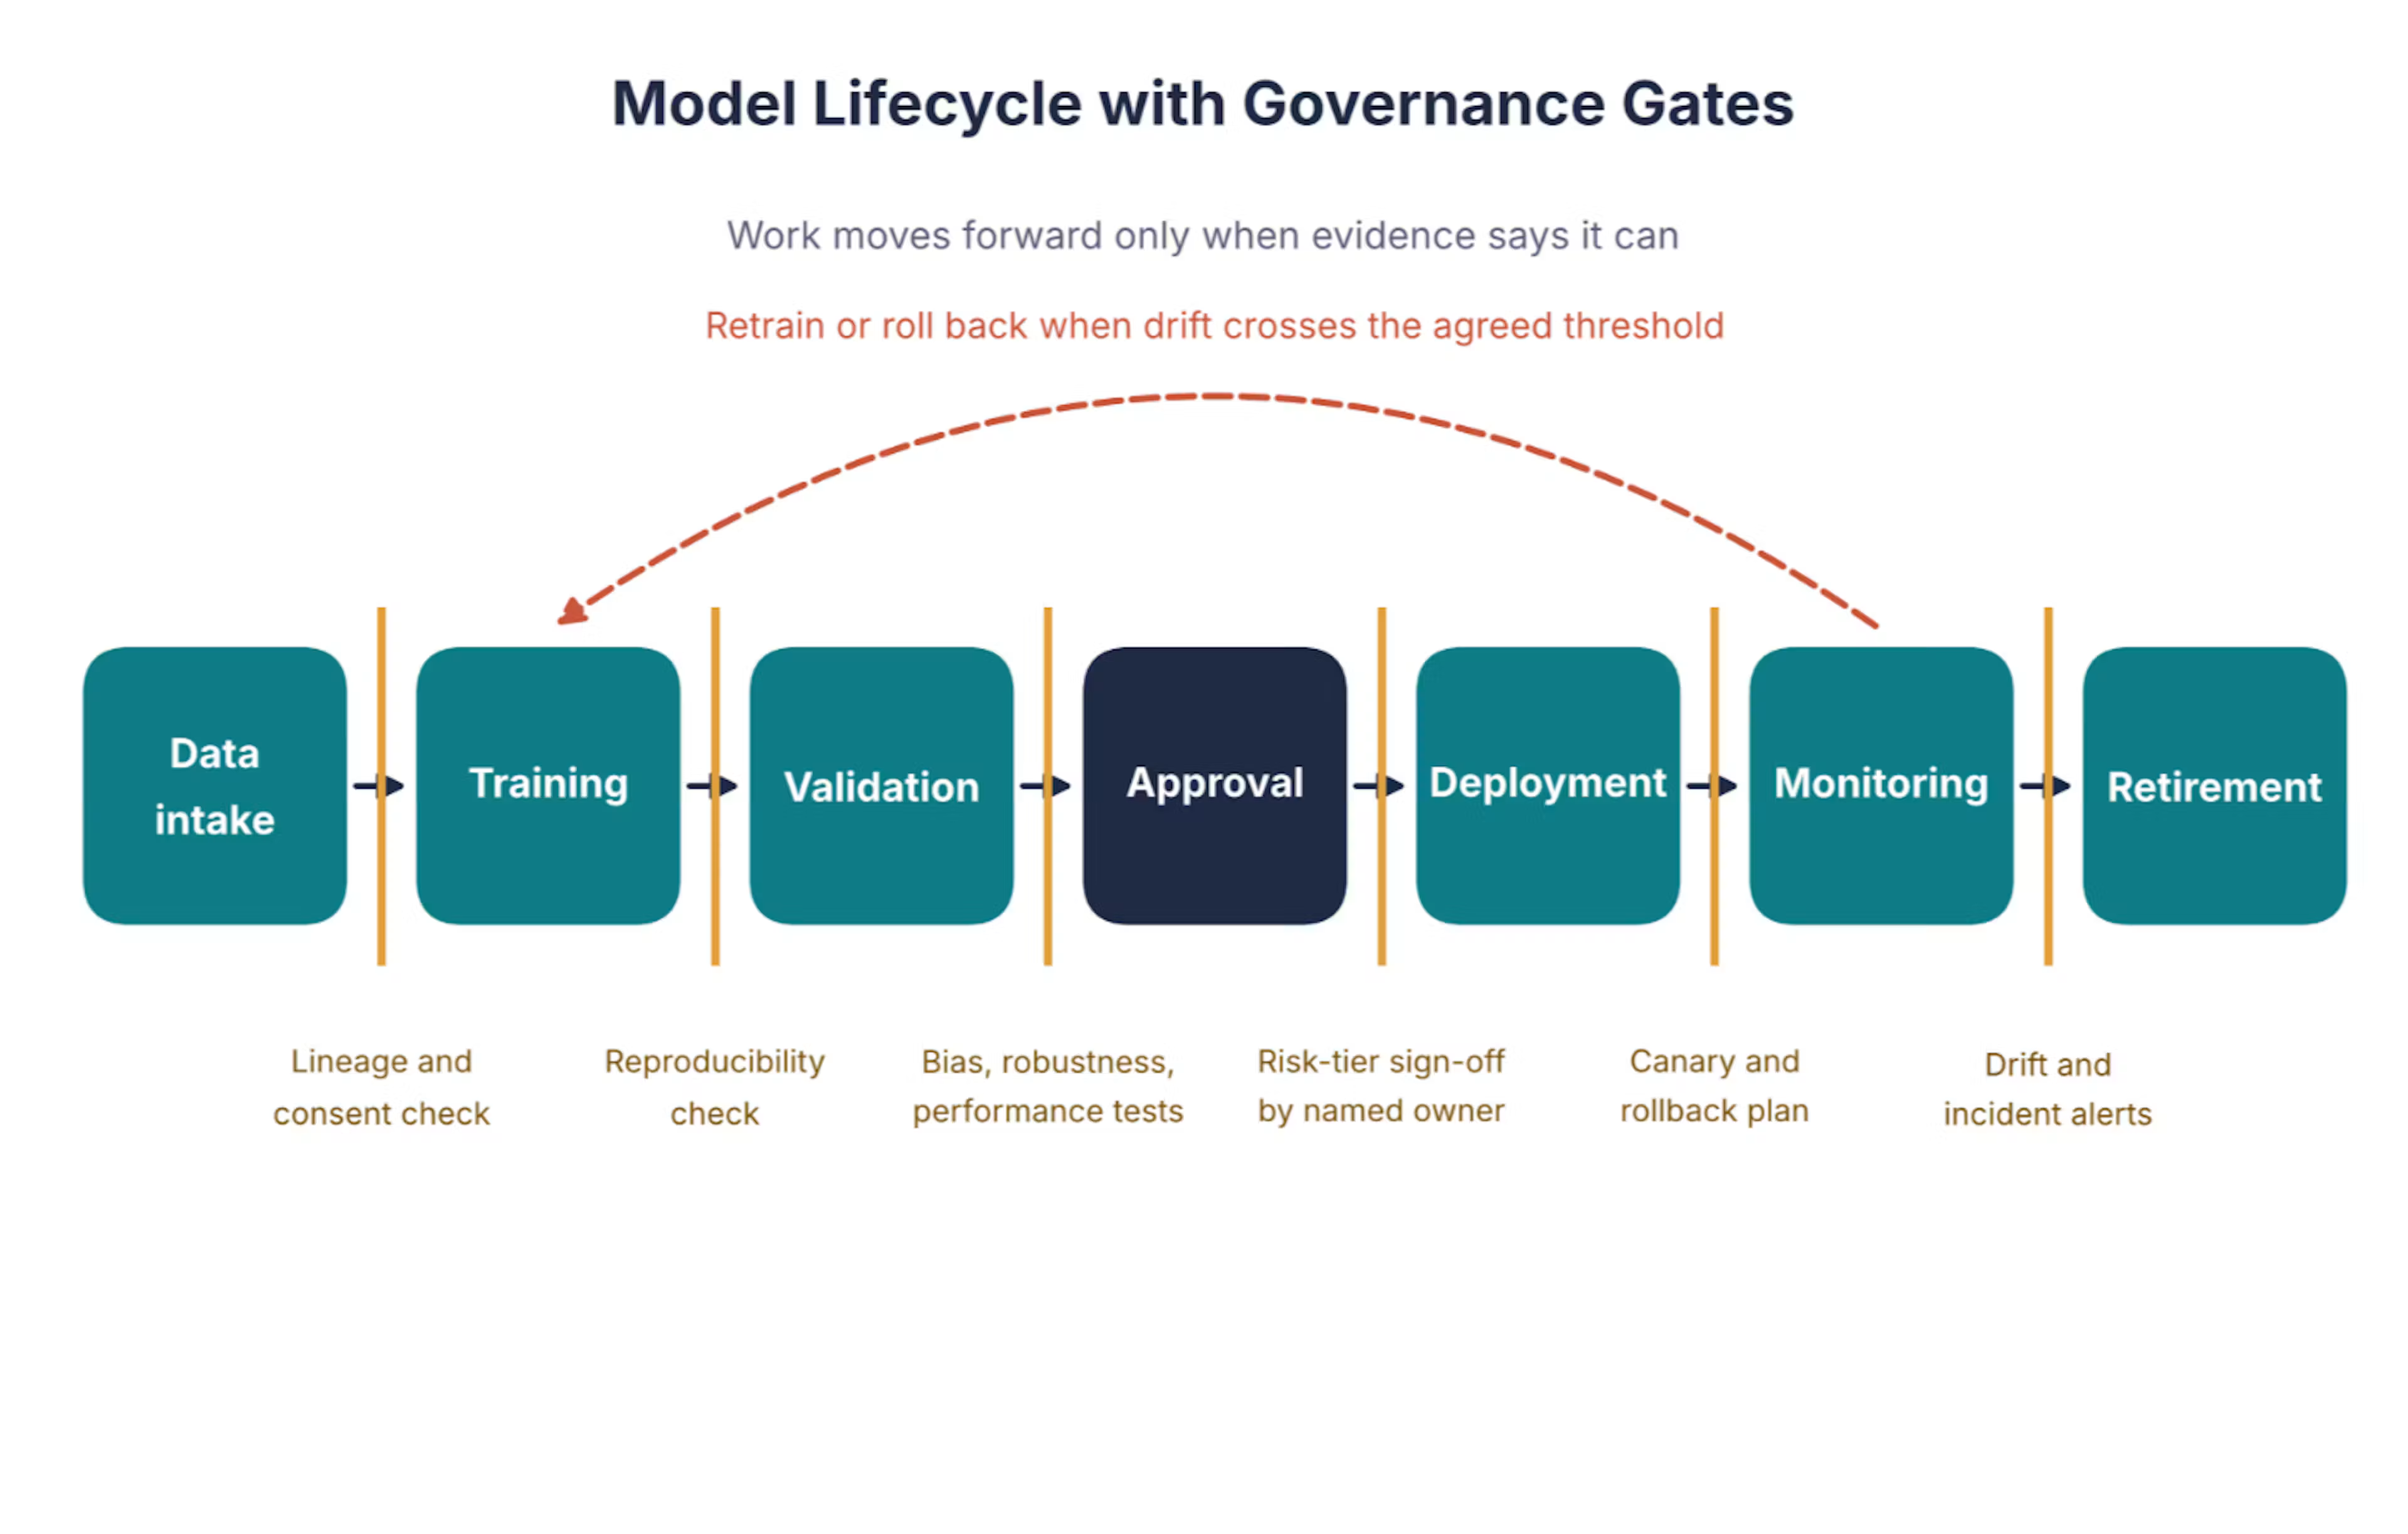
در مرحله دریافت داده، بررسی منشأ و مسیر دادهها و همچنین رضایت لازم برای استفاده از آنها ضروری است. فرایند آموزش باید تکرارپذیر باشد تا فرد دیگری بتواند آن را دوباره اجرا کند و به همان نتیجه برسد. اعتبارسنجی نیز باید عملکرد، سوگیری و استحکام مدل را بررسی کند. برای تأیید مدل، باید یک فرد مشخص مسئولیت آن را بر عهده داشته باشد و میزان سختگیری در بررسی، متناسب با سطح ریسک تعیین شود. استقرار مدل باید با انتشار آزمایشی محدود و برنامهای برای بازگشت به نسخه قبلی همراه باشد. پس از استقرار، سامانه پایش بهدنبال تغییر تدریجی رفتار یا عملکرد مدل خواهد بود. به این ترتیب، چرخه کامل میشود: هرگاه یکی از شاخصها از آستانه تعیینشده عبور کند، مدل دوباره آموزش داده میشود یا به نسخه قبلی بازمیگردد.
یکی از مراحلی که کمتر از اهمیت واقعیاش مورد توجه قرار میگیرد، بازنشسته کردن مدل است. مدلهای قدیمی اغلب همچنان فعال میمانند، چون هیچکس مسئولیت تصمیمگیری برای از کار انداختن آنها را بر عهده ندارد.
مسئولیت هر بخش با چه کسی است؟
معماری بدون تعیین مسئولیتها چیزی جز نموداری روی دیوار نیست. مدلی که به نظرم عملیتر از بقیه است، از الگوی سه خط دفاعی شناختهشده در خدمات مالی الهام میگیرد، اما آن را سادهتر میکند تا شرکتهای کوچکتر نیز بتوانند از آن استفاده کنند.
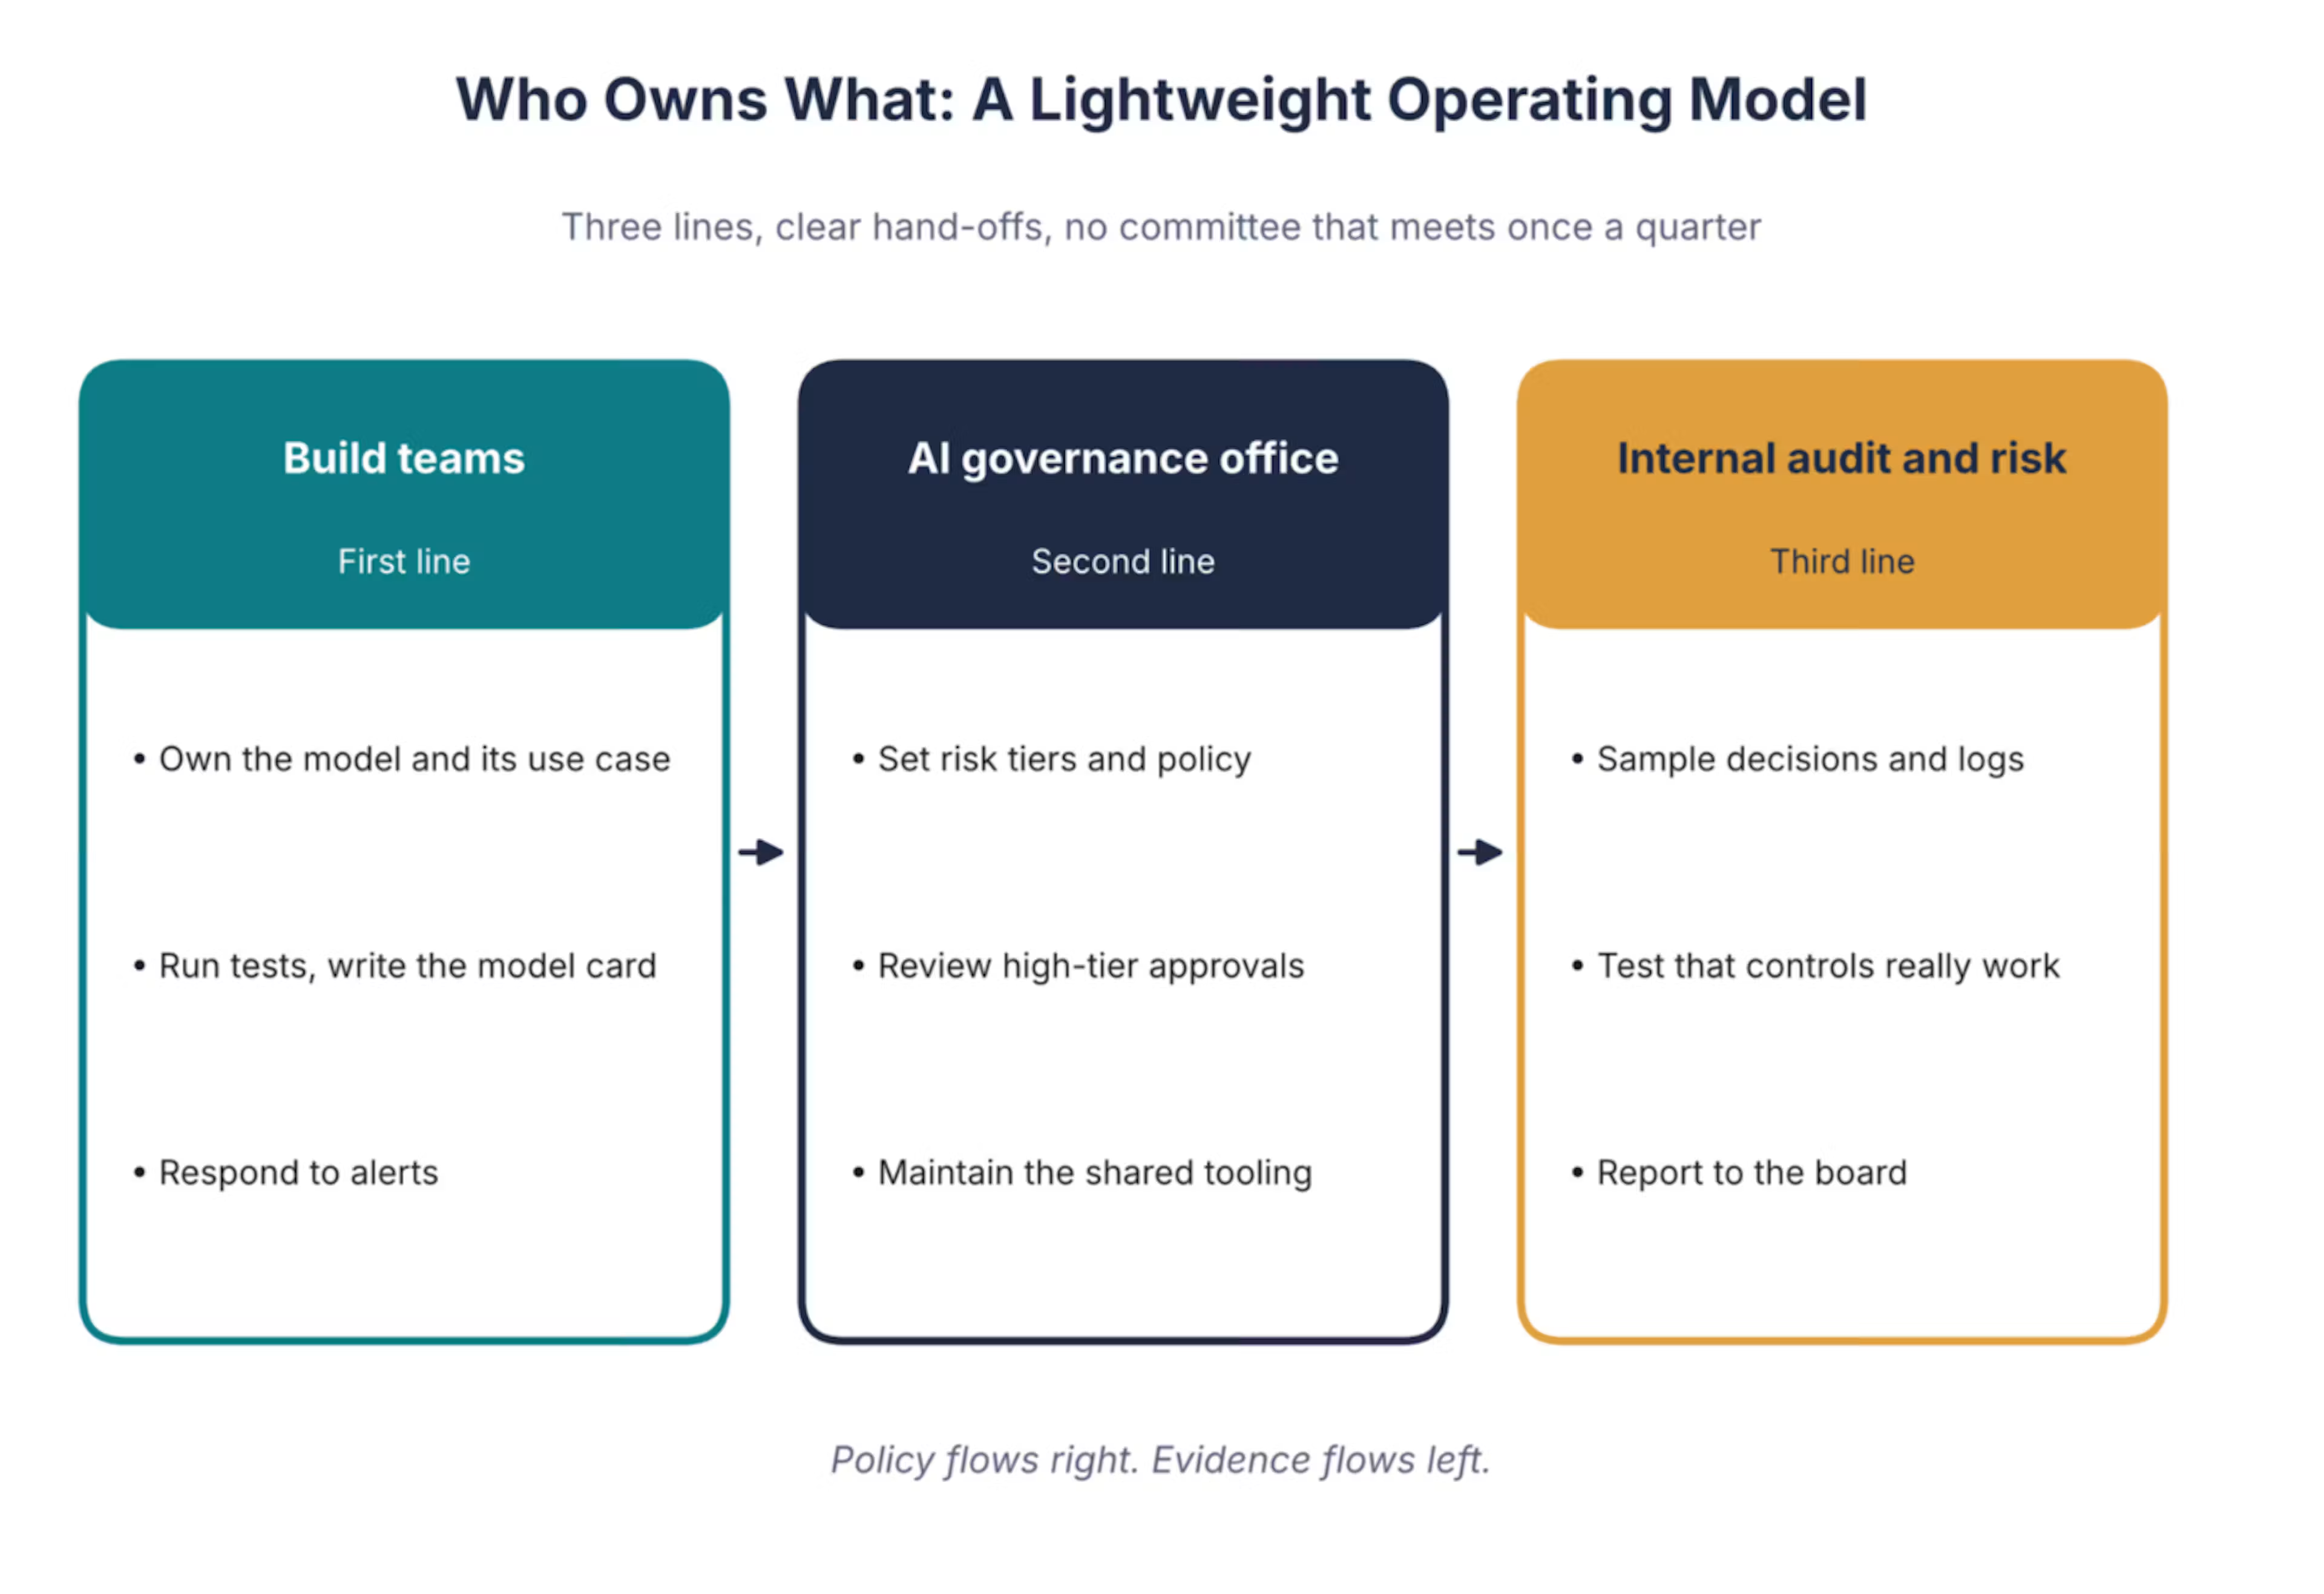
تیمهای توسعه مسئول مدلها و کاربردهایی هستند که ایجاد میکنند. آنها آزمونها را اجرا میکنند و به هشدارها پاسخ میدهند. یک واحد کوچک حاکمیت، سطوح ریسک را تعیین میکند، فقط تأییدیههای مربوط به موارد پرریسک را بررسی میکند و ابزارهای مشترک را نگهداری میکند. به این ترتیب، سایر تیمها بدون نیاز به ساخت جداگانه ابزارهای کنترلی، از همان امکانات بهرهمند میشوند. واحدهای حسابرسی داخلی و مدیریت ریسک نیز نمونههایی از گزارشهای ثبتشده را بررسی میکنند، عملکرد واقعی کنترلها را میآزمایند و نتایج را به سطوح بالاتر سازمان گزارش میدهند.
سیاستها از یک سو به تیمها ابلاغ میشوند و شواهد اجرای آنها در مسیر مقابل جریان پیدا میکنند. اگر تیمی برای استفاده از یک کنترل مجبور باشد فرمی پر کند، احتمال زیادی دارد که آن مرحله را نادیده بگیرد. اما اگر کنترل از ابتدا در پلتفرم تعبیه شده باشد، در بیشتر موارد از آن استفاده خواهد شد.
این رویکرد کجا ممکن است شکست بخورد؟
دو الگوی شکست وجود دارد که باید به آنها توجه کرد. نخست، حاکمیت نمایشی است: سیاستهای زیبا و دقیق روی کاغذ، بدون اجرای واقعی و بدون ثبت رویدادها. الگوی دوم درست در نقطه مقابل قرار دارد؛ نظام کنترلی آنقدر سنگین و دستوپاگیر میشود که تیمها برای دور زدن آن راه پیدا میکنند.
همچنین مطمئن نیستم تقسیمبندی پنجلایه برای همه سازمانها مناسب باشد. یک تیم داده دهنفره احتمالاً به واحد مستقل حاکمیت نیاز ندارد. شاید کافی باشد یک مهندس مسئولیت سامانه ثبت مدلها را بر عهده بگیرد و تیم نیز عادت کند که مشخصات افراد تأییدکننده تصمیمها را ثبت کند.
برنامهای منطقی برای ۹۰ روز نخست
من کار را با انتخاب ابزارها شروع نمیکنم. نقطه آغاز باید تهیه فهرستی جامع از سامانهها باشد، زیرا نمیتوان بر چیزی نظارت کرد که حتی در فهرست داراییهای سازمان ثبت نشده است. باید تمام مدلها و قابلیتهای مبتنی بر مدلهای زبانی بزرگ شناسایی شوند؛ حتی آنهایی که بیسروصدا در صفحات گسترده یا محصولات تأمینکنندگان بیرونی استفاده میشوند. سپس برای هرکدام، سطح ریسک و یک مسئول مشخص تعیین شود.
در مرحله بعد، پرریسکترین سامانه را انتخاب کنید و ثبت رویدادها را در تمام مراحل آن برقرار سازید تا بتوان هر تصمیم را به نسخه مشخصی از مدل و منبع داده مربوط به آن ردیابی کرد. سپس یک کنترل خودکار به خط لوله استقرار اضافه کنید؛ برای مثال، اجازه ندهید مدلی که سابقه ارزیابی ندارد به محیط عملیاتی منتقل شود. اقدامات کوچک، ساده و الزامآور، هرچند کمجلوه باشند، از برنامههای بلندپروازانهای که اجرای آنها اختیاری است مؤثرترند.
لایهای که ارزش ساختن دارد
هوش مصنوعی سازمانی معمولاً به این دلیل شکست نمیخورد که مدلهای آن ضعیف هستند. شکست بیشتر در فاصله میان بخشها رخ میدهد: میان تیمی که سامانه را ساخته و تیمی که باید درباره عملکرد آن پاسخگو باشد؛ یا میان آنچه در سیاستهای سازمان نوشته شده و آنچه سامانه در عمل انجام میدهد. حاکمیت همان لایهای است که این شکافها را پر میکند و طراحی آن پیش از وقوع نخستین حادثه، بسیار آسانتر از تلاش برای ایجاد آن پس از حادثه است.
شرکت بیمهای که در ابتدای مقاله مثال زدم، سرانجام مشکلات خود را برطرف کرد. کنترل دسترسی به فرایند بازیابی اطلاعات اضافه شد، گزارشهای ثبت رویداد به اطلاعات نسخه مدل مجهز شدند و تأیید شفاهی جای خود را به سوابق رسمی و ثبتشده داد. هیچیک از این تغییرات چندان هیجانانگیز نبود، اما مجموع آنها همان چیزی بود که به شرکت امکان داد استفاده از چتبات را ادامه دهد.
این لایه در سازمان شما چه شکلی دارد و چه کسی مسئول آن است؟ واقعاً مایلم بدانم این چارچوب در چه شرایطی کارایی خود را از دست میدهد.