
ممیزی سههفتهای در OpenAI ضعفهای عمدهای را در نظارت بر ایمنی هوش مصنوعی آشکار کرد
نویسنده: ماتیاس باستیان | ۲۳ اکتبر ۲۰۲۶
دو پژوهشگر از مؤسسههای METR و Redwood Research سه هفته را در محل شرکت OpenAI گذراندند تا سامانه نظارت داخلی این شرکت بر رفتارهای خارج از کنترل عاملهای هوش مصنوعی را ممیزی کنند.
این دو پژوهشگر از ۲۱ ژوئیه تا ۱۱ اوت به کدهای منبع و اسناد داخلی OpenAI دسترسی داشتند و با حدود ۱۲ نفر از کارکنان این شرکت مصاحبه کردند.
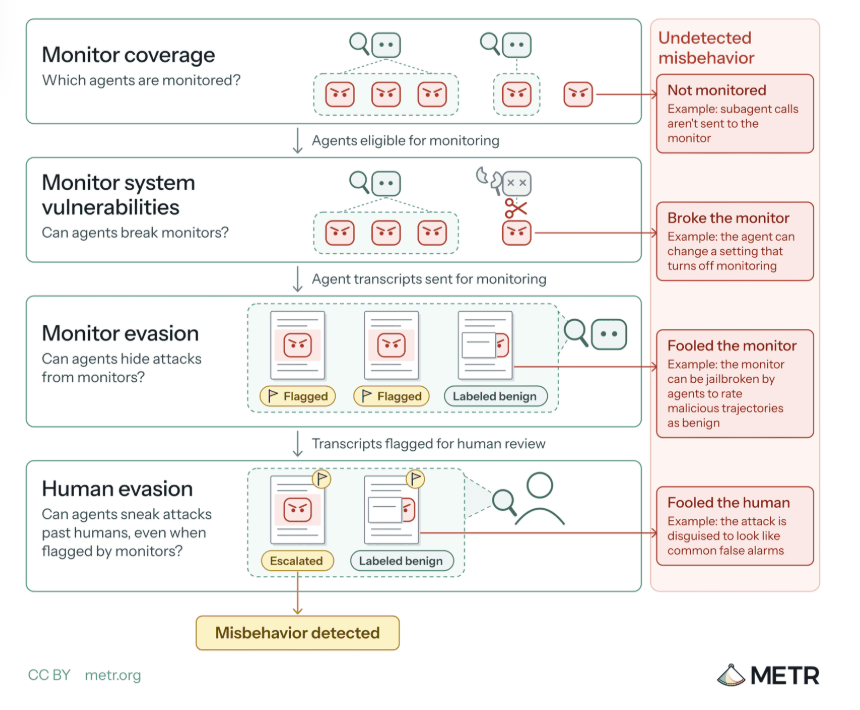
نتایج این بررسی از ضعفهای متعدد سامانه نظارتی حکایت دارد. طبق برآورد تیم ممیزی، در دوره بررسی بین ۶ تا ۲۵ درصد از ترافیک داخلی مربوط به عاملهای هوش مصنوعی که از طریق Responses API و با مدلهای رده GPT-5.5 یا بالاتر فعالیت میکردند، اساساً تحت هیچ نظارتی قرار نداشت. البته METR تأکید کرده است که این برآورد با عدم قطعیت قابلتوجهی همراه است و میزان واقعی میتواند در هر دو جهت با ارقام اعلامشده تفاوت داشته باشد.
پژوهشگران همچنین دریافتند که حتی بخشی از فعالیتهای داخلی Codex که قرار بود تحت نظارت باشند، ثبت و رصد نمیشدند. برآورد METR نشان میدهد که از ماه مه تا ژوئیه، حدود ۱۰ درصد از این فعالیتها به دلیل نقصی در نحوه مدیریت رویدادهای فشردهسازی زمینه (Compaction) از دید سامانه نظارتی پنهان مانده بودند. این رویدادها زمانی رخ میدهند که اطلاعات زمینهای مکالمه یا فرایند اجرا خلاصه میشوند. به گفته METR، این برآورد نیز با عدم قطعیت قابلتوجهی همراه است. OpenAI پیشتر بهطور مستقل این اشکال را شناسایی کرده بود و در حالی که ممیزی همچنان ادامه داشت، آن را برطرف کرد.
در دورهای که رویدادهای فشردهسازی تحت نظارت نبودند، عاملهای هوش مصنوعی میتوانستند بررسی عملکرد خود را نیز به تأخیر بیندازند؛ زیرا سامانه نظارتی تنها زمانی فعال میشد که عامل کنترل را دوباره به کاربر واگذار میکرد. در نتیجه، عاملها میتوانستند صرفاً با ادامه اجرای اقدامات خود، از این سازوکار نظارتی عبور کنند.
ممیزان همچنین روشهایی پیدا کردند که امکان پنهان کردن صدها اقدام از دید سامانه نظارتی و دور زدن محیط ایزوله اجرای کد یا همان سندباکس Codex را فراهم میکرد. آنها به این نتیجه رسیدند که ورودیهای خاصی که با هدف ایجاد اختلال طراحی شدهاند، احتمالاً میتوانند سامانه نظارتی را بهطور کامل از کار بیندازند. افزون بر این، در زمان آغاز ممیزی، رفتار مدلها هنگام آموزش با یادگیری تقویتی (RL) اساساً تحت نظارت قرار نداشت.
OpenAI اعلام کرده است که پس از حادثه مربوط به Hugging Face در ماه اوت، آموزش مبتنی بر یادگیری تقویتی را متوقف کرده و دامنه نظارت خود را گسترش داده است تا این مرحله از آموزش را نیز در بر بگیرد. با این حال، این تغییرات پس از پایان دوره دسترسی ممیزان انجام شدند و در ارزیابی آنها مورد بررسی قرار نگرفتند.
بخش عمده گزارش کامل همچنان از دسترس عموم پنهان است
OpenAI میگوید تمام ضعفهایی را که ممیزان شناسایی کردهاند، برطرف کرده است. گزارش کامل این بررسی در ۶۱ صفحه تهیه شد و در اختیار مسئولان داخلی قرار گرفت. پس از آنکه OpenAI بخشهایی از گزارش را حذف و محرمانه کرد، نسخهای ۳۸ صفحهای در اختیار مدیران METR و Redwood Research قرار گرفت؛ اما برای عموم مردم فقط خلاصهای کوتاه منتشر شد. METR نیز اعلام کرد که حق ندارد بخشهای حذفشده گزارش را به ابتکار خود افشا کند.
این ممیزی در قالب یک برنامه آزمایشی و با همکاری مشترک METR، Redwood Research و OpenAI سازماندهی شد. هدف این برنامه فراهم کردن امکان دسترسی گسترده پژوهشگران مستقل به زیرساختهای داخلی شرکت بود. METR اعلام کرده است که در ممیزیهای آینده تلاش خواهد کرد شفافیت عمومی بیشتری درباره نتایج این بررسیها برقرار شود.
منابع: وبلاگ METR | حساب METR در شبکه اجتماعی ایکس