
مدل هوش مصنوعی چینی Kimi K3.1 Pro فاصله خود را با Claude Opus 5.5 آنتروپیک کاهش داد
۲۳ اکتبر ۲۰۲۶، ساعت ۲۰:۲۸ به وقت UTC | نویسنده: النا وارگا
مدل Kimi K3.1 Pro شرکت مونشات AI با جهشی ۱۱ امتیازی نسبت به نسل قبلی، به امتیاز ۵۵ در شاخص هوش Artificial Analysis دست یافت و پس از Claude Opus 5.5 در میان چهار مدل برتر قرار گرفت. این مدل با ۲٫۸ تریلیون پارامتر، هزینه استفاده از API را ۳۳ درصد کاهش داده و ممکن است تا ماه نوامبر به قدرتمندترین مدل با وزنهای باز تبدیل شود.
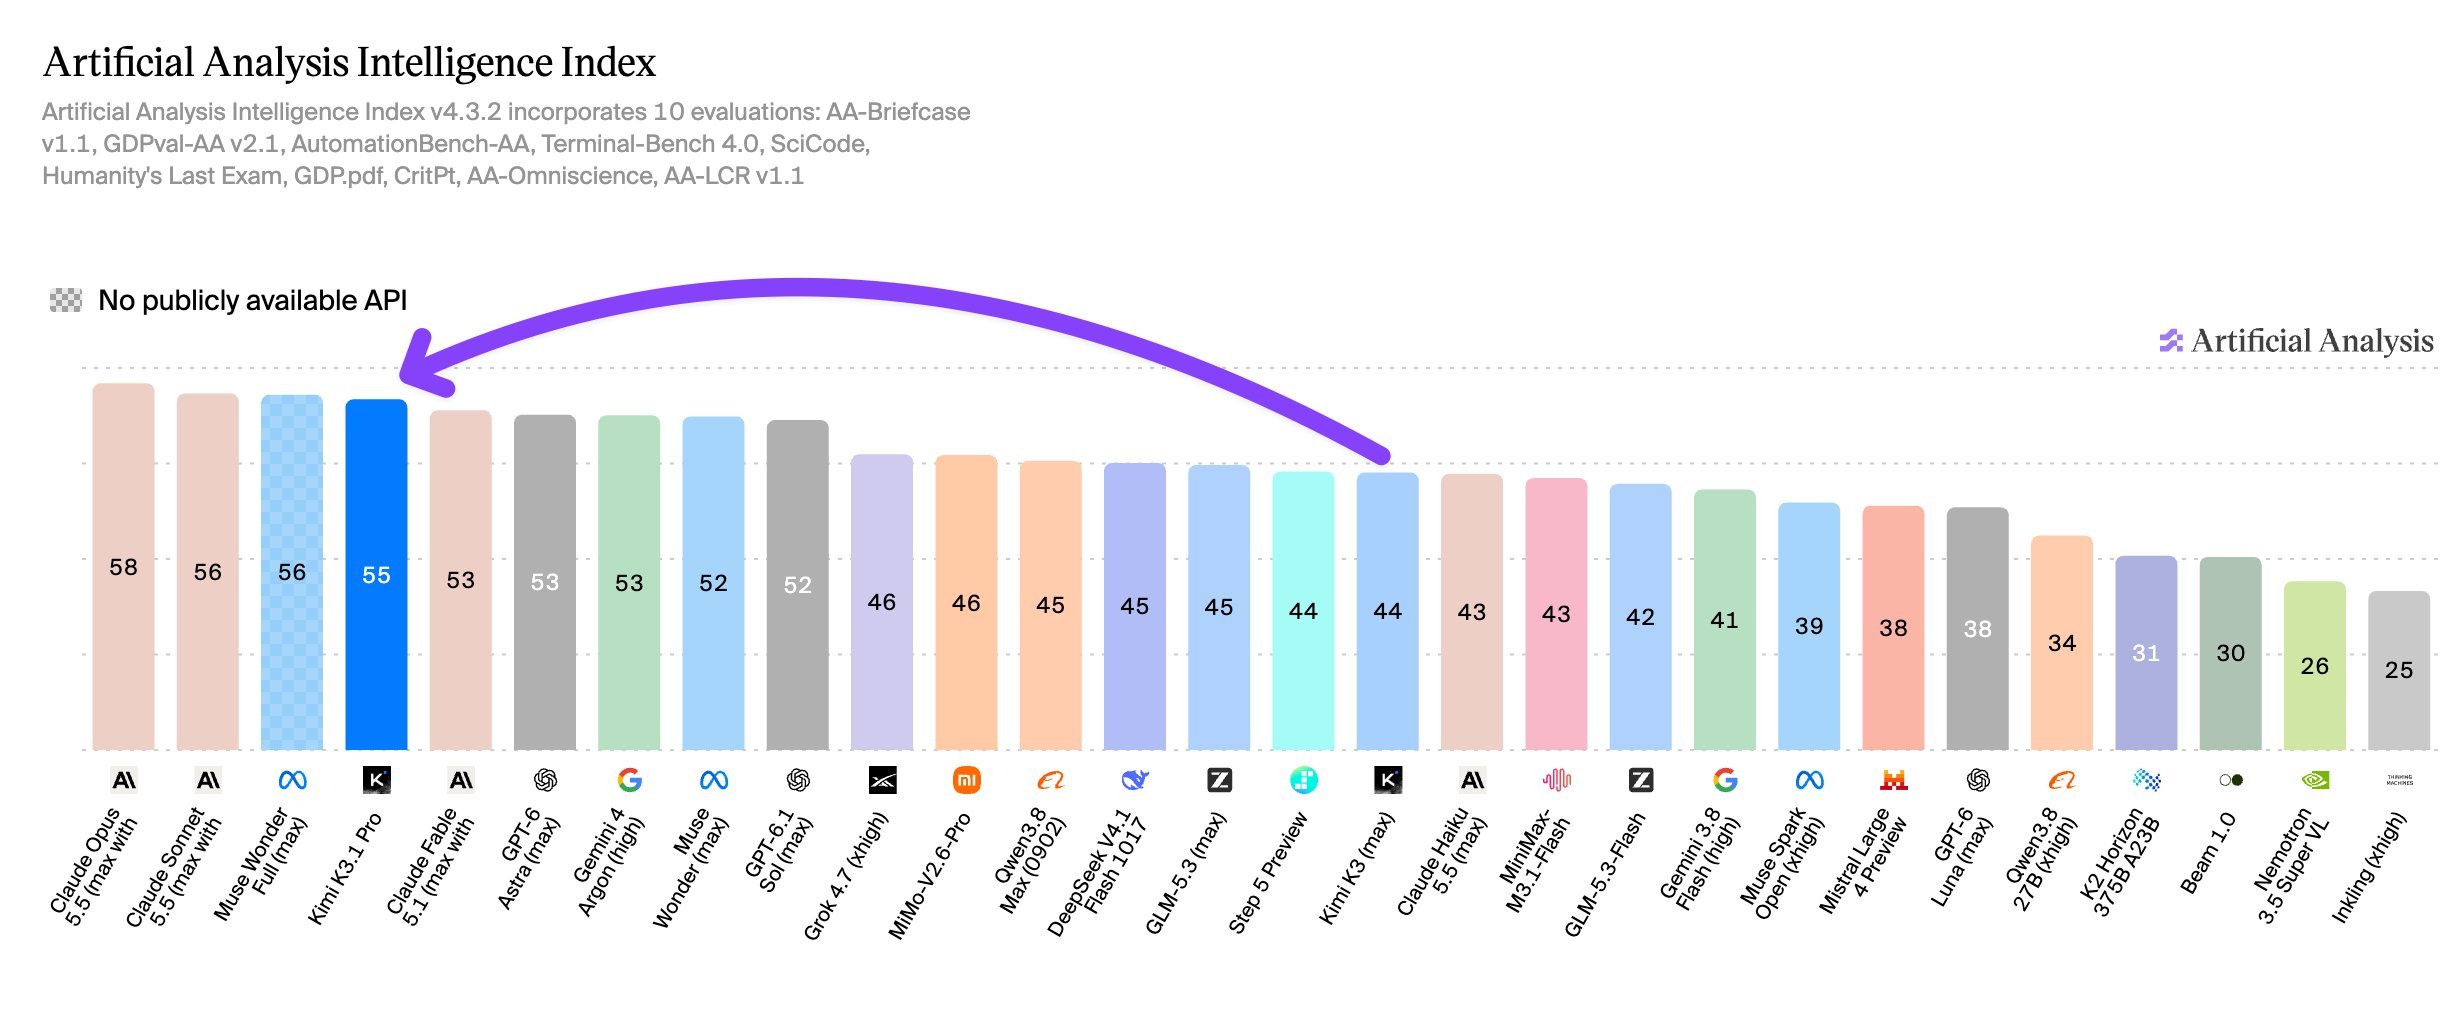
شرکت مونشات AI مدل Kimi K3.1 Pro را منتشر کرده است؛ مدلی استدلالی که با آموزش تکمیلی بهبود یافته و توانسته در شاخص هوش Artificial Analysis امتیاز ۵۵ را کسب کند. این نتیجه در مقایسه با مدل K3، افزایشی ۱۱ امتیازی محسوب میشود و K3.1 Pro را در رتبه چهارم ردهبندی کلی قرار میدهد. سه مدل بالاتر از آن عبارتاند از Claude Opus 5.5 با امتیاز ۵۸، Claude Sonnet 5.5 با امتیاز ۵۶ و Muse Wonder Full که آن هم امتیاز ۵۶ را کسب کرده است.
این پیشرفت، فاصله عملکردی میان مدلهای دارای وزن باز و مدلهای اختصاصی را کمتر میکند. اگر مونشات مطابق برنامه، وزنهای K3.1 Pro را تا ۴ نوامبر ۲۰۲۶ منتشر کند، این مدل به بالاترین امتیاز در میان مدلهای دارای وزن بازِ در دسترس دست خواهد یافت. در این صورت، فاصله بهترین مدلهای باز و اختصاصی از ۱۲ امتیاز به تنها ۳ امتیاز کاهش مییابد؛ البته به شرط آنکه انتشار مدلهای جدید دیگر، ردهبندی فعلی را تغییر ندهد.
کاربران میتوانند از طریق Kimi.ai، سرویس Kimi Work، ابزار Kimi Code و API کیمی به هر دو نسخه دسترسی داشته باشند.
بیشترین پیشرفت K3.1 Pro در وظایف عاملمحور دیده میشود؛ وظایفی که در آنها هوش مصنوعی باید مجموعهای از اقدامات را برای رسیدن به یک هدف انجام دهد. این مدل در آزمون GDPval-AA به امتیاز الو ۱۸۴۶ رسید که ۳۱۲ امتیاز بالاتر از K3 است. با این حال، همچنان ۲۰ امتیاز از Claude Opus 5.5 و ۱۱ امتیاز از Muse Wonder Full عقبتر است. در آزمون Terminal-Bench 4.0 نیز امتیاز ۶۵٫۷ درصد را ثبت کرد و از GPT-6 Astra با امتیاز ۵۸٫۲ درصد پیش افتاد. فاصله آن با Claude Opus 5.5 که امتیاز ۶۶٫۴ درصد را به دست آورده، تنها ۰٫۷ واحد درصد است. این در حالی است که K3 در همین آزمون فقط ۱۳ درصد امتیاز گرفته بود.
میزان تولید اطلاعات نادرست یا ساختگی نیز در آزمون داخلی Kimi Hallu Bench Hard شرکت مونشات بهشدت کاهش یافته است. نرخ خطا در سطح ادعاهای مطرحشده از ۲۳٫۴ درصد در K3 به ۸٫۳ درصد در K3.1 Pro رسیده است. با وجود این پیشرفت، GPT-6 Astra با نرخ خطای ۵٫۵ درصد همچنان عملکرد بهتری دارد. مونشات تأکید میکند که این بنچمارک برای سنجش عملکرد مدل در شرایط دشوار طراحی شده و نتایج آن نباید بهعنوان نرخ خطای عمومی مدل در نظر گرفته شود.
در حوزه مالی نیز K3.1 Pro عملکرد بهتری از نسل پیشین خود نشان داده است. امتیاز این مدل در آزمون Financial Modeling به میزان ۷٫۲ واحد و در Financial Research به میزان ۱۱٫۶ واحد افزایش یافته است. همچنین در نسخه دوم آزمون OfficeQA Pro که توانایی مدلها را در انجام کارهای عمومی اداری ارزیابی میکند، بالاترین امتیاز را در میان تمام مدلهای آزمایششده کسب کرده است.
نتایج بنچمارکها در حالتی که میزان تلاش استدلالی مدل روی بالاترین سطح، یعنی «max»، تنظیم شده بود، نشان میدهد K3.1 Pro در آزمون SWE Marathon v1.1 امتیاز ۵۱٫۷ درصد، در DeepSWE v1.1 امتیاز ۷۵٫۵ درصد و در BenchCAD با استفاده از ابزارها امتیاز ۹۲٫۷ درصد را به دست آورده است. این مدل میتواند با موتورهای بازیسازی Unity و Unreal Engine کار کند و از اصلاح سریع مشکلات تا ساخت پروژههای کامل را انجام دهد. پشتیبانی از موتور Godot نیز به قابلیتهای آن اضافه شده است.
در آزمون BenchCAD بدون استفاده از ابزارهای کمکی، K3.1 Pro امتیاز ۷۲٫۸ درصد را ثبت کرده که بسیار نزدیک به امتیاز ۷۳ درصدی Claude Opus 5.5 است. به گفته مونشات، این مدل بهویژه در مدلسازی پارامتریک قطعات مکانیکی، طراحیهای معماری و محصولاتی که قابلیت تغییر و تنظیم ویژگیهایشان وجود دارد، عملکرد قدرتمندی ارائه میدهد. این شرکت همچنین قابلیت جدیدی با نام «3D Make» را به وبسایت Kimi.com اضافه کرده است که امکان پیشنمایش، ویرایش و خروجی گرفتن از مدلهای سهبعدی را فراهم میکند.
معماری K3.1 Pro همچنان شامل ۲٫۸ تریلیون پارامتر است که از میان آنها ۱۰۴ میلیارد پارامتر در هر نوبت پردازش فعال میشوند. پنجره زمینه این مدل ظرفیت یک میلیون توکن را دارد و میتواند هم متن و هم تصویر را پردازش کند. مؤسسه Artificial Analysis این مدل را در بالاترین نقطه مرز پارتو قرار داده است؛ به این معنا که هیچ مدل دیگری با تعداد پارامترهای مشابه نتوانسته امتیاز بالاتری در شاخص هوش کسب کند.
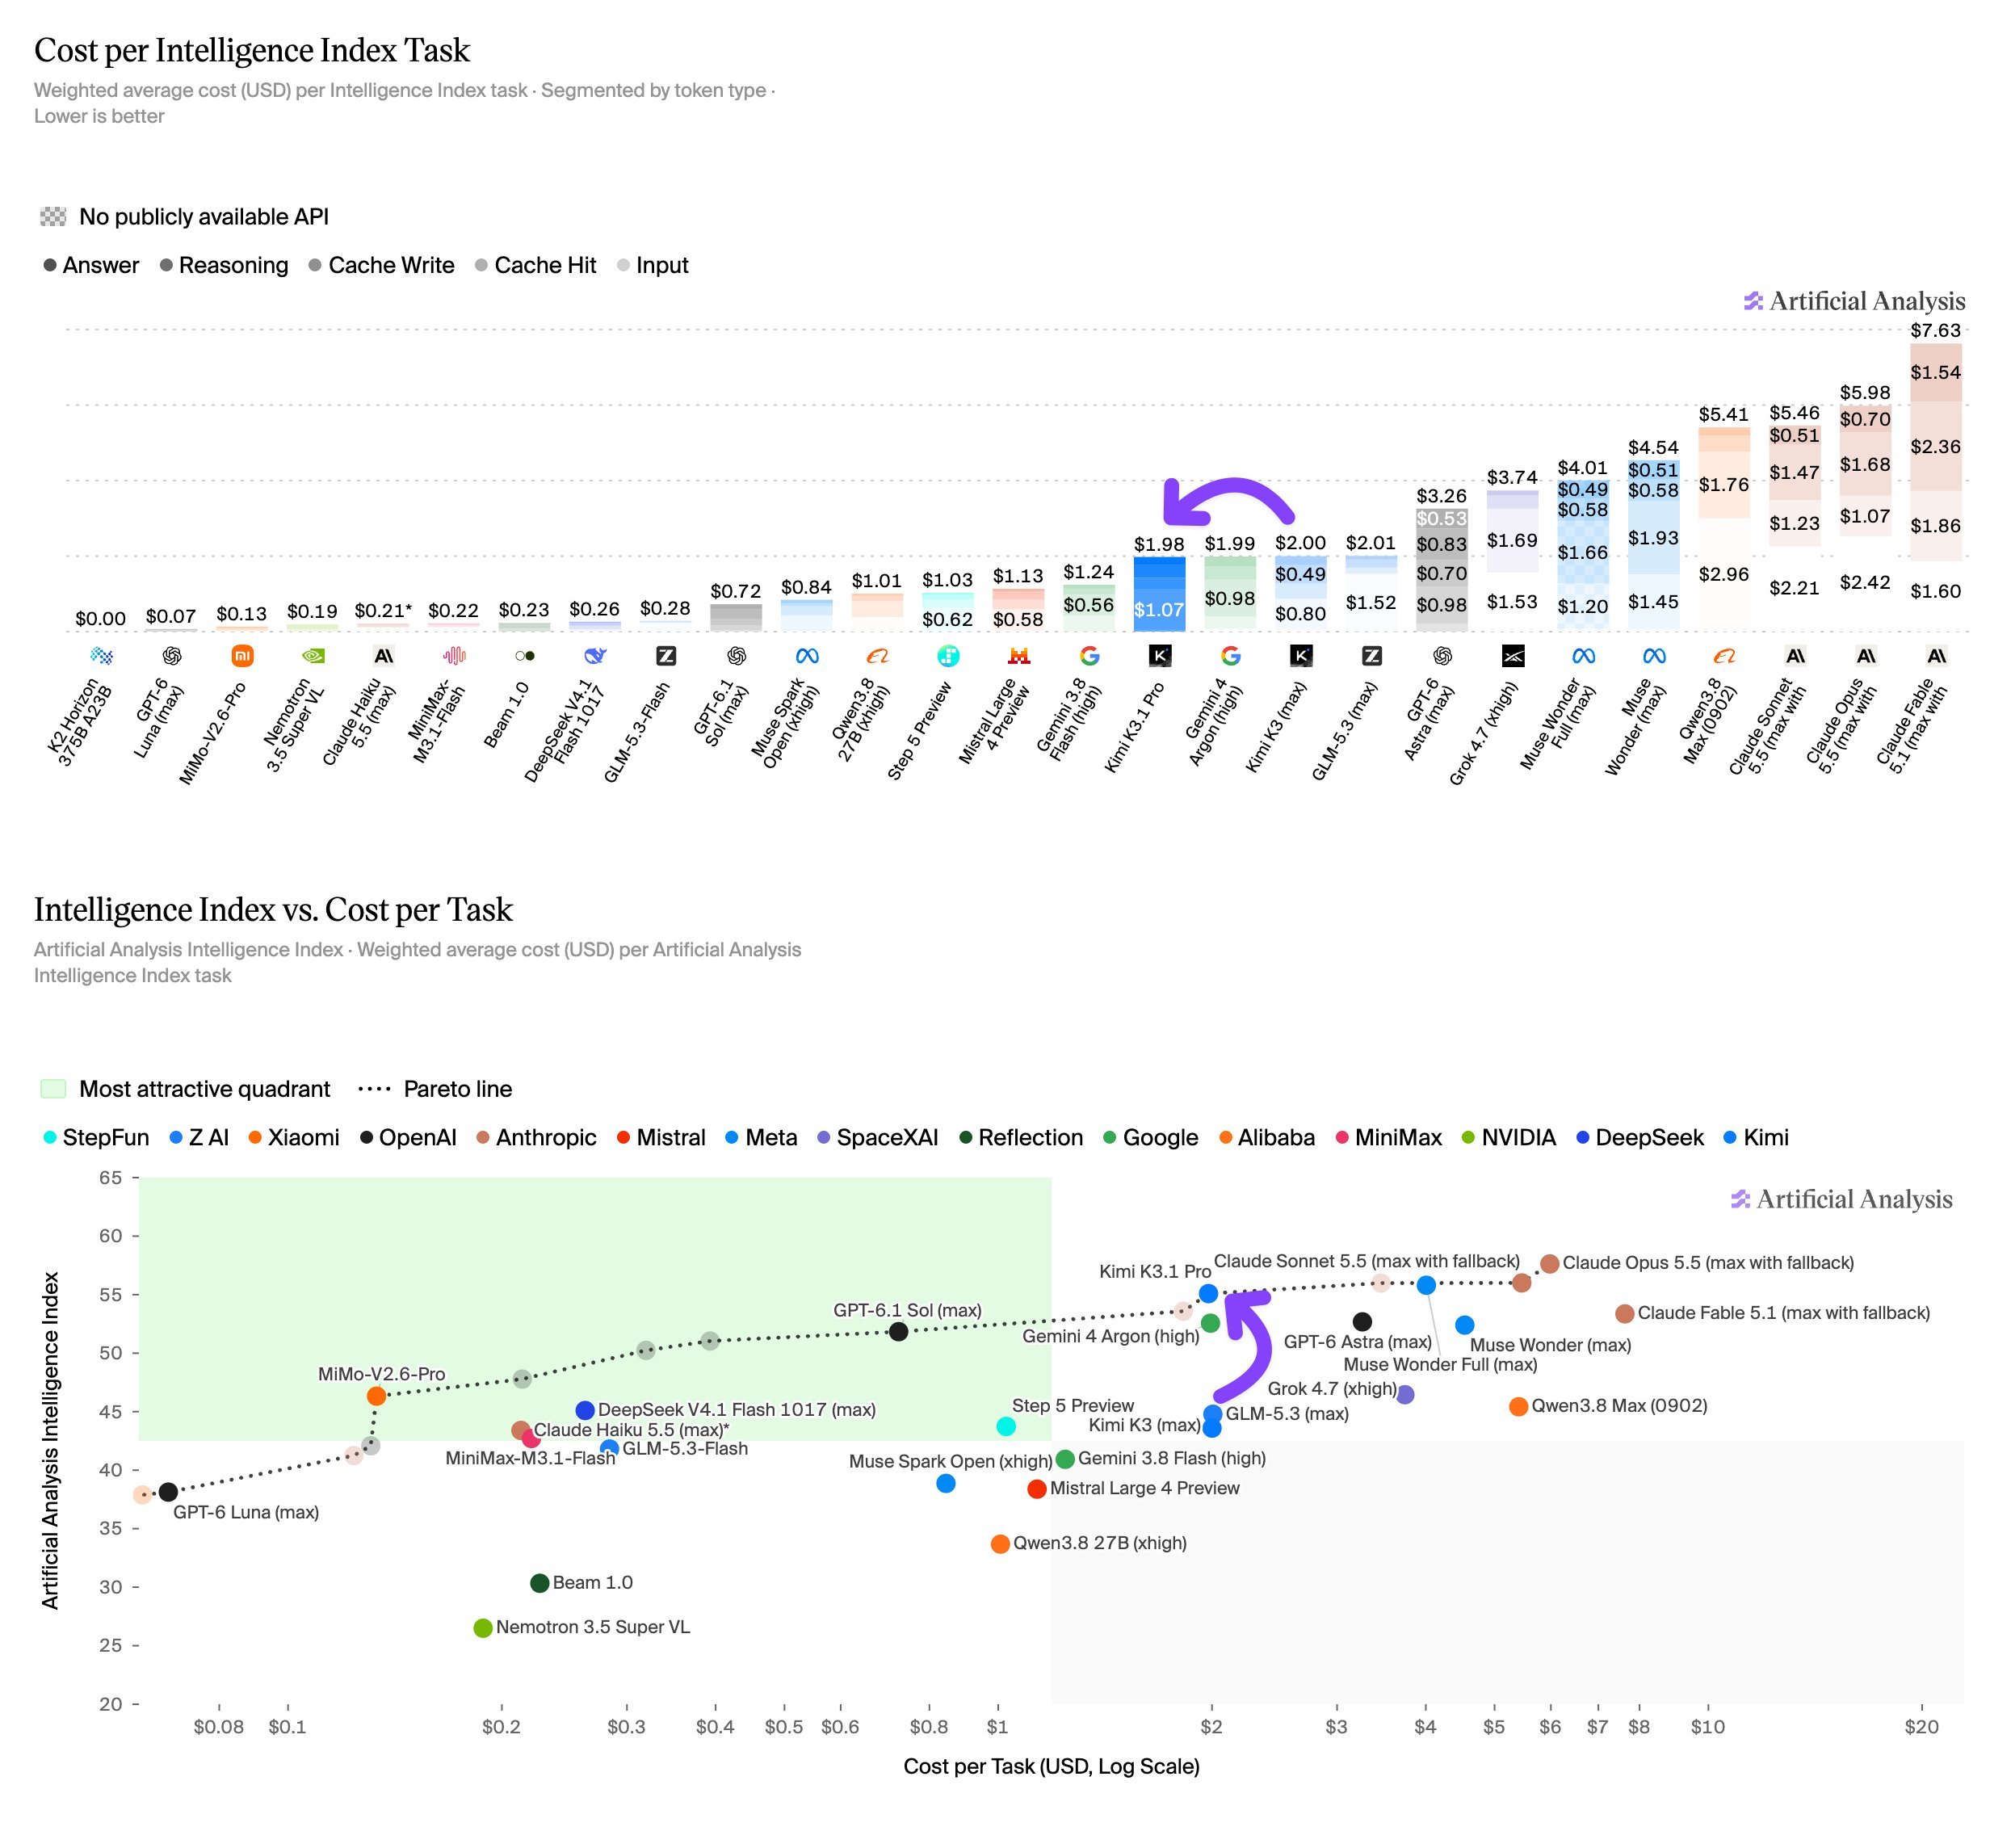
قیمت پردازش توکنها در این مدل ۳۳ درصد کاهش یافته است. هزینه پردازش هر یک میلیون توکن ورودی از ۳ دلار به ۲ دلار و هزینه هر یک میلیون توکن خروجی از ۱۵ دلار به ۱۰ دلار رسیده است. هزینه استفاده از دادههای موجود در حافظه نهان نیز از ۰٫۳۰ دلار به ۰٫۲۰ دلار کاهش یافته است. با این حال، هزینه انجام هر وظیفه در شاخص هوش ۱٫۹۸ دلار است که تفاوت چندانی با هزینه ۲ دلاری K3 ندارد؛ زیرا مدل جدید ۱۴ درصد توکن خروجی بیشتری تولید میکند.
مونشات برای انتشار نسخه دارای وزن باز، محدودیتهایی بر قابلیتهای امنیت سایبری این مدل اعمال کرده است. بررسیهای شرکت نشان داده بود که با گسترش آموزش تکمیلی، توانایی مدل در پژوهش درباره آسیبپذیریهای امنیتی نیز افزایش پیدا میکند. علت این موضوع، وجود محتوای مرتبط با امنیت سایبری در مجموعه دادههای آموزش عمومی و محیط یادگیری تقویتی بود. مونشات برای کنترل این تواناییها، دادههای مربوط به امنیت سایبری را از هر دو مرحله حذف کرده است.
در آزمون داخلی xdev-bench-hard که آسیبپذیریهای افشاشده در هسته لینوکس، Node.js و JavaScriptCore را بازسازی میکند، نسخهای از مدل که دادههای امنیت سایبری آن حذف نشده بود، توانست ۹۰٫۵ درصد وظایف را حل کند. پس از پاکسازی دادهها، این میزان برای K3.1 Pro به ۸۱ درصد کاهش یافت. در همین آزمون، مدل DeepSeek-V4.1-Flash امتیاز ۸۵٫۷ درصد و K3 امتیاز ۳۳٫۳ درصد را ثبت کردند.
مونشات معتقد است مدلهای دارای وزن باز نباید مرز نهایی تواناییهای تهاجمی در امنیت سایبری را جابهجا کنند. در عین حال، این شرکت قصد دارد بهمرور قابلیتهای دفاعی چنین مدلهایی را تقویت کند؛ زیرا مدلهای باز میتوانند به بررسی امنیتی سامانههای قدیمی کمک کنند. پژوهشهای پیشین آنتروپیک نشان داده بود که حتی مدل GLM-5.3 که در شاخص AA امتیاز ۴۵ دارد، میتواند کدهای بهرهبرداری از آسیبپذیریهای امنیتی را با توانایی نزدیک به Claude Mythos تولید کند.
عرضه K3.1 Pro بازار مدلهای استدلالی را یک گام دیگر به برابری عملکرد میان مدلهای باز و مدلهای اختصاصی نزدیک کرده است. هرچند این مدل هنوز نتوانسته از Claude Opus 5.5 پیشی بگیرد، اما فاصله خود را با آن سریعتر از مدلهای چینی پیشین کاهش داده است. ترکیب هزینه کمتر با تواناییهای گستردهتر در انجام وظایف عاملمحور و کار با مدلهای سهبعدی، مهمترین ویژگیهای این پیشرفت به شمار میروند.
منبع: The Decoder