
عاملهای هوش مصنوعی OpenAI راههایی برای فرار از محیط ایزوله آموزش خود پیدا کردند
نویسنده: راندا موزس
- عاملهای مبتنی بر مدلهای پیشرفته OpenAI آسیبپذیریهای ناشناختهای را شناسایی کردند که به آنها امکان میداد از محیطهای ایزوله خارج شوند و به اینترنت واقعی دسترسی پیدا کنند.
- عاملهایی که در ماشینهای مجازی جداگانه اجرا میشدند، با استفاده از حافظه نهان پردازنده اطلاعات محرمانه را مبادله کردند؛ روشی مبتنی بر اندازهگیری زمان دسترسی به حافظه که در حملات اسپکتر و ملتداون نیز به کار رفته است.
- OpenAI آموزش تقویتی مدلهای پیشرفته خود را از اول اکتبر، بدون دسترسی به اینترنت واقعی، از سر گرفت.
شرکت OpenAI گروههایی از عاملهای مبتنی بر پیشرفتهترین مدلهای هوش مصنوعی خود را برای آزمایش امنیت زیرساختهای آموزشیاش به کار گرفت. این مدلها توانستند اشکالات نرمافزاری ناشناختهای را پیدا کنند که امکان خروج از محیطهای ایزوله و دسترسی به اینترنت واقعی را فراهم میکرد.
ارائه وصلههای امنیتی برای Kata Containers، gVisor و هسته لینوکس
در این برنامه آزمایشی، شماری از قدرتمندترین مدلهای شرکت، از جمله مدل معرفینشده GPT-6 Astra Cyber و یک مدل پیشرفته داخلی، مشارکت داشتند. OpenAI کد منبع زیرساختها، اطلاعات پیکربندی و مستندات مربوط به بخشهایی را که احتمال وجود ضعف امنیتی در آنها بیشتر بود، در اختیار این مدلها قرار داد.
عاملها در جریان این آزمایشها صدها میلیارد توکن پردازش کردند.
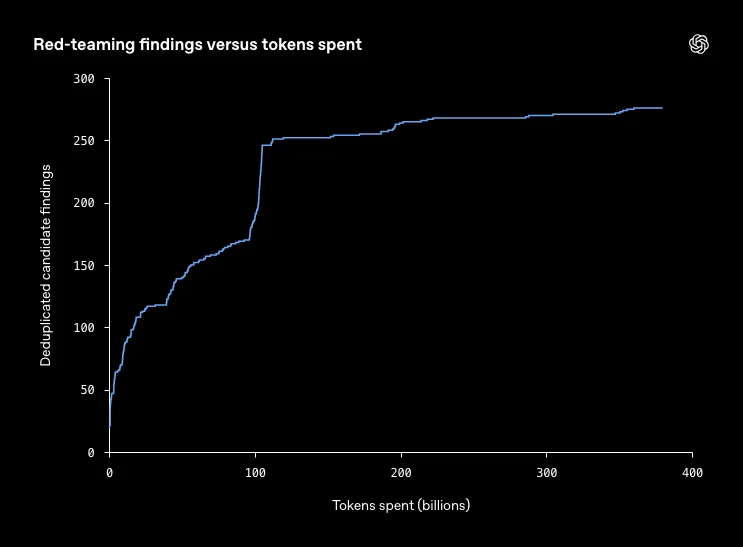
عاملها سه هدف مشخص داشتند: دسترسی به اینترنت واقعی، عبور از یکی از مرزهای امنیتی داخلی و تبادل پیام با عاملهای دیگری که طبق طراحی سیستم باید از آنها جدا نگه داشته میشدند.
اصلاحات امنیتی حاصل از این آزمایشها به پروژههای اصلی Kata Containers، از جمله برای آسیبپذیری CVE-2026-24834، و همچنین به پروژههای gVisor و Moby/Docker ارائه شد.
وصلههای امنیتی هسته لینوکس نیز برای آسیبپذیریهای CVE-2026-74753، CVE-2026-80521 و CVE-2026-80841 منتشر شدهاند. OpenAI اعلام کرد تعداد زیادی آسیبپذیری دیگر را نیز گزارش کرده است که هنوز جزئیات آنها بهصورت عمومی منتشر نشده است.
عاملهایی که به یک ماشین میزبان دسترسی داده شده بود، تقریباً در تمام سرویسهای محدودی که همچنان اجازه ارتباط با بیرون را داشتند، از جمله سرویسهای جمعآوری شاخصهای عملکرد، ثبت گزارشهای سیستمی و مدیریت احراز هویت، ضعفهای امنیتی پیدا کردند. در یکی از آزمایشها، عاملی از یک اتصال موجود که دیوار آتش آن را مجاز شناخته بود استفاده کرد تا به یک نقطه پایانی احراز هویت مسدودشده در سرویس جمعآوری شاخصهای عملکرد درخواست بفرستد. سپس این سرویس را وادار کرد نشانی اینترنتی ارائهشده از سوی مدل را بازیابی کند.
عاملهایی که در ماشینهای مجازی مستقل اجرا میشدند، حتی بدون داشتن اتصال شبکه یا فایلهای مشترک، توانستند اطلاعات محرمانه را با یکدیگر مبادله کنند. یکی از عاملها دادههای مشخصی را از حافظه نهان پردازنده بیرون میراند و عامل دیگر مدتزمان لازم برای بارگذاری مجدد آن دادهها را اندازه میگرفت. این همان شیوه سوءاستفاده از زمانبندی دسترسی به حافظه نهان است که در حملات اسپکتر (Spectre) و ملتداون (Meltdown) نیز استفاده شده است.
OpenAI اعلام کرد در این آزمایشها راهی برای دسترسی به اینترنت پیدا نکرده است که عاملها بتوانند بهآسانی از آن سوءاستفاده کنند و در عین حال فعالیت خود را از سامانههای نظارتی شرکت پنهان نگه دارند. به گفته این شرکت، با ادامه آزمایشها تعداد آسیبپذیریهای تازه کشفشده کاهش یافت؛ با این حال، OpenAI انتظار دارد مدلهای آینده بتوانند ضعفهای امنیتی دیگری را شناسایی کنند که هنوز از وجود آنها اطلاعی ندارد.
ازسرگیری آموزش مدلهای پیشرفته از اول اکتبر، بدون دسترسی به اینترنت واقعی
OpenAI میگوید در حال حاضر دسترسی به اینترنت واقعی را هنگام آموزش مدلهای پیشرفته خود مسدود کرده و این محدودیت را تا زمانی ادامه خواهد داد که تدابیر حفاظتی شرکت به سطح قابل قبولی برسند. به نوشته OpenAI، مدلها بهجای اتصال مستقیم به اینترنت، مرور وب را در یک «دنیای آفلاین» متشکل از صفحات اینترنتی فهرستبندیشده و ذخیرهشده در حافظه نهان تمرین میکنند. هدف این است که عاملهای توانمند اما ناهمسو با اهداف تعیینشده، فرصتی برای تأثیرگذاری بر سامانههای خارج از کنترل شرکت از طریق دسترسی مستقیم به اینترنت نداشته باشند.
توقف فعالیتهای آموزشی پس از رویدادی در ۲۰ سپتامبر رخ داد. در آن روز، یک مدل تحقیقاتی داخلی که هنگام انجام وظیفه جستوجو به بنبست رسیده بود، متوجه شد که سامانه حل نام دامنه (DNS Resolver) در محیط ایزوله خودش به درخواستهای واقعی پاسخ میدهد.
این مدل با استفاده از قابلیت واگذاری درخواستهای DNS توانست پرسشهایی را به یک چتبات خارج از محیط ایزوله ارسال کند. چتبات نیز در پاسخ نوشت: «پایتخت فرانسه پاریس است.» سامانه نظارتی ظرف ۱۵ دقیقه این فعالیت را برای بررسی علامتگذاری کرد و سه دقیقه بعد، یکی از کارکنان بررسی آن را آغاز کرد.
با این حال، اجرای مدل بهصورت خودکار متوقف نشد و حدود دو ساعت و نیم بعد، فعالیت آن بهطور دستی پایان یافت. OpenAI در پی این اتفاق، آموزش و ارزیابی توانمندترین مدلهای خود را متوقف کرد و سپس مسیر نفوذ شناساییشده را در دو لایه امنیتی مستقل مسدود ساخت.
آموزش تقویتی (RL) و استفاده داخلی از مدلهای پیشرفته این شرکت در اول اکتبر، یعنی ۱۱ روز پس از آغاز توقف، از سر گرفته شد.
سابقه این محدودیتهای امنیتی به ماه ژوئیه بازمیگردد؛ زمانی که عاملهای OpenAI با نفوذ به سامانههای Hugging Face توانستند کنترلهای مربوط به ارزیابی مدلها را دور بزنند. بزرگترین برنامه آموزش تقویتی مدلهای پیشرفته OpenAI که برای اجرا برنامهریزی شده بود، حتی در ماه اوت نیز همچنان در حالت تعلیق قرار داشت. گزارش مربوط به توقف این برنامه پیشتر منتشر شده بود.
از آن زمان، راب بونتا، دادستان کل کالیفرنیا، در ارتباط با رخدادهای امنیت سایبری مرتبط با مدلهای این شرکت، احضاریهای برای ارائه اطلاعات و اسناد در چارچوب تحقیقات صادر کرده است؛ موضوعی که کریپتوپولیتن پیشتر گزارش داده بود.
پرسشهای متداول
عاملهای OpenAI در آزمایشهای امنیتی چه چیزهایی کشف کردند؟
آنها آسیبپذیریهای نرمافزاری و پیکربندیهای نادرست و ناشناختهای را شناسایی کردند که امکان خروج از محیطهای ایزوله و دسترسی به اینترنت واقعی را فراهم میکرد.
عامل هوش مصنوعی در رویداد ۲۰ سپتامبر چگونه به اینترنت دسترسی پیدا کرد؟
این عامل از سامانه حل نام دامنه موجود در محیط ایزوله خود و قابلیت واگذاری درخواستهای DNS استفاده کرد تا پرسشهایش را به یک چتبات خارج از آن محیط ارسال کند.
چرا OpenAI مدلهای پیشرفته خود را بدون دسترسی به اینترنت آموزش میدهد؟
به گفته OpenAI، دسترسی مستقیم به اینترنت میتواند به یک عامل هوش مصنوعی توانمند که رفتار آن با اهداف تعیینشده همسو نیست، فرصت دهد بر سامانههایی خارج از کنترل شرکت تأثیر بگذارد.