
عاملهای هوش مصنوعی در آزمون هماهنگی بازی Overcooked ناکام ماندند؛ بهترین مدل تنها ۲۶ درصد سفارشها را تکمیل کرد
پژوهشگران بازی آشپزی گروهی Overcooked را به معیاری آزمایشی به نام DuoCook تبدیل کردهاند تا توانایی مدلهای هوش مصنوعی بیناییـزبانی را در هماهنگی و انجام وظایف مشترک ارزیابی کنند. حتی بهترین مدل این آزمایش، GPT-6-Astra، بهطور میانگین فقط ۲۶٫۲ درصد سفارشها را تکمیل کرد و امتیاز مدلهای دیگر، از جمله Claude، GPT و Gemini، بین ۸٫۸ تا ۱۱٫۲ درصد بود. این پژوهش شکاف موجود در توانایی هماهنگی عاملهای خودمختار را برجسته میکند؛ مشکلی که میتواند در کاربردهای دنیای واقعی نیز تأثیرگذار باشد.
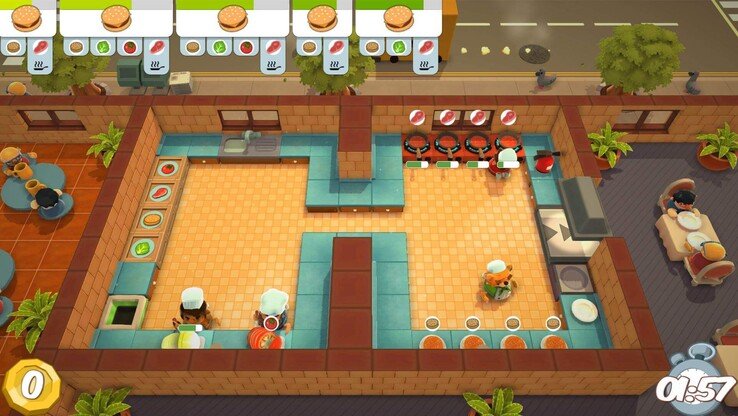
پژوهشگران بازی همکاریمحور Overcooked را به DuoCook تبدیل کردند؛ معیاری برای سنجش عملکرد هوش مصنوعی بیناییـزبانی. در این بازی، بازیکنان باید غذا آماده کنند و سفارشها را تحویل دهند. آنها همزمان با آمادهسازی مواد اولیه و نظافت آشپزخانه سروکار دارند و باید پیش از آنکه مشتریان بیحوصله شوند، سفارشها را آماده کنند. موفقیت در بازی به همکاری دقیق و تقسیم سریع کارها وابسته است. در نتیجه، بازیکنان باید در محیطی شلوغ و پرشتاب، هماهنگ با یکدیگر عمل کنند.
در چارچوب DuoCook، یک مدل هوش مصنوعی کنترل هر دو آشپز را بر عهده میگیرد. مدل تصاویر دریافتی از محیط و نقشه آشپزخانه را بررسی میکند و سپس بر اساس حرکتهای مجاز و اطلاعات مربوط به وضعیت بازی، اقدام میکند.
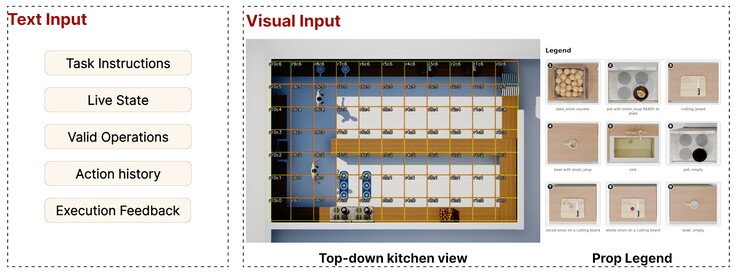
مدل باید بر اساس این اطلاعات، توالی اقدامات را برنامهریزی کند و هر دو شخصیت را بدون راهنمایی انسان به حرکت درآورد. از آنجا که کنترل هر دو نقش بر عهده یک مدل است، این مدل باید اقدامات خود را میان دو شخصیت که در فضایی مشترک فعالیت میکنند، هماهنگ کند.
نتایج پژوهش نشان داد میان توانایی مدلهای هوش مصنوعی و پیچیدگی شرایط آشپزخانه فاصله چشمگیری وجود دارد. GPT-6-Astra که بهترین عملکرد را داشت، بهطور میانگین ۲۶٫۲ درصد سفارشها را تکمیل کرد. در مقابل، مدلهای Claude، GPT و Gemini تنها به نرخ تکمیل ۸٫۸ تا ۱۱٫۲ درصد دست یافتند.
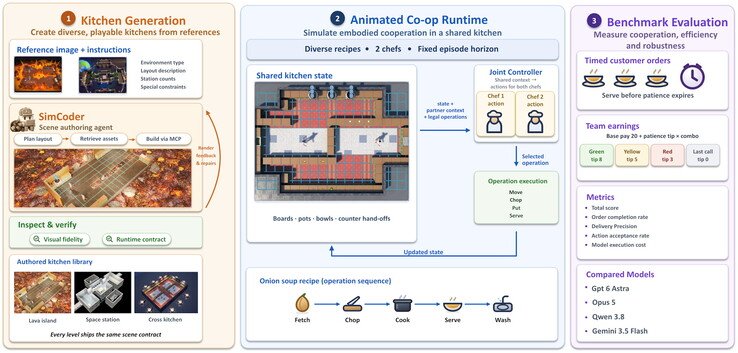
عملکرد مدلها در نقشههایی که موانع متحرک و تجهیزات مشترک داشتند، ضعیفتر بود. آنها بهویژه در آشپزخانههایی که آشپزها باید مواد اولیه را میان بخشهای مختلف جابهجا میکردند، بارها شکست خوردند. حتی استفاده از ابزارهای کمکی ساختاریافته نیز نتوانست مشکل تقسیم وظایف و پیگیری اهداف در شرایط متغیر را بهطور مؤثر برطرف کند.
پژوهشگران یک دفترچه یادداشت مشترک نیز در اختیار عاملها قرار دادند تا بتوانند مشاهدات خود را در آن ثبت کنند. این ابزار حافظه باعث بهبود میانگین امتیاز Claude شد، اما عملکرد GPT و Gemini را کاهش داد. در طول آزمایش، هزینه استفاده از رابط برنامهنویسی کاربردی (API) برای هر چهار مدل افزایش یافت.
عاملهای خودمختار در حوزههایی مانند لجستیک و تولید نیز با مشکلات هماهنگی مشابهی روبهرو هستند. این سامانهها باید وظایف را میان بخشهای مختلف تقسیم کنند، منابع را مدیریت کنند، روند پیشرفت کار را زیر نظر بگیرند و با تغییر شرایط سازگار شوند. نتایج پژوهش نشان میدهد مدلهای بیناییـزبانی فعلی هنوز از توانایی برنامهریزی عمیق و هماهنگی چندعاملی لازم برای انجام کارهای پیچیده و زمانحساس برخوردار نیستند.
بااینحال، باید نتایج این پژوهش را با احتیاط تفسیر کرد. مقاله هنوز در مرحله پیشچاپ است و فرایند معمول داوری علمی را پشت سر نگذاشته است. علاقهمندان میتوانند متن کامل مطالعه را در آرکایو (arXiv) بررسی کنند.
منبع: Notebookcheck