
اوپنایآی سه مقاله ریاضی هوش مصنوعی را بهدلیل یک خطای علامتگذاری پس گرفت
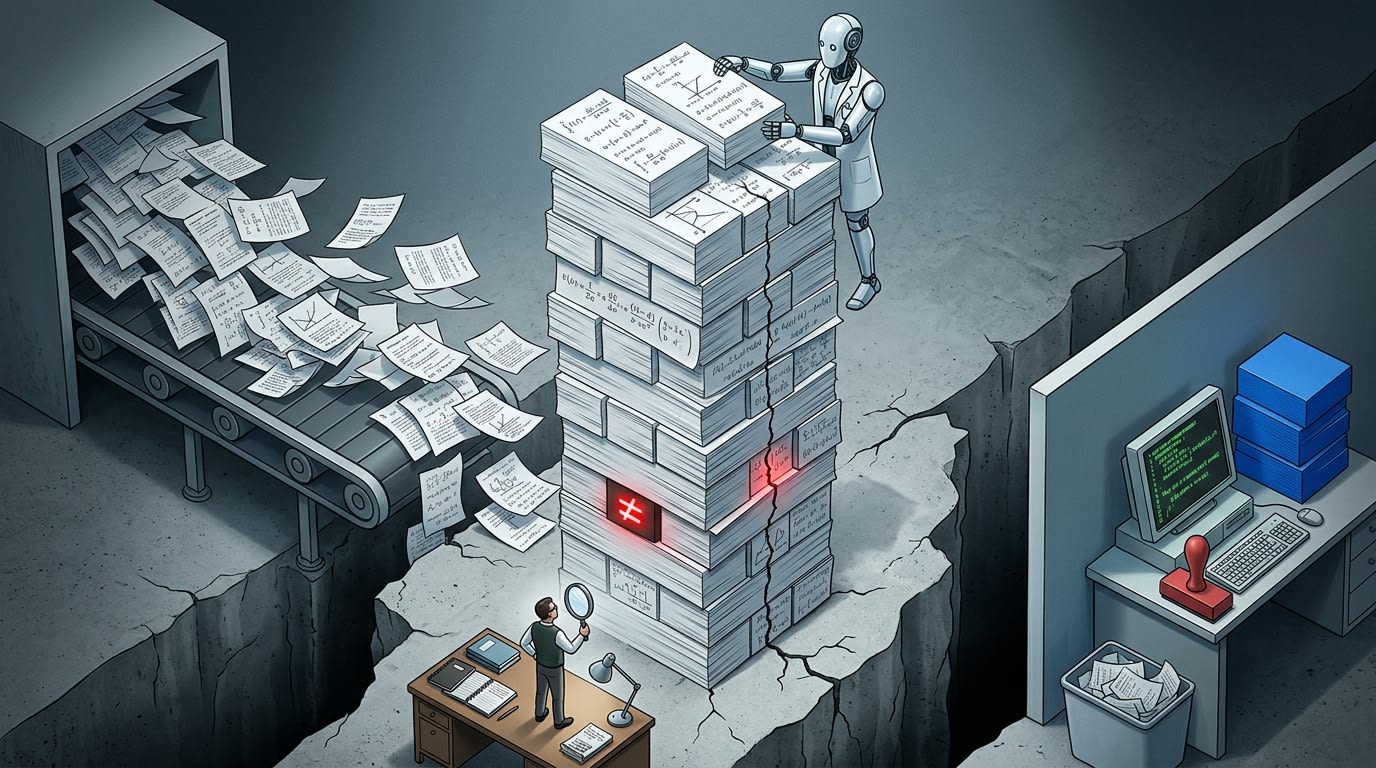
اوپنایآی ۷۲۲ دستنوشته ریاضی تولیدشده با هوش مصنوعی منتشر کرد؛ سپس سه مورد از آنها را پس گرفت. دلیل این کار یک اشتباه در یک علامت بود؛ اشتباهی که باعث شد کل اثباتها از اعتبار بیفتند.
این جزئیات در نگاه اول خندهدار به نظر میرسد، اما مسئله جدی است. هوش مصنوعی اکنون میتواند مقالهها را سریعتر از توان انسانها برای بررسی آنها تولید کند. شکاف میان تولید و ارزیابی، اصل ماجراست.
آنچه ریاضیات از آن هراس دارد، قراردادهاست
افراد خارج از حوزه ریاضیات معمولاً آن را کاملاً دقیق میدانند: یک فرمول یا درست است یا غلط. اما مقالههای ریاضی به این سادگی کار نمیکنند.
پیش از رسیدن به یک قضیه، مجموعهای از قراردادها وجود دارد. یک نماد واحد ممکن است در شاخههای مختلف، کتابهای درسی متفاوت یا میان نویسندگان مختلف معناهای کاملاً متفاوتی داشته باشد. یک علامت کوچک میتواند نشاندهنده جهتگیری، درجه همولوژی، ساختار مختلط، قراردادهای مربوط به بستههای اصلی، انتخابهای مربوط به قضیه شاخص یا ضرایب تبدیل فوریه باشد. حتی مفهوم «مثبت» نیز ممکن است بر اساس زمینه، پیشفرضهای متفاوتی داشته باشد.
مقالههای علمی برای همتایان نوشته میشوند. همتایان معمولاً زبان مشترک آن حوزه را میشناسند. اما خوانندهای از رشتهای دیگر یا یک هوش مصنوعی که میان حوزهها جستوجو میکند، ممکن است در همین نقطه گرفتار شود؛ زیرا قرارداد هرگز بهطور صریح نوشته نشده است.
ریاضیات در قالب زبان طبیعی مانند کد اجرایی نیست. بیشتر شبیه شبهکدی است که به زمینه، پیشفرضها و توافقهای یک جامعه علمی وابسته است. اعتبار آن از داوری، بازتولید، اصلاح و بررسیهای رسمی به دست میآید، نه صرفاً از فایل PDF.
به همین دلیل، یک علامت اشتباه میتواند سه دستنوشته را نابود کند. نکته شگفتآور این است که انتظار داریم هوش مصنوعی همه قراردادهای نانوشته را بهتنهایی استنباط کند.
هوش مصنوعی شکافهای انسانی را به ارث میبرد
وقتی مردم میشنوند «هوش مصنوعی مقالهها را پس گرفت»، معمولاً هوش مصنوعی را مقصر میدانند. اما برداشت دقیقتر این است که هوش مصنوعی ادبیات علمی انسانی را بهعنوان واقعیت پذیرفت و بر پایه آن ساخت.
ریاضیات انسانی مانند یک سازه چندلایه است. بیشتر بخشهای پایه آن محکم هستند، اما برخی نقاط مشکل دارند. نمادها در طول زمان تغییر میکنند، تعریفها دگرگون میشوند، اثباتها گاهی مراحل خود را توضیح نمیدهند، زنجیرههای ارجاع دچار شکست میشوند، پیشچاپها بهعنوان نتایج قطعی در نظر گرفته میشوند و لمی که فقط در شرایط خاصی درست است، گاهی به ابزاری عمومی تبدیل میشود.
پژوهشگران انسانی یاد گرفتهاند تشخیص دهند کدام نتایج قابل اعتمادترند و کدامها نیاز به بررسی دوباره دارند. آنها میدانند چه زمانی باید به تعریف اصلی بازگردند. هوش مصنوعی چنین حس و تجربهای ندارد. این سامانهها متن را واقعیت، اعتبار را حقیقت و ارجاعها را اثبات تلقی میکنند.
این همان سوگیری نسبت به اقتدار و تمایل به تأیید است که از فرایند آموزش و پاداشدهی مدلها ناشی میشود. مدلها برای پاسخهای روان و شبیه به نظر متخصصان پاداش میگیرند؛ بنابراین ممکن است چارچوب یک مقاله را بپذیرند، به جای آنکه بپرسند:
این نماد در اینجا دقیقاً چه معنایی دارد؟
آیا این ارجاع واقعاً از این ادعا پشتیبانی میکند؟
آیا این اثبات فرضی پنهان دارد؟
آیا میتوان نمونه نقضی پیدا کرد؟
اگر هوش مصنوعی بدون بررسی نتایج انسانی را بپذیرد، روی پایهای نامطمئن ساختوساز خواهد کرد. هرچه این برج بلندتر شود، سقوط آن نیز دشوارتر خواهد بود.
انتشار دستهای بدون بررسی، یک آزمایش است
۷۲۲ دستنوشته. بدون داور انسانی. بررسی خودکار توسط هوش مصنوعی. سه مورد پس گرفته شد.
پس گرفتن این مقالهها نشان میدهد که بررسیها توانستهاند مشکلی را پیدا کنند. مسئله اصلی، انتشار دستهای اولیه بود. پیشچاپها مقالههای رسمی نیستند. دستنوشتههای بررسینشده دانش قابل اتکا محسوب نمیشوند. رویکرد «اول منتشر کن، اگر اشتباه بود بعداً پس بگیر» یک آزمایش است، نه فرایند معمول انتشار علمی.
انتشار علمی بر پایه راستیآزمایی میچرخد. انتشار بدون بررسی، هزینه اصلاح را به خوانندگان و پژوهشگران بعدی منتقل میکند.
عموم مردم معمولاً تفاوت میان دستنوشته، پیشچاپ، مقاله داوریشده و اثبات رسمیشده را دنبال نمیکنند. اگر تیترها بگویند «اوپنایآی ۷۲۲ مقاله ریاضی منتشر کرد»، بسیاری آنها را نتیجههای تثبیتشده تلقی میکنند. زمانی که اصلاحیه یا پسگرفتن مقاله منتشر میشود، بخشی از اعتماد عمومی قبلاً مصرف شده است.
امروز تولید یک مقاله تقریباً هزینهای ندارد، اما بررسی آن همچنان به زمان، تخصص و توجه نیاز دارد. این شکاف همچنان مشکلساز خواهد بود.
لین تنها راهحل نیست
پاسخ رایج این است: بگذارید هوش مصنوعی همه چیز را با لین بررسی کند. جهت کلی این ایده درست است. ابزارهایی مانند لین، کوک و ایزابل اثباتها را به اشیای قابل بررسی توسط ماشین تبدیل میکنند. آنها ابهام نمادها و شکافهای موجود در اثباتها را کاهش میدهند.
اما مشکل را بهطور کامل حل نمیکنند.
لین بررسی میکند که آیا کد با یک گزاره رسمی مطابقت دارد یا نه. این ابزار بررسی نمیکند که آیا گزاره رسمیشده دقیقاً همان معنایی را دارد که مقاله اصلی قصد بیان آن را داشته است. اگر هنگام رسمیسازی علامت اشتباه برگردانده شود، لین گزاره نادرست را تأیید خواهد کرد. اگر تعریف اشتباه ترجمه شود، لین یک شیء نادرست را اثبات میکند. اگر قراردادهای اصلی مبهم باشند، رسمیکننده ممکن است نسخهای مناسب انتخاب کند که از متن اصلی فاصله گرفته باشد.
رسمیسازی مشکل بررسی اثبات را حل میکند، اما مشکل ترجمه معنایی را حل نمیکند. هوش مصنوعی به گواهیهای رسمی نیاز دارد، اما همزمان به بررسی معنایی، تطبیق تعریفها، ممیزی وابستگیها و جستوجوی نمونههای نقض نیز نیازمند است.
رسمیسازی پایه کار است؛ اما هنوز کسی باید نقشه را بررسی کند.
هوش مصنوعی آشفتگیهای پنهان زیرساخت پژوهش را آشکار میکند
اینکه بگوییم «پژوهش انسانی یک فرایند سرهمبندیشده است» شاید تند به نظر برسد، اما در همه موارد نادرست نیست. بسیاری از حوزهها با سوءاستفاده از نمادها، تعریفهای ناسازگار، وابستگیهای تأییدنشده و مشکلات بازتولید روبهرو هستند. وقتی تعداد پژوهشگران محدود و اصلاحات کند باشد، این مشکلات زیر لایهای از ارجاعها و اعتبار علمی پنهان میمانند.
هوش مصنوعی میتواند ادبیات علمی را جستوجو کند، وابستگیها را بررسی کند، به دنبال نمونههای نقض بگردد و اثباتها را با سرعت بازتولید کند. در نتیجه، موارد ناخوشایند بیشتری آشکار خواهند شد:
یک لم که هزاران بار به آن ارجاع شده، فقط در شرایط خاصی درست است.
تعریفهای استاندارد یک حوزه در مقالههای مختلف با هم تضاد دارند.
یک قضیه مشهور به یادداشتهایی وابسته است که هرگز بهطور رسمی منتشر نشدهاند.
فرض اصلی یک مقاله مهم کنفرانسی با یک نمونه نقض روبهرو میشود.
این نوع یافتهها به مرور عادی خواهند شد. جملههایی مانند «کل یک حوزه فرو میریزد» یا «هزاران مقاله بیارزش میشوند» معمولاً بیش از حد اغراقآمیز هستند.
نمودارهای وابستگی دارای پیوندهای قوی و ضعیف هستند. برخی نتایج به یک لم کلیدی وابستهاند؛ اگر آن لم شکست بخورد، بخشی از ساختار فرو میریزد. بسیاری از نتایج دیگر را میتوان اصلاح، محدود، جایگزین یا بازتعریف کرد. چیزی که فرو میریزد، ساختارهای محلی ساختهشده بر پایه اعتبار تأییدنشده است.
ارزش هوش مصنوعی در آشکار کردن همین ساختارهای محلی است.
هوش مصنوعی آینده به اعتماد تنظیمشده نیاز دارد
یک جمله رایج چنین است: اگر چیزی مقاله انسانی است، قابل اعتماد نیست؛ پس آن را با لین بررسی کنید.
نیمی از این حرف درست است و نیمی از آن خطرناک.
هوش مصنوعی نباید بهطور پیشفرض مقالههای انسانی را حقیقت بداند. اما اگر به همه چیز بیاعتماد باشد، دیگر نمیتواند بر پایهای حرکت کند. این سیستمها به اعتماد تنظیمشده نیاز دارند: ابتدا شواهد قابل بررسی و سپس اعتماد بر اساس قدرت شواهد.
اثباتهای رسمی بالاترین سطح اعتماد را دارند. مقالههایی که بهطور مستقل بازتولید شدهاند، سطح پایینتری دارند. مقالههای داوریشده در میانه قرار میگیرند. پیشچاپها پایینتر هستند. مقالههای تکمنبعی با نمادهای آشفته و وابستگیهای تأییدنشده حتی پایینتر قرار میگیرند. ادعاهای «ظاهراً» در شبکههای اجتماعی در پایینترین سطح هستند.
هوش مصنوعی به اعتماد تنظیمشده نیاز دارد، نه اعتماد کورکورانه و نه بدبینی فراگیر.
همچنین به جسارت نیاز دارد. مدلهای قدیمیتر اغلب از مسائل دشوار دوری میکردند: مسئله حلنشده است، راهحل بیش از حد دشوار است یا استدلال من نمیتواند درست باشد. آموزش مدلها را به تلاش بیشتر سوق داد و این مفید است.
اما جسارت با زودباوری تفاوت دارد. هوش مصنوعی آینده به دو ویژگی همزمان نیاز دارد: کاوش بیباکانه و راستیآزمایی محتاطانه. باید به سراغ مسائل دشوار برود، بدون آنکه مقالههای انسانی را مانند متون مقدس بپذیرد.
فرایند پژوهش باید تغییر کند
با افزایش سرعت تولید مقاله توسط هوش مصنوعی، فرایند پژوهش نیز باید تغییر کند. در غیر این صورت چرخه انتشار، گسترش، پسگرفتن و عذرخواهی تکرار خواهد شد.
چند تغییر ضروری عبارتاند از:
خروجیهای ریاضی هوش مصنوعی باید بهطور پیشفرض «پیشنویس تأییدنشده» تلقی شوند. نباید دستنوشتهها بهعنوان مقاله یا پیشچاپها بهعنوان اجماع علمی معرفی شوند.
هرجا امکان دارد، اثباتها باید همراه با گواهیهای رسمی ارائه شوند. لین همه مشکلات را حل نمیکند، اما بسیاری از خطاهای نمادین و شکافهای اثباتی را پیدا خواهد کرد.
یک مرحله بررسی معنایی باید اضافه شود. پیش از رسمیسازی، باید بررسی شود که تعریفها، نمادها و قراردادها با منبع اصلی هماهنگ هستند. متخصصان انسانی و هوش مصنوعی باید این کار را در کنار هم انجام دهند.
دادههای آموزشی باید بر اساس میزان اعتبار برچسبگذاری شوند. نباید پیشچاپها، وبلاگها، پاسخهای انجمنها و مقالههای رسمی در یک مجموعه مخلوط شوند و سپس مدل مجبور شود خودش تشخیص دهد چه چیزی اعتبار دارد.
از چند عامل هوش مصنوعی برای بازتولید نتایج و یافتن نمونههای نقض استفاده شود. یک مدل که فقط با خودش گفتوگو میکند کافی نیست.
نقش داوران انسانی نیز باید ارتقا یابد. آنها باید نگاشت رسمیسازی، نمودارهای وابستگی و معنای کلی را بررسی کنند، نه فقط خطاهای تایپی در فرمولها را.
هیچکدام از این کارها ارزان نیست. اما سالمتر از رویکرد «۷۲۲ مقاله منتشر کن و ۳ مورد را پس بگیر» است.
دکمه انتشار از قبل فشرده شده است
یک علامت اشتباه باعث پس گرفتن سه مقاله شد. پیدا شدن آن نشان میدهد سیستم اصلاح هنوز کار میکند.
اما دکمه انتشار از قبل فشرده شده بود.
معیار آینده این نیست که هوش مصنوعی چند مقاله میتواند تولید کند؛ بلکه این است که چند مقاله را میتواند بررسی، رد، اصلاح و دوباره بسازد. سه پسگرفتن فقط یک نماد را تغییر داد، اما هزینه راستیآزمایی کاهش نیافته است. دکمه انتشار از قبل فشرده شده است.