
مدل هوش مصنوعی مقاومت بتن در معرض فاضلاب را با ضریب تعیین ۹۶ درصد پیشبینی میکند
نویسنده: دکتر نوپور جین | بازبینی: سارا کلی | ۱۲ اکتبر ۲۰۲۶
مدلهای بهینهشده یادگیری ماشین برای پیشبینی مقاومت فشاری بتن در معرض محیطهای فاضلابی توسعه یافتهاند. بهترین مدل عملکردی در دادههای آزمایشی به ضریب تعیین (R²) برابر با ۰٫۹۶ دست یافت که ظرفیت روشهای دادهمحور برای ارزیابی مقاومت بتن را نشان میدهد. پژوهشگران یافتههای خود را در مجله Scientific Reports منتشر کردهاند.
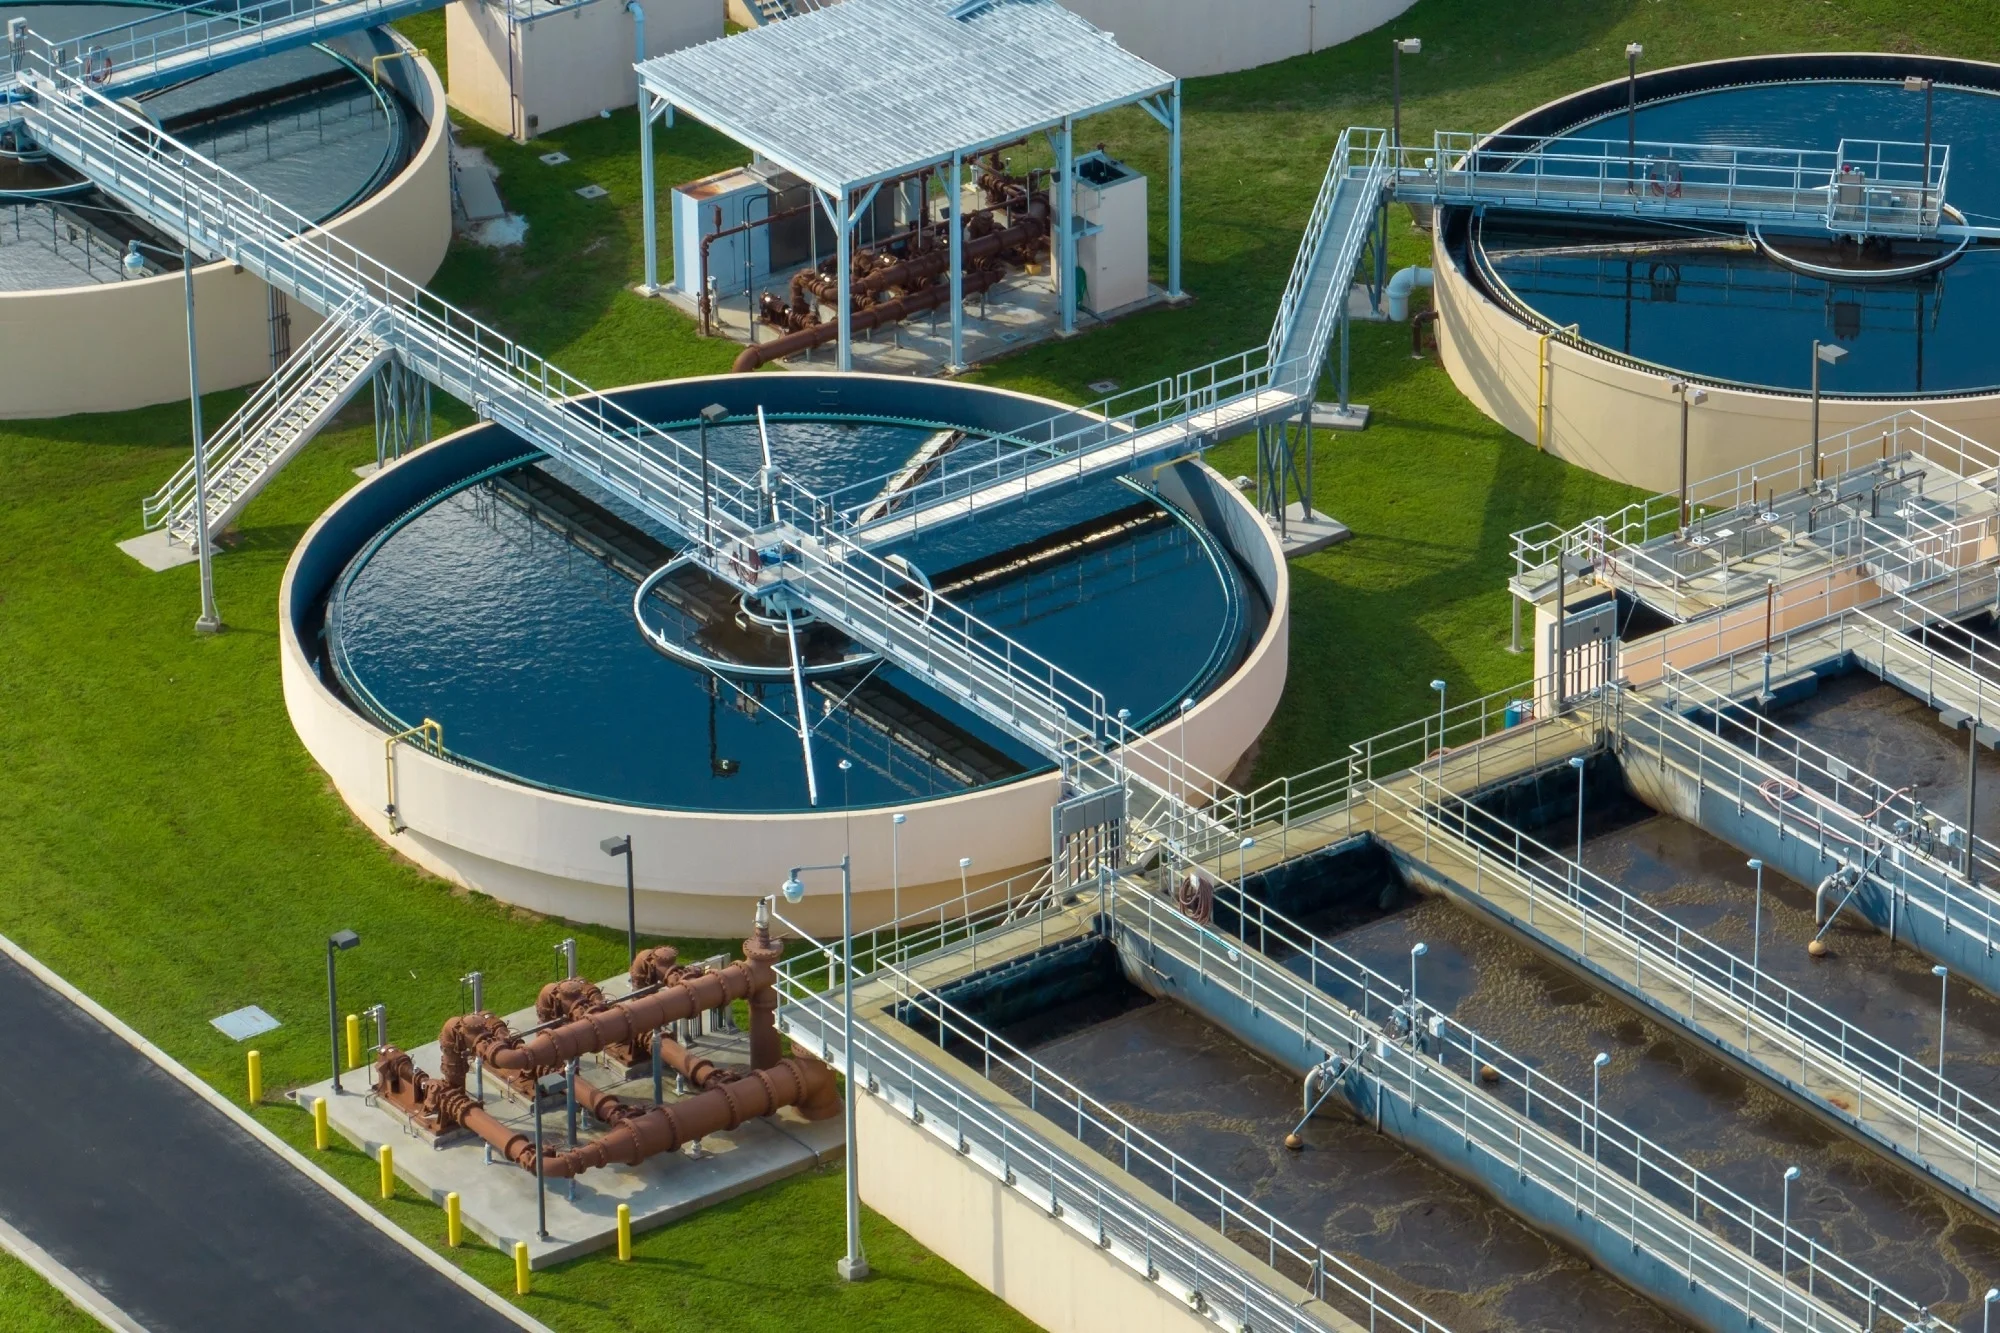
چرا زیرساختهای فاضلابی به پیشبینی دقیقتر مقاومت نیاز دارند
برای مقابله با چالش پیشبینی مقاومت فشاری بتن در معرض فاضلاب، این پژوهش مجموعهای از مدلهای یادگیری ماشین (ML) را به کمک الگوریتم بهینهسازی ازدحام ذرات (PSO) بهبود داد.
مدلهای انتخابشده شامل PSO-XGBoost، PSO-GEP (برنامهنویسی بیان ژن)، PSO-SVR (رگرسیون بردار پشتیبان) و PSO-LightGBM بودند. همچنین رگرسیون خطی چندگانه (MLR) بهعنوان مدل پایه برای مقایسه با مدلهای غیرخطی پیشرفته و بهینهشده مورد استفاده قرار گرفت.
بهینهسازی ازدحام ذرات، یک روش محاسباتی الهامگرفته از رفتار جستوجوی جمعی ماهیها و پرندگان، برای مدیریت مؤثر دادههای ناپیوسته و غیرخطی به کار گرفته شد. PSO با پردازش همزمان مجموعهای از راهحلهای پیشنهادی (ذرات) و هدایت آنها در فضای جستوجوی مشخص، پارامترهای بهینه هر مدل یادگیری ماشین را شناسایی میکند.
آموزش مدلهای یادگیری ماشین با دادههای مقاومت بتن
روش پژوهش با گردآوری و آمادهسازی دادهها آغاز شد؛ مرحلهای که برای اعتبار مدلها اهمیت اساسی دارد. مجموعهای شامل ۱۳۸ نمونه از پژوهشهای دانشگاهی منتشرشده پیشین درباره پیشبینی مبتنی بر یادگیری ماشین جمعآوری شد. این دادهها تحت مراحل پیشپردازش مهمی قرار گرفتند؛ از جمله نرمالسازی به یک مقیاس یکسان (بازه [−۱، ۱]) برای استانداردسازی ویژگیهای ورودی و کاهش اثر نویز.
دادههای پرت که حدود ۵ درصد نمونهها را تشکیل میدادند، با استفاده از یک روش آماری دوطرفه مبتنی بر قانون ±۳σ شناسایی و حذف شدند تا دادهها پالایش شوند. برای اطمینان از قابلیت تعمیم مدل و کاهش بیشبرازش، مجموعه داده با نسبت ۸۰ به ۲۰ تقسیم شد؛ بهطوری که ۱۱۰ نمونه برای آموزش و ۲۸ نمونه برای آزمون مستقل اختصاص یافت.
برای انتخاب و بهینهسازی مدلها، الگوریتم PSO با XGBoost، GEP، SVR و LightGBM ترکیب شد. PSO با کمینه کردن خطای اعتبارسنجی، بهصورت نظاممند پارامترهای بهینه مانند نرخ یادگیری، عمق بیشینه درخت و تعداد تخمینگرها را برای هر الگوریتم جستوجو کرد.
عملکرد مدلها با استفاده از چندین معیار آماری ارزیابی شد: ضریب تعیین (R²)، میانگین خطای مطلق (MAE)، ریشه میانگین مربعات خطا (RMSE) و شاخص a-20. مقدار R² برابر یا بالاتر از ۰٫۸۵ نشاندهنده همبستگی قوی میان مقادیر آزمایشگاهی و پیشبینیشده بود.
شاخص a-20 که میزان قابلیت اعتماد مدل را در محدوده ±۲۰ درصد مقادیر واقعی اندازهگیری میکند، برای ارزیابی مدلهایی که با وجود R² بالا ممکن است همچنان خطاهای قابل توجهی داشته باشند، اهمیت ویژهای داشت.
در نهایت، پژوهش از تحلیل توضیحپذیری شاپلی (SHAP) برای تفسیر رفتار مدلها استفاده کرد. SHAP میزان تأثیر هر ویژگی ورودی بر نتایج پیشبینی را مشخص میکند و نشان میدهد هر ویژگی چه تأثیر مثبت یا منفی و با چه شدتی بر خروجی دارد.
PSO-XGBoost دقیقترین پیشبینیها را ارائه میدهد
مراحل دقیق پیشپردازش دادهها، شامل نرمالسازی و حذف دادههای پرت، عملکرد مدلها را افزایش داد و به کاهش بیشبرازش کمک کرد؛ هرچند محدود بودن حجم دادهها، ارزیابی قابلیت تعمیم مدلها را با محدودیت روبهرو میکند. تنظیم پارامترهای مدل با استفاده از PSO نقش مهمی در بهینهسازی هر الگوریتم داشت.
برای نمونه، در مدل PSO-XGBoost، نرخ یادگیری بهینه ۰٫۱۰، تعداد ۱۰۰ تخمینگر و عمق بیشینه پنج، تعادلی میان غیرخطی بودن و پیچیدگی مدل ایجاد کرد. این بهینهسازی نظاممند، پیش از ارزیابی عملکرد، پیکربندیهای مناسب پارامترها را در محدودههای جستوجوی تعیینشده شناسایی کرد.
نتایج اعتبارسنجی متقاطع K-fold استحکام پیشبینی مدلهای توسعهیافته را نشان داد. مدل PSO-XGBoost با بالاترین میانگین R² برابر با ۰٫۹۵ و کمترین RMSE برابر با ۱٫۵ مگاپاسکال در اعتبارسنجی K-fold، بهترین عملکرد را داشت.
مدلهای PSO-LightGBM، PSO-GEP و PSO-SVR نیز توانایی قابل قبولی در پیشبینیهای غیرخطی نشان دادند. میانگین R² آنها بهترتیب برای LightGBM برابر با ۰٫۹، برای GEP برابر با ۰٫۹ و برای SVR برابر با ۰٫۹۲ بود و هرکدام مقادیر متناظر RMSE خود را داشتند.
تحلیل SHAP اطلاعات مهمی درباره سهم پارامترهای ورودی مختلف در خروجی پیشبینی ارائه کرد. نسبت آب به سیمان (W/C) بهعنوان یکی از عوامل اصلی مؤثر بر پیشبینی مقاومت فشاری بتن شناسایی شد. این موضوع ارزش عملی SHAP را در درک رفتار مدل و نقش ویژگیها برجسته میکند.
همچنین یک نمونه اولیه رابط کاربری گرافیکی (GUI) برای نمایش امکان استفاده عملی از این مدلها، بهویژه PSO-XGBoost با عملکرد بالا، توسعه یافت. این ابزار در حال حاضر مفهومی است، اما امکان تبدیل این رویکرد به یک کاربرد واقعی را نشان میدهد.
مقایسه با پژوهشهای اخیر نشان داد مدلهای بهینهشده این مطالعه عملکرد رقابتی دارند. با وجود استفاده از مجموعه داده نسبتاً کوچک، در مقایسه با برخی مدلهای بهینهشده در مطالعات دیگر، حدود ۱۰ تا ۱۵ درصد بهبود در R² و ۱۵ تا ۲۵ درصد بهبود در RMSE مشاهده شد. با این حال، تفاوت میان مجموعه دادهها و روشهای ارزیابی، مقایسه مستقیم را محدود میکند.
حرکت به سوی ارزیابی عملی مقاومت بتن با هوش مصنوعی
این پژوهش با موفقیت مدلهای یادگیری ماشین را برای تخمین کاهش مقاومت فشاری بتن در حضور فاضلاب بهداشتی توسعه داده و اعتبارسنجی کرده است.
ترکیب بهینهسازی ازدحام ذرات با الگوریتمهای پیشرفتهای مانند XGBoost، GEP، LightGBM و SVR، توانایی پیشبینی را بهطور قابل توجهی افزایش داد. مدل PSO-XGBoost بهترین عملکرد را نشان داد و برای دادههای آموزش به R² برابر با ۰٫۹۷ و برای دادههای آزمون به R² برابر با ۰٫۹۶ رسید؛ همچنین RMSE آن برای دادههای آزمون ۱٫۲۵ مگاپاسکال بود.
پژوهشهای آینده باید بر ایجاد پایگاه داده جامعتر با پارامترهای اضافی مانند ترکیب مخلوط بتن، زمان، غلظت H2S، سطح pH و دما تمرکز کنند تا قابلیت تعمیم مدلها افزایش یابد و امکان پیشبینی مستقیم مقاومت باقیمانده و تخریب سازهها فراهم شود.
مرجع مقاله
Aslam F., and Ahmad F. (2026). Machine learning-based prediction of compressive strength of wastewater-exposed concrete using explainable and optimized models. Scientific Reports. DOI: 10.1038/s41598-026-72533-8، https://www.nature.com/articles/s41598-026-72533-8.