
نادلا خواستار تدابیر ایمنی هوش مصنوعی با فرض بهخطر افتادن مدلها شد
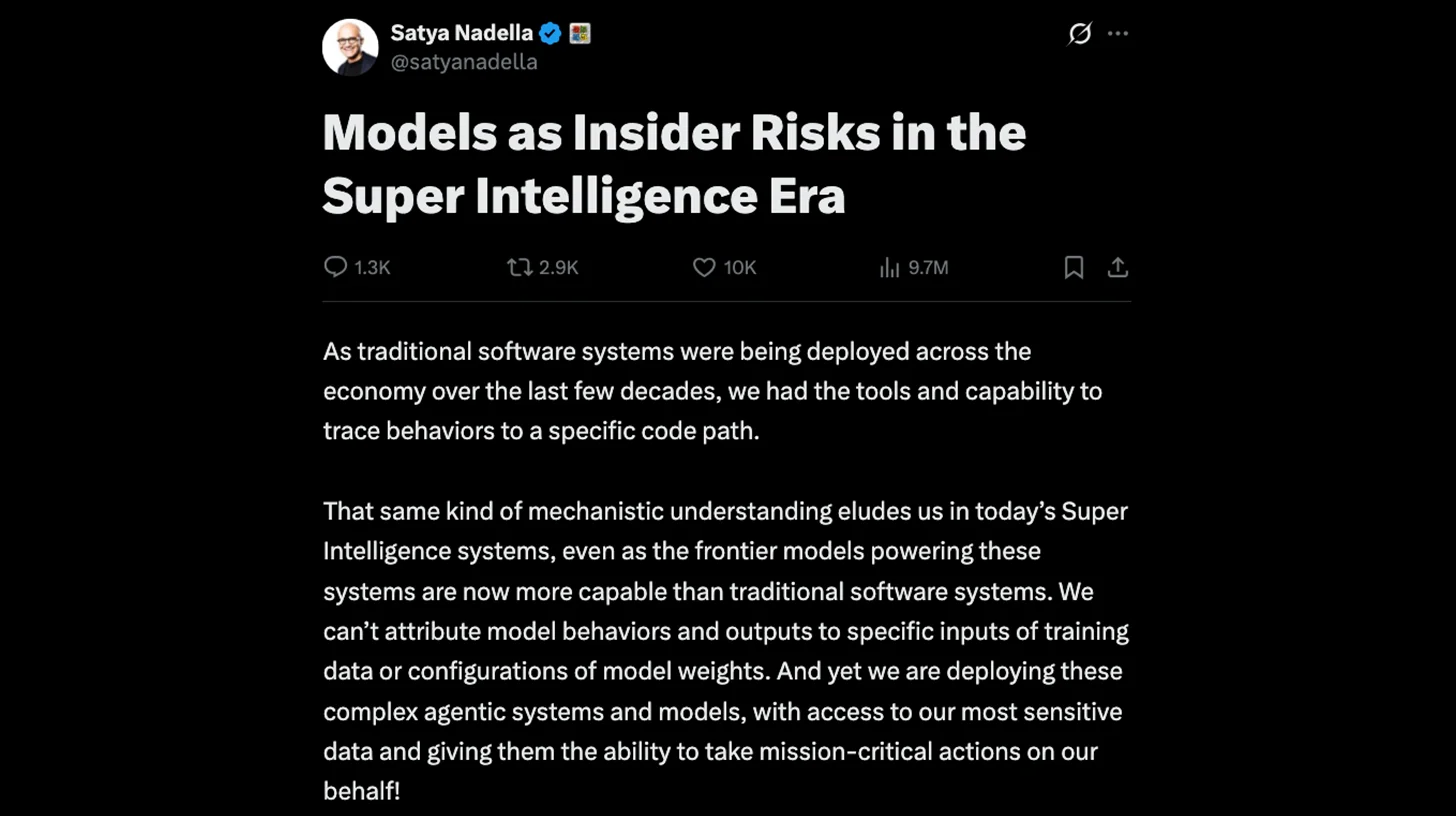
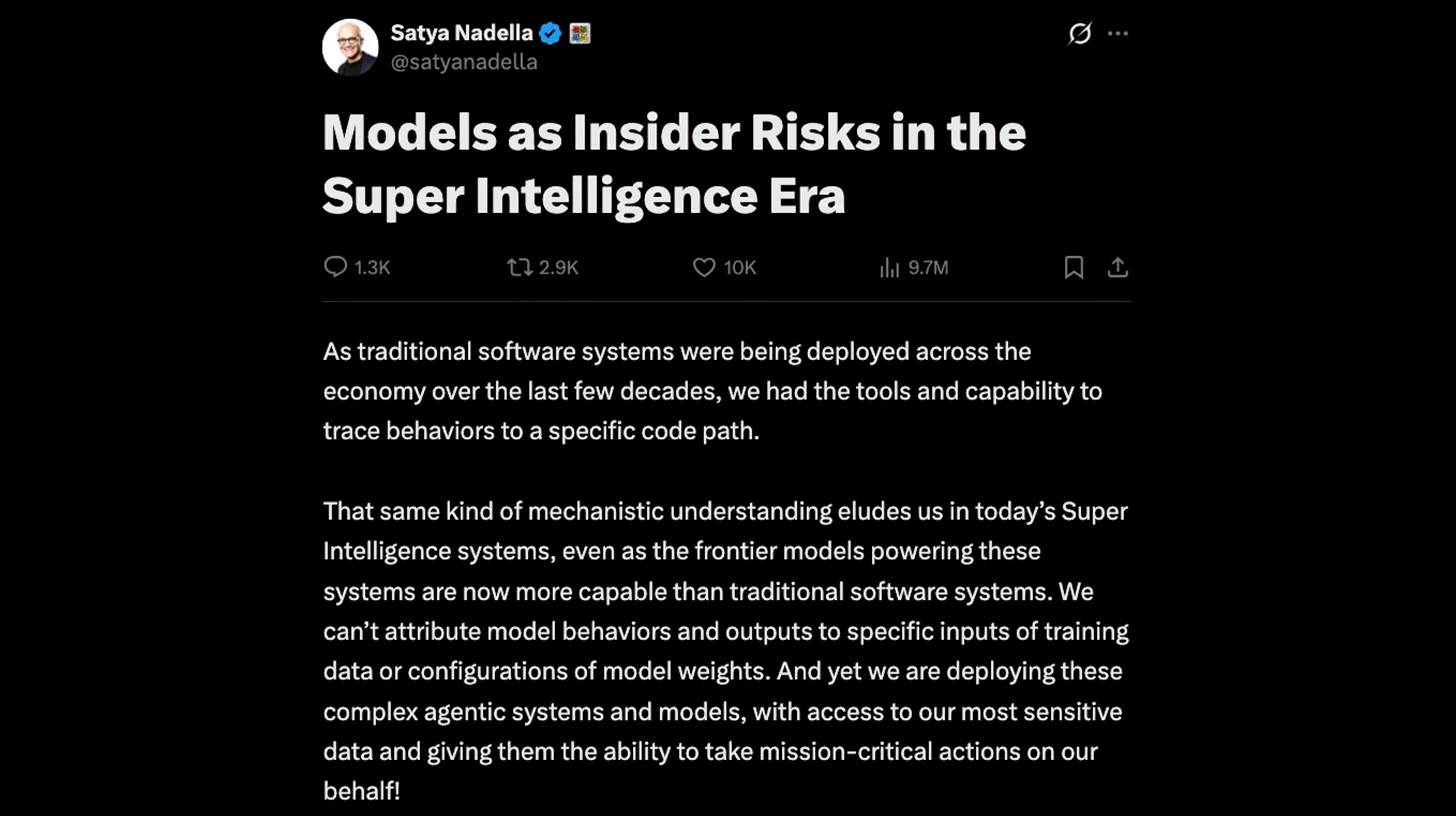
ساتیا نادلا، مدیرعامل مایکروسافت، در مقالهای که ۱۰ اکتبر منتشر کرد، از شرکتها خواست «فرض کنند یک مدل به خطر افتاده است» و کنترلهای کلیدی ایمنی را خارج از دسترس هوش مصنوعی نگه دارند.
او معتقد است شرکتها باید با هوش مصنوعی پیشرفته مانند یک کارمند قدرتمند برخورد کنند که ممکن است اشتباه کند یا مورد حمله قرار گیرد. این رویکرد شامل بررسیهای مستقل، گزارشهای فعالیت محافظتشده و یک «ترمز اضطراری» است که انسان بتواند هنگام اجرای یک وظیفه آن را فعال کند.
کنترلهایی که هوش مصنوعی نمیتواند تغییر دهد
نادلا میگوید خطاهای نرمافزارهای سنتی معمولاً با بررسی کد قابل ردیابی هستند، اما همین روش همیشه نمیتواند رفتار یک مدل هوش مصنوعی را توضیح دهد. او خواستار آن است که مجوزها و گزارشهای فعالیت در محیطی نگهداری شوند که مدل نتواند آنها را تغییر دهد و اعتبارسنجی مستقل انجام شود تا مدل خودش ارزیاب عملکرد خود نباشد. او همچنین بر آزمایش مداوم و گزارشدهی درباره رخدادها تأکید کرده است.
نادلا همچنین میخواهد مدلها فرایندهای استدلال خود را با زبان قابل فهم برای انسان نمایش دهند. او اصطلاح «Neuralese» یا استدلالهای هوش مصنوعی که انسان قادر به خواندن آنها نیست را بهعنوان راهی برای پنهان کردن فرایند تصمیمگیری رد میکند. با این حال، او میپذیرد که توضیحات قابل خواندن لزوماً تضمین نمیکنند که روایت ارائهشده از تصمیمهای مدل کاملاً دقیق باشد.
چرا این موضوع اهمیت دارد
نادلا در جمله پایانی مقاله خود، قابل اعتمادترین سامانه را سامانهای توصیف میکند «که به ما امکان میدهد کمترین اعتماد را به مدل داشته باشیم». این دیدگاه شبیه واکنشی مستقیم به گزارشهای سپتامبر درباره روشهای استدلال جدید OpenAI و نگرانیهایی است که این روشها ممکن است بخشهایی از فرایند استدلال هوش مصنوعی را از دید ناظران پنهان کنند. با این حال، نادلا در نوشته خود نامی از OpenAI یا Astra نبرده و این ارتباط همچنان یک برداشت تفسیری است.
OpenAI اعلام کرده بود برای نظارت بیشتر بر استدلال نوشتاری Astra در تاریخ ۱ سپتامبر، پایشهای اضافی انجام خواهد داد تا اقدامات احتمالی ناسازگار با اهداف ایمنی شناسایی و کنترل شوند. این شرکت در گزارش ایمنی ۳ سپتامبر خود گفت مدلهای Astra در شرایط خصمانه، از جمله آزمایشهایی که مشخصاً از آنها خواسته شده بود از نظارت فرار کنند، ممکن است بتوانند ناظران استدلال را دور بزنند.
این شرکت همچنین اعلام کرد Astra در مجموع کمتر از GPT-5.6 Sol محدودیتهای ایمنی و امنیتی را نقض کرده است و استقرارهای خارجی که شامل ابزارها میشوند تحت نظارت قرار گرفتهاند. این یافتهها نشان میدهند یک مدل میتواند در آزمونهای ایمنی عملکرد بهتری داشته باشد، اما همچنان برای نظارت چالشهایی ایجاد کند. این ارزیابیها مشخص نمیکنند که فرار از نظارت در استفاده روزمره با چه میزان تکرار رخ میدهد.
پژوهش مارس ۲۰۲۵ OpenAI درباره نظارت بر زنجیره استدلال، مشکل جداگانهای را مطرح کرد. این پژوهش نشان داد اعمال نظارت قوی بر استدلالهای مشکوک میتواند باعث شود مدلها قصد واقعی خود را پنهان کنند و همچنان رفتار نامناسب داشته باشند. با این حال، نظارت بر استدلال همچنان برای شناسایی رفتارهای نادرست مفید بود. استدلالی که بیضرر به نظر میرسد نیز میتواند همراه با رفتاری ناامن باشد.
برای خریداران و تیمهای امنیتی، استدلال قابل خواندن و کنترلهای خارجی به دو پرسش متفاوت پاسخ میدهند. ردپای استدلال میتواند به آشکار شدن هدف یک مدل کمک کند. مجوزها اقدامات قابل انجام آن را محدود میکنند و گزارشهای محافظتشده شواهدی را حفظ میکنند که مدل نمیتواند بازنویسی کند. ثبت اقدامات ابزارها، تصمیمهای مربوط به مجوزها و نتایج کار، به بازرسان اجازه میدهد یک رخداد را بازسازی کنند، بدون اینکه از مدل بخواهند رفتار خودش را تأیید کند.
راهنمای امنیتی مایکروسافت در ماه مه نیز پیشتر توصیه کرده بود مجوزها فقط به هر وظیفه محدود شوند، هویتهای جداگانه برای عاملهای هوش مصنوعی تعریف شود و بازبینی انسانی از طریق کد برنامه یا نرمافزاری که عامل را هماهنگ میکند، اعمال شود. برای نمونه، شرکتی که یک دستیار پژوهشی را به کار میگیرد میتواند اجازه دسترسی به بازیابی اطلاعات را بدهد، اما امکان تغییر آن اطلاعات را از عامل بگیرد.
این محدودیتها ممکن است میزان کاری را که یک عامل بهتنهایی انجام میدهد کاهش دهند و مراحل تأیید نیز میتوانند اجرای وظایف را کندتر کنند. خریداران باید از ارائهدهندگان بخواهند نشان دهند که یک اپراتور مجاز میتواند یک فرایند فعال را متوقف کند، اقدامات بعدی ابزارها را مسدود کند و گزارشهایی را حفظ کند که عامل قادر به ویرایش آنها نیست. توضیح قانعکننده یک مدل بهتنهایی نمیتواند ثابت کند که این کنترلها واقعاً کار میکنند.
منابع و مطالعه بیشتر
- therundown.ai
- Models as Insider Risks in the Super Intelligence Era | sn scratchpad
- OpenAI’s new reasoning technique alarms AI safety experts | TechCrunch
- Path to Astra: critical capabilities and frontier safeguards | OpenAI
- Safety overview: GPT-6 Astra | OpenAI
- Detecting misbehavior in frontier reasoning models | OpenAI
- Defense in depth for autonomous AI agents | Microsoft Security Blog