
اجرای بارهای کاری استنتاج چندگرهی با استفاده از کانتینرهای یادگیری عمیق Ray LLM در AWS
این مطلب نحوه استقرار یک مدل زبانی بزرگ (LLM) روی دو گره GPU در Amazon Elastic Kubernetes Service (Amazon EKS) با استفاده از کانتینرهای یادگیری عمیق Ray LLM چندگرهی را نشان میدهد. این معماری از گرههای جداگانه برای مرحله پیشپردازش (prefill) و مرحله رمزگشایی (decode) استفاده میکند که پشت یک نقطه پایانی سازگار با OpenAI قرار گرفتهاند. چنین ساختاری در بارهای کاری چندگرهی برای موازیسازی تانسوری، موازیسازی خط لولهای، موازیسازی دادهای و همچنین استنتاج با جداسازی مراحل prefill/decode رایج است.
در مطلب قبلی، کانتینر Ray Serve DLC معرفی شد و از آن برای راهاندازی یک مدل کوچک پشت یک نقطه پایانی HTTP روی یک گره GPU استفاده شد. در آن حالت، یک نقطه پایانی استنتاج آماده در اختیار بود و کانتینر با حفظ سازگاری پشته GPU، از جمله کتابخانههای CUDA، نیاز به نوشتن کدهای تکراری و زیرساختی را از بین میبرد.
Ray یک چارچوب محاسبات توزیعشده است، بنابراین استقرارهای Ray Serve میتوانند روی چندین گره اجرا شوند. مشتریان از Ray Serve چندگرهی به دلایل مختلف استفاده میکنند. برخی میخواهند مدلهای پایه یا مدلهای متنباز بزرگی را اجرا کنند که روی یک GPU واحد جا نمیشوند. برخی دیگر به توان عملیاتی بیشتری از یک نمونه نیاز دارند و گروهی نیز برای بهبود عملکرد، دو مرحله استنتاج را از یکدیگر جدا میکنند.
در هر یک از این موارد، کاربران باید زنجیره وابستگیها را خودشان ایجاد کنند؛ از انتخاب کتابخانههای سازگار با پشته GPU گرفته تا رفع مشکلاتی که در اثر ناسازگاری نسخهها ایجاد میشوند. این کارهای تکراری زمان و منابعی را که میتوانست صرف ارائه مدلها شود، مصرف میکنند.
کانتینرهای یادگیری عمیق AWS (DLC) مدتهاست این مشکل را برای بارهای کاری آموزش و استنتاج حل کردهاند. DLCها تصاویر Docker از پیش ساخته و بهینهشده برای عملکرد هستند که چارچوب، وابستگیها و پشته GPU را در یک ترکیب آزمایششده و اصلاحشده در کنار هم قرار میدهند تا کاربران بتوانند آن را مستقیماً دریافت و استفاده کنند.
با عرضه Ray LLM DLC برای استقرارهای چندگرهی، همین رویکرد اکنون به استنتاج چندگرهی نیز گسترش یافته است. این کانتینر برای ارائه مدلها پشت یک نقطه پایانی HTTP طراحی شده، توسط AWS نگهداری و آزمایش میشود و کل پشته استنتاج را از پیش آماده دارد.
این مطلب نحوه پیادهسازی استنتاج چندگرهی تفکیکشده با استفاده از Ray LLM DLC چندگرهی را بررسی میکند؛ یعنی استقرار یک مدل زبانی بزرگ روی دو گره مجهز به GPU در Amazon EKS که پشت یک نقطه پایانی واحد با هم همکاری میکنند. در این معماری، یکی از گرههای GPU مرحله prefill و دیگری مرحله decode را انجام میدهد.
جدا کردن این مراحل باعث میشود درخواستهای طولانی با محاسبات سنگین prefill، تولید توکن درخواستهایی را که در حال اجرا هستند متوقف نکنند. این روش برای بارهایی مانند تولید تقویتشده با بازیابی (RAG)، خلاصهسازی اسناد و برنامههای عاملمحور مناسب است.
در این پیادهسازی از Ray LLM DLC چندگرهی استفاده میشود که شامل Ray Serve LLM، کتابخانه انتقال استنتاج NVIDIA (NIXL) و پشته Elastic Fabric Adapter (EFA) است و بدون نیاز به کدنویسی برنامه، یک API سازگار با OpenAI ارائه میدهد. کد کامل در مخزن همراه موجود است.
چرا جداسازی prefill/decode (PD) اهمیت دارد؟
استنتاج LLM شامل دو مرحله مجزا است. Prefill کل درخواست ورودی را بهصورت موازی پردازش میکند و حافظه کلید-مقدار (KV cache) را میسازد. سپس Decode پاسخ را توکنبهتوکن تولید میکند و در هر مرحله این حافظه را میخواند و گسترش میدهد.
مرحله prefill به توان محاسباتی وابسته است، در حالی که decode بیشتر به پهنای باند حافظه محدود میشود. وقتی هر دو مرحله روی یک GPU اجرا شوند، برای منابع یکسان رقابت میکنند و پردازشهای سنگین و ناگهانی prefill با فرآیند پایدار و حساس به تأخیر decode تداخل ایجاد میکند.
جدا کردن مرحله prefill از decode امکان انتخاب سختافزار و ویژگیهای سرویسدهی مناسب برای هر مرحله را فراهم میکند و در مقیاس بزرگ عملکرد کلی را بهبود میدهد.
در معماری PD disaggregation، دو مرحله روی گرههای جداگانه قرار میگیرند تا بدون ایجاد اختلال برای یکدیگر اجرا شوند و هرکدام بهصورت مستقل مقیاسپذیر باشند. البته حافظه KV ساختهشده در مرحله prefill باید به گره decode منتقل شود و این انتقال باید بهاندازه کافی سریع باشد تا مزیت این معماری از بین نرود. به همین دلیل ارتباط میان گرهها اهمیت زیادی دارد.
Ray LLM DLC چه چیزی ارائه میدهد؟
DLCهای AWS تصاویر Docker از پیش ساخته و بهینهشدهای هستند که چارچوب، وابستگیها و پشته GPU را در یک ترکیب آزمایششده و اصلاحشده گرد هم میآورند. همه اجزا پیش از انتشار هر نسخه در کنار یکدیگر اعتبارسنجی میشوند تا از ناسازگاری میان زمان اجرای CUDA، چارچوب و لایه سرویسدهی جلوگیری شود. وصلههای امنیتی نیز هنگام ساخت اعمال میشوند.
Ray LLM DLC این قابلیت را به ارائه سرویس LLM توزیعشده گسترش میدهد. این کانتینر شامل vLLM بهعنوان موتور استنتاج، HTTP مربوط به Ray Serve بهعنوان لایه سرویسدهی، NIXL برای انتقال KV cache میان گرهها و پشته EFA شامل libfabric و aws-ofi-nccl برای ارتباط پرسرعت میان گرهها است.
از آنجا که کتابخانه Ray Serve LLM یک سازنده داخلی برنامه دارد، کل برنامه سرویسدهی به یک بلوک YAML تبدیل میشود. نیازی به کلاس handler، model archiver یا ساخت تصویر سفارشی نیست. تابع کمکی build_pd_openai_app یک پیکربندی prefill و یک پیکربندی decode را دریافت میکند و انتقال KV cache میان آنها را پشت یک نقطه پایانی سازگار با OpenAI متصل میکند.
معماری
نمودار زیر نحوه استقرار روی Amazon EKS را نشان میدهد. درخواست کاربر به Ray head روی گره سیستمی CPU میرسد و دو گره کاری GPU مراحل prefill و decode مدل را اجرا میکنند.
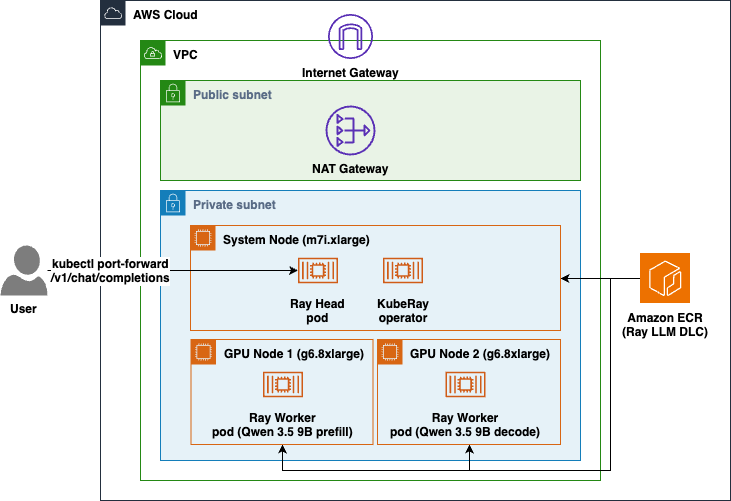
شکل ۱: معماری استنتاج چندگرهی در Amazon EKS، با Ray head روی گره سیستم CPU و مراحل prefill و decode روی دو گره کاری GPU
این استقرار یک کلاستر EKS درون یک شبکه خصوصی مجازی (VPC) است. گرهها در زیرشبکههای خصوصی قرار دارند و دسترسی خروجی آنها از طریق NAT Gateway انجام میشود. یک گره سیستم CPU مدل m7i.xlarge میزبان بارهای سیستمی، اپراتور KubeRay و pod مربوط به Ray head است که فقط از CPU استفاده میکند.
دو گره کاری GPU مدل g6.8xlarge، workerهای Ray را اجرا میکنند؛ یکی برای مرحله prefill و دیگری برای مرحله decode. هر دو گره، Ray LLM DLC را از Amazon Elastic Container Registry (Amazon ECR) دریافت میکنند.
KubeRay سرویس RayService اعمالشده را بررسی میکند و اتصال head به worker را بهصورت خودکار برقرار میسازد. Ray Serve استقرارهای prefill و decode را روی دو worker GPU قرار میدهد. KV cache از worker prefill به worker decode از طریق NIXL و با استفاده از EFA منتقل میشود. گروه گرههای GPU به یک Availability Zone واحد محدود شده است، زیرا EFA نمیتواند میان AZها ارتباط برقرار کند.
پیشنیازها
برای دنبال کردن این مطلب، به موارد زیر نیاز دارید:
- یک حساب AWS با فعال بودن صورتحساب.
- سهمیه کافی برای اجرای دو نمونه g6.8xlarge (حداقل ۶۴ vCPU) در منطقه موردنظر.
- AWS Command Line Interface (AWS CLI) با اعتبارنامه پیکربندیشده.
- ابزار خط فرمان kubectl برای ارتباط با صفحه کنترل Kubernetes.
- ابزار خط فرمان eksctl برای ایجاد و مدیریت کلاسترهای EKS.
- helm برای نصب اپراتور KubeRay.
- ابزار envsubst از مجموعه GNU gettext برای تولید manifest.
اعتبارنامه AWS خود را با دستور زیر بررسی کنید:
aws sts get-caller-identityادامه مقاله شامل مراحل پیکربندی، استقرار کلاستر EKS، افزودن گرههای GPU، نصب KubeRay، استقرار RayService، فراخوانی مدل، بررسی استفاده از EFA و پاکسازی منابع است. دستورات و فایلهای پیکربندی ارائهشده در مقاله، نحوه اجرای کامل این معماری را نشان میدهند.
جمعبندی و گامهای بعدی
در این معماری، یک مدل واحد روی دو گره GPU با جداسازی prefill/decode سرویسدهی شد و کل برنامه تنها یک بلوک YAML بود؛ بدون کد handler، بدون model archiver و بدون نیاز به ساخت دستی پشته GPU و EFA. Ray LLM DLC چندگرهی پشته استنتاج آزمایششده را فراهم کرد، KubeRay کلاستر Ray را مدیریت کرد و NIXL روی EFA انتقال KV cache میان گرهها را انجام داد. وظیفه کاربر پیکربندی سامانه بود، نه ساخت آن از ابتدا.
الگوهای رایج برای اجرای استنتاج چندگرهی شامل موازیسازی تانسوری و خط لولهای برای تقسیم مدلهایی که روی یک نمونه جا نمیشوند، موازیسازی دادهای برای افزایش توان عملیاتی و جداسازی prefill/decode برای قرار دادن دو مرحله استنتاج روی گرههای متفاوت است.
از اینجا میتوان replicaهای decode را برای افزایش توان عملیاتی مقیاس داد، مدلهای بزرگتر را با موازیسازی تانسوری یا خط لولهای روی نمونههای GPU بزرگتر اجرا کرد یا کتابخانههای اضافی موردنیاز مدلها را روی همین پایه آزمایششده اضافه کرد. برای کد کامل، فهرست برچسبهای تصاویر و جزئیات فنی، به مخزن همراه، صفحه تصاویر موجود Ray LLM DLC، مستندات Ray Serve LLM درباره prefill/decode و مستندات EFA مراجعه کنید.