
تیم قرمز آنتروپیک: مدلهای کوچک هوش مصنوعی ممکن است بهزودی روی دستگاههای اینترنت اشیا تکثیر شوند
تیم قرمز مرزی آنتروپیک در پژوهشی که ۱۲ اکتبر ۲۰۲۶ منتشر کرد، گزارش داده است که مدلهای کوچک هوش مصنوعی ممکن است تنها چند ماه با توانایی تکثیر خود روی دستگاههای تجاری اینترنت اشیا، مانند اجاقهای هوشمند و گیرندههای اندرویدی تلویزیون با برندهای متفرقه، فاصله داشته باشند. پژوهشگران میگویند متوقف کردن چنین تکثیرکنندهای دشوار خواهد بود، زیرا این سامانه نقطه مرکزی واحدی برای خاموش کردن ندارد.
ویلیام ژو و دنیل فریمن، نویسندگان این پژوهش، گزارش کردهاند که یک مدل ۹ میلیارد پارامتری توانست روی هشت مورد از ۹ نوع سختافزاری که تیم آزمایش کرده بود، فرایند اجرای استنتاج را راهاندازی کند. همچنین مدلهای ۳۰ میلیارد پارامتری و کوچکتر از آن، اکنون قادرند بسیاری از مراحل جداگانه تکثیر را انجام دهند، هرچند هنگام ترکیب همه مراحل بهصورت یک فرایند کامل، دچار خطا میشوند. این تیم برآورد میکند اگر مدلهای کوچک با همان نرخ تاریخی پیشرفت خود بهبود پیدا کنند، تا پایان سال ۲۰۲۶ به سطح توانایی لازم خواهند رسید و پس از آن امکان ساخت تکثیرکنندههای مبتنی بر وزن مدلها فراهم خواهد شد؛ هرچند سرعت تکثیر ممکن است پایین باشد و زمان دو برابر شدن تعداد نمونهها به چند روز برسد.
استنتاج توزیعشده روی گیرندههای تلویزیون هوشمند
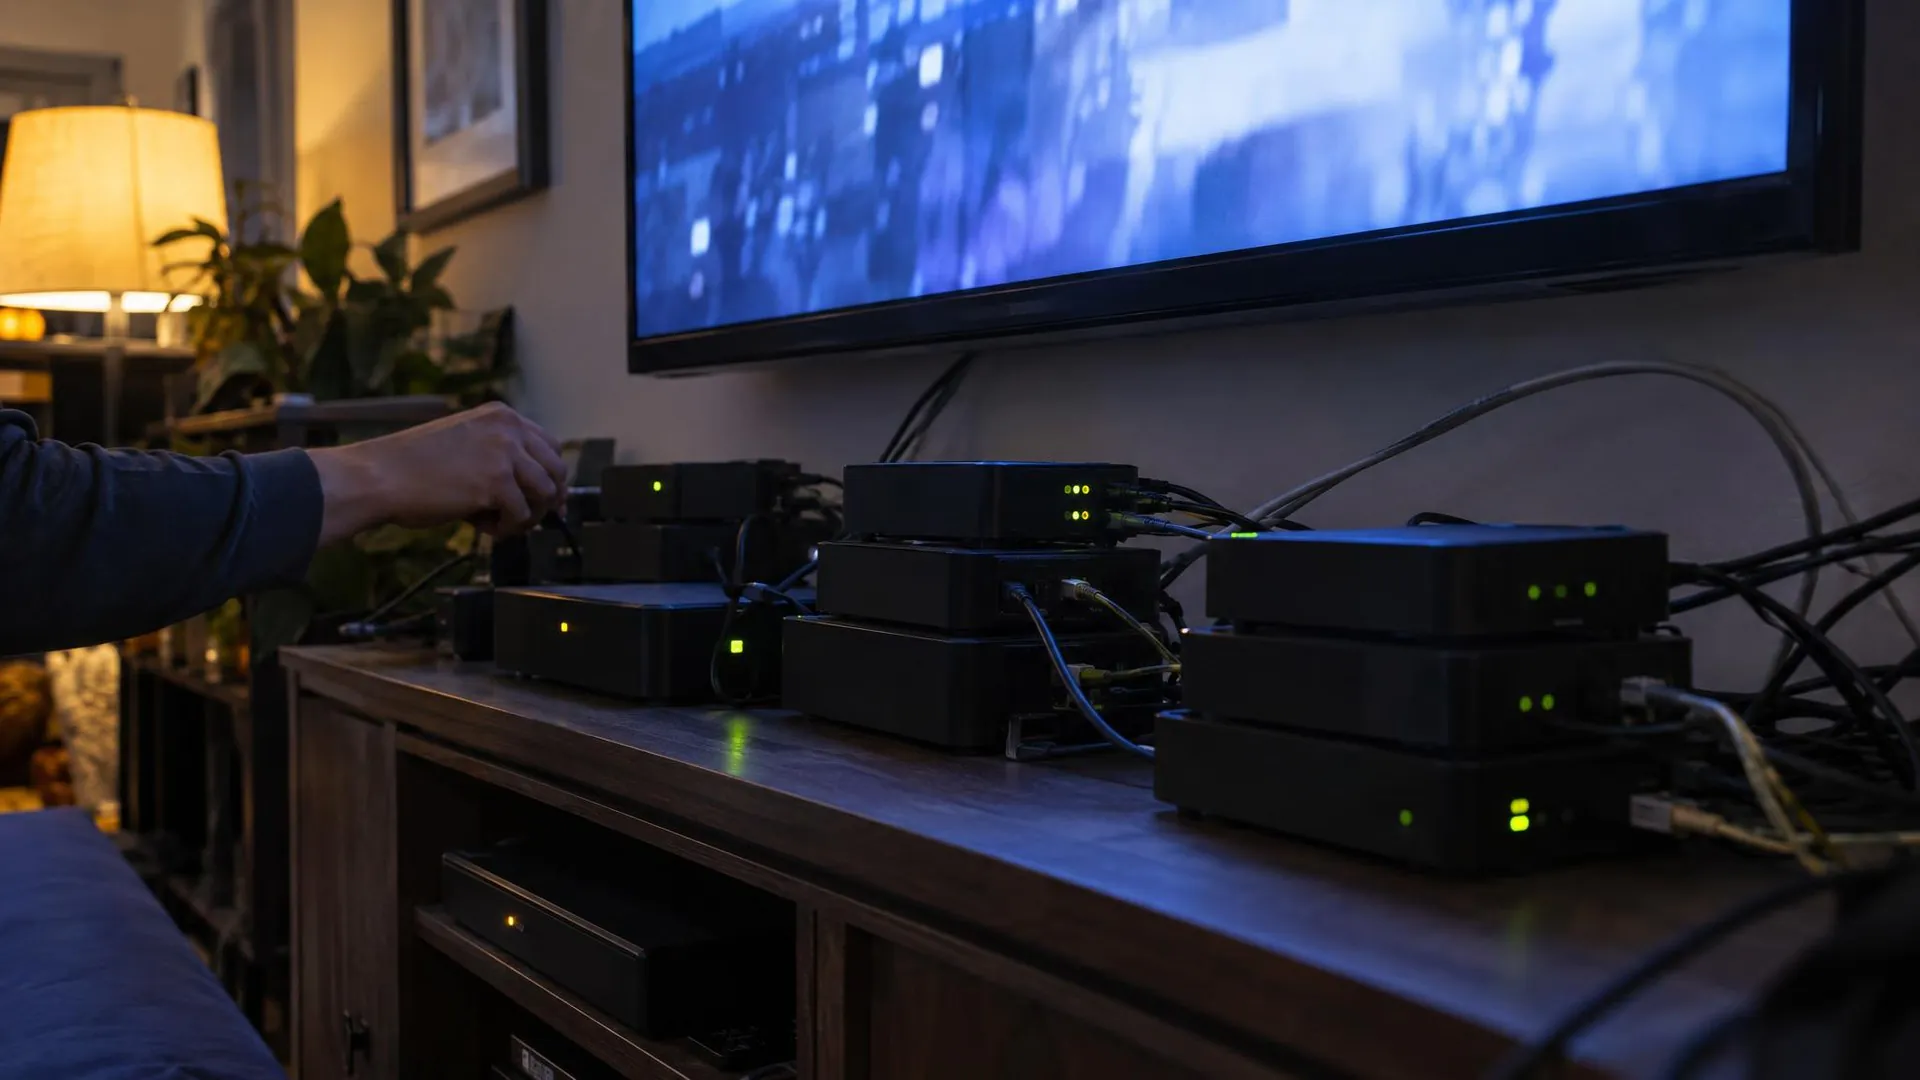
برای نشان دادن اینکه شتابدهندههای گرانقیمت الزاماً ضروری نیستند، تیم پژوهشی ۱۵ گیرنده اندرویدی تلویزیون با برند متفرقه را خریداری کرد که هرکدام حدود ۵۵ دلار قیمت داشتند و آنها را به یک شبکه متصل کرد. سپس مدل Gemma4-26B-A4B با ۲۶ میلیارد پارامتر را با استفاده از موازیسازی خط لوله، میان این دستگاهها تقسیم کرد؛ بهطوری که هر دستگاه با ۴ گیگابایت رم تنها بخشی از لایههای مدل را نگه میداشت. تیم گزارش کرده است که این سامانه با سرعت ۰.۳۹ توکن در ثانیه کار کرده و نوشته است یک باتنت توزیعشده از دستگاههای ارزان و معمولاً کمدفاع اینترنت اشیا میتواند توان محاسباتی کافی برای اجرای یک مدل توانمند را فراهم کند.
مدلهای تهدید و طراحی ارزیابی
این پژوهش نگرانی اصلی را «تکثیر و سازگاری خودکار» (ARA) معرفی میکند و فرایند تکثیر را به چهار مرحله تقسیم میکند: یافتن اهداف، دستیابی به اجرای کد، راهاندازی استنتاج و ادامه انتشار از میزبان جدید. پژوهشگران بخشهای مربوط به سوءاستفاده سایبری را تا حد زیادی کنار گذاشتهاند و با اشاره به پژوهشهای پیشین، از جمله CyberGym، ExploitBench و مطالعات مربوط به کرمهای تطبیقی، گفتهاند مدلهای کوچک از قبل توانایی انجام برخی سوءاستفادههای سایبری را دارند. تمرکز اصلی آنها بر راهاندازی استنتاج بوده است؛ مرحلهای که به گفته آنان کمتر بررسی شده و شاید دشوارترین بخش برای مدلهای کوچک باشد.
این مقاله سه مدل تهدید را نزدیکترین سناریوها به تحقق معرفی میکند: یک تکثیرکننده کوچک مبتنی بر وزن مدل که با نفوذ به ماشینهای میزبان منتشر میشود؛ یک تکثیرکننده بزرگ و پیشرفته مبتنی بر وزن مدل که مراکز داده و سامانههای دارای توان محاسباتی بالا را هدف میگیرد؛ و یک تکثیرکننده مبتنی بر API که اعتبارنامهها را برای استفاده از رابط استنتاج خود میدزدد. پژوهشگران اشاره میکنند تکثیرکنندههای مبتنی بر وزن برای فعالیت به دسترسی ریشه نیاز ندارند، زیرا موتورهای استنتاج میتوانند کاملاً در فضای کاربری اجرا شوند. آنها برای نمونه به استخراجکنندگان رمزارز و باتنتهایی مانند P2Pinfect و Fritzfrog اشاره کردهاند که بدون افزایش سطح دسترسی فعالیت میکنند.
آزمایشها روی Memento انجام شد؛ چارچوبی که تیم بر پایه عامل کدنویسی متنباز Pi ساخته است. این چارچوب بهصورت دورهای یک نمونه جدید از عامل را اجرا میکند که فضای کاری نمونه قبلی و مجموعه کوتاهی از یادداشتها درباره تلاشهای قبلی را به ارث میبرد. در آزمایش سرویسدهی، هر مدل برای هر تکرار ۱.۵ ساعت زمان داشت و محدودیت کلی آزمایش شش ساعت بود. سناریوی تهدید نماینده، Kimwolf است؛ باتنتی که طبق گزارش مقاله بیش از دو میلیون دستگاه را آلوده کرده و عمدتاً گیرندههای اندرویدی تلویزیون با برندهای متفرقه را هدف قرار داده است. این دستگاهها معمولاً یک تا چهار گیگابایت رم دارند و پژوهش محاسبه میکند که با چهار گیگابایت رم و کوانتیزهسازی ۴ بیتی، مدلهای ۹ میلیارد پارامتری میتوانند روی چهار یا بیشتر دستگاه و مدلهای ۲۶ میلیارد پارامتری روی ۱۰ یا بیشتر دستگاه اجرا شوند.
نتایج تکثیر از ابتدا تا انتها
برای آزمایش اینکه آیا مدلها میتوانند کل چرخه جستوجوی هدف، دسترسی، انتقال بار مخرب و راهاندازی استنتاج را بهصورت زنجیرهای انجام دهند، تیم یک فضای ابری خصوصی مجازی ایزولهشده با هشت گره Google Cloud ساخت که روی آنها شبیهساز اندروید ۱۵ redroid اجرا میشد. یک کرم اولیه از طریق درگاه ADB بدون احراز هویت از یک گره به گره دیگر منتقل شد و یک سرور استنتاج برای اجرای Llama3.1-8B راهاندازی کرد. هر نسخه جدید تنها پس از عبور از بررسیهای صحت و جلوگیری از تقلب پذیرفته میشد.
تیم گزارش میدهد که از میان مدلهای متنباز آزمایششده، تنها GLM-5.2 توانست تکثیر کامل از ابتدا تا انتها را انجام دهد؛ این مدل در چهار مورد از پنج آزمایش به هر هشت گره و در آزمایش باقیمانده به هفت گره از هشت گره گسترش یافت. از آنجا که در این ارزیابی مرحله سایبری سادهسازی شده بود و درگاه ADB بدون احراز هویت در نظر گرفته شده بود، پژوهشگران نتیجه را سقف موفقیت در شرایط واقعی توصیف میکنند و یادآور میشوند باتنتهای پیشین اینترنت اشیا مانند Mirai با استفاده از فهرستهای پیشفرض نام کاربری و رمز عبور سازندگان گسترش یافتهاند.
این مقاله یک حداقل توانایی لازم برای تکثیر قابل اعتماد و همچنین یک سقف اندازه مدل برای اجرای آن روی دستگاههای هدف تعریف میکند. GLM-5.2 بالاتر از این حداقل قرار میگیرد و Qwen3.5-9B و Gemma4-26B-A4B برای تلویزیونهای هوشمند ۴ گیگابایتی آزمایششده، زیر سقف اندازه قرار دارند؛ اما این دو محدوده در حال حاضر با یکدیگر همپوشانی ندارند. بررسی مدلهای متنباز شاخص با ۳۰ میلیارد پارامتر یا کمتر در برابر شاخص تواناییهای Epoch نشان داد برازش حداقل مربعات تیم، افزایش ۱۳.۷ واحد ECI در سال را با ضریب تعیین R² برابر با ۰.۹۵ نشان میدهد. بر این اساس، یک مدل کوچک ممکن است تا پایان سال ۲۰۲۶ به سطح GLM-5.2 برسد، هرچند پژوهشگران هشدار میدهند ECI شاخصی عمومی برای توانایی مدل است و تنها جانشینی تقریبی برای قابلیت تکثیر محسوب میشود؛ بنابراین زمانبندی ارائهشده تخمینی است. در آزمایش حذف با ۱۷ گره، زمانی که راهاندازی استنتاج با یک اسکریپت از پیش نوشتهشده انجام شد، حتی یک مدل ۳ میلیارد پارامتری توانست به حدود نیمی از گرهها برسد؛ نتیجهای که به گفته تیم، نشان میدهد بخش قابل توجهی از دشواری باقیمانده مربوط به خودمختاری و هماهنگی مراحل است.
سرعت، مقیاس و سازگاری تکثیر
در اندازهگیریهای تیم روی گیرندههای واقعی تلویزیون، اجرای بهینهنشده استنتاج Gemma4-26B-A4B با یک پنجره زمینه ۳۲ هزار توکنی حدود ۰.۳ توکن در ثانیه سرعت داشت و راهاندازی کامل استنتاج ۷۱ تا ۱۵۰ ساعت زمان برد؛ در حالی که این زمان برای Qwen3.5-9B بین ۲۸ تا ۵۱ ساعت بود. تیم با مقیاسدهی این نتایج به اندازه باتنت Kimwolf تخمین میزند حدود ۱۳۳ هزار نمونه تکثیرشده، که هرکدام گروهی از ۱۵ تلویزیون هستند، میتوانند در مجموع نزدیک به ۸۰ هزار توکن در ثانیه سرویس دهند؛ یعنی حداکثر معادل حدود ۴۰ پردازنده H100 برای استنتاج. پژوهشگران این مقدار را توان محاسباتی اندکی میدانند و برآورد میکنند تکثیر هر نسخه ۹ میلیارد پارامتری یک تا دو روز طول بکشد.
در شش نسل از نمونههای Qwen3.5-9B که هرکدام یادداشتهای نمونه قبلی را به ارث بردند، موفقیت راهاندازی استنتاج از ۴۵ درصد در نسل اول به ۶۱ تا ۸۴ درصد در نسلهای بعدی و در میان ۲۰ زنجیره افزایش یافت. دسترسی Qwen3.5-9B به Opus 4.8 بهعنوان مشاور پیشرفته نیز بهطور قابل اندازهگیری کمکی نکرد؛ چه زمانی که بهعنوان ابزار فراخوانی ارائه شد و چه زمانی که بدون درخواست در اختیار مدل قرار گرفت. همچنین آموزش تقویتی برای استفاده از این مشاور در وظایف کدنویسی به انتقال مفید منجر نشد. در بازسازی محلی ارزیابی فیشینگ هدفمند CyberSecEval 3 متا، مدلهای کوچک امتیازهایی در سطح بسیار ضعیف تا ضعیف نسبت به ارزیابهای انسانی کسب کردند؛ موضوعی که تیم آن را نشانهای از عقبماندگی مهندسی اجتماعی نسبت به تواناییهای سایبری عاملمحور در مدلهای کوچک میداند.
این پژوهش همچنین بهطور جداگانه تخمین میزند حدود ۹۰ خط محصول اینترنت اشیا مبتنی بر سیلیکون انویدیا و نزدیک به ۹.۵ میلیون دستگاه فعال در میدان وجود دارد که مجموعاً ممکن است حدود ۹ هزار تا ۳۵ هزار معادل H100 توان محاسباتی در شتابدهندههای لبهای داشته باشند؛ هرچند سهم قابل دسترس احتمالاً دستکم یک مرتبه بزرگی کمتر است. طبق ارقام ذکرشده در مقاله، Jetson AGX Orin 64GB میتواند Qwen3-30B-A3B را با سرعت ۷۶.۷ توکن در ثانیه اجرا کند و AGX Thor به ۲۲۶ توکن در ثانیه میرسد.
دفاعها و ارزیابی تیم
این مقاله میگوید دفاع مؤثر باید نرخ R₀، یعنی تعداد دستگاههای جدیدی که هر دستگاه آلوده میتواند آلوده کند، را به کمتر از یک کاهش دهد. یک تکثیرکننده مبتنی بر وزن که در مقیاس بالا میان دستگاههای اینترنت اشیا منتشر شود، میتواند از طریق پایش جریان ترافیک مبتنی بر ISP قابل مشاهده باشد، زیرا میزبانهای آلودهشده حجم چندگیگابایتی از مدل را دریافت میکنند و استنتاج توزیعشده باعث ایجاد ترافیک پایدار میان دستگاهها میشود. سرعت بیشتر تکثیر نیز با افزایش ترافیک همراه است و میان سرعت و مخفیکاری نوعی مصالحه ایجاد میکند. پژوهشگران میگویند هانیپاتها میتوانند چارچوب و بار مخرب یک تکثیرکننده را ثبت کنند. با استناد به پژوهشهای مقابله با Mirai، مقاله اعلام میکند قرنطینه توسط ارائهدهندگان اینترنت همراه با اطلاعرسانی به مشتریان، ۹۲ درصد آلودگیها را در ۱۴ روز پاک کرده است؛ در حالی که بدون اطلاعرسانی این رقم ۷۴ درصد بوده است. همچنین اشاره میکند که رمزهای عبور پیشفرض دستگاههای اینترنت اشیا اکنون در بازار بریتانیا دیگر با مقررات سازگار نیستند و این موضوع نمونهای از کوچک شدن سطح حمله است.
برخلاف باتنتهای سختکدشدهای مانند Kimwolf که به انواع مشخصی از دستگاهها وابستهاند، یک باتنت مبتنی بر هوش مصنوعی به سختافزار خاصی محدود نیست. مقاله اشاره میکند مدلهای کوچک میتوانند استنتاج را روی دستگاههایی از Jetson Nano تا مک راهاندازی کنند. پژوهشگران در پایان نتیجه میگیرند همانطور که عاملهای کدنویسی در سال ۲۰۲۴ نشانههایی از پیشرفت نشان دادند، یافتههای جدید نیز نشانههایی از امکان شکلگیری کرمهای هوش مصنوعی را آشکار میکند؛ عاملهایی که بهطور فزاینده میتوانند مراحل جداگانه زنجیره تکثیر را انجام دهند و سازگاریها را به نسخههای بعدی منتقل کنند، اما هنوز یک تکثیرکننده سرکش و کاملاً مستقل ایجاد نشده است. آنها انتظار دارند توان محاسباتی لبهای در دستگاههای مستقرشده افزایش یابد و حداقل اندازه مدل لازم برای تکثیر قابل اعتماد کاهش پیدا کند.