
مِیوز واندر با پشت سر گذاشتن آسترا، متا دوباره به خط مقدم رقابت مدلهای هوش مصنوعی بازگشت
بیش از یک سال بعد، متا سرانجام یک مدل بزرگ هوش مصنوعی عرضه کرده است که میتواند بهطور مستقیم با مدلهای پیشرفته OpenAI و Anthropic رقابت کند.
مارک زاکربرگ در ۱۲ اکتبر اعلام کرد که آزمایشگاه ابرهوش متا (Meta Superintelligence Labs یا MSL) بهطور رسمی Muse Wonder و Muse Wonder Full را منتشر کرده است. این نخستین مدل پرچمداری است که از زمان تأسیس MSL بیش از یک سال پیش، ادعا میکند به سطح پیشرفتهترین مدلهای بازار رسیده است.
پیش از این، در شرایطی که OpenAI و Anthropic بهنوبت رتبهبندی مدلهای هوش مصنوعی را بهروزرسانی میکردند، متا برای مدت طولانی نسل جدیدی از مدل پرچمدار خود را معرفی نکرده بود. حتی این تصور شکل گرفته بود که زاکربرگ از رقابت برای دستیابی به بالاترین سطح عملکرد منصرف شده است.
اکنون به نظر میرسد متا در حال آمادهسازی یک حرکت بزرگ بوده است.
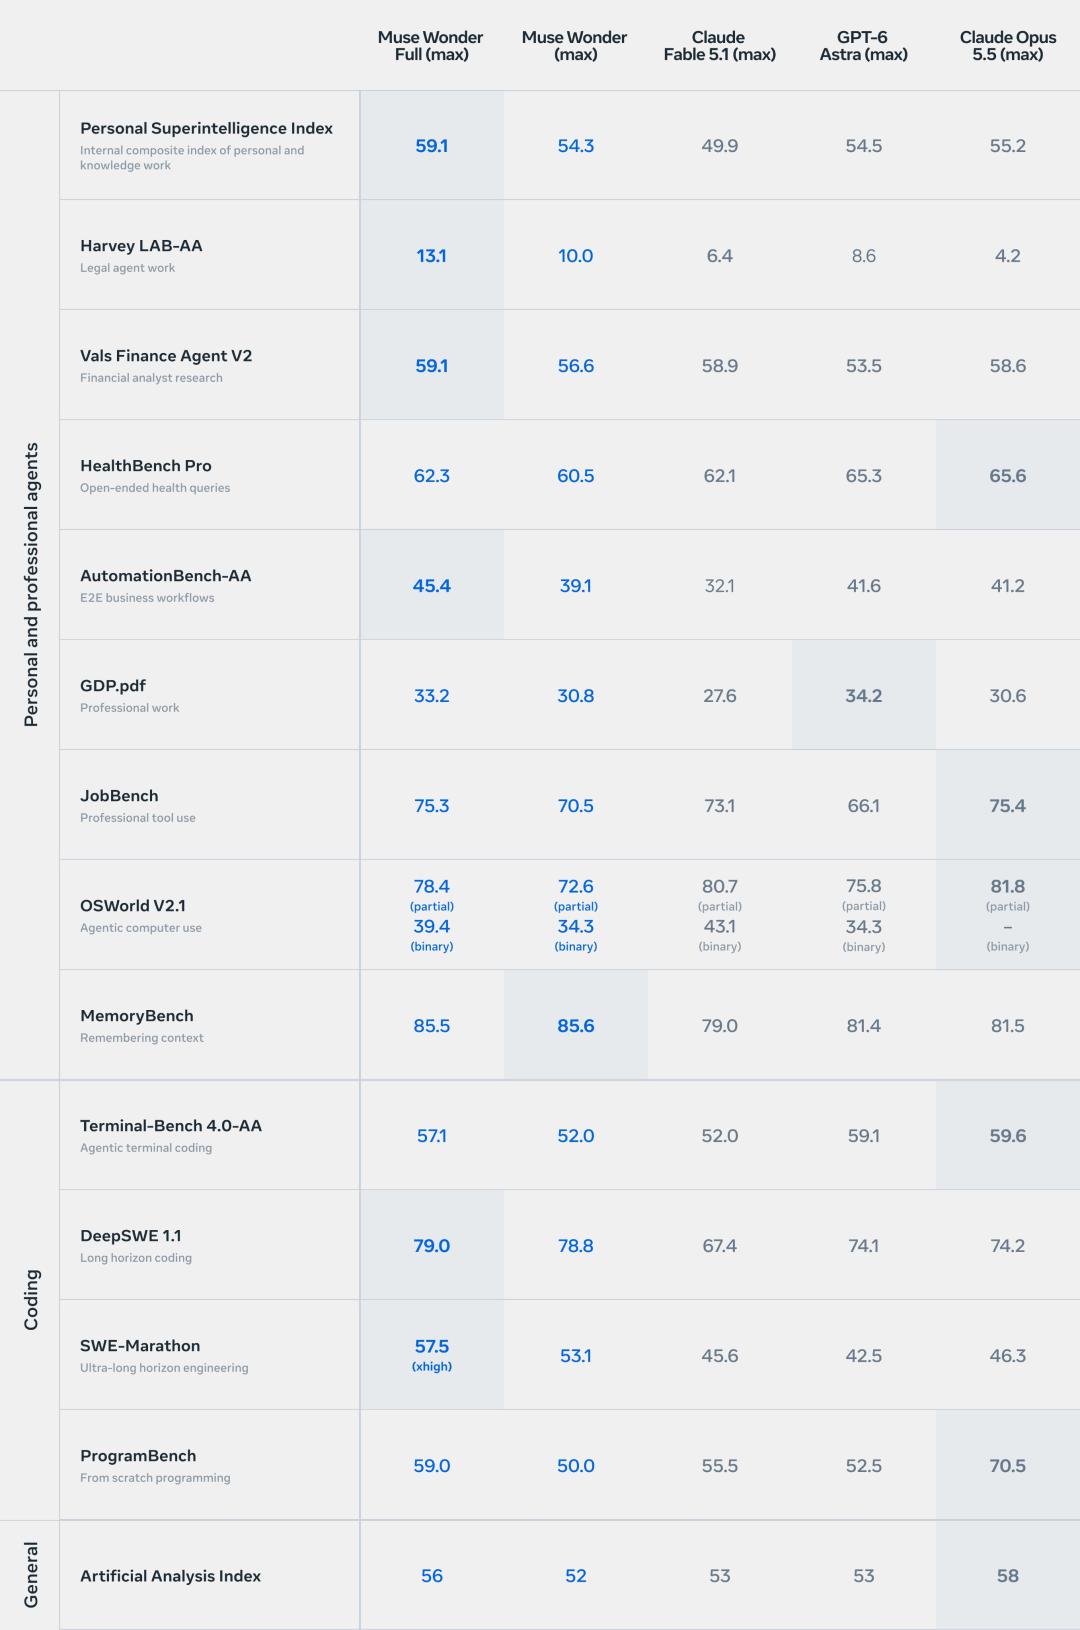
در آزمونهایی مانند برنامهنویسی، وظایف عاملهای هوشمند با چرخه طولانی و تواناییهای حافظه، Wonder Full نتایج چشمگیری ثبت کرده و در برخی بخشها حتی از GPT-6 Astra و Claude Opus 5.5 پیشی گرفته است.
در آوریل ۲۰۲۵، مدل Llama 4 که متا امید زیادی به آن بسته بود عرضه شد، اما نتوانست روند موفقیت نسلهای قبلی را ادامه دهد و در عوض با بحثهایی درباره عملکرد و بهینهسازی برای آزمونهای معیار مواجه شد. پس از آن، زاکربرگ شخصاً وارد عمل شد، سرمایه زیادی برای جذب نیروهای متخصص اختصاص داد و تیم تحقیق و توسعه هوش مصنوعی را بازسازی کرد.
اکنون زاکربرگ سرانجام نتیجه این سرمایهگذاری را دریافت کرده است. اما مدل جدید متا تا چه اندازه رقابتی است؟
متا دوباره یک مدل در سطح برترینها دارد
متا این بار دو مدل عرضه کرده است: Muse Wonder و مدل قدرتمندتر Muse Wonder Full. هر دو مدل از پنجره زمینه یک میلیون توکن پشتیبانی میکنند و بر برنامهنویسی، وظایف بلندمدت عاملهای هوشمند و کارهای تخصصی دانشمحور تمرکز دارند.
بر اساس معیارهای رسمی منتشرشده توسط متا، Wonder Full در چندین آزمون توانسته با مدلهای پرچمدار OpenAI و Anthropic رقابت مستقیم داشته باشد.
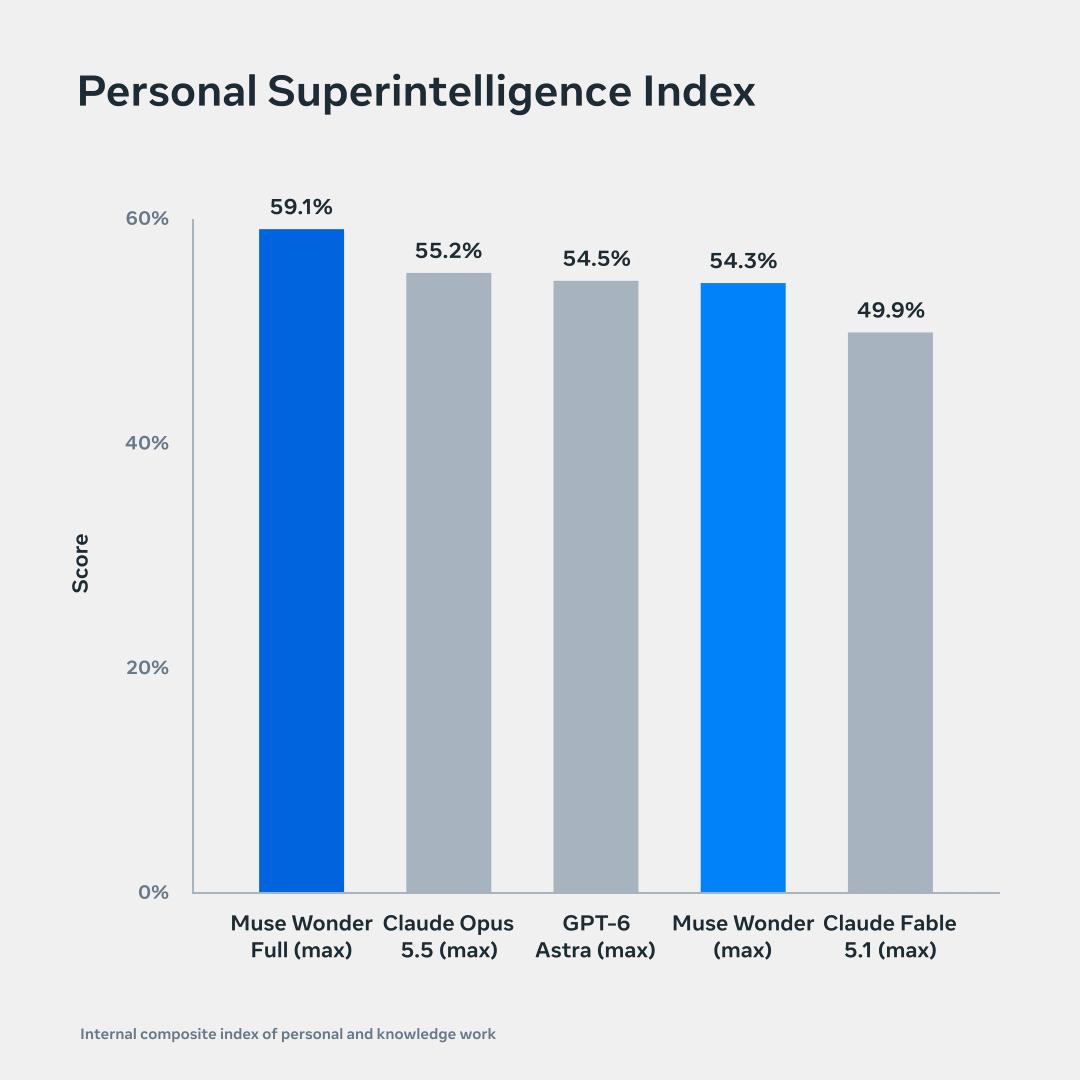
یکی از قابلتوجهترین شاخصها، معیاری با نام Personal Superintelligence Index است.
این شاخص جامع توسط متا در داخل شرکت طراحی شده و شامل هفت آزمون مرتبط با امور شخصی و کارهای دانشمحور است؛ از جمله سناریوهایی مانند فعالیتهای حرفهای، خودکارسازی فرایندها و عملیات وب.
در این آزمون، Wonder Full با امتیاز ۵۹.۱ درصد در رتبه نخست قرار گرفت. Claude Opus 5.5 و GPT-6 Astra بهترتیب ۵۵.۲ و ۵۴.۵ درصد امتیاز کسب کردند و نسخه استاندارد Wonder نیز با امتیاز ۵۴.۳ درصد توانست از Fable 5.1 عبور کند.
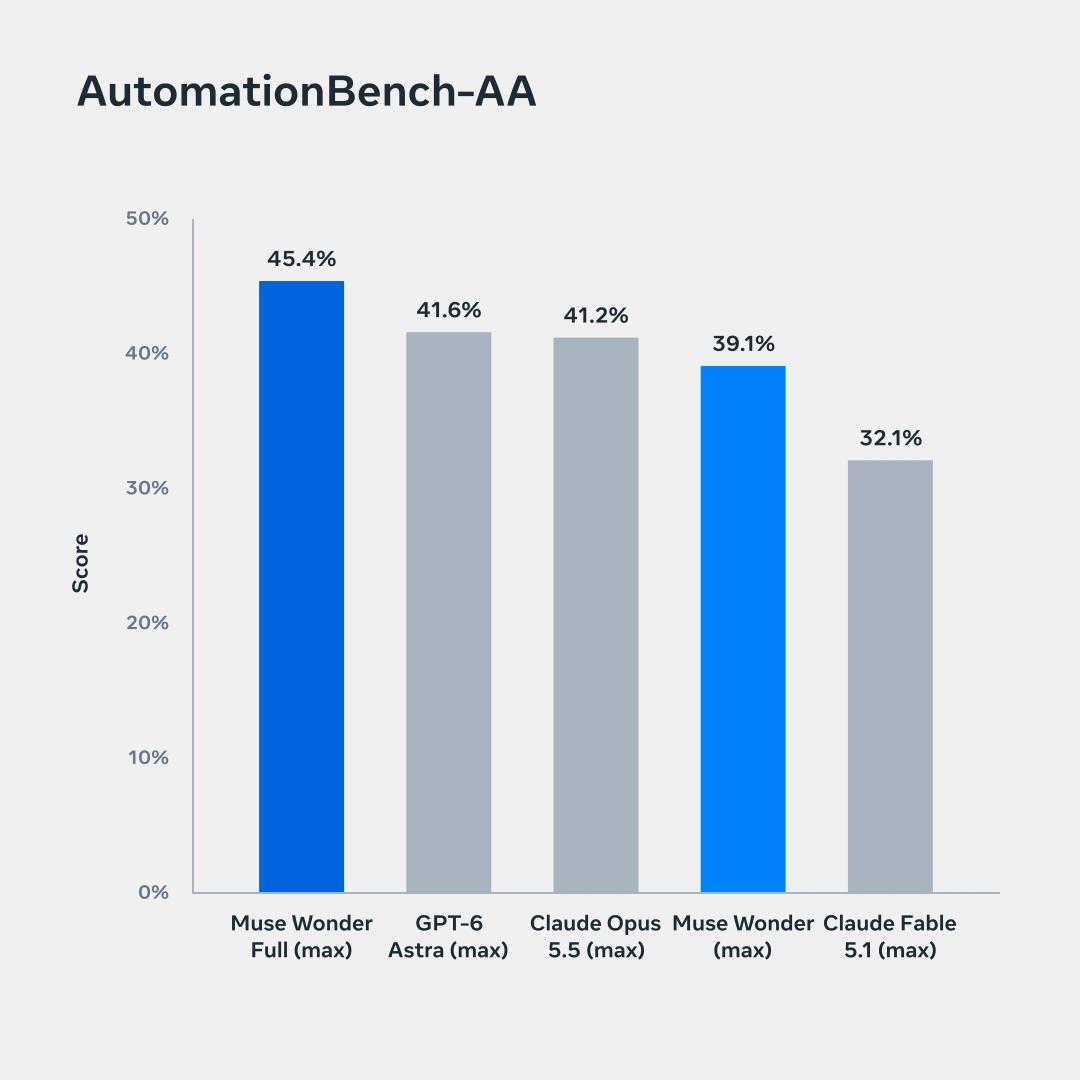
متا همچنین تواناییهای مدل در زمینه خودکارسازی و حافظه را بهطور ویژه نمایش داد.
در آزمون AutomationBench-AA که توانایی خودکارسازی کامل فرایندهای کاری را اندازهگیری میکند، Wonder Full امتیاز ۴۵.۴ درصد به دست آورد؛ رقمی بالاتر از ۴۱.۶ درصد Astra و ۴۱.۲ درصد Opus 5.5.
در MemoryBench که توانایی حافظه مکالمهای بلندمدت را بررسی میکند، نسخه استاندارد Wonder حتی کمی بهتر از Wonder Full عمل کرد و امتیاز ۸۵.۶ درصد گرفت؛ در حالی که Wonder Full به ۸۵.۵ درصد، Opus 5.5 به ۸۱.۵ درصد و Astra به ۸۱.۴ درصد رسیدند. این آزمون توسط خود متا توسعه یافته و هدف آن بررسی توانایی مدل در بازیابی دقیق اطلاعات کلیدی از مکالمههای طولانی با حجم زیادی از اطلاعات مزاحم و تغییرات محتوایی است.
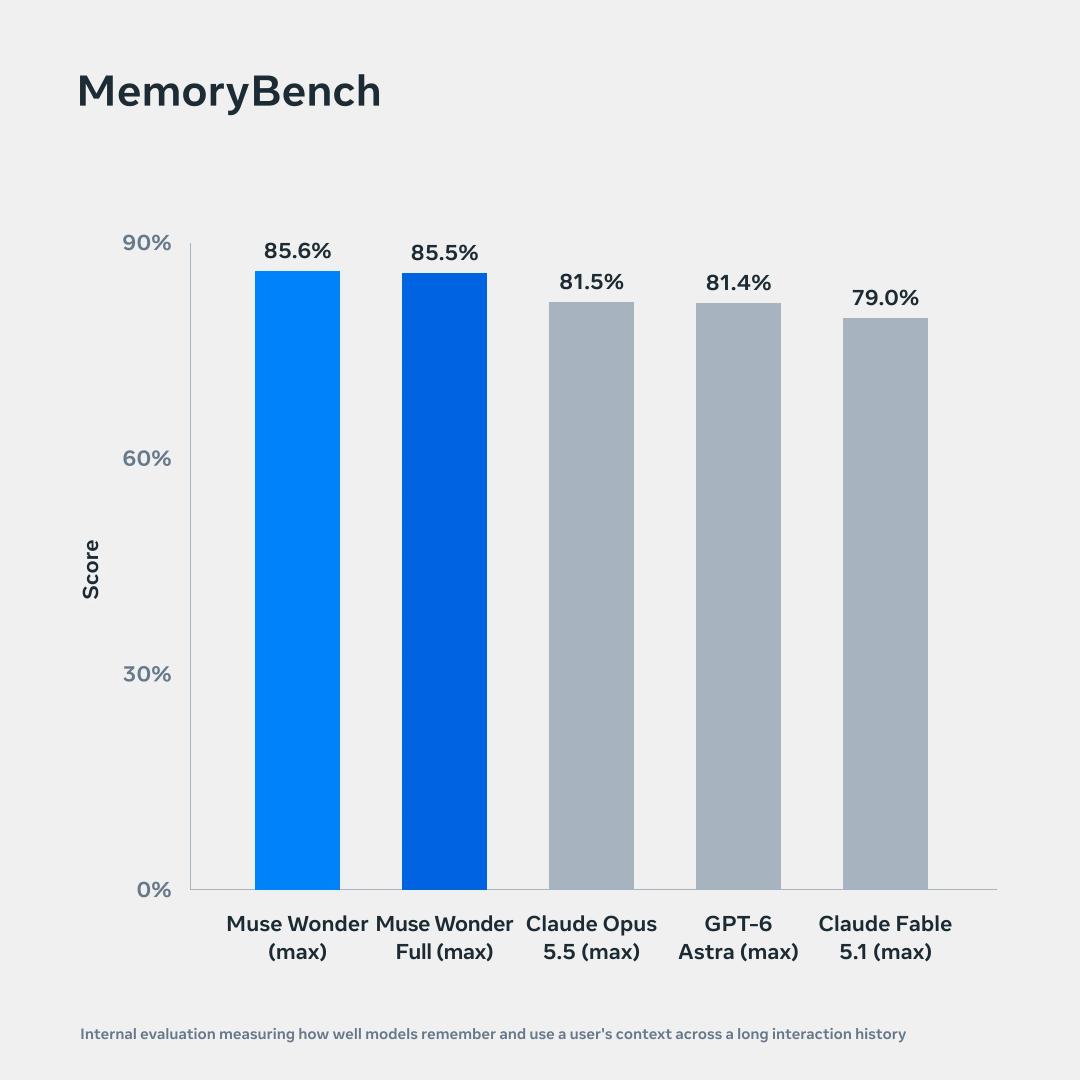
از وظایف شخصی و حرفهای گرفته تا خودکارسازی فرایندها و استخراج اطلاعات از مکالمههای طولانی، این سه آزمون بهروشنی نشان میدهند که متا تمرکز زیادی بر تواناییهای عاملهای هوشمند دارد.
با این حال، تمرکز بر عاملهای شخصی باعث نشده است که متا رقابت با OpenAI و Anthropic در حوزه برنامهنویسی را کنار بگذارد.
در DeepSWE 1.1 که توانایی مهندسی نرمافزار بلندمدت را آزمایش میکند، Wonder Full امتیاز ۷۹ درصد کسب کرد و از GPT-6 Astra با ۷۴.۱ درصد و Claude Opus 5.5 با ۷۴.۲ درصد بالاتر قرار گرفت. در SWE-Marathon که چرخه وظایف طولانیتری دارد و مدل باید بهطور مداوم پروژههای نرمافزاری را اصلاح و نگهداری کند، نرخ موفقیت Wonder Full به ۵۷.۵ درصد رسید؛ در حالی که این رقم برای GPT-6 Astra برابر ۴۲.۵ درصد و برای Claude Opus 5.5 برابر ۴۶.۳ درصد بود.
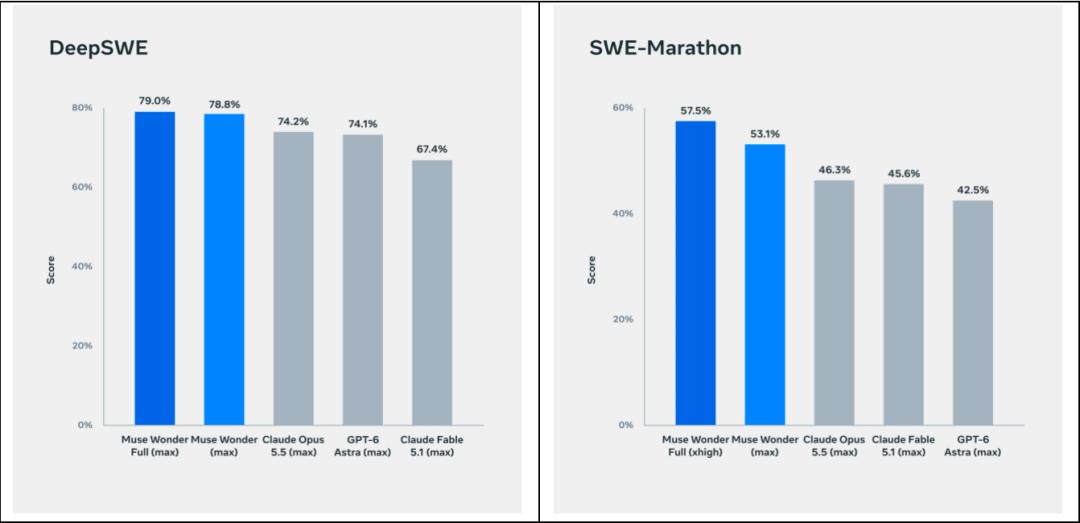
در پنج آزمون کلیدی که متا ارائه کرده است، Wonder Full در همه موارد از مدلهای پرچمدار دو شرکت رقیب پیشی گرفته است. حتی نسخه استاندارد Wonder نیز در آزمونهای برنامهنویسی و حافظه عملکرد رقابتی دارد.
البته این نتایج هنوز ثابت نمیکند که متا بهطور کامل از OpenAI و Anthropic پیشی گرفته است. معیارهای یادشده شامل شاخصهایی هستند که خود متا طراحی کرده و آزمونها نیز با تنظیمات عملیاتی متفاوت انجام شدهاند؛ بنابراین نمیتوان آنها را بهسادگی معادل تجربه واقعی کاربران دانست.
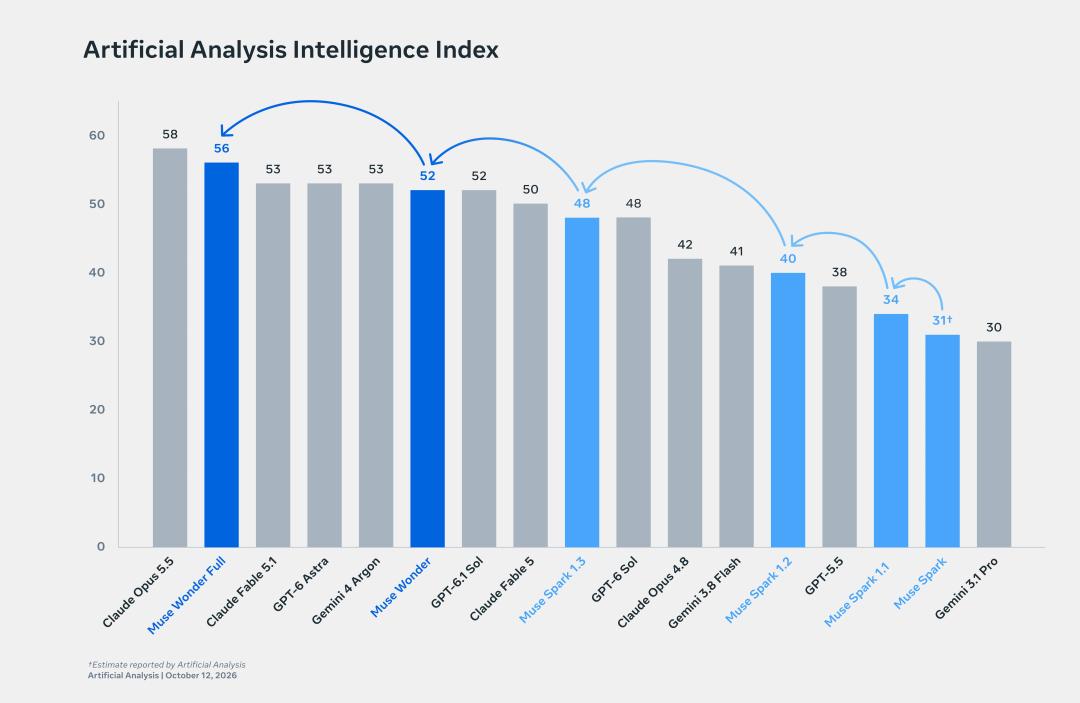
علاوه بر این، در ارزیابی جامع شخص ثالث Artificial Analysis Intelligence Index، امتیاز Wonder Full برابر ۵۶ بود؛ بالاتر از GPT-6 Astra با ۵۳ امتیاز، اما پایینتر از Claude Opus 5.5 با ۵۸ امتیاز.
در کنار عملکرد، قیمتگذاری نیز قابل توجه است.
در حال حاضر نسخه استاندارد Muse Wonder از طریق Meta Model API و Muse Code در دسترس است. قیمت ورودی API برابر ۴ دلار به ازای هر یک میلیون توکن، قیمت خروجی ۲۰ دلار به ازای هر یک میلیون توکن و هزینه ورودی ذخیرهشده ۰.۲ دلار به ازای هر یک میلیون توکن است.
برای مقایسه، قیمت استاندارد API برای Claude Opus 5.5 دقیقاً ۴ دلار برای ورودی و ۲۰ دلار برای خروجی است؛ در حالی که GPT-6 Astra برای ورودی ۱۰ دلار و برای خروجی ۵۰ دلار هزینه دارد.
با توجه به اینکه عملکرد سه مدل در برخی آزمونها بسیار نزدیک است، قیمتگذاری Wonder رقابتی به نظر میرسد.
متا همچنین اعلام کرده است که برای استفاده از زمینههای طولانیتر هزینه اضافی دریافت نخواهد کرد.
با این حال، Wonder Full که در این نوبت عملکرد بهتری در آزمونهای معیار نشان داده، فعلاً بهصورت جداگانه از طریق API قابل خرید نیست.
این مدل در حال حاضر فقط برای کاربران Power Usage و مشترکان طرح جدید Maximum Usage در Muse Code ارائه میشود. هزینه این دو طرح بهترتیب ۵۰ و ۲۰۰ دلار در ماه است. سهمیه استفاده در طرح جدید ۸۰ برابر طرح پایه Everyday Usage خواهد بود.
در مورد Muse، محصول عامل شخصی متا، این سرویس هنوز بهطور همزمان به Wonder ارتقا پیدا نکرده است.
متا اعلام کرده است که Wonder بهتدریج به Muse متصل خواهد شد؛ ابتدا برای کاربران اشتراکی و سپس با نسخهای ویژه برای عموم کاربران. هنوز زمان مشخصی برای ورود Wonder Full به Muse اعلام نشده است.
بنابراین، با وجود عرضه مدل پرچمدار، برای بیشتر کاربران این بهروزرسانی فعلاً در مرحله محصولات توسعهدهندگان و پیشنمایش قابلیتهای آینده قرار دارد.
هدفگذاری بازار عاملهای هوشمند مصرفی
متا علاوه بر نمایش امتیازهای آزمونهای معیار، در وبلاگ فنی رسمی خود فضای زیادی را به توانایی تعمیم مدل اختصاص داده است.
این شرکت به دو اصطلاح بهطور ویژه اشاره کرده است: Benchmaxxing و Big model smell. اصطلاح نخست به معنای «بازی با معیارهای سنجش» است و به مدلهایی اشاره دارد که بیش از حد برای آزمونهای محبوب آموزش داده شدهاند؛ اصطلاح دوم عبارتی انتزاعیتر است که میتوان آن را «بوی نامطبوع مدل بزرگ» ترجمه کرد.
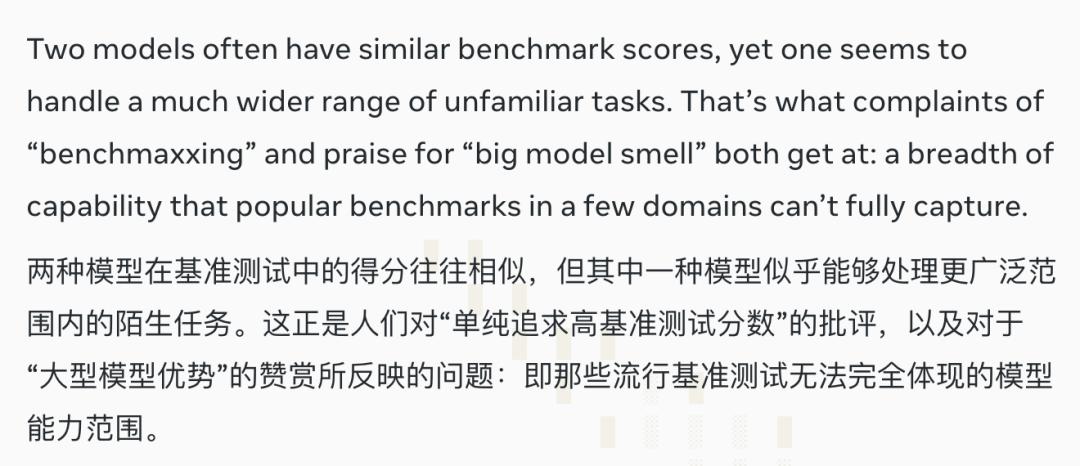
متا معتقد است حتی اگر دو مدل در آزمونهای معیار امتیازهای مشابهی داشته باشند، توانایی واقعی آنها در مواجهه با وظایف ناشناخته میتواند بسیار متفاوت باشد. برخی مدلها قابلیتهایی فراتر از محدوده آزمونهای رایج دارند که کاربران در استفاده واقعی متوجه آن میشوند.
برای بررسی این موضوع، متا بهطور ویژه Muse Spark 1.3 و Wonder Full را مقایسه کرد.
پژوهشگران دو نوع وظیفه را در کنار هم قرار دادند: وظایفی که در مرحله پساآموزش بهشدت برای آنها بهینهسازی شده بودند و وظایف ناشناختهای که مدل بهطور خاص برای آنها بهینه نشده بود. سپس عملکرد دو مدل را با شدتهای مختلف استنتاج بررسی کردند.
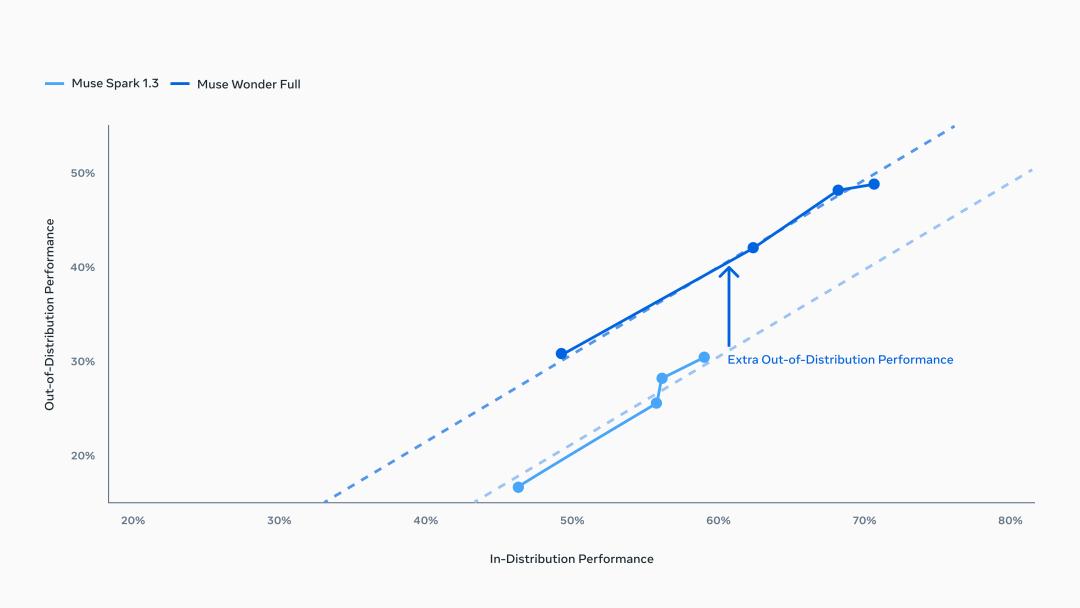
نتایج نشان داد در حالی که دو مدل در وظایف بهینهشده امتیازهای مشابهی داشتند، Wonder Full در وظایف ناشناخته عملکرد بهتری ارائه کرد و از پیشبینیهای حاصل از روند آزمون Spark 1.3 فراتر رفت.
متا این موضوع را ناشی از آن میداند که Wonder بر پایه یک مدل پایه بزرگتر و قدرتمندتر ساخته شده است. هرچه تواناییهای مدل پایه بیشتر باشد، احتمال انتقال بهبودهای حاصل از پساآموزش به وظایفی که بهطور خاص برای آنها آموزش ندیده، افزایش مییابد.
در مقایسه با این اعداد، مجموعه نمونههای رسمی ارائهشده توسط متا شاید بهتر مسیر توسعه Wonder را نشان دهد.
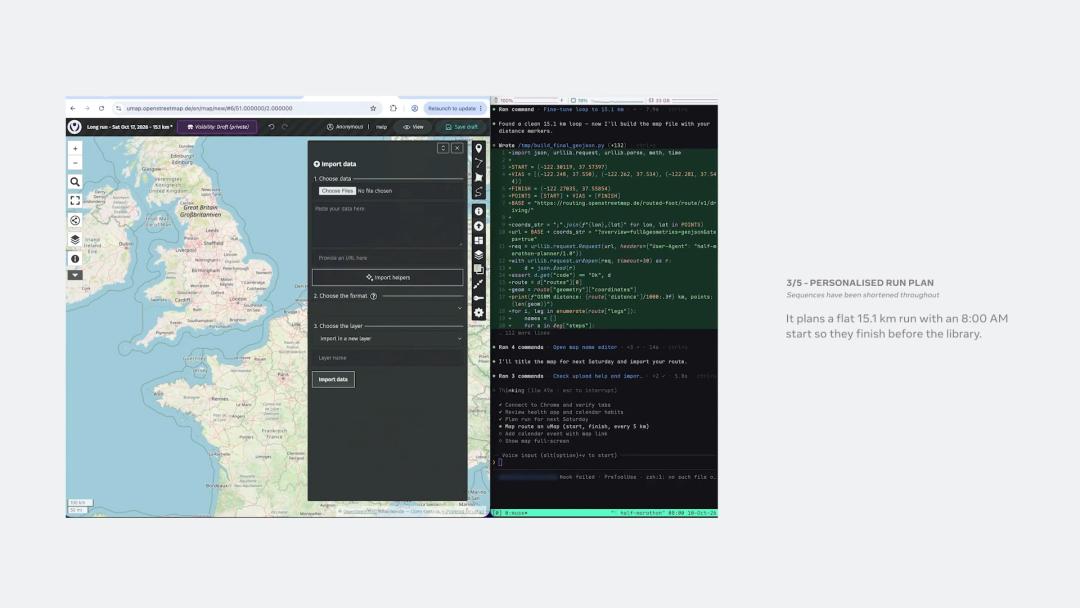
برای مثال، کاربر میتواند از Wonder بخواهد یک جلسه دویدن برای روز شنبه برنامهریزی کند.
Wonder میتواند با توجه به ترجیحات شخصی کاربر و شرایط واقعی، میان مرورگر و چندین برنامه مختلف تعامل کند و یک برنامه دویدن تنظیم کند.
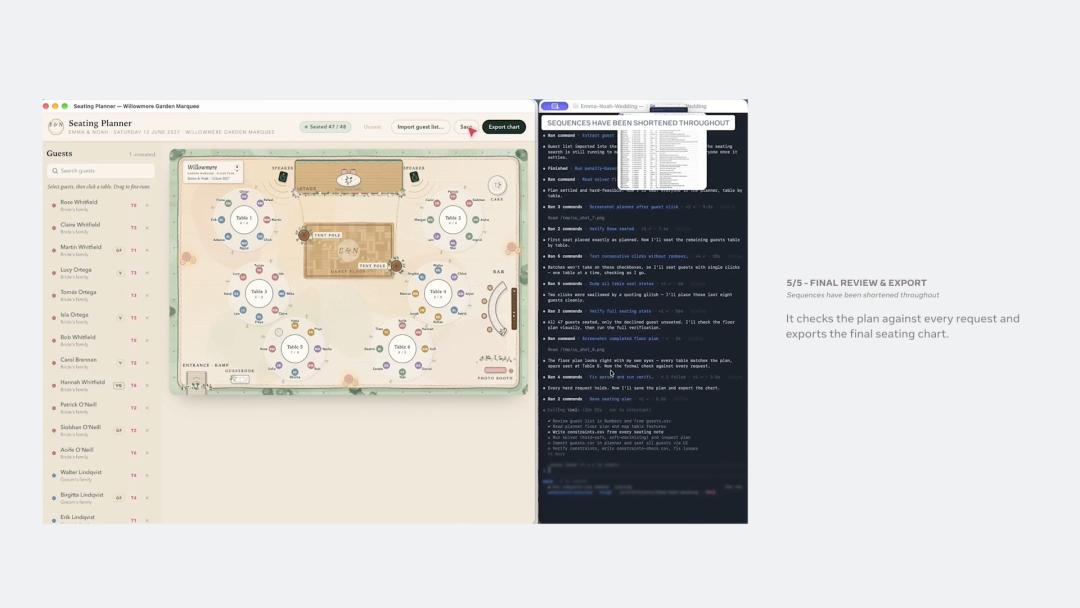
نمونه دیگر، سپردن برنامهریزی چیدمان صندلیهای مراسم عروسی به Wonder است.
کاربر مجموعهای از نیازهای پیچیده، از جمله روابط میان مهمانان و محدودیتهای جایگاهها را ارائه میکند و Wonder بر اساس این شرایط، نمودار سفارشی چیدمان صندلیها را ایجاد میکند.
متا همچنین نشان داد که Wonder میتواند عکسهای واقعی کاربران از حسابهای اینستاگرام آنها را بخواند، یادگاریهای شخصیسازیشده طراحی کند و سفارش آنها را تکمیل کند.
البته Wonder میتواند وظایف حرفهایتری نیز انجام دهد؛ برای مثال، ساخت مستقیم یک بازی سهبعدی قابل اجرا از روی تصویر ارائهشده توسط کاربر، پردازش درخواستهای بیمه، درک قراردادهای اجاره و تحلیل امور مالی شخصی.
برای انجام موفق این وظایف، متا دو قابلیت Wonder را بهطور ویژه برجسته کرده است: Active Memory و Active Focus.
قابلیت نخست به مدل اجازه میدهد اطلاعات مهم را در میان مکالمههای مختلف حفظ کند و هنگام نیاز محتوای مرتبط را بازیابی کند. قابلیت دوم نیز به مدل امکان میدهد هنگام مواجهه با مشکل، روشهای دیگری را امتحان کند، موانع را پشت سر بگذارد، کار را ادامه دهد و در صورت نیاز از کاربر سؤال بپرسد یا تأیید بگیرد.
در عاملهای شخصی مصرفی، وظایفی که کاربران ممکن است تعیین کنند بسیار متنوع هستند و ابزارها، اهداف و محدودیتهای درگیر نیز گستردهترند. توسعهدهندگان نمیتوانند همه شرایط را از پیش پیشبینی کنند، چه رسد به اینکه مدل را برای تکتک وظایف زندگی آموزش دهند.
در مقایسه با کسب بالاترین امتیاز در چند وظیفه ثابت، متا آشکارا ترجیح میدهد Wonder بتواند طیف گستردهای از مشکلات، حتی مشکلات پیشبینینشده، را مدیریت کند.
یک روز پیش از عرضه Wonder، الکساندر وانگ، مدیر ارشد هوش مصنوعی متا، در مصاحبهای با David Senra درباره دلیل انتخاب تمرکز متا بر عاملهای شخصی مصرفی صحبت کرد.
او یادآوری کرد که در اوایل سال جاری، Claude در حوزه برنامهنویسی فاصله زیادی با رقبا ایجاد کرده بود و صنعت هوش مصنوعی برای مدتی تصور میکرد عاملهای کدنویسی مهمترین شکل محصول هوش مصنوعی هستند و تقریباً همه میخواستند وارد این بازار شوند تا با Anthropic رقابت کنند.
اما متا مسیر دیگری را انتخاب کرد.
الکساندر وانگ معتقد است مزیت طبیعی متا در بازار مصرفکننده قرار دارد، زیرا این شرکت محصولاتی مانند اینستاگرام، واتساپ و فیسبوک را در اختیار دارد.