
انجمن OpenAI مهارتهای هوش مصنوعی برای متخصصان نظرسنجی را در دستور کار قرار داد
کارگاهی در واشنگتن دیسی پژوهشگران را گرد هم آورد تا گردشکارهای خودکار را بررسی کنند، از تجربه همکاران صنعتی بیاموزند و درباره قضاوت حرفهای لازم برای استفاده مسئولانه از هوش مصنوعی گفتوگو کنند.
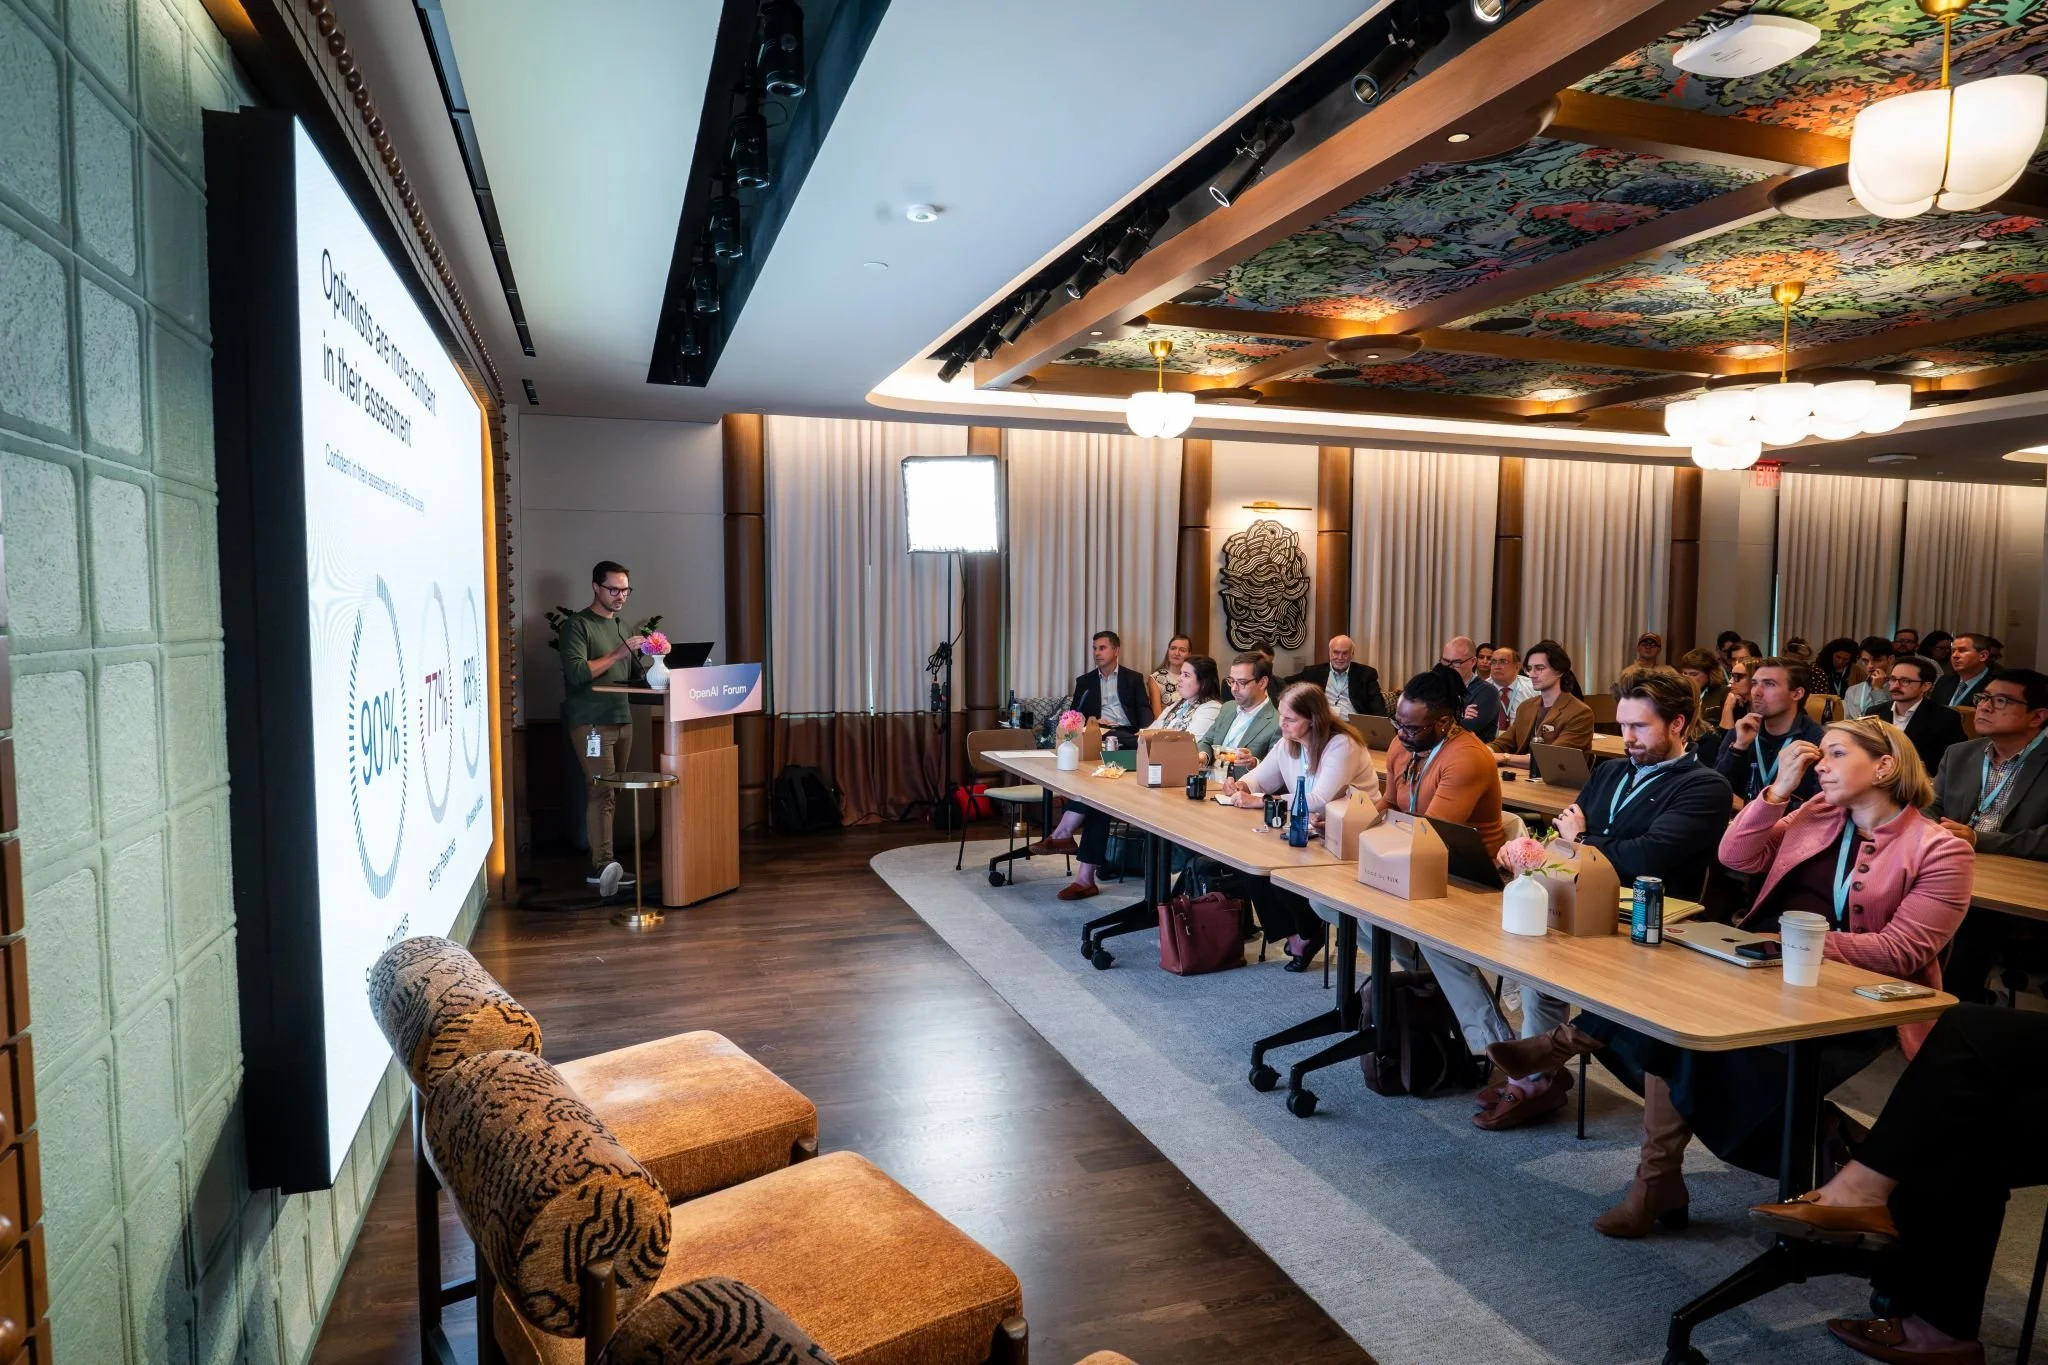
متخصصان نظرسنجی در انجمن OpenAI در واشنگتن دیسی گرد هم آمدند تا ابزارهای هوش مصنوعی، گردشکارهای پژوهشی و مهارتهای لازم برای ارزیابی نتایج را بررسی کنند.
انجمن OpenAI متخصصان نظرسنجی را در واشنگتن دیسی گرد هم آورد تا در کارگاهی درباره استفاده از هوش مصنوعی در پژوهشهای پیمایشی شرکت کنند. این رویداد شامل نمایش ابزارهای خودکار برای پایش نظرسنجیها و تحلیل دادههای مکالمهای بود و در کنار آن، درباره چگونگی تغییر مهارتهای پژوهشگران برای استفاده از این فناوری بحث شد.
شرکتکنندگان از تجربه متخصصانی از OpenAI، TrueDot، Gallup و Cygnal شنیدند؛ افرادی که ابزارهایی را در عمل استفاده میکنند یا در حال آزمایش آنها هستند. نشستها تغییرات عملی در روند کار را با پرسشهایی درباره قضاوت حرفهای پیوند دادند: چگونه نتایج بررسی شوند، چه روشهای پژوهشی مناسب هستند و نقش هوش مصنوعی در تولید شواهد چگونه توضیح داده شود.
در آغاز رویداد، میشل جاکونی، مشاور OpenAI، دو هدف برای شرکتکنندگان تعیین کرد: یادگیری چیزی که بتواند کار آنها را بهبود دهد و آشنایی با فردی که تخصصش بتواند مسیر یادگیری آنها را ادامه دهد. او این کارگاه را فضایی توصیف کرد که در آن متخصصان دعوت شدهاند در شکلدهی گفتوگو درباره هوش مصنوعی نقش داشته باشند.
این رویکرد در نمایش ابزارهایی که توسط نظرسنجیگران باتجربه ساخته شده بود نیز دیده شد؛ ابزارهایی که بر وظایفی متکی بودند که این متخصصان از نزدیک با آنها آشنا بودند، از جستوجو در جدولهای طولانی نتایج گرفته تا پیگیری نظرسنجیهای تازه منتشرشده.
تبدیل وظایف آشنای پژوهشی به گردشکارهای هوش مصنوعی
لوکاس استاکسلادر، مدیر پژوهشهای اولیه در بخش Global Affairs Insights شرکت OpenAI، یک ردیاب احساسات عمومی درباره هوش مصنوعی را معرفی کرد که با استفاده از Codex ساخته و خودکار شده بود. این ابزار نتایج نظرسنجیهای عمومی از مؤسساتی مانند Marist، Pew و Gallup را جمعآوری میکند.
این ردیاب همچنین نشان داد که چرا تخصص پژوهشی همچنان ضروری است. استاکسلادر توضیح داد که سنجههای مربوط به نگرش عمومی نسبت به هوش مصنوعی، بسته به نحوه طرح پرسش و جامعه آماری مورد بررسی متفاوت هستند. برای مثال، پرسیدن اینکه آیا خطرات هوش مصنوعی بیشتر از مزایای آن است، با پرسیدن اینکه آیا هوش مصنوعی بیشتر آسیبزا است یا مفید، معنای یکسانی ندارد.
مارک موری، مدیر تحریریه OpenAI، نمونه دیگری را از دوران فعالیت خود بهعنوان مسئول نظرسنجی در NBC News مطرح کرد. او توضیح داد که چگونه از ChatGPT و Codex برای گردآوری هفتگی نظرسنجیهای عمومی جدید، شامل لینکها، جدولهای نتایج و خلاصهها استفاده میکند و این مجموعه برای بررسی به صندوق ورودی او ارسال میشود.
به گفته OpenAI، علاقه به این کاربردها تنها به پژوهشگران حرفهای محدود نیست. OpenAI Global Affairs در توضیح خود درباره این کارگاه در حساب LinkedIn این شرکت نوشت: «دهها هزار کاربر هر روز برای دریافت اطلاعات درباره نظرسنجیها و روششناسی آنها، از ChatGPT پرسوجو میکنند.»
جان کوهن، بنیانگذار و مدیرعامل TrueDot، نشان داد که چگونه TrueDot Connect به کاربران اجازه میدهد با استفاده از زبان طبیعی، دادههای نظرسنجی را در ChatGPT جستوجو کنند. کوهن که پیشتر مدیر نظرسنجی واشنگتن پست و مدیر ارشد پژوهشی SurveyMonkey بوده است، این تجربه را با جستوجو در صدها صفحه جدول در شرایط فشرده کاری تحریریه مقایسه کرد.
کوهن همچنین نشان داد که هوش مصنوعی چگونه میتواند به پژوهشگران در بررسی سوابق تاریخی کمک کند؛ سوابقی که پیشتر نیازمند دیجیتالیسازی دستی بودند. او از زمانی یاد کرد که در دوره تحصیلات تکمیلی، نظرسنجیهای کالیفرنیا را از روی زونکنها کدنویسی میکرد.
او گفت: «اکنون با Codex و TrueDot، یک فایل تجمیعی از نظرسنجیهای کالیفرنیا با بیش از یک میلیون مورد از سال ۱۹۵۶ تا ۲۰۲۶ ایجاد کردهام. جدا شدن از این مجموعه داده برایم سخت است.»
او توضیح داد که از این دادههای ترکیبی برای بررسی تغییرات وابستگی سیاسی و وزندهی آماری در طول دههها استفاده میکند؛ موضوعی که دامنه پرسشهایی را که میتواند بررسی کند، گسترش داده است.
کوهن برای متخصصانی که تازه استفاده از هوش مصنوعی را آغاز کردهاند، تأکید کرد که باید دانش موجود خود را وارد این فرایند کنند و با استفاده مکرر، روش کارشان را بهبود دهند. او به شرکتکنندگان گفت: «هر کسی میتواند با این ابزارها عدد تولید کند.» توصیه او بر بررسی این موضوع متمرکز بود که آیا سیستمها دادههایی را که پژوهشگران میشناسند، بهدرستی بازتاب میدهند یا نه.
ساخت سواد هوش مصنوعی در کنار توانایی فنی
نشستی که موری مدیریت آن را بر عهده داشت، برنت بوکانان، بنیانگذار و مدیرعامل Cygnal، و ایلانا رون-لوی، مدیرعامل Gallup، را گرد هم آورد تا بررسی کنند هوش مصنوعی چگونه میتواند کار نظرسنجی را تغییر دهد.
رون-لوی کاربردهای هوش مصنوعی پیش و پس از جمعآوری دادهها را توضیح داد؛ از یافتن پرسشهای نظرسنجی معتبرشده پیشین و پشتیبانی از مرور منابع علمی گرفته تا آزمایش فرایندهای پژوهش کیفی. او همچنین خواستار آن شد که پژوهشگران تجربههای خود را بیشتر با یکدیگر به اشتراک بگذارند.
این گفتوگو به مهارتهای موردنیاز افرادی که نتایج نظرسنجیها را مصرف میکنند نیز پرداخت. بوکانان گفت روزنامهنگاران باید ترکیب نمونه آماری و روششناسی پژوهش را بررسی کنند و تنها به یافتههای مطرحشده در تیترها تکیه نکنند.
رون-لوی هشدار داد آسانتر شدن دسترسی به دادههای نظرسنجی میتواند به گسترش اطلاعات نادرست کمک کند، اگر کاربران نتوانند میان یک نظرسنجی قوی و ضعیف تفاوت بگذارند.
او گفت: «شاید بخشی از راهحل، افزایش سواد عمومی درباره اصول پایه نظرسنجی باشد تا مردم بتوانند خودشان ارزیابی کنند.»
شفافیت نیز یکی دیگر از مسئولیتهای حرفهای مطرحشده در این نشست بود. رون-لوی هشدار داد: «فقط چند بازیگر بد کافی هستند که اعلام نکنند از هوش مصنوعی استفاده شده یا داده مصنوعی را بهعنوان داده انسانی ارائه دهند؛ این مسئله میتواند اعتماد را بهشدت کاهش دهد.»
او افزود: «فکر میکنم بازیگران مسئول در صنعت پژوهش نظرسنجی میدانند که کل این صنعت بر شفافیت کامل درباره روشها استوار است.»
آنچه آزمایشهای مصاحبه نشان میدهد
این کارگاه همچنین نمونههایی ارائه کرد که نشان میداد استفاده از هوش مصنوعی تنها به یادگیری کار با یک ابزار محدود نمیشود.
به گفته رون-لوی، Gallup بیش از ۵۰۰ هزار نظرسنجی صوتی مبتنی بر هوش مصنوعی را در چهار قاره انجام داده است. این شرکت پاسخها را با دادههای جمعآوریشده توسط مصاحبهگران تلفنی انسانی و پنلهای خودتکمیلشونده مقایسه میکند، بدون آنکه متعهد به جایگزینی مصاحبهگران انسانی باشد.
تجربه Cygnal محدودیت متفاوتی را نشان داد. بوکانان گفت مصاحبهگر هوش مصنوعی این شرکت توانست دستورالعملهای نظرسنجی را اجرا کند، اما این شرکت پس از یک آزمایش در آمریکا، پروژه را متوقف کرد؛ زیرا فرایند دریافت رضایت از شرکتکنندگان هزینه تماسها را پیش از محاسبه هزینههای هوش مصنوعی، دستکم دو برابر تماسهای معمولی کرد.
Gallup همچنان بررسی میکند که مصاحبههای تلفنی مبتنی بر هوش مصنوعی برای پاسخ به چه پرسشهایی دقیق هستند و آیا افرادی که با این نوع مصاحبهها موافقت میکنند، بهطور نظاممند با کسانی که آنها را رد میکنند تفاوت دارند یا نه. رون-لوی گفت این سازمان انتظار دارد یافتههای بیشتری را در کنفرانس بعدی انجمن آمریکایی پژوهش افکار عمومی ارائه کند.