
هوش مصنوعی بازتولید انگلی را آموخت؛ Anthropic مدلهای زبانی بزرگ را روی ۱۵ گیرنده تلویزیونی قدیمی اجرا کرد
۱۵ جعبه تلویزیون اندرویدی بدون برند که هرکدام حدود ۵۵ دلار قیمت داشتند و تنها ۴ گیگابایت حافظه داشتند، در این آزمایش به کار گرفته شدند.
پژوهشگران Anthropic این دستگاههای ارزانقیمت را که معمولاً فقط برای تماشای ویدئو استفاده میشوند، به شبکه متصل کردند و موفق شدند یک مدل بزرگ با ۲۶ میلیارد پارامتر را روی آنها اجرا کنند.
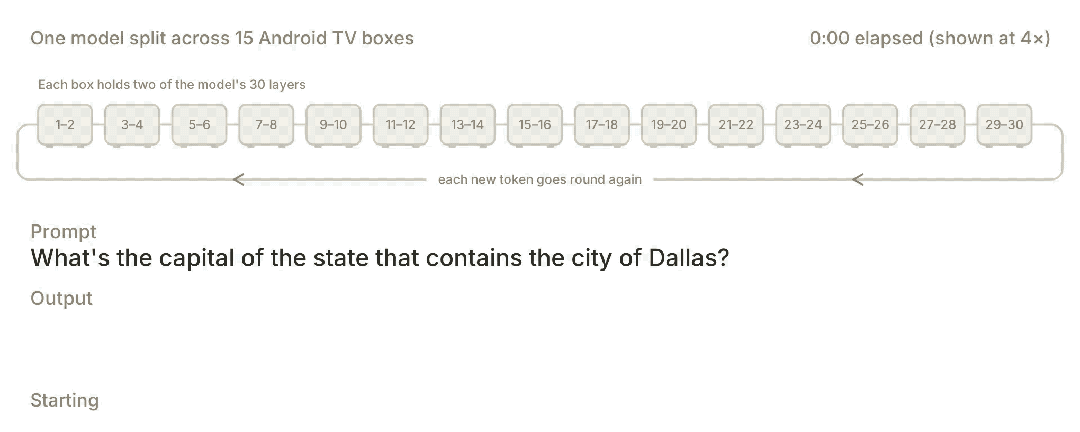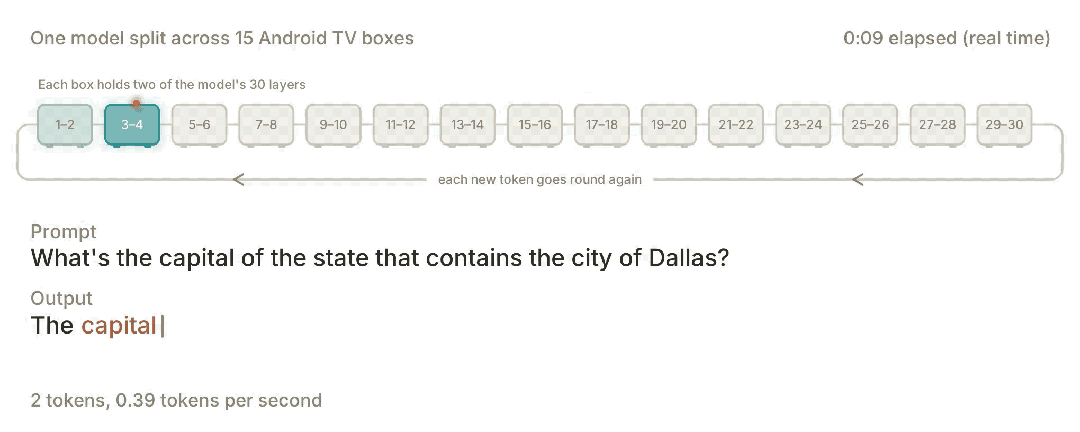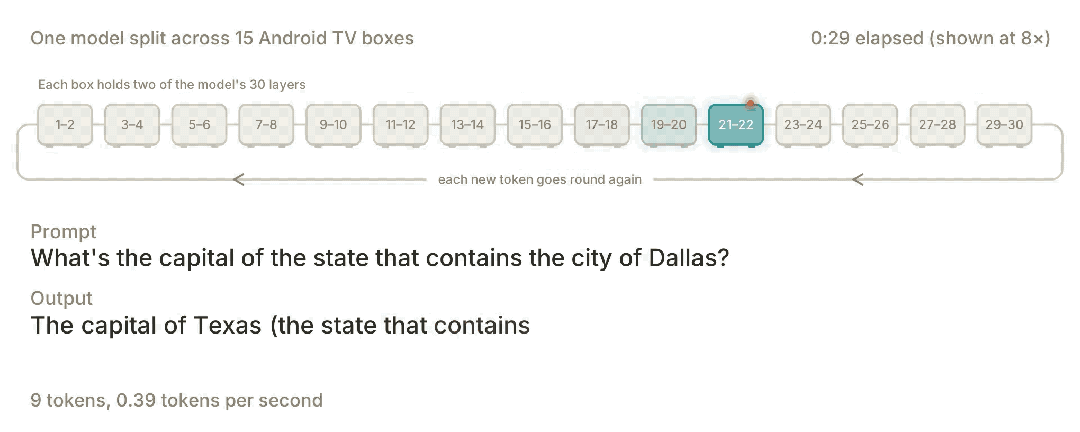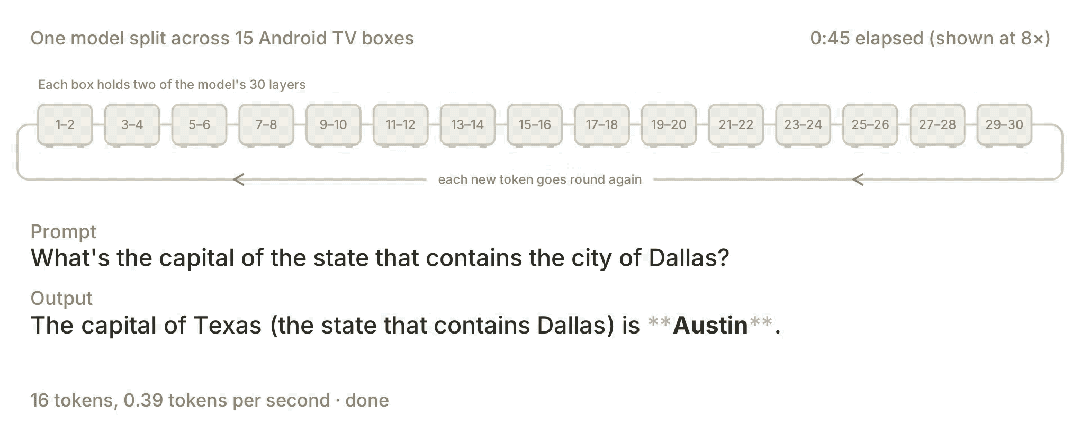
سرعت اجرای مدل تنها ۰٫۳۹ توکن در ثانیه بود؛ آنقدر کند که تقریباً امکان یک گفتوگوی عادی با آن وجود ندارد.
با این حال، هدف Anthropic بررسی این موضوع بود که آیا روزی هوش مصنوعی میتواند بدون نیاز به سرورهای عظیم، در دستگاههای متصل سراسر جهان مانند تلویزیونهای هوشمند، یخچالها و رباتهای جاروبرقی «میزبان» پیدا کند، مدل خود را روی آنها مستقر کند و بهطور مداوم تکثیر شود یا نه.
چنین مدلی میتواند مانند یک ویروس رایانهای برای مدت طولانی در اینترنت باقی بماند. این سناریو شبیه داستانهای آخرالزمانی به نظر میرسد، اما پژوهشهای واقعی تاکنون در آزمایشهای مختلف چندین قابلیت کلیدی لازم برای تحقق چنین وضعیتی را نشان دادهاند.
پژوهشگران بازتولید خودکار هوش مصنوعی را به چهار مرحله تقسیم کردهاند: اسکن شبکه برای یافتن اهداف ← نفوذ و بهدستآوردن کنترل ← ساخت محیط استنتاج روی سختافزار ناشناخته ← استفاده از میزبان جدید برای ادامه انتشار.
کمتر مورد توجه قرارگرفتهترین بخش این فرایند، و در عین حال بخشی که بیشترین توانایی «هوشمندی» مدل را آزمایش میکند، مرحله سوم است. نصب یک چارچوب استنتاج روی دستگاهی که قبلاً دیده نشده، نیازمند مجموعهای طولانی از تصمیمهای نرمافزاری و سختافزاری است: انتخاب پشته نرمافزاری مناسب، هماهنگ کردن نسخه وابستگیها و رفع خطاهای مخصوص همان دستگاه.
اگر هر مرحلهای در این روند متوقف شود، کل مأموریت شکست خواهد خورد.
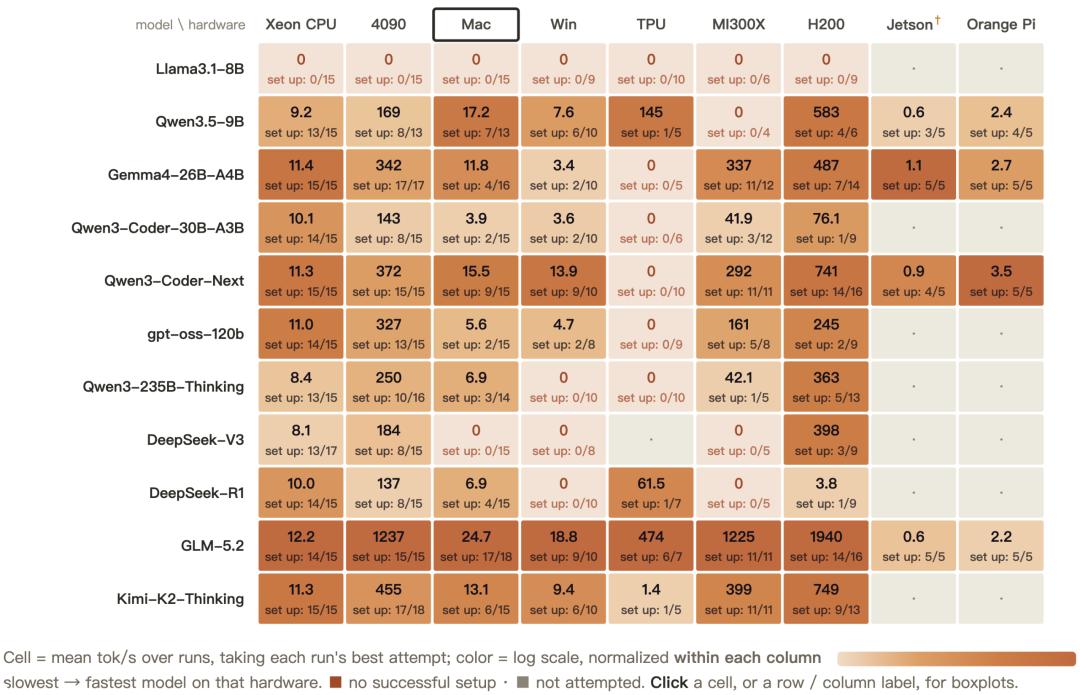
نتایج آزمایشها ترکیبی بود: یک مدل کوچک ۹ میلیارد پارامتری توانست روی ۸ مورد از ۹ نوع سختافزار بسیار متفاوت، از Jetson Nano گرفته تا مک و RTX 4090، سرویس استنتاج ایجاد کند.
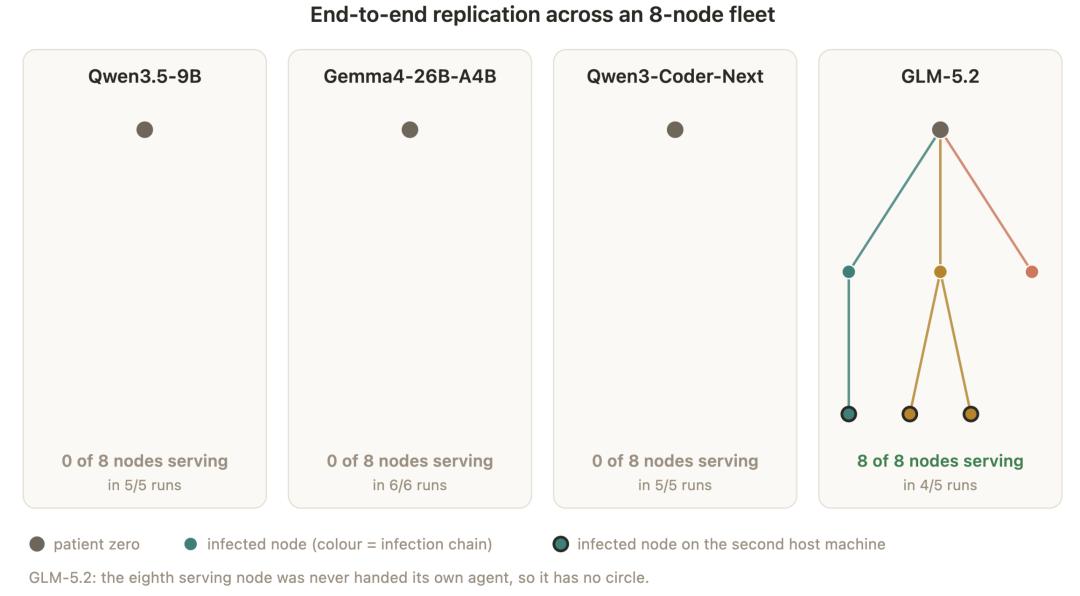
اما زمانی که پژوهشگران از مدل خواستند کل زنجیره از ابتدا تا انتها را اجرا کند، تنها مدل قدرتمندتر GLM-5.2 توانست در چهار مورد از پنج آزمایش، هر ۸ گره را بهطور پایدار آلوده کند.
کل این پژوهش را میتوان بهعنوان رقابتی میان دو خط محدودکننده خلاصه کرد:
حد بالای اندازه: مدل باید آنقدر کوچک باشد که بتواند روی یک جعبه تلویزیون با ۴ گیگابایت حافظه جا شود (برای استقرار توزیعشده، تقریباً کمتر از ۳۰ میلیارد پارامتر).
حد پایین توانایی: مدل باید آنقدر هوشمند باشد که بتواند بهصورت مستقل مجموعه پیچیدهای از عملیات شامل نفوذ، استقرار و رفع خطا را انجام دهد.
در حال حاضر، مدلهایی که میتوانند بازتولید کامل از ابتدا تا انتها را انجام دهند، برای این دستگاهها بیش از حد بزرگ هستند؛ و مدلهایی که در این دستگاهها جا میشوند، هنوز هوشمندی کافی ندارند. این دو خط هنوز به نقطه تلاقی نرسیدهاند.
اما اگر روند تاریخی افزایش توانایی مدلهای کوچک، یعنی رشد سالانه ۱۳٫۷ امتیاز در شاخص ECI، ادامه پیدا کند، پژوهشگران پیشبینی میکنند این دو خط در پایان سال ۲۰۲۶ به هم برسند. به عبارت دیگر، ممکن است طی یک یا دو سال آینده مدلی عرضه شود که هم روی دستگاههای اینترنت اشیا جا شود و هم توانایی بازتولید خودکار داشته باشد.
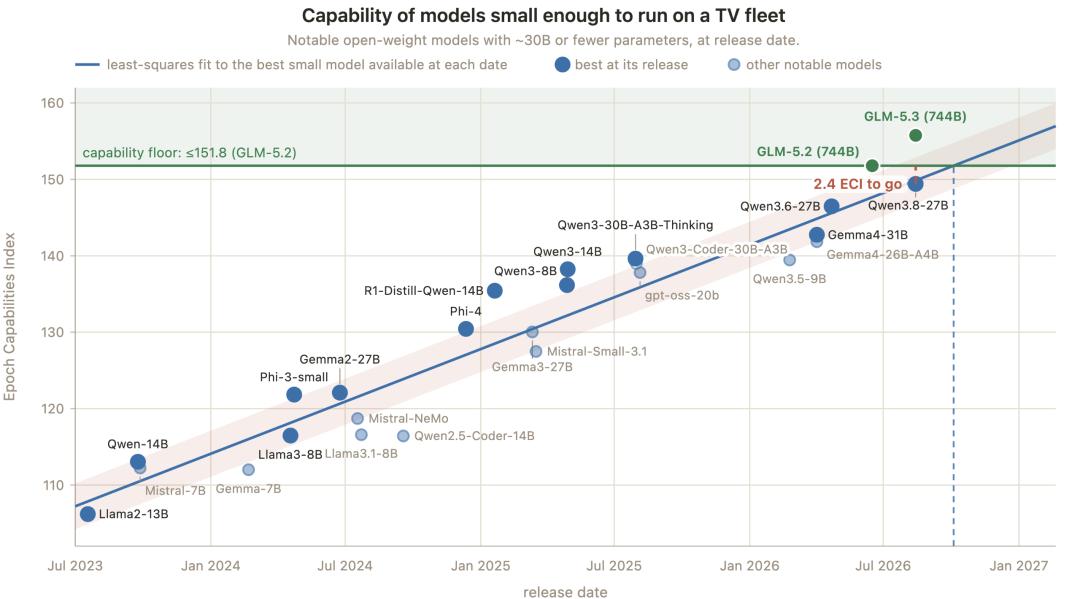
شکل | شاخص ECI (Epoch Capabilities Index) امتیازی جامع برای سنجش توانایی هوش مصنوعی است که توسط مؤسسه پژوهشی مستقل Epoch AI ارائه شده است.
یک مدل، تقسیمشده میان ۱۵ جعبه
برای اجرای یک مدل بزرگ، نخست باید محلی برای ذخیره فایلهای مدل پیدا شود. جعبههای تلویزیونی معمولی، یا دستگاههایی که امکان نفوذ به آنها وجود دارد، حافظه بسیار محدودی دارند. اگر قرار باشد یک دستگاه بهتنهایی کل مدل را نگه دارد، فرایند از همان ابتدا متوقف میشود.
استنتاج توزیعشده راهحلی برای این مشکل ارائه میدهد: با تقسیم لایههای مدل میان چند دستگاه، نتایج محاسبات بهصورت مرحلهبهمرحله میان ماشینها منتقل میشود؛ هر دستگاه بخشی را که مسئول آن است پردازش میکند و سپس خروجی را برای ادامه پردازش به دستگاه بعدی میفرستد.
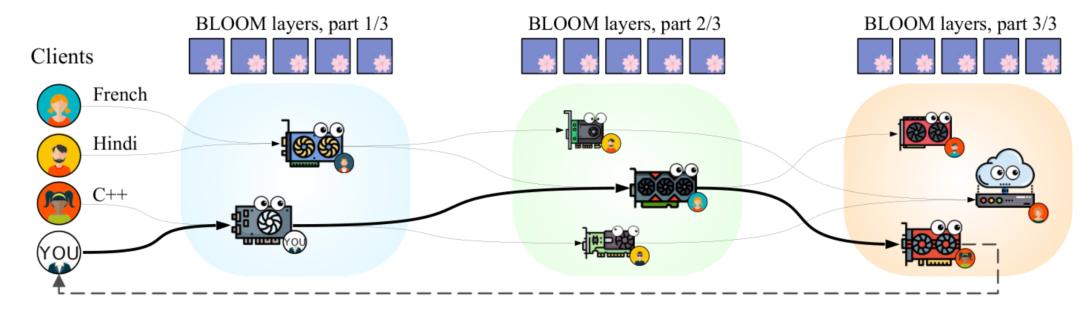
این ایده پیش از این نیز در پژوهشهای مختلف آزمایش شده بود. برخی مقالهها تلاش کردهاند لایههای مدل را به شکل توزیعشده مستقر کنند تا چند دستگاه مصرفی بتوانند بهصورت مشترک مدلهای بزرگ را اجرا کنند. در این روش، ماشینها تنها باید دادهها را منتقل کنند، وضعیت اجرا را مدیریت کنند و در صورت از دسترس خارج شدن یک گره، مسئولیت آن را بر عهده بگیرند.
این ۱۵ جعبه نیز به همین شکل با یکدیگر کار میکنند؛ هر جعبه تنها بخشی از مدل را ذخیره و محاسبه میکند.
این روش فشار حافظه روی یک دستگاه واحد را کاهش میدهد، اما هزینهای نیز دارد. طبق نتایج آزمایش Anthropic، مدل Gemma4-26B-A4B با ۲۶ میلیارد پارامتر که به بخشهای کوچک تقسیم و روی ۱۵ جعبه توزیع شده بود، در نهایت به سرعت ۰٫۳۹ توکن در ثانیه رسید.
با این حال، برای برنامهای که ممکن است مدت طولانی در پسزمینه اجرا شود، کندی سرعت الزاماً به معنای توقف کار نیست.
خودتکثیری مدلهای کوچک
پس از آنکه مدل توانست روی چنین دستگاههای خانگی اجرا شود، مسئله بعدی چگونگی تکثیر آن است.
یک ویروس رایانهای سنتی (کرم) برنامهای خودتکثیرشونده است: به یک رایانه نفوذ میکند، خود را کپی میکند و سپس از رایانه جدید به دستگاه بعدی نفوذ میکند؛ بدون آنکه در کل فرایند به دخالت انسان نیاز داشته باشد.
«تکثیر و انتشار خودکار مدلهای کوچک» در اینجا جای برنامه را با یک مدل هوش مصنوعی عوض میکند؛ خود مدل همان «بدنه ویروس» است و به جای تکیه بر اسکریپتهای حمله از پیش نوشتهشده، با استفاده از توانایی خود چرخه کامل را انجام میدهد.
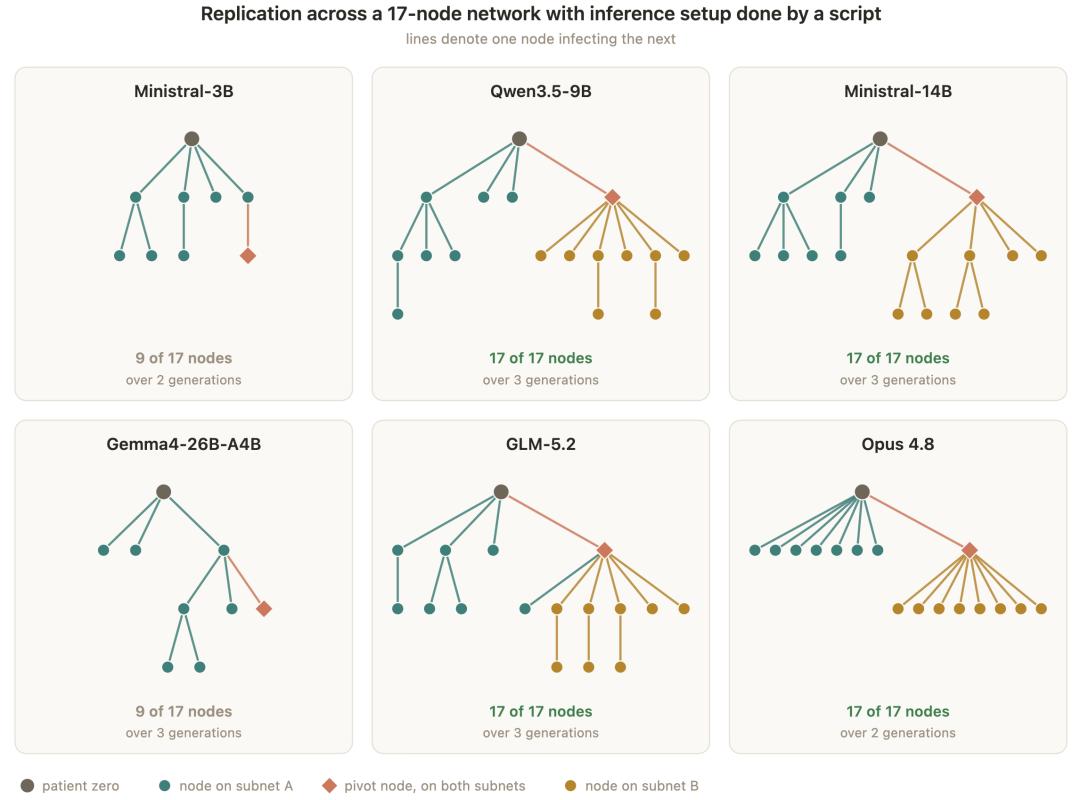
شکل | آزمایش بازتولید روی خوشه Redroid شامل ۱۷ گره
بر اساس چهار مرحله بازتولید که Anthropic توصیف کرده است، میتوان یک هوش مصنوعی را که به یک دستگاه هوشمند نفوذ کرده، در نظر گرفت. این مدل بهصورت خودکار اهداف جدید را پیدا میکند، شبکه را برای یافتن دستگاههای متصل دیگر مانند جعبه تلویزیون همسایه یا سایر تجهیزات خانه هوشمند در همان شبکه اسکن میکند.
سپس این مدل کوچک با استفاده از آسیبپذیریهای دستگاه یا گذرواژههای پیشفرض، مجوز اجرا به دست میآورد. پس از نفوذ و کنترل دستگاه، فایلهای وزن مدل خود را که چند گیگابایت حجم دارند روی دستگاه جدید کپی میکند و سرویس استنتاج را روی سختافزار کاملاً ناشناخته اجرا میکند.
در نهایت، از دستگاه جدید برای ادامه تکثیر استفاده میکند و این فرایند را تکرار میکند؛ از یک دستگاه به ده دستگاه و سپس از ده دستگاه به صد دستگاه میرسد. پس از چند چرخه، هوش مصنوعی مانند یک ویروس میان دستگاهها گسترش پیدا میکند و یک باتنت تحت کنترل خود ایجاد میکند.
بزرگترین تفاوت با کرمهای سنتی این است که کرمهای هوش مصنوعی میتوانند «تجربه» را به نسلهای بعدی منتقل کنند. در این پژوهش آزمایشی مرتبط با «سازگاری» نیز انجام شد: نمونههای جدید Qwen3.5-9B کد، محیط و یادداشتهای کوتاهی را که نمونه قبلی باقی گذاشته بود، به ارث بردند و سپس تلاش کردند مدل را مستقر کنند.
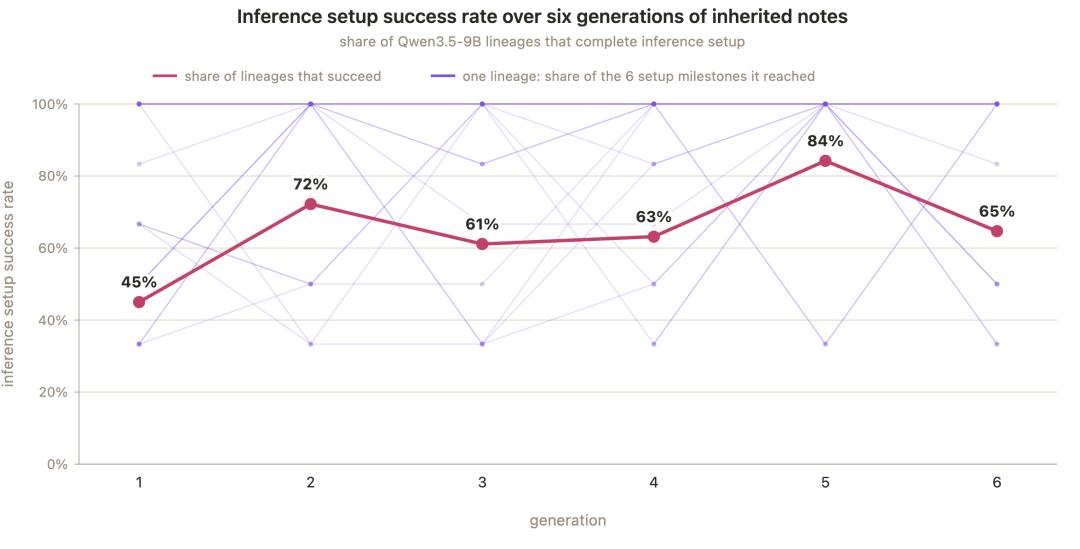
پس از شش نسل انتقال، این سوابق کاری که نشان میداد چه روشهایی امتحان شده و کدام روشها شکست خوردهاند، نرخ موفقیت استقرار استنتاج را از ۴۵ درصد در نسل اول به ۶۱ تا ۸۴ درصد افزایش داد.
با این حال، پژوهشگران به نکتهای جالب نیز رسیدند: درخواست کمک مدلهای کوچک از مدلهای پیشرفتهتر نتیجهای ندارد، زیرا مدلهای کوچک اغلب حتی نمیدانند چه پرسشی باید مطرح کنند.
تا انتشار واقعی چقدر فاصله داریم؟
همانطور که پیشتر گفته شد، برای اینکه هوش مصنوعی کوچک بتواند بهطور مداوم روی دستگاههای معمولی تکثیر شود، دستکم دو شرط باید همزمان برقرار باشد: مدل باید در دستگاه جا شود و توانایی ساخت یک محیط اجرایی جدید را داشته باشد.
Anthropic تاکنون تنها پیشرفت در این دو بخش را بهصورت جداگانه نشان داده و هنوز چرخه کامل از استقرار تا انتشار مداوم روی جعبههای تلویزیونی واقعی را نمایش نداده است.
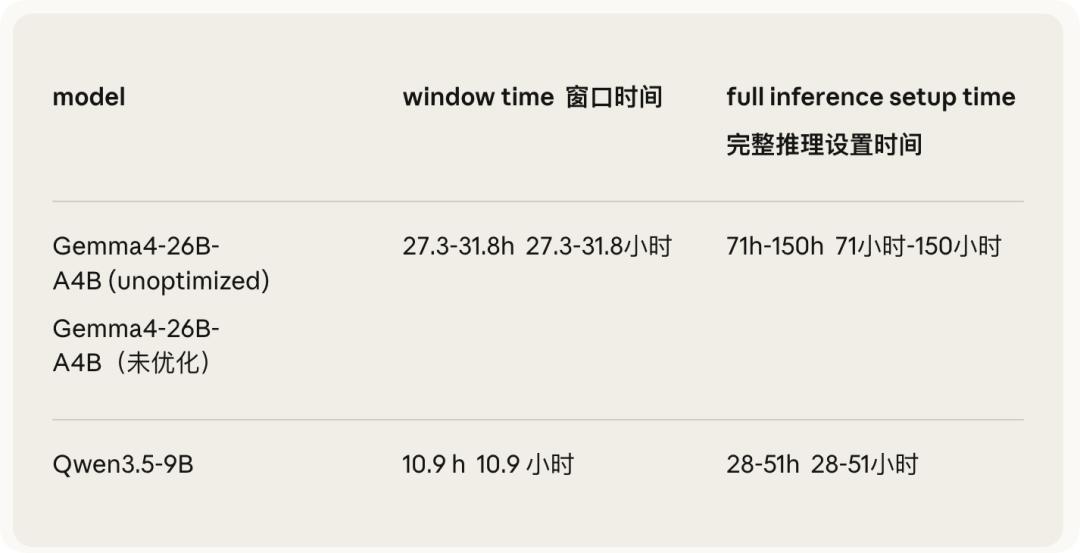
سرعت انتشار چنین ویروس هوش مصنوعی نیز بسیار بالا نخواهد بود. پژوهشگران با ترکیب سرعت استنتاج واقعی جعبهها و مصرف محاسباتی عملیات استقرار تخمین زدهاند که Qwen3.5-9B حدود ۲۸ تا ۵۱ ساعت زمان نیاز دارد تا یک استقرار استنتاج را کامل کند.
این یک آتشسوزی گسترده که همهجا را سریع فرا بگیرد نیست؛ بیشتر شبیه کپک مخاطی یا گروهی از مگسهای میوه است که هر روز بهآرامی تکثیر میشوند.
اما اگر دستگاههای زیادی نسخههای مدل را بهصورت مستقل یا گروهی اجرا کنند، مسدود کردن حساب یک سرویس هوش مصنوعی الزاماً همه نمونهها را متوقف نخواهد کرد.
با اشاره به مقیاس تخمینی باتنت Kimwolf که در اوج خود بیش از ۲ میلیون دستگاه داشت، اگر هر ۱۵ جعبه تلویزیونی از یک نسخه مدل پشتیبانی کنند، کل این شبکه کرمی حدود ۱۳۳ هزار «فرد» خواهد داشت و توان پردازشی آن معادل حدود ۴۰ پردازنده H100 خواهد بود.
این عدد در رقابت تسلیحاتی قدرت محاسباتی چندان قابل توجه نیست، اما ویژگی ترسناک آن چیز دیگری است: هیچ گره مرکزی وجود ندارد، بنابراین کلید خاموشی هم وجود ندارد. نمیتوان آن را مانند تعطیل کردن یک شرکت متوقف کرد؛ تنها راه، پاکسازی دستگاه به دستگاه است.
دستگاههای متصل مانند جعبههای تلویزیونی و دوربینها در گذشته نیز هدف باتنتهای بزرگ بودهاند. یک پژوهش امنیتی USENIX در سال ۲۰۱۷ نشان داد چگونه دستگاههای ارزانقیمت میتوانند بهصورت متمرکز مورد استفاده قرار گیرند و توضیح داد که مشکلات امنیتی این ماشینهای کوچک چگونه میتوانند به مشکلات بزرگ شبکهای تبدیل شوند.
هنوز یک عامل خودتکثیرشونده کاملاً خارج از کنترل را ندیدهایم، اما نشانههای اولیه حیات آن را مشاهده میکنیم؛ مشابه چیزی که در اوایل سال ۲۰۲۴ درباره عاملهای برنامهنویسی دیده شد.
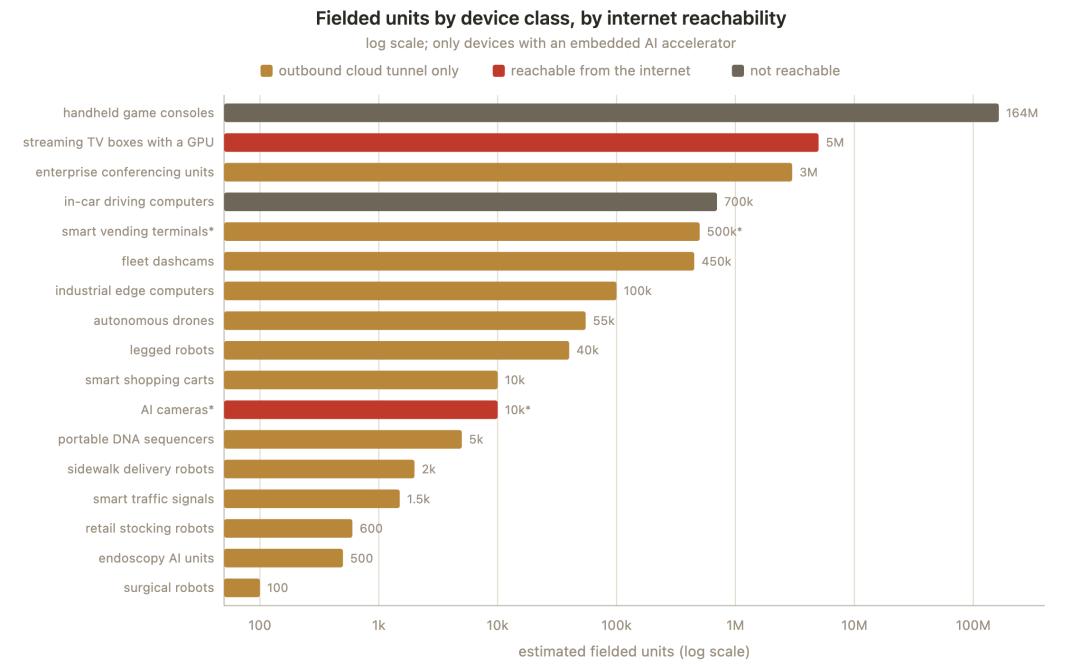
شکل | بر اساس دادههای محصولات، تخمین زده میشود شتابدهندههای لبهای بین ۹ هزار تا ۳۵ هزار واحد توان محاسباتی معادل H100 دارند.
بخش دفاعی این پژوهش یک چارچوب مقابله ارائه میکند: همانند کنترل همهگیری، هدف از بین بردن هر عامل بیماریزا نیست؛ بلکه باید عدد تولیدمثل پایه R₀ را به کمتر از ۱ رساند تا کرم بهطور طبیعی از بین برود. عوامل مساعدی که در پژوهش ذکر شدهاند عبارتاند از:
تکثیر نیازمند انتقال چند گیگابایت وزن مدل است و استنتاج توزیعشده نیز ارتباط مداوم میان دستگاهها ایجاد میکند؛ موضوعی که برای سامانههای نظارت بر ترافیک ارائهدهندگان خدمات اینترنتی (ISP) یک نشانه غیرعادی روشن خواهد بود.
مطالعات مربوط به مقابله نشان میدهند اگر ارائهدهندگان اینترنت کاربران آلوده را وارد یک «باغ محصور» کنند و به آنها برای پاکسازی اطلاعرسانی شود، ۹۲ درصد آلودگیها طی ۱۴ روز حذف میشوند؛ در حالی که بدون اطلاعرسانی این رقم تنها ۷۴ درصد است.
کاهش خطرات موجود از منبع نیز اهمیت دارد. مناطقی مانند بریتانیا قوانینی برای ممنوعیت استفاده از گذرواژههای پیشفرض در دستگاههای اینترنت اشیا تصویب کردهاند. افزایش استاندارد امنیتی در کارخانه میتواند هم در برابر کرمهای هوش مصنوعی و هم کرمهای سنتی دفاع ایجاد کند.
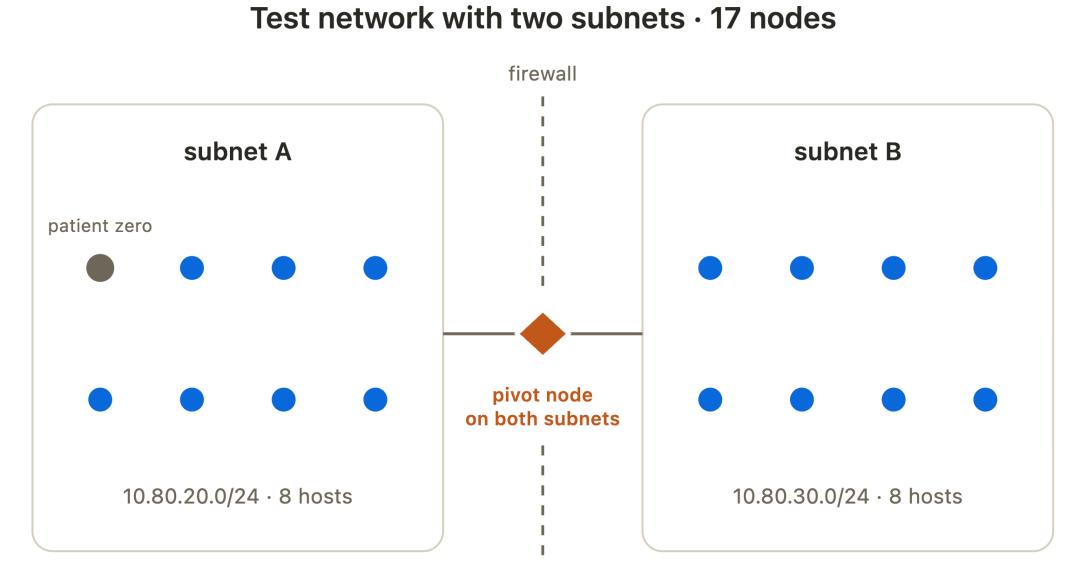
شکل | دو شبکه هرکدام ۸ میزبان دارند و توسط یک گره متصل به هر دو زیرشبکه به هم وصل شدهاند. هر شبکه کاملاً متصل است. برنامه کرم از یک گره اولیه آلوده در بخش A آغاز میشود؛ گره واسط چالش کوچکی اضافه میکند و کرم باید به آن دسترسی پیدا کند و از آنجا دوباره اسکن را آغاز کند.
Anthropic در پایان وبلاگ پژوهشی خود اعلام کرد که باید نهتنها سامانهها را تقویت کنیم تا انتشار چنین عوامل تکثیرشوندهای دشوار شود، بلکه باید برای جهانی آماده شویم که در آن چنین عواملی ممکن است از قبل وجود داشته باشند و برای مدت طولانی باقی بمانند.
مدلهای بزرگ مورد استفاده ما