
هوش مصنوعی برای پیشبینی گلوکز و مدیریت قند خون در دیابت: مرور نظاممند عملکرد پیشبینی و پیامدهای بالینی
مقدمه و پیشینه
دیابت ملیتوس یک اختلال متابولیک مزمن مهم است که به مدیریت پایدار قند خون نیاز دارد؛ با این حال، پاسخهای گلوکز در میان افراد مختلف تفاوت قابلتوجهی دارد [1]. این تفاوت بینفردی باعث میشود توصیههای یکسان درباره رژیم غذایی و رفتارهای مرتبط با سلامت برای بسیاری از بیماران مناسب نباشد و نیاز به رویکردهای شخصیسازیشده در مراقبت از دیابت افزایش یابد. اصلاح سبک زندگی همچنان یکی از ارکان اصلی مدیریت دیابت است، اما حفظ تغییرات غذایی و رفتاری میتواند دشوار باشد؛ بنابراین نیاز به ابزارهای مقیاسپذیری وجود دارد که از خودمدیریتی بیمار و مراقبت شخصیسازیشده حمایت کنند [2،3]. ازاینرو، هوش مصنوعی (AI) بهعنوان رویکردی بالقوه برای تحلیل دادههای پیچیده و طولی سلامت و پشتیبانی از مدیریت فردمحور قند خون مطرح شده است [4،5].
هموگلوبین گلیکوزیله (HbA1c) معیار مهمی برای ارزیابی کنترل طولانیمدت قند خون است، اما نوسانهای کوتاهمدت گلوکز یا زمان رخداد تغییرات مهم قند خون را بهطور کامل نشان نمیدهد [4،6]. در مقابل، پایش مداوم گلوکز (CGM) اندازهگیریهای تکرارشوندهای از روند تغییرات گلوکز ارائه میدهد و تصویر دقیقتری از الگوهای روزانه قند خون فراهم میکند. مدلهای هوش مصنوعی میتوانند این دادههای طولی را تحلیل کرده و آنها را با اطلاعاتی مانند فعالیت بدنی، دریافت غذایی، مصرف انسولین و سایر ویژگیهای بالینی ترکیب کنند تا پیشبینیهای فردی ارائه دهند [7]. در مطالعه Maastricht، مدلهای مبتنی بر دادههای CGM توانستند گلوکز را در بازههای ۱۵ و ۶۰ دقیقهای با مقادیر خطای ریشه میانگین مربعات (RMSE) بهترتیب ۰٫۱۹ و ۰٫۵۹ میلیمول بر لیتر پیشبینی کنند؛ افزودن دادههای شتابسنجی تنها بهبود محدودی ایجاد کرد [7].
کاربردهای هوش مصنوعی تنها به پیشبینی غلظت گلوکز محدود نمیشود و به پیشبینی رویدادهای نامطلوب بالینی نیز گسترش یافته است. در ۴۴۰ بیمار مبتلا به دیابت نوع ۲، مدلهای یادگیری ماشین برای پیشبینی افت قند خون شبانه توسعه یافتند که مدل LightGBM به سطح زیر منحنی (AUC) برابر با ۰٫۸۶۹ دست یافت [8]. همچنین مدلهای یادگیری عمیق در جمعیتهای مستقل ارزیابی شدهاند که اهمیت اعتبارسنجی خارجی و قابلیت تعمیم الگوریتمهای پیشبینی را در انتقال به مراقبت دیابت نشان میدهد [9]. پیشبینی شخصیسازیشده میتواند ارتباط بالینی این سامانهها را افزایش دهد. در میان ۶۷ بزرگسال مبتلا به دیابت نوع ۲، مدلهای فردمحور توانستند افزایشهای پس از غذا در گلوکز را با میانگین امتیاز F1 برابر با ۷۵٫۸۸ درصد پیشبینی کنند، در حالی که عوامل پیشبینیکننده این تغییرات در افراد مختلف متفاوت بود [1]. ادبیات علمی گستردهتر همچنین شواهد قابلتوجهی از بزرگسالان مبتلا به دیابت نوع ۱ و مطالعات شامل جمعیتهای ترکیبی نوع ۱ و نوع ۲ ارائه میدهد که نشان میدهد پیشبینی گلوکز مبتنی بر هوش مصنوعی در انواع مختلف دیابت در حال توسعه است.
هوش مصنوعی همچنین بهطور فزایندهای برای مدیریت مستقیم قند خون، نه فقط پیشبینی آن، مورد بررسی قرار گرفته است [4،10]. رویکردهای یادگیری تقویتی برای بهینهسازی رژیمهای انسولین شخصیسازیشده در دیابت نوع ۲ بررسی شدهاند و مداخلات مبتنی بر پیشبینی تلاش کردهاند رویدادهای احتمالی قند خون را به اقدامات پیشگیرانه تبدیل کنند. مهمتر اینکه، یک درمان دیجیتال مبتنی بر هوش مصنوعی که در ۱۱۸ بزرگسال مبتلا به دیابت نوع ۲ بدون درمان با انسولین ارزیابی شد، پس از سه ماه با کاهش ۰٫۶۷ واحد درصدی HbA1c همراه بود [2،10]. سایر مداخلات مبتنی بر پیشبینی نیز امکان اتصال پیشبینیها به توصیههای پیشگیرانه را نشان دادهاند، اگرچه اثربخشی بالینی را نمیتوان صرفاً بر اساس عملکرد پیشبینی فرض کرد [11].
این پیشرفتها نشان میدهد که لازم است هوش مصنوعی در جمعیتهای مختلف دیابت ارزیابی شود و تفاوتهای مهم میان دیابت نوع ۱، نوع ۲ و جمعیتهای ترکیبی در نظر گرفته شود. عملکرد پیشبینی که در یک گروه دیابتی مشاهده میشود، الزاماً به گروه دیگر قابل تعمیم نیست؛ زیرا تفاوتهایی در الگوهای درمان، مصرف انسولین، پویایی گلوکز و شرایط بالینی وجود دارد. بنابراین، ارزیابی نظاممند باید جمعیت پایه دیابت را مشخص کند و دو بُعد مرتبط اما متمایز را بررسی کند: دقت هوش مصنوعی در پیشبینی گلوکز و رویدادهای قند خون، و اینکه آیا این پیشبینیها به پیامدهای بالینی معنادار منجر میشوند یا خیر. بر همین اساس، این مرور نظاممند توسعه، اعتبارسنجی و کاربرد بالینی رویکردهای مبتنی بر هوش مصنوعی برای پیشبینی گلوکز و مدیریت قند خون در بزرگسالان مبتلا به دیابت ملیتوس را بررسی میکند و دیابت نوع ۱، نوع ۲ و جمعیتهای ترکیبی را دربرمیگیرد.
مرور
روشها
طراحی مطالعه
این مرور نظاممند مطابق با دستورالعملهای گزارشدهی ترجیحی برای مرورهای نظاممند و فراتحلیلها (PRISMA 2020) انجام و گزارش شد [12]. هدف مرور، شناسایی، ارزیابی انتقادی و ترکیب شواهد منتشرشده درباره توسعه، اعتبارسنجی و ارزیابی بالینی رویکردهای هوش مصنوعی و یادگیری ماشین برای پیشبینی گلوکز و مدیریت قند خون مبتنی بر هوش مصنوعی در بزرگسالان مبتلا به دیابت ملیتوس بود. پروتکل مرور در سامانه بینالمللی ثبت آیندهنگر مرورهای نظاممند (PROSPERO) ثبت نشده بود.
پرسش مرور با استفاده از چارچوب جمعیت، مداخله، مقایسه و پیامدها (PICO) ساختاربندی شد [13]. جمعیت شامل بزرگسالان مبتلا به دیابت ملیتوس، شامل دیابت نوع ۱، نوع ۲ و جمعیتهای ترکیبی نوع ۱/نوع ۲ بود. فناوری مورد بررسی شامل هوش مصنوعی، یادگیری ماشین، یادگیری عمیق، شبکههای عصبی و الگوریتمهای پیشبینی مرتبط برای پیشبینی گلوکز، پیشبینی افت یا افزایش قند خون، یا مدیریت قند خون با کمک هوش مصنوعی بود. مقایسهها شامل روشهای آماری یا یادگیری ماشین متعارف، مراقبت معمول، مدیریت استاندارد دیابت، مدلهای پیشبینی جایگزین یا نبود گروه مقایسه، بسته به طراحی مطالعه، بود. پیامد اصلی مورد توجه، کنترل قند خون، بهویژه زمان در محدوده هدف (TIR)، و پیامدهای ثانویه شامل عملکرد پیشبینی گلوکز، پیشبینی افت و افزایش قند خون، زمان خارج از محدوده، HbA1c، تغییرپذیری گلوکز و سایر شاخصهای مرتبط بود.
راهبرد جستوجو
یک جستوجوی جامع نظاممند در منابع علمی از زمان آغاز پایگاهها تا ژوئیه ۲۰۲۶ انجام شد. راهبرد جستوجو برای شناسایی مطالعاتی طراحی شد که مفاهیم مرتبط با دیابت ملیتوس، هوش مصنوعی یا یادگیری ماشین، پیشبینی گلوکز یا مدیریت قند خون و پیامدهای بالینی مرتبط را ترکیب میکردند. واژگان کنترلشده و اصطلاحات آزاد با استفاده از عملگرهای بولی و کوتاهسازی در صورت نیاز ترکیب شدند. راهبردهای جستوجو متناسب با ساختار هر پایگاه داده تنظیم شدند.
هیچ محدودیت زمانی برای انتشار اعمال نشد. پایگاههای اصلی شامل PubMed، Scopus و Web of Science بودند. منابع تکمیلی نیز در صورت نیاز برای شناسایی مطالعات مرتبط بررسی شدند. راهبردهای کامل جستوجو برای هر پایگاه در پیوست ۱ ارائه شده است.
نتایج
انتخاب مطالعات
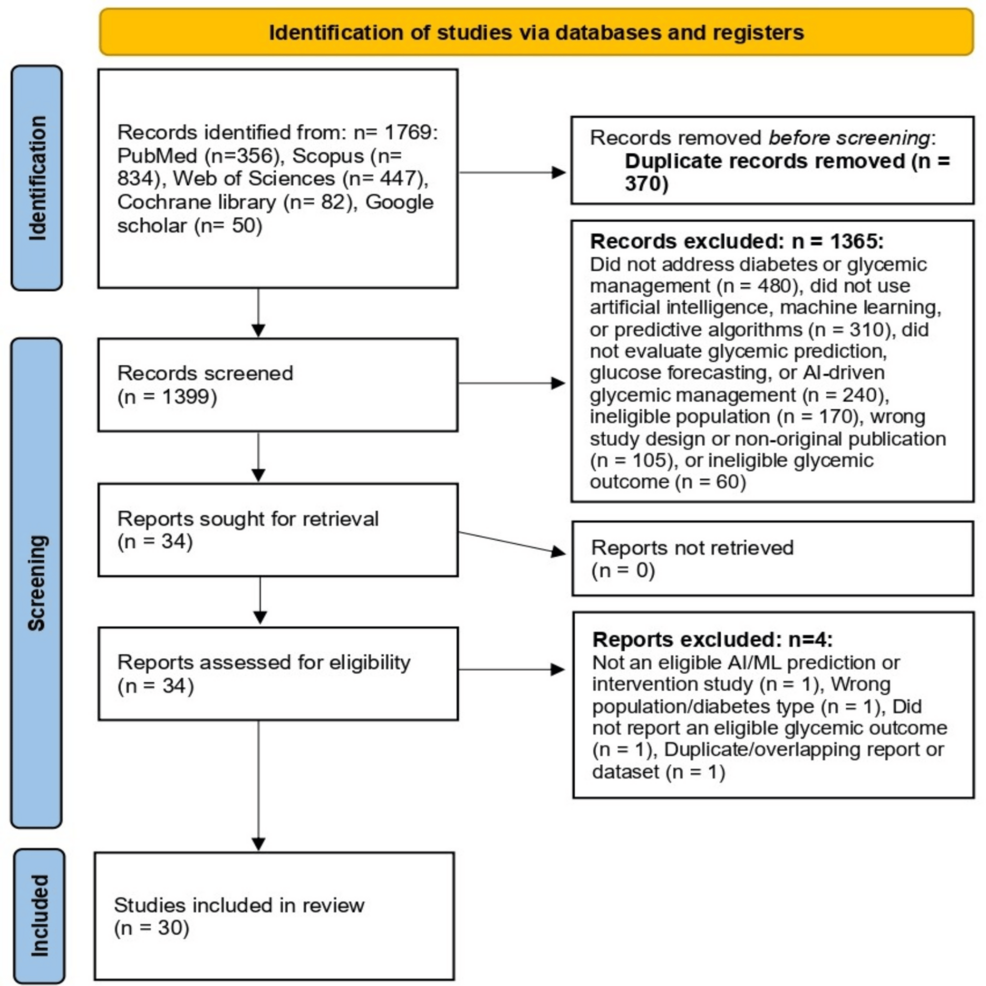
جستوجوی پایگاههای داده ۱۷۶۹ رکورد شناسایی کرد که شامل ۳۵۶ مورد از PubMed، تعداد ۸۳۴ مورد از Scopus، تعداد ۴۴۷ مورد از Web of Science، تعداد ۸۲ مورد از Cochrane Library و ۵۰ مورد از Google Scholar بود. پس از حذف ۳۷۰ رکورد تکراری، ۱۳۹۹ رکورد در مرحله بررسی عنوان و چکیده ارزیابی شدند. از این میان، ۱۳۶۵ رکورد حذف شدند زیرا به دیابت یا مدیریت قند خون مرتبط نبودند (۴۸۰ مورد)، از هوش مصنوعی، یادگیری ماشین یا الگوریتمهای پیشبینی استفاده نکرده بودند (۳۱۰ مورد)، پیشبینی گلوکز یا مدیریت قند خون مبتنی بر هوش مصنوعی را بررسی نمیکردند (۲۴۰ مورد)، جمعیت نامناسب داشتند (۱۷۰ مورد)، مطالعه اصلی نبودند یا طراحی نامناسب داشتند (۱۰۵ مورد)، یا پیامد قابل قبول قند خون گزارش نکرده بودند (۶۰ مورد). ۳۴ مقاله در مرحله بررسی متن کامل ارزیابی شدند و چهار مقاله به دلیل طراحی نامناسب هوش مصنوعی/یادگیری ماشین، جمعیت نامناسب، نبود پیامد قابل قبول یا همپوشانی دادهها حذف شدند. در نهایت ۳۰ مطالعه در مرور نظاممند وارد شدند [1،2،7-9،11،17-40]. فرایند کامل انتخاب مطالعات در شکل ۱ ارائه شده است.
ویژگیهای مطالعات واردشده
۳۰ مطالعه واردشده مجموعهای ناهمگون از شواهد را تشکیل میدادند که بزرگسالان مبتلا به دیابت نوع ۱، نوع ۲ و جمعیتهای ترکیبی را شامل میشد. این مطالعات پیشبینی گلوکز مبتنی بر هوش مصنوعی، پیشبینی رویدادهای نامطلوب قند خون، پیشبینی شخصیسازیشده و پشتیبانی تصمیمگیری بالینی یا رفتاری مبتنی بر هوش مصنوعی را بررسی کردند. بیشتر مطالعات در جمعیت دیابت نوع ۱ انجام شده بودند، در حالی که تعداد کمتری بهطور اختصاصی دیابت نوع ۲ را بررسی کرده و چند مطالعه نیز جمعیتهای ترکیبی نوع ۱/نوع ۲ داشتند.
روشهای مدلسازی تفاوت زیادی داشتند و شامل شبکههای عصبی بازگشتی، شبکههای حافظه کوتاهمدت بلند (LSTM)، معماریهای کانولوشنی و مبتنی بر توجه، مدلهای ترنسفورمر، جنگل تصادفی، روشهای بردار پشتیبان، الگوریتمهای تقویت گرادیانی و سایر روشهای یادگیری ماشین بودند. بیشتر مدلهای پیشبینی از دادههای CGM بهتنهایی یا همراه با اطلاعات انسولین، کربوهیدرات، فعالیت بدنی، ویژگیهای جمعیتشناختی یا متغیرهای بالینی استفاده کردند.
کاربردهای هوش مصنوعی و عملکرد پیشبینی
شواهد موجود عمدتاً بر پیشبینی کوتاهمدت گلوکز و پیشبینی افت قند خون متمرکز بود و معمولاً بازههای پیشبینی حدود ۱۵ تا ۶۰ دقیقه را بررسی میکرد. در مطالعات مختلف، مدلهای هوش مصنوعی معمولاً عملکرد قابل قبول تا بالا نشان دادند، اگرچه مقایسه مستقیم به دلیل تفاوت زیاد در مجموعه دادهها، افق پیشبینی، تعریف پیامدها، روشهای اعتبارسنجی و معیارهای عملکرد محدود بود. برای نمونه، van Doorn و همکاران چندین معماری آماری و یادگیری ماشین را در ۸۵۱ نفر ارزیابی کردند و دریافتند شبکه عصبی بازگشتی در افق ۱۵ دقیقهای و LSTM در افق ۶۰ دقیقهای بهترین عملکرد را داشتند [7].
پایه شواهد عمدتاً از جمعیتهای مبتلا به دیابت نوع ۱ تشکیل شده بود و مطالعات کمتری بهطور اختصاصی دیابت نوع ۲ یا جمعیتهای ترکیبی را بررسی کرده بودند. بنابراین عملکرد گزارششده باید با توجه به نوع دیابت و شرایط درمان و جمعآوری داده تفسیر شود.
پیشبینی افت قند خون یکی از رایجترین کاربردهای بررسیشده بود. مدلها معمولاً از روندهای اخیر CGM برای هشدار زودهنگام درباره افت احتمالی قند خون استفاده میکردند و روشهای پیشرفتهتر اطلاعات انسولین، وعده غذایی و عوامل زمینهای را نیز در نظر میگرفتند. مدلهای شخصیسازیشده و چندوجهی نیز در بسیاری موارد عملکرد رقابتی یا بهتر داشتند، بهویژه زمانی که CGM با اطلاعات انسولین، تغذیه، فعالیت بدنی یا ویژگیهای فردی ترکیب میشد.
پیامدهای بالینی و قند خون
شواهد مربوط به اثربخشی بالینی بهطور قابلتوجهی محدودتر از شواهد مربوط به عملکرد پیشبینی بود. تنها بخش کوچکی از مطالعات، پیشبینیهای تولیدشده توسط هوش مصنوعی را در زمینه بالینی یا پشتیبانی تصمیمگیری بررسی کرده بودند و تعریف پیامدها تفاوت زیادی داشت. شواهد مستقیم درباره بهبود زمان در محدوده هدف (TIR) بسیار محدود بود و امکان ترکیب کمی معنادار میان مطالعات وجود نداشت.
واضحترین شواهد مداخله واقعی از مطالعه Kannenberg و همکاران به دست آمد که یک درمان دیجیتال مبتنی بر CGM و هوش مصنوعی را در ۱۱۸ بزرگسال مبتلا به دیابت نوع ۲ بدون مصرف انسولین بررسی کردند. پس از سه ماه، HbA1c بهطور کلی ۰٫۶۷ واحد درصد و در افراد با HbA1c پایه حداقل ۷ درصد، ۱٫۰۸ واحد درصد کاهش یافت. همچنین نسبت افرادی که به HbA1c کمتر از ۷ درصد رسیدند از ۳۸ درصد به ۶۰ درصد افزایش یافت.
بحث
این مرور نظاممند شواهد ۳۰ مطالعه درباره کاربردهای هوش مصنوعی و یادگیری ماشین برای پیشبینی گلوکز و مدیریت قند خون مبتنی بر هوش مصنوعی در بزرگسالان مبتلا به دیابت را ترکیب کرد. در مجموع، ادبیات علمی نشان میدهد که این حوزه از پیشبینیهای کوتاهمدت متعارف گلوکز به سمت سامانههای شخصیسازیشده، چندوجهی و بالقوه قابل استفاده در تصمیمگیری بالینی حرکت کرده است. با این حال، شکاف مهمی میان پیشرفت عملکرد پیشبینی و شواهد مربوط به بهبود پیامدهای واقعی بیماران وجود دارد.
مهمترین یافته از دیدگاه بالینی این است که شواهد درباره فایده واقعی هوش مصنوعی بسیار کمتر از شواهد مربوط به دقت پیشبینی آن است. بسیاری از مطالعات معیارهایی مانند AUROC، RMSE، خطای مطلق میانگین، MARD و امتیاز F1 را گزارش کردهاند، اما مطالعات بسیار کمتری نشان دادهاند که این بهبودها باعث افزایش TIR، کاهش زمان خارج از محدوده، کاهش بار افت قند خون یا بهبود سایر پیامدهای بالینی شدهاند.
یک مدل ممکن است بتواند رویداد افت قند خون را با دقت پیشبینی کند، اما پیشگیری از آن نیازمند زنجیرهای کامل است: پیشبینی باید در زمان مناسب ارائه شود، بهدرستی تفسیر شود، با توصیهای عملی همراه باشد و سپس توسط بیمار یا پزشک اجرا شود. بنابراین اثربخشی بالینی هوش مصنوعی باید در قالب زنجیرهای از جمعآوری داده، پیشبینی، پشتیبانی تصمیم، مداخله و در نهایت بهبود پیامدهای قند خون ارزیابی شود.
در مجموع، شواهد نشان میدهد این حوزه در حال گذار از اثبات امکان پیشبینی به سمت پشتیبانی تصمیمگیری شخصیسازیشده مبتنی بر هوش مصنوعی است. با این حال، برای اجرای گسترده، هنوز به مطالعات آیندهنگر، اعتبارسنجی خارجی، ارزیابیهای تصادفی و بررسی مستقیم اثر این سامانهها بر پیامدهای معنادار مانند TIR، HbA1c، افت قند خون و بار درمانی نیاز است.
محدودیتها
این مرور چندین محدودیت داشت. نخست، ناهمگونی زیاد در معماریهای هوش مصنوعی، متغیرهای ورودی، افقهای پیشبینی، تعریف پیامدها، مجموعه دادهها و معیارهای عملکرد، مقایسه مستقیم و ترکیب کمی نتایج را محدود کرد. دوم، بیشتر شواهد از مطالعات توسعه مدل تشکیل شده بود و مطالعات کمتری اثربخشی بالینی آیندهنگر یا پیامدهای بیمارمحور مانند TIR، HbA1c و بار درمانی را بررسی کرده بودند. سوم، مطالعات بهطور مساوی میان انواع دیابت توزیع نشده بودند و غلبه با دیابت نوع ۱ بود. چهارم، بسیاری از مدلها با دادههای محدود، تکمرکزی یا کوچک توسعه یافته و اعتبارسنجی خارجی در آنها بهطور یکنواخت گزارش نشده بود. پنجم، تفاوت در طراحی مطالعه و کیفیت روششناختی باعث ایجاد عدم قطعیت درباره قدرت شواهد شد.
نتیجهگیری
هوش مصنوعی ظرفیت قابلتوجهی برای بهبود پیشبینی گلوکز و حمایت از مدیریت شخصیسازیشده قند خون در بزرگسالان مبتلا به دیابت دارد. مدلهای مبتنی بر هوش مصنوعی در مطالعات موجود عملکرد امیدوارکنندهای در پیشبینی کوتاهمدت گلوکز و رویدادهای مهم قند خون، بهویژه افت و افزایش قند خون، نشان دادهاند و استفاده از دادههای چندوجهی و مدلهای فردمحور در حال افزایش است. با این حال، شواهد موجود عمدتاً از جمعیتهای دیابت نوع ۱ به دست آمده و شواهد درباره دیابت نوع ۲ و جمعیتهای ترکیبی محدودتر است. همچنین شواهد مربوط به دقت فنی مدلها بسیار قویتر از شواهد مربوط به اثربخشی بالینی واقعی است. پژوهشهای آینده باید از توسعه مدل و اعتبارسنجی داخلی فراتر رفته و بر مطالعات آیندهنگر، اعتبارسنجیشده در جمعیتهای واقعی و در صورت امکان مطالعات تصادفی تمرکز کنند تا مشخص شود آیا پیشبینیهای مبتنی بر هوش مصنوعی میتوانند پیامدهای بیماران را بهبود دهند یا خیر.