
آنتروپیک با تیمی ۷ نفره در ۵ ماه جایگزینی نوآورانه برای گیت توسعه داد
گیت (Git)، ابزار کنترل نسخهای که ۲۰ سال است بر دنیای برنامهنویسی سلطه دارد، بهطور غیرمنتظرهای با یک سیستم جدید که خود شرکت آنتروپیک ساخته، جایگزین شده است.
تمام این فرایند تنها با حضور ۷ مهندس و با مشارکت عمیق کلود در توسعه انجام شد.
آنتروپیک طی ۵ ماه، سیستم کنترل کد منبع داخلی خود با نام Scion، ابزار بازبینی کد پشتیبان آن با نام Antique و چندین سیستم مرتبط دیگر را از صفر توسعه داد و مهاجرت کامل مخزن یکپارچه (Monorepo) خود از گیت به Scion را به پایان رساند.
این اتفاق چه معنایی دارد؟ گروهی کوچک از افراد با کمک هوش مصنوعی تنها در چند ماه توانستهاند سیستم جدیدی بسازند که مستقیماً جایگزین گیتی شود که شرکت سالها در داخل خود از آن استفاده میکرد. این دستاورد بسیار چشمگیر است و بهطور طبیعی این پرسش را مطرح میکند که آیا باید گفت «گیت، خداحافظ».
چرا آنتروپیک تصمیم گرفت جایگزینی برای گیت بسازد؟
دلیل ساده است: مقیاس برنامهنویسی با هوش مصنوعی در آنتروپیک آنقدر بزرگ شده که زیرساخت توسعه قبلی دیگر بهسختی میتوانست پاسخگو باشد.
دادههای منتشرشده از سوی آنتروپیک نشان میدهد این شرکت در ماه مه امسال بهطور میانگین روزانه حدود ۲۵۰۰ تغییر کد را ادغام میکرد. تا ماه سپتامبر، این رقم از ۳۰ هزار تغییر در روز عبور کرده بود؛ یعنی تنها طی ۴ ماه بیش از ۱۲ برابر افزایش یافته است. آنتروپیک انتظار دارد این رشد در کوتاهمدت متوقف نشود. تقاضای بالقوه برای ادغام کد تقریباً سقفی ندارد و هر بار که یک گلوگاه برطرف میشود، خروجی کد نیز افزایش پیدا میکند.
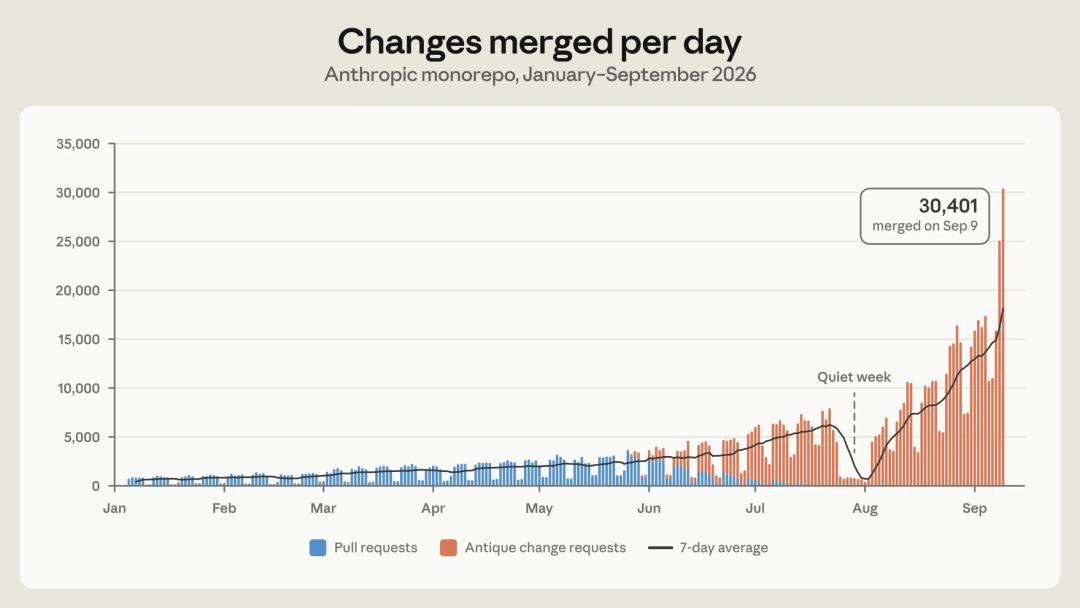
آنتروپیک تحت فشارهای عملیاتی واقعی، سیستم کنترل نسخه داخلی خود را توسعه داد و طی پنج ماه کل مخزن یکپارچه خود را از گیت به Scion منتقل کرد.
این شرکت جزئیات کامل این فرایند را در تازهترین پست وبلاگی خود توضیح داده است.
۱. مخزن یکپارچهای که دائماً در حال بزرگتر شدن است
پیش از معرفی Scion، باید توضیح داد که حجم کاری آنتروپیک چه ویژگی خاصی دارد. میزان استفاده این شرکت از کلود برای نوشتن نرمافزار بسیار فراتر از بیشتر شرکتهاست و ابزارهایی که برای مقیاس توسعه انسانی طراحی شدهاند، در چنین شرایطی با مشکل مواجه میشوند. کنترل کد منبع تنها یکی از نمونههای این مسئله است.
آنتروپیک انتظار ندارد بسیاری از شرکتها در کوتاهمدت با چنین مشکلی روبهرو شوند. اما با فراگیرتر شدن ابزارهای برنامهنویسی مبتنی بر هوش مصنوعی، شرکتهای دیگر نیز ممکن است بهزودی با گلوگاههای مشابهی مواجه شوند؛ به همین دلیل آنتروپیک تصمیم گرفت تجربه طراحی و توسعه Scion را منتشر کند.
گیت یک سیستم غیرمتمرکز است. هر نسخه کلونشده، یک کپی کامل و مستقل از مخزن کد دریافت میکند. حتی در حالت کاملاً آفلاین، توسعهدهندگان میتوانند تفاوتهای کد را محاسبه کنند، تاریخچه تغییرات را ببینند، تغییرات یک خط خاص را دنبال کنند و هر نسخهای را بازیابی کنند. برای بیشتر مخازن کد، این طراحی کاملاً منطقی است و یکی از دلایل اصلی تبدیل شدن گیت به استاندارد صنعت محسوب میشود.
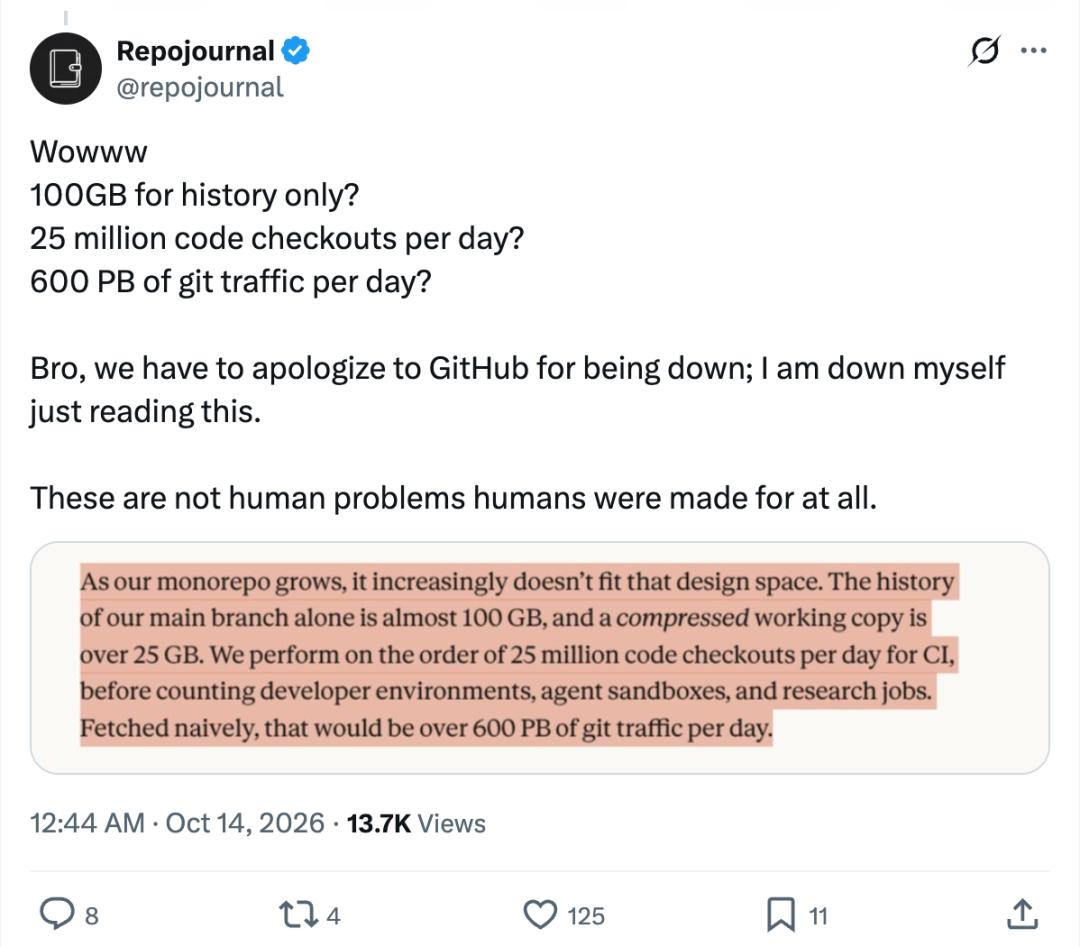
اما با رشد مداوم Monorepo آنتروپیک، طراحی گیت بیش از پیش پاسخگوی نیازهای این شرکت نیست. در حال حاضر، تنها تاریخچه دادههای شاخه اصلی نزدیک به ۱۰۰ گیگابایت است و نسخه کاری فشردهشده بیش از ۲۵ گیگابایت حجم دارد. تنها سیستم CI روزانه حدود ۲۵ میلیون بار عملیات دریافت کد (checkout) انجام میدهد؛ این رقم شامل محیطهای توسعه، سندباکسهای Agent و وظایف پژوهشی نمیشود. اگر دادههای موردنیاز هر بار مستقیماً از گیت دریافت شوند، حجم انتقال روزانه داده از ۶۰۰ پتابایت فراتر خواهد رفت.
البته گیت امکاناتی برای پردازش بخشی از دادههای مخزن ارائه میکند؛ از جمله کلون کمعمق (shallow clone)، دریافت پراکنده (sparse checkout) و Promisor Remote. صنعت نیز روشهای رایجی برای مدیریت Monorepoهای بزرگ دارد؛ مانند ساخت آینههای داخلی گیت یا ذخیره نسخههای snapshot مخزن در فضای ذخیرهسازی اشیا.
آنتروپیک از تمام این روشها استفاده کرده بود. در اوج بار کاری، این شرکت حتی صدها سرور داخلی آینه گیت را اجرا میکرد. این راهکارها برای مدتی به حفظ عملیات کمک کردند، اما با افزایش مداوم حجم ادغام کد، نگهداری آنها دشوارتر شد. فاصله میان snapshot و جدیدترین نسخه شاخه اصلی بین دو بهروزرسانی snapshot بیشتر و بیشتر میشد. همچنین برای اینکه مخازن کلونشده جزئی بتوانند عملیاتهایی مانند diff و blame را که به اطلاعات تاریخی وابسته هستند انجام دهند، نیاز به نگهداری بیشتری وجود داشت.
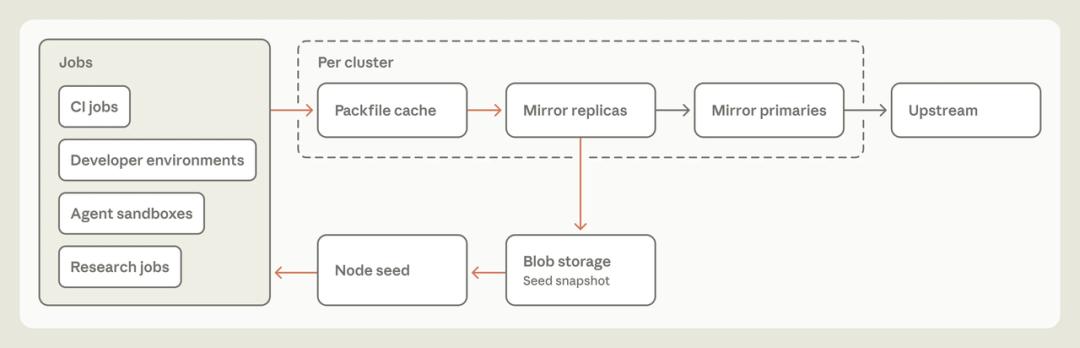
معماری معمول برای گسترش قابلیت دریافت کد در گیت.
بعدتر، آنتروپیک الگوی استفاده خود را دوباره بررسی کرد و به یک نکته مهم رسید. این شرکت مانند بیشتر سازمانها در عمل از گیت بهعنوان یک سیستم متمرکز استفاده میکرد و تمام توسعهها حول یک مخزن کد مرجع انجام میشد. اما تقریباً تمام کلاینتها، Agentها و وظایف خودکار هستند که ذاتاً همیشه آنلایناند. ویژگیهایی که گیت برای توسعه توزیعشده و آفلاین ارائه میدهد، با رشد مخزن کد به عاملی محدودکننده برای مقیاسپذیری تبدیل شدهاند.
بنابراین آنتروپیک این پرسش را مطرح کرد: اگر یک سیستم کنترل کد منبع از ابتدا بر اساس این فرض طراحی شود که Agentها همیشه آنلاین هستند، چه شکلی خواهد داشت؟
۲. کنترل کد منبع برای مقیاس Agentها
با آغاز تولید گسترده کد توسط Agentها، بسیاری از فرضیات سنتی در توسعه نرمافزار در حال تغییر هستند. آنتروپیک هنگام طراحی Scion این تغییرات را در نظر گرفت و در چند اصل کلیدی، راهکارهایی متفاوت از گیت انتخاب کرد. البته کنترل کد منبع برای Monorepoهای بسیار بزرگ بدون سابقه نیست؛ سیستم Piper گوگل و Sapling شرکت متا تجربههای ارزشمندی در این زمینه دارند که آنتروپیک نیز در توسعه Scion از آنها استفاده کرده است.
Scion عمدتاً بر اصول طراحی زیر استوار است.
۱. کلاینت همیشه آنلاین است.
گیت فرض میکند کلاینت باید بتواند آفلاین کار کند، بنابراین یک مخزن کامل کد را بهصورت محلی نگه میدارد. اما تقریباً تمام کلاینتهای آنتروپیک Agentها و وظایف خودکار هستند؛ به همین دلیل کلاینت و پروتکل ارتباطی Scion بر اساس سروری طراحی شدهاند که همیشه در دسترس است. کلاینت تنها دادههای موردنیاز خود را از سرور دریافت میکند.
۲. کلاینت و سرور مسئولیتهای متفاوتی دارند.
در گیت، هر کلاینت توانایی تبدیل شدن به یک سرور کامل گیت را دارد. Scion بیشتر وظایف را به سرور واگذار میکند؛ از جمله جستوجوی تاریخچه فایل، اطلاعات blame، ایجاد commit، ادغام و rebase. کلاینت تنها مسئول نگهداری یک حافظه موقت محلی با اندازه محدود، نوشتن فایلهای نسخه کاری روی دیسک، پایش تغییرات سیستم فایل و ارائه رابط عملیات کاربر است. خود کلاینت تقریباً محاسبات پیچیدهای انجام نمیدهد و بنابراین حجم داده ذخیرهشده محلی بسیار کمتر است.
۳. یک سرویس کامل کنترل کد منبع میتواند از برنامههای جدید بیشتری پشتیبانی کند.
در گیت، اگر یک وظیفه CI یا ابزار دیگری بخواهد اطلاعاتی از مخزن کد، مانند آخرین تغییردهنده یک خط یا رابطه میان دو commit را بررسی کند، معمولاً باید یک مخزن محلی جداگانه نگهداری کند. راه دیگر استفاده از APIهای ارائهشده توسط سرویسدهندگان خاص است، اما این APIها ممکن است پاسخ تمام پرسشها را ندهند. Scion تمام قابلیتهای پرسوجوی کد منبع مورد استفاده کلاینتها را بهصورت API ارائه میکند. به این ترتیب بسیاری از وظایف میتوانند بدون داشتن مخزن محلی، مستقیماً پرسوجوهای خود را انجام دهند.
خط لوله داخلی آنتروپیک برای bisect خودکار و بازگردانی کد نمونهای از این کاربرد است. بدون این قابلیت دسترسی کمهزینه و قابل فراخوانی برنامهای به کد منبع، اجرای چنین ابزارهایی در مقیاس فعلی بسیار دشوار بود.
۴. همه اجزا باید از مقیاسپذیری افقی پشتیبانی کنند.
در گذشته، آنتروپیک در بیشترین حالت صدها سرور آینه گیت اجرا میکرد که منابع محاسباتی زیادی مصرف میکردند. علاوه بر این، وقتی اندازه مخزن از ظرفیت دیسک یا حافظه یک سرور آینه بیشتر شود، توسعه بیشتر بسیار دشوار خواهد شد.
Scion دادههای مخزن کد را بهصورت توزیعشده ذخیره میکند و هر جزء میتواند بهطور مستقل مقیاس پیدا کند. در کل سیستم، هیچ مخزن کامل و کاملاً ساختهشدهای وجود ندارد؛ حتی روی سرور. Scion همچنین سازوکاری مشابه packfile گیت ندارد، بنابراین نیازی به عملیات نگهداری مرتبط با مخزن نیست.
۵. Commitها باید به اندازه کافی سبک باشند، پردازش افزایشی را پشتیبانی کنند و به قفل نیاز نداشته باشند.
در گیت، توسعهدهندگان ابتدا کد را بهصورت محلی commit میکنند و سپس تغییرات را با push به اشتراک میگذارند. در Scion تمام عملیات commit، rebase و merge در سمت سرور انجام میشود و بنابراین push وجود ندارد. اما در این حالت سرور باید بتواند این عملیات را سریع پردازش کند. هزینه ایجاد commit و بهروزرسانی ساختارهای داده مرتبط باید متناسب با اندازه تغییرات کد باشد، نه اندازه کل مخزن؛ در غیر این صورت سرور دیر یا زود از سرعت ارسال کد عقب خواهد ماند.
روند توسعه Scion همچنین استفاده از refها را تا حد ممکن کاهش میدهد. ref اشارهای به یک commit است؛ مانند شاخهها و tagها. معمولاً تنها ارجاعات ضروری مانند شاخه اصلی یا شاخههای انتشار نگهداری میشوند، زیرا دادههای سراسری که همه سرورها باید در آنها وضعیت یکسانی داشته باشند، در آینده میتوانند به گلوگاه مقیاسپذیری تبدیل شوند.
۶. نسخه کاری میتواند حذف شود و checkout بهصورت پیشفرض فقط داده موردنیاز را دریافت کند.
Monorepo آنتروپیک بسیار بزرگ است و CI روزانه دهها میلیون بار checkout انجام میدهد؛ بنابراین این شرکت میخواهد عملیاتهای غیرضروری checkout را تا حد امکان حذف کند. برای مثال، اگر یک وظیفه CI نیاز داشته باشد تفاوت میان یک commit و merge base آن را محاسبه کند، میتواند مستقیماً از سرور Scion پرسوجو کند. بسیاری از وظایف نوشتاری نیز میتوانند checkout کد را کنار بگذارند و کاملاً از طریق APIها انجام شوند.
پروتکل Scion عمدتاً برای checkout پراکنده و مجازی طراحی شده است. checkout پراکنده تنها دایرکتوریهایی را شامل میشود که کلاینت صراحتاً نیاز دارد و checkout مجازی فایلها را فقط زمانی بارگذاری میکند که واقعاً موردنیاز باشند. به این ترتیب حتی اگر وظیفهای مجبور باشد از فایلهای روی دیسک استفاده کند، تنها محتوایی را دریافت میکند که واقعاً خوانده میشود.
۳. Scion چگونه کار میکند؟
پس از شناخت اصول طراحی، اکنون باید دید Scion چگونه آنها را پیادهسازی میکند. این تجربهها میتوانند در دیگر سیستمهای کنترل کد منبع نیز به کار گرفته شوند و حتی به بهبود بخشهای دیگر روند توسعه نرمافزار کمک کنند.
ساختار داده
در Scion، واحد اصلی کار Changeset نام دارد که یک رکورد در Write-Ahead Log است.
Changeset بیشتر اطلاعات مشترک موجود در Git Commit را ذخیره میکند، اما روش سازماندهی داده در این دو متفاوت است. Git Commit یک اشارهگر به درخت دایرکتوری ذخیره میکند، در حالی که Changeset فهرست فایلهایی را ذخیره میکند که نسبت به اولین commit والد تغییر کردهاند، به همراه اشارهگرهای مبتنی بر محتوا به فایلهای فشردهشده در فضای ذخیرهسازی اشیا. Changesetها در سمت سرور ایجاد میشوند و پس از ایجاد، بلافاصله از هر نقطه سیستم قابل دسترسی هستند.
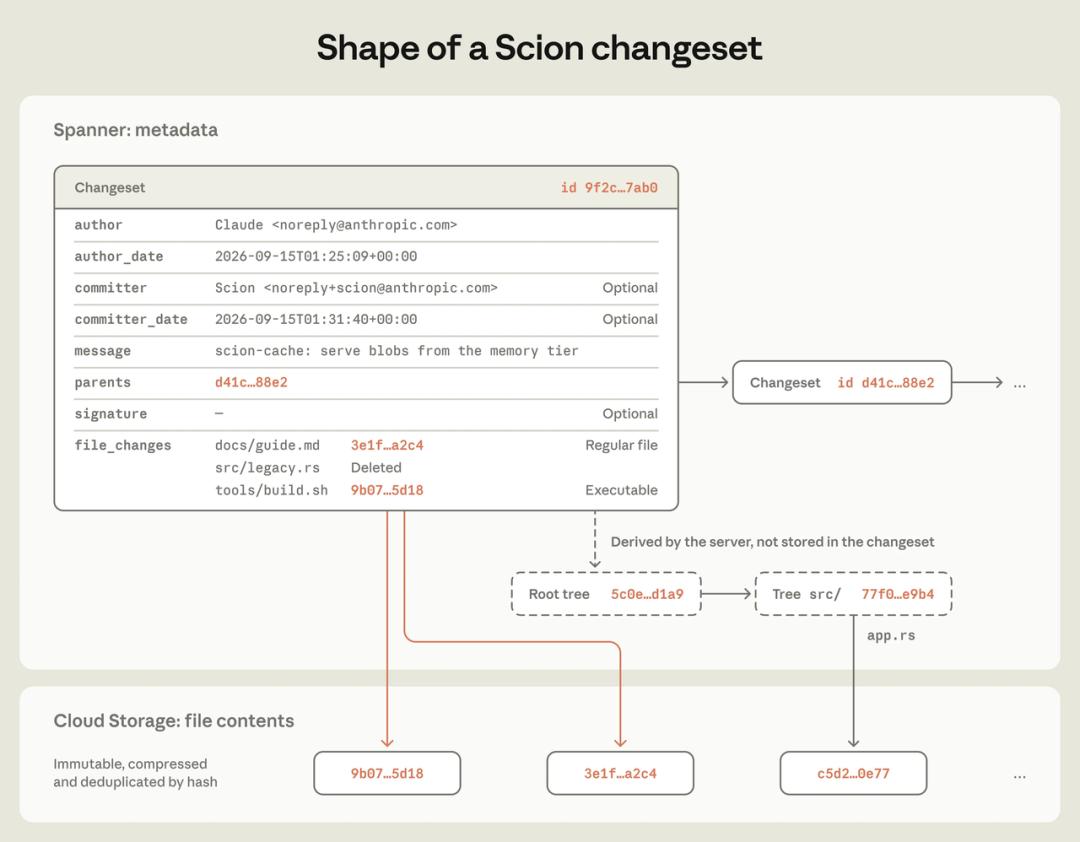
ساختار داده Changeset در Scion.
این ساختار به Scion اجازه میدهد تغییرات را با توان عملیاتی بسیار بالا دریافت کند. زیرا نیازی به دریافت packfile، قفلگذاری یا هماهنگی میان سرورها و جابهجایی refها وجود ندارد. از نظر فنی Scion همچنان از ref پشتیبانی میکند، اما ایجاد و دریافت commit به ref وابسته نیست؛ بنابراین جابهجایی یک ref تنها به یک عملیات Compare-and-Swap روی یک ردیف داده در Spanner نیاز دارد و این عملیات از ایجاد Changeset جداست.
با این حال، Changeset فقط محتوای تغییرکرده را ثبت میکند. اتکا به این رکوردها بهتنهایی برای پاسخ سریع به پرسشهایی مانند آخرین تغییردهنده یک خط یا مسیر طیشده یک فایل در commitها کافی نیست. برای حل این مشکل، Scion ساختارهای داده اضافی را بر اساس Changesetها ایجاد میکند؛ از جمله ساختارهای ویژه برای پرسوجوی blame و تاریخچه مسیر فایل و همچنین skip list برای سریعتر کردن جستوجوی گراف commit.
آنتروپیک دادههایی را که مستقیماً به Changeset تعلق ندارند، Derived Data مینامد. تمام دادههای مشتقشده با یک سازوکار عمومی محاسبه میشوند. هر نوع داده مشتقشده بهصورت بازگشتی تعریف میشود؛ یعنی داده مشتقشده مربوط به یک Changeset را میتوان بر اساس داده متناظر در Changeset والد محاسبه کرد.
این سازوکار سه مزیت دارد.
نخست اینکه اگر مشخص شود یک عملیات با ساختار داده جدیدی سریعتر میشود، افزودن نوع جدیدی از داده مشتقشده آسان خواهد بود.
دوم اینکه هر نوع داده مشتقشده میتواند مستقل تصمیم بگیرد که از پیش محاسبه شود یا تا زمان نیاز واقعی صبر کند تا از تولید دادههای بدون استفاده جلوگیری شود.
در نهایت، کلاینت نیازی ندارد از جزئیات داخلی این ساختارهای داده آگاه باشد؛ بنابراین ساختارهای سمت سرور میتوانند بدون تغییر کلاینت بهطور مداوم بهینه شوند.
با تکامل Scion، آنتروپیک انواع جدیدی از دادههای مشتقشده را اضافه کرده است؛ مانند شاخصهای جدید برای تشخیص کپی فایلها و جستوجوی فایلها بر اساس مسیر.
مقیاسپذیر کردن Scion
یک خوشه کوچک از سرورهای Scion مسئول ارائه APIهای مختلف کنترل کد منبع به کلاینتهاست؛ از جمله دریافت Changeset، محاسبه diff، یافتن merge base و دریافت Blobها. تمام دادههای کد منبع بر اساس محتوا آدرسدهی میشوند، بنابراین پس از نوشته شدن داده، محتوای آن دیگر تغییر نمیکند. هر سروری میتواند این داده را بدون هماهنگی با سرورهای دیگر در حافظه موقت خود نگه دارد.
به همین دلیل سرورهای Scion میتوانند بهصورت افقی توسعه پیدا کنند و نیاز بسیار کمی به هماهنگی میان خود دارند. این سرورها در عمل مانند حافظههای نهان بزرگ عمل میکنند و میتوانند دادههای مشتقشده را در صورت نیاز محاسبه کرده و نتیجه را در Spanner ذخیره کنند.
بسیاری از ابزارهای داخلی که از Scion استفاده میکنند دیگر نیازی به نگهداری مخزن محلی خود ندارند. در گذشته، اگر یک وظیفه CI یا ابزار دیگری نیاز داشت رابطه اجدادی commitها را بررسی کند یا سوابق تغییرات کد را دنبال کند، ابتدا باید مخزن کد را دریافت و نگهداری میکرد؛ کاری که هزینه نگهداری قابل توجهی داشت. در مراحل ابتدایی مهاجرت، آنتروپیک حتی کلاینت، قالب مخزن و پروتکل ارتباطی اختصاصی خود را نداشت و Scion در آن زمان تنها میتوانست به پرسوجوهای فرادادهای پاسخ دهد. در مقابل، دریافت محتوای فایل و ساخت نسخه کاری روی دیسک به انتقال داده بسیار بیشتری نیاز دارد؛ بنابراین آنتروپیک برای این بخش راهکار جداگانهای طراحی کرد.
کلاینت scn در Scion در پروتکل دریافت داده چند تفاوت مهم با گیت دارد و به همین دلیل میتواند معماریای با مقیاسپذیری بیشتر و سربار پردازنده بسیار کمتر از سرورهای گیت داشته باشد. هنگام مذاکره برای دریافت داده، Scion از کلاینت نمیخواهد ابتدا اعلام کند چه دادههایی را در اختیار دارد؛ بلکه کلاینت مستقیماً درخت دایرکتوری و اشیای Blob موردنیاز خود را درخواست میکند. کلاینت از ریشه درخت دایرکتوری بررسی میکند کدام اشیا در ذخیرهسازی محلی وجود ندارند و سپس آنها را بهصورت بازگشتی از سرور درخواست میکند. پس از دریافت درخت دایرکتوری، Blobها نیز به همین روش دریافت میشوند. هر درخواست به یک شی مشخص اشاره دارد که محتوایش تغییر نمیکند؛ بنابراین هر حافظه نهانی میتواند پاسخ را بازگرداند.
کل این معماری بسیار شبیه یک سیستم سنتی حافظه نهان لایهای است. این روش بسیار کارآمد است و امکان ادامه انتقال پس از قطع شدن را فراهم میکند، زیرا کل فرایند به یک پاسخ packfile واحد که ممکن است چند گیگابایت حجم داشته باشد وابسته نیست. checkout پراکنده و checkout مجازی نیز به پشتیبانی ویژهای نیاز ندارند؛ کلاینت تنها نباید درخت دایرکتوریهایی را درخواست کند که به آنها نیاز ندارد.
در خوشه محاسباتی آنتروپیک، کلاینت از طریق Socket با یک فرایند daemon به نام scion-daemon ارتباط برقرار میکند. scion-daemon اشیای کد را برای کل گره محاسباتی ذخیره میکند. از آنجا که بیشتر گرهها باید به Monorepo دسترسی داشته باشند، وظایف مختلف روی یک گره معمولاً تعداد زیادی شی مشترک را دوباره استفاده میکنند؛ بنابراین مدیریت یکپارچه حافظه نهان توسط daemon کارآمدتر است.