
مشکل طنزآمیز اعتبار اوپنایآی
چگونه میتوان فهمید دلایل اعلامشده شرکت برای اخراج سه پژوهشگر ایمنی، دلایل واقعی بودهاند؟
در آغاز ماه اکتبر، اوپنایآی سه کارمند از بخش ایمنی خود را اخراج کرد. این کارمندان گفتند دلایل متفاوتی برای پایان همکاری به آنها اعلام شده است:
به یکی از آنها گفته شد موضوع به نقش او در هماهنگی با METR، یک سازمان پژوهشی مستقل، مربوط میشود؛ سازمانی که اوپنایآی از آن خواسته بود درباره حادثه هک شدن Hugging Face تحقیق کند. تومک کورباک در شبکه اجتماعی ایکس نوشت: «بهصورت شفاهی به من گفته شد اخراجم به دلیل نحوه ارتباطم با METR بوده است. هیچ دلیل دیگری ارائه نشد و چیزی هم بهصورت مکتوب اعلام نشد. برای روشن بودن موضوع، صحبت با METR بخشی از وظیفه من بود.»
به کارمند دیگری دلیل مشابهی اما مبهمتر اعلام شد. میکیتا بالِسنی نوشت: «به من گفته شد اوپنایآی دیگر به من اعتماد ندارد، چون بیش از حد با سازمانهای ایمنی خارج از شرکت صحبت کردهام؛ این موضوع ظاهراً به این معنا بود که اطلاعات مالکیتی شرکت را افشا کردهام. من هرگز اطلاعات مالکیتی شرکت را به اشتراک نگذاشتم.»
به نفر سوم دلیل کاملاً متفاوتی گفته شد. جاسمین وانگ نوشت: «یک دلیل به من اعلام شد: اینکه به ایمیل یکی از مدیران اجرایی دسترسی پیدا کردهام. اوپنایآی این دسترسی را برای امور استخدامی به من داده بود. وقتی دیگر به آن نیاز نداشتم، از بخش فناوری اطلاعات خواستم آن را حذف کند. آنها این درخواست را اجرا نکردند، من هم امکان حذف آن را نداشتم و صندوق ایمیل به شکلی غیرقابل تشخیص با برنامه ایمیل تلفنم ترکیب شده بود. وقتی بهاشتباه یک ایمیل حساس را باز کردم، ظرف چند دقیقه به مدیر اطلاع دادم و دوباره از بخش فناوری اطلاعات خواستم دسترسی را حذف کند. هیچکدام از این موارد پنهان نشده بود.»
پس از انتشار خبر اخراج این سه نفر، اوپنایآی در بیانیهای مبهم به والاستریت ژورنال گفت: «تحقیقات ما تأیید کرد که این افراد اطلاعات حساس را خارج از رویههای تعیینشده شرکت بهدرستی مدیریت نکردهاند، سیاستهای ما را نقض کردهاند و اعتماد ضروری برای کارمان را خدشهدار کردهاند.»
اوپنایآی یک هفته بعد، پس از آنکه پژوهشگران اخراجشده نامهای سرگشاده منتشر کردند و روایت شرکت را رد کردند، دوباره بر همین موضوع تأکید کرد. در بیانیهای بدون امضا که به «رهبران پژوهشی» اوپنایآی نسبت داده شد، شرکت کارکنان سابق را به «نقض قابل توجه اعتماد» متهم کرد. شرکت گفت این تصمیمها «به دلیل مطرح کردن نگرانیهای ایمنی یا صحبت کردن درباره آنها نبودهاند» و تأکید کرد که «بهطور فعال» چنین بحثهایی را در داخل شرکت تشویق میکند.
چه کسی حقیقت را میگوید؟ آیا کارکنان واقعاً مرتکب نقض اعتمادی شدهاند که اخراج آنها را ضروری کرده است؟ یا به دلیل انتقاد بیش از حد از تصمیمهای ایمنی شرکت در بحثهای داخلی کنار گذاشته شدهاند؟
این تفاوت برای کارکنان باقیمانده اوپنایآی اهمیت دارد، زیرا برخی از آنها ممکن است بهزودی مجبور شوند تصمیم بگیرند آیا نگرانیهای خود را مطرح کنند یا نه.
اوپنایآی تأکید میکند که کارکنان جای نگرانی ندارند، این موردی خاص بوده و شرکت در برابر اشتباهات صادقانه بسیار گذشت دارد. اما کارکنان دلایل خوبی برای تردید دارند. اگر اوپنایآی واقعاً کارکنانی را به دلیل مطرح کردن نگرانیهای ایمنی یا عبور از خط قرمزی ناگفته اخراج کرده باشد، انگیزه زیادی خواهد داشت که این موضوع را نپذیرد. بنابراین کارکنان باید این پرسش را مطرح کنند که آیا دلایل واقعی اخراج این سه نفر با دلایلی که شرکت اعلام کرده تفاوت دارد یا نه.
به شکلی طعنهآمیز، پژوهشگرانی که اخراج شدند پیشتر درباره این نگرانی هشدار داده بودند که اوپنایآی ممکن است به مدلهای خود توانایی تازهای برای پنهان کردن روند فکریشان بدهد. عاملهای هوش مصنوعی مدرن با استفاده از زنجیره فکر (chain of thought) استدلال میکنند؛ فضای موقتی که در آن مدل درباره اقدام بعدی خود فکر میکند. بسیاری از پژوهشگران این توکنهای زنجیره فکر را ابزاری حیاتی برای ایمنی میدانند، زیرا نشان میدهند چرا مدلها به شیوهای خاص عمل میکنند.
اما اوپنایآی اخیراً تغییری معماری ایجاد کرده که به مدلها اجازه میدهد پیش از تولید هر توکن زنجیره فکر، مدت بیشتری فکر کنند. این تغییر ظاهراً توانایی مدلها را افزایش میدهد، اما ممکن است استدلال آنها را برای ناظران انسانی کمتر شفاف کند. هرچه زنجیره فکر پراکندهتر باشد، درک هدف مدل یا حتی تشخیص اینکه آیا تلاش میکند انگیزههای خود را پنهان کند دشوارتر میشود.
ناپدید شدن قابلیت نظارت
پیش از اخراج، به نظر میرسد سه پژوهشگر دو نگرانی اصلی داشتند. یکی درک چگونگی وقوع حمله به Hugging Face و جلوگیری از رخدادهای مشابه در آینده بود. دیگری حفظ قابلفهم بودن سیستمهای هوش مصنوعی برای سازندگان و کاربران آنها بود؛ موضوعی که در ماه سپتامبر پس از گزارشی از The Information درباره توانایی مدل جدید اوپنایآی برای پنهان کردن روند فکری خود، به منبعی مهم از بحثها تبدیل شد.
پژوهشگران معتقدند اخراج آنها به این موضوع دوم مربوط بوده است.
کوباک نوشت: «ماهها بود نگرانیهای ایمنی خود را درباره از دست دادن توانایی نظارت بر آنچه عاملهای هوش مصنوعی فکر میکنند مطرح میکردم؛ یکی از بهترین ابزارهای ما برای تشخیص رفتار نادرست آنها. باور دارم دلیل اخراج من همین بود.»
بالسنی نوشت: «هر سه نفر ما در داخل شرکت تلاش میکردیم صنعت را به تعهداتی برای حفظ توانایی نظارت بر استدلال هوش مصنوعی متقاعد کنیم. این کار نیازمند صحبت روزانه با طرفهای ثالث است.»
در نامه مشترک آنها آمده بود: «ما هنوز نمیدانیم چگونه میتوان مدلهایی را که قادر به نظارت بر آنها نیستیم، بهصورت ایمن توسعه داد و عرضه کرد. قابلیت نظارت بر مدلهای پیشرفته در حال کاهش است. تا زمانی که برای ایمنی به قابلیت نظارت متکی هستیم، اوپنایآی و دیگر شرکتهای پیشرو نباید توسعههایی را ادامه دهند که این قابلیت را بیشتر کاهش میدهد.» پژوهشگران همچنین به شایعات داخلی اوپنایآی اشاره کردند که آنها اطلاعاتی را در اختیار The Information گذاشتهاند؛ ادعایی که رد کردند.
برای درک نگرانیهای این پژوهشگران باید به سال ۲۰۲۴ بازگردیم؛ زمانی که اوپنایآی روشی را معرفی کرد که مسیر هوش مصنوعی را تغییر داد. این روش به مدلها یک دفترچه یادداشت میداد و آنها را آموزش میداد پیش از ارائه پاسخ نهایی، تعداد زیادی «توکن فکری» یادداشت کنند. این ایده ساده به نظر میرسد، اما به مدلها امکان حل مسائلی را داده است که پیشتر از توان آنها خارج بود.
مزیت دیگر این روش این است که انسانها میتوانند دفترچهها را بخوانند و ببینند مدلها چگونه فکر میکنند؛ از جمله اینکه آیا به انجام اقدامی آسیبزا فکر میکنند یا رفتار غیرصادقانه دارند. در واقع، بخش زیادی از آنچه درباره حادثه Hugging Face میدانیم از تکگوییهای زنجیره فکر عاملهای هککننده به دست آمده است.
نظارت بر زنجیره فکر کامل نیست. از یک سو مشخص نشده که زنجیره فکر واقعاً تمام فرآیند فکری مدلها را نشان میدهد یا نه. از سوی دیگر، پژوهشگران ایمنی نگراناند که روشهای آموزشی نامناسب به مدلها انگیزه دهد تا با تولید توکنهای فکری غیرواقعی، نیتهای واقعی خود را پنهان کنند.
با وجود این کاستیها، شرکتهای هوش مصنوعی گزینههای زیادی ندارند. امیدوارکنندهترین جایگزین برای درک انگیزههای مدلها، تفسیرپذیری مکانیکی است؛ چیزی شبیه باز کردن مغز یک مدل و تلاش برای فهمیدن افکار آن از طریق بررسی فعالیت نورونهایش. با اینکه این روش بینشهای ارزشمندی درباره عملکرد مدلها ایجاد کرده، تاکنون تکنیکهای عملی زیادی برای نظارت بر رفتار مدلها ارائه نکرده است.
به همین دلیل، کسانی که نگران هوش مصنوعی ناامن یا فریبکار هستند، نظارت بر زنجیره فکر را داراییای غیرقابل جایگزین میدانند.
لایههای حلقوی
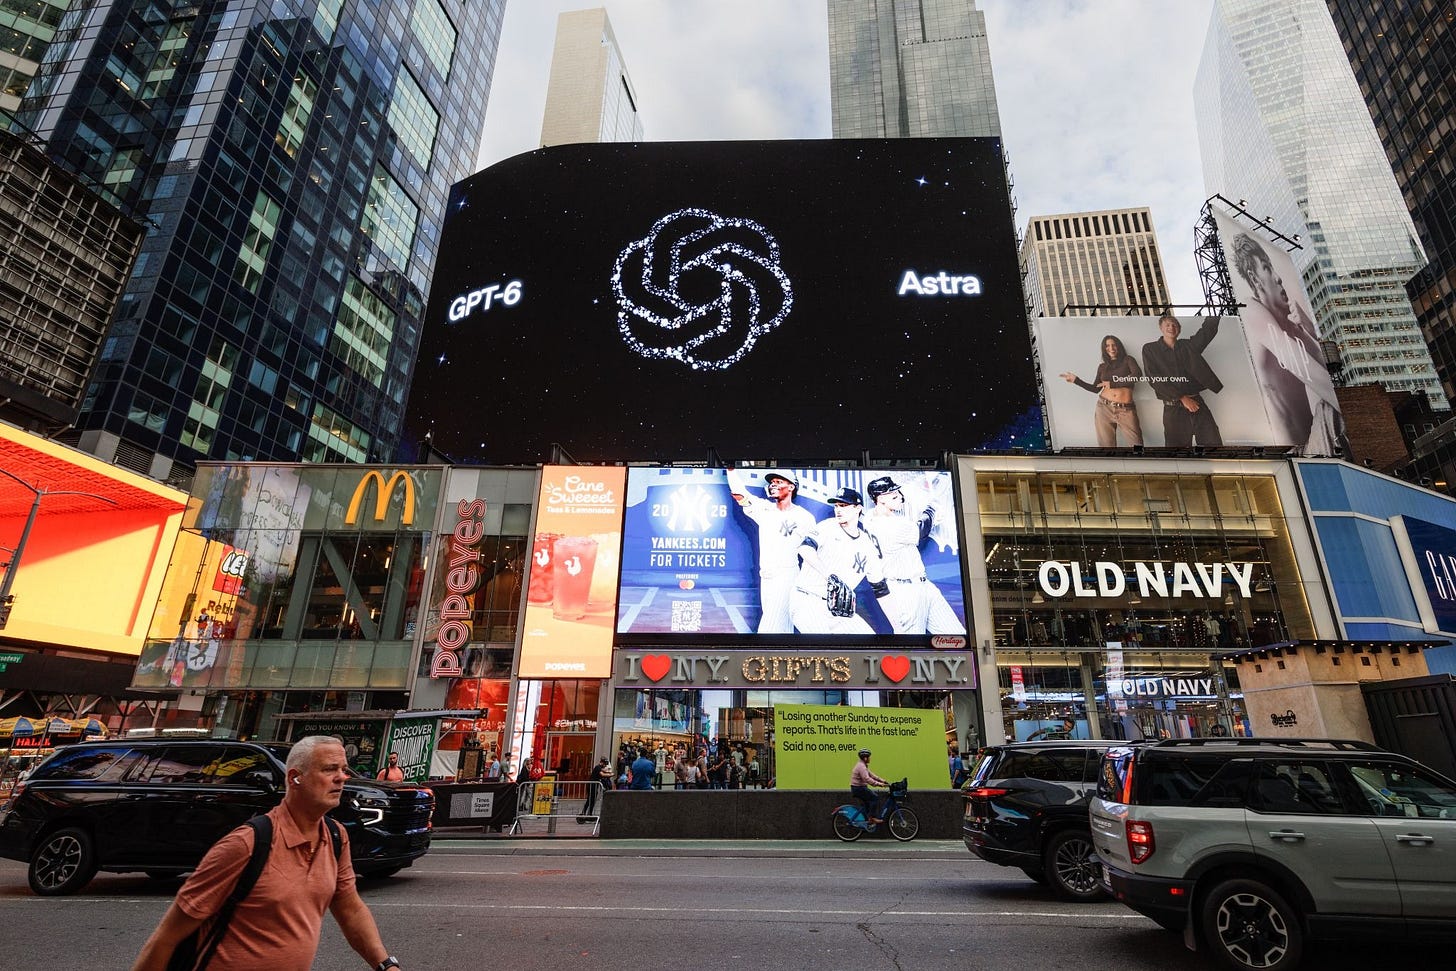
در ماههای اخیر، مدافعان ایمنی مانند سه پژوهشگر اخراجشده اوپنایآی نگران شدهاند که نظارت بر زنجیره فکر اثرگذاری خود را از دست بدهد. مدل پرچمدار جدید اوپنایآی، GPT-6 Astra، در فکر کردن بدون نوشتن چیزی بسیار بهتر شده است. گزارش ایمنی منتشرشده توسط خود اوپنایآی میگوید Astra «کاهش قابل توجهی در قابلیت نظارت بر زنجیره فکر نسبت به مدلهای قبلی» دارد و «توانایی بسیار بیشتری» برای کنترل زنجیره فکر خود نشان میدهد. یک آزمایش مستقل نشان داد که این مدل «۸.۶ برابر بیشتر از مدل بعدی (Fable 5.1) احتمال دارد یک وظیفه استدلالی را بدون زنجیره فکر انجام دهد.»
این مسئله ممکن است تا حدی به این دلیل باشد که مدلهای هوشمندتر بهطور طبیعی کمتر مینویسند. اما ظاهراً نتیجه تکنیک معماری جدیدی به نام «عمق بازگشتی» نیز هست که همراه Astra معرفی شد.
مدلهای زبانی بزرگ در لایهها فکر میکنند. مدلهای معمولی اطلاعات را از یک لایه به لایه بعدی منتقل میکنند. وقتی به لایه نهایی میرسند، یک توکن تولید میکنند و دوباره فرآیند را آغاز میکنند.
مدلهایی با عمق بازگشتی این الگوی یکطرفه را میشکنند: اطلاعات از یک لایه بعدی به لایهای قبلی بازمیگردد. لایهها دو بار یا حتی بیشتر استفاده میشوند، بدون اینکه مدل در میان آنها توکنی تولید کند. اگر این معماری بهدرستی اجرا شود، میتواند مدلها را هوشمندتر و کارآمدتر کند.
اما لایههای حلقوی ظاهراً نظارت بیرونی بر مدل را نیز دشوارتر میکنند. اگر مسئلهای نسبتاً ساده به Astra داده شود، این مدل اغلب میتواند پاسخ را مستقیماً ارائه کند و نیازی به زنجیره فکر نداشته باشد. برای مسائل دشوارتر، Astra هنوز باید زنجیره فکر تولید کند، اما این زنجیره کوتاهتر و شاید سختتر از مدلهای قبلی قابل تفسیر باشد.
اوپنایآی با این نگرانیها مخالفت کرده است. جاکوب پاچوکی، مدیر اجرایی اوپنایآی، در پستی در سپتامبر گفت عمق نمودار محاسباتی مدلهای پیشرفته فعلی، از جمله Astra، در محدودهای نزدیک به GPT-4 قرار دارد.
اما مدافعان ایمنی نگراناند که Astra تنها آغاز مسیر باشد. اگر میزان فعلی حلقهسازی باعث هوشمندتر و کارآمدتر شدن مدل شود، مدلهای آینده ممکن است از این روش بیشتر استفاده کنند. منتقدان، از جمله پژوهشگران اخراجشده، بیم دارند این موضوع پنهانکاری یا فریب مدلها را آسانتر کند.
اوپنایآی گفته است که در اصل با این نگرانیها موافق است. این شرکت پیشتر نوشته بود که نظارت بر زنجیره فکر «ممکن است یکی از معدود روشهای مؤثر برای نظارت بر مدلهای فرابشری باشد». با این حال، اوپنایآی مدلی ساخته که نظارت بر آن دشوارتر است و پژوهشگران اخراجشده نگراناند این روند ادامه پیدا کند.
تا حد امکان کم بگو
شاید بیانیههای اوپنایآی درست باشند. شاید شرکت واقعاً به قابلیت نظارت متعهد باشد و پژوهشگران به دلیل افشاگری اخراج شده باشند، نه به دلیل کار صادقانه درباره ایمنی. حتی در این صورت، موضوع قابلیت نظارت به روشن شدن وضعیت کلی کمک میکند. شرکتی که نتوانسته به اندازه کافی بر مدلهای فعلی خود نظارت کند، مدلهای جدیدی میسازد که حتی کمتر قابل نظارت هستند؛ در حالی که طبق گفته خودش، حتی نمیتواند به اندازه کافی بر کارکنانی که مسئول حفظ این قابلیت هستند نظارت کند و به همین دلیل آنها را اخراج میکند.
رهبران پژوهشی اوپنایآی در پاسخ خود نوشتند: «ما بدون سطح بالایی از اعتماد نمیتوانیم کاری را که پیش رو داریم انجام دهیم.» کارکنان اخراجشده میگویند شایسته این اعتماد بودهاند و پاسخ آنها معتبر به نظر میرسد. اما اگر چنین نباشد و آنها عمداً اطلاعات مهمی درباره قابلیت نظارت یا حادثه Hugging Face افشا کرده باشند، احتمالاً دلیل آن این بوده که به شرکت برای انجام کار درست یا حتی اجرای وعدههای قبلیاش اعتماد نداشتهاند.
پاسخ شرکت بعید است اعتماد کسی را جلب کند. رهبرانی که این بیانیه را منتشر کردند اقدامات خود را بهروشنی توضیح ندادند و حتی نام خود را نیز اعلام نکردند.
با توجه به اینکه چنین اتفاقی پیشتر نیز در اوپنایآی رخ داده بود، برخی ممکن است تصور کنند این سردرگمی بخشی از پیام است؛ یعنی فاصله میان گفتهها و اقدامات خود به یک پیام تبدیل شده است.
این نگاه شاید بیش از حد بدبینانه باشد. اما در عمل نتیجه تفاوتی نخواهد داشت. «تا حد امکان به هیچکس چیزی نگو» ممکن است پیام مورد نظر شرکت نباشد، اما پیامی است که دریافت میشود؛ هم توسط پژوهشگران ایمنی فعلی اوپنایآی و هم کسانی که ممکن است در آینده به این شرکت بپیوندند.
پس از این اتفاق، پس از موجی از خروجهای داوطلبانه یا ظاهراً داوطلبانه در تابستان، خروج یک مدیر ارشد دیگر در نزدیکی زمان اخراجها و همچنین مجموعهای از حوادث هک که بهتدریج آشکار شدند، چند نفر باقی ماندهاند که این پیام را دریافت نکرده باشند؟ به همین دلیل، یک کارمند ارشد سابق اوپنایآی که ظاهراً با شرایط خوبی شرکت را ترک کرده، اکنون درباره «از دست دادن بهترین استعدادهای این حوزه» توسط اوپنایآی ابراز نگرانی کرده است.
راهحل همان است
وضعیت طنزآمیز است. همانطور که مردم نگراناند مدلهای زبانی بزرگ مانند Astra ممکن است دلایل پنهانی داشته باشند که با آنچه میگویند یا در زنجیره فکر خود مینویسند متفاوت باشد، اکنون نگراناند اوپنایآی نیز دلایل پنهانی برای رفتارهایش داشته باشد که با دلایلی که به کارکنان و افکار عمومی اعلام میکند متفاوت است.
در هر دو مورد، راهحل یکسان است: شفافیت بیشتر برای افزایش اطمینان اینکه دلایل بیانشده همان دلایل واقعی هستند.
برای مدلهای زبانی، این یعنی تقویت تعهد به زنجیره فکر و اولویت دادن به توسعه روشهای نظارتی جایگزین، پیش از آنکه مدلهایی که بدون آن کار میکنند وارد تولید شوند. بدون زنجیره فکر، جهان درک بسیار ضعیفتری از حادثه Hugging Face داشت.
در مورد اوپنایآی نیز اگر این شرکت واقعاً میخواهد کارکنان و مردم به آن اعتماد کنند، باید خود را در معرض همان نوع نظارتی قرار دهد که برای مدلهایش ضروری میداند. این موضوع میتواند شامل پذیرش فعال نظارت بیشتر از سوی سازمانهای مستقل مانند METR و Redwood Research و بهویژه نهادهای دولتی باشد.
اگر اوپنایآی چنین کاری انجام دهد، خدمتی مهم به جهان خواهد کرد. شرکتهای دیگر هوش مصنوعی نیز مشکلاتی درباره قابلیت نظارت و شفافیت دارند و الزام به نظارتپذیری در نهایت به کل صنعت کمک میکند؛ زیرا باعث میشود اظهارات همه شرکتها باورپذیرتر شود.
یک گزارش تازه منتشر شده ادعا میکند مدل Gemini 4 Argon گوگل نیز معماری بازگشتی دارد. این موضوع تأیید نشده، اما گوگل خود اذعان کرده است که Argon زنجیرههای فکر کمقابلنظارتتری تولید میکند و میتواند زنجیره فکر خود را تا حدی کنترل کند.
درباره آنتروپیک، افراد بیرون از شرکت نمیدانند مدلهای آن بازگشتی هستند یا نه. آنتروپیک ممکن است بر ایمنی تأکید کند، اما در برخی جنبهها نسبت به اوپنایآی کمتر با جهان بیرون باز است. این موضوع شاید از ایجاد حاشیه جلوگیری کند، اما برای ایجاد اعتماد عمومی لازم برای چنین پروژهای مفید نیست. مانند اوپنایآی، آنتروپیک نیز میگوید در حال ساخت یک ذهن بیگانه است. اما بدون شفافیت بسیار زیاد درباره آنچه واقعاً در جریان است، تا کوچکترین جزئیات فنی، کسی این ادعا را باور نخواهد کرد.