
درخشش ستارگان علم؛ تصویری جمعی از دانشمندان پشت ۷۲۲ مقاله منتشرشده OpenAI
پس از آنکه OpenAI تعداد ۷۲۲ دستنوشته علمی تولیدشده با هوش مصنوعی را در حوزه ریاضیات و علوم کامپیوتر نظری بهصورت عمومی منتشر کرد، پروژه متنباز On Whose Shoulders (بر شانههای چه کسانی) به ابتکار چیونگشیو لی از آزمایشگاه امنیت هوش مصنوعی دانشگاه آلبورگ دانمارک، تمامی ارجاعات این مقالات را بهصورت موردی بررسی کرد و منشأ آنها را در یک تحلیل نظاممند ردیابی کرد.
نتایج این بررسی، بیش از پنج قرن فعالیت علمی، ۱۱ هزار و ۶۷ اثر پژوهشی انسانها و حدود ۹۶۰۰ ریاضیدان را در بر میگیرد. در میان این پژوهشگران، ۱۱۴ نفر برنده مدال فیلدز، جایزه آبل یا جایزه ولف بودهاند.
چنین دستاوردهایی اغلب در یک جمله خلاصه میشوند: «هوش مصنوعی فلان مسئله دشوار را حل کرد.»
اما این روایت تنها نیمی از ماجراست. نیمه دیگر آن است که هوش مصنوعی برای رسیدن به راهحل، بر کدام پژوهشها و دستاوردهای پیشین تکیه کرده است.
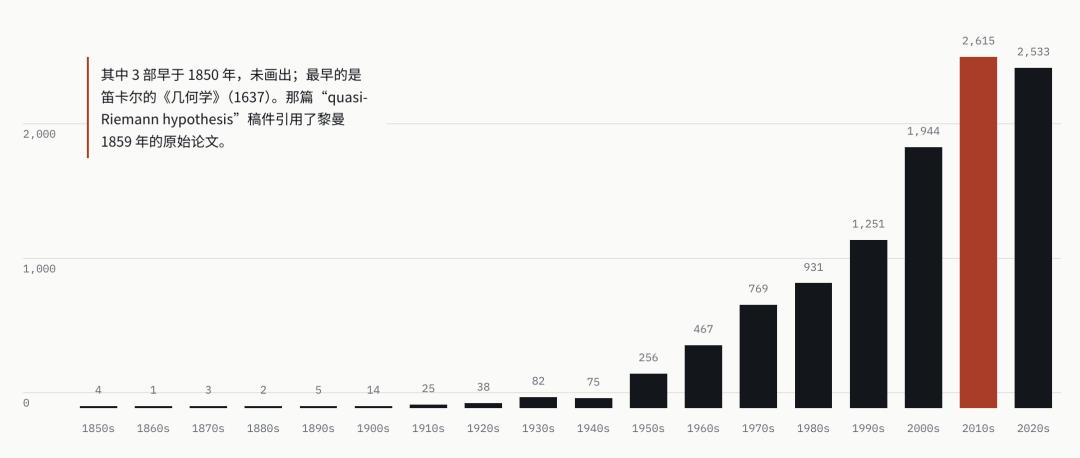
بیشتر پژوهشگرانی که آثارشان در این مقالات مورد استناد قرار گرفته، صرفاً چهرههایی متعلق به تاریخ علم نیستند؛ بسیاری از آنها ریاضیدانان و متخصصان علوم کامپیوتر نظری هستند که امروز نیز به فعالیت علمی مشغولاند.
همانطور که محتوای اصلی مقالات نشان میدهد، هوش مصنوعی از دستاوردهای این دانشمندان بهعنوان ابزارهایی برای حل مسائل استفاده کرده است:
در هندسه حسابی، یکی از مقالات با استناد به پژوهش «Fargues–Scholze 2024» از لوران فارگ و پیتر شولتسه، تناظر میان دستهای از کلافهای برداری و دستگاههای موضعی p-ادیک را برقرار میکند.
در هندسه دوتعبیری، برخی مقالات از راهبرد جدید کوچر بیرکار و یکی از همکارانش پیروی میکنند و برخی دیگر قضیه بیرکار درباره متممهای کراندار را به کار میگیرند. گروه دیگری از مقالات نیز بر روش استقرایی اوسامو فوجینو و پژوهشهای اومپروکاش داس، کریستوفر هاکون و میهای پائون استوارند.
در نظریه احتمال، مقالات از برآوردهای بحرانی عبور در مدلهای خوشهای تصادفی، حاصل پژوهش هوگو دومینیل-کوپن و همکارانش، و همچنین قضیه «جفتسازی درختها» از برتران دوپلانتیه، جیسون میلر و اسکات شفیلد بهره میبرند.
یک مثال نقض در نظریه گراف از ساختار نمونهگیری حد گراف، ارائهشده به دست لاسلو لوواس و بالاش سگدی، استفاده میکند. مثال نقض دیگری در ترکیبیات نیز بر روش جمع و ضرب ژان بورگن، نتس کاتس و ترنس تائو تکیه دارد.
مقالهای درباره شیشه اسپینی از روش حفره میشل تالاگران استفاده میکند.
در یکی از استدلالهای مربوط به جریان ریچی، خاصیت یکنوایی آنتروپی پرلمان که در سال ۲۰۰۲ معرفی شد به کار رفته است. استدلال دیگری در نظریه هاج نیز از برهان نیمهسادگی دلین بهره میگیرد.
به این ترتیب، پشت هر دستاورد هوش مصنوعی در هر حوزه علمی، گروهی از انسانها و حاصل تلاش آنها قرار دارد.
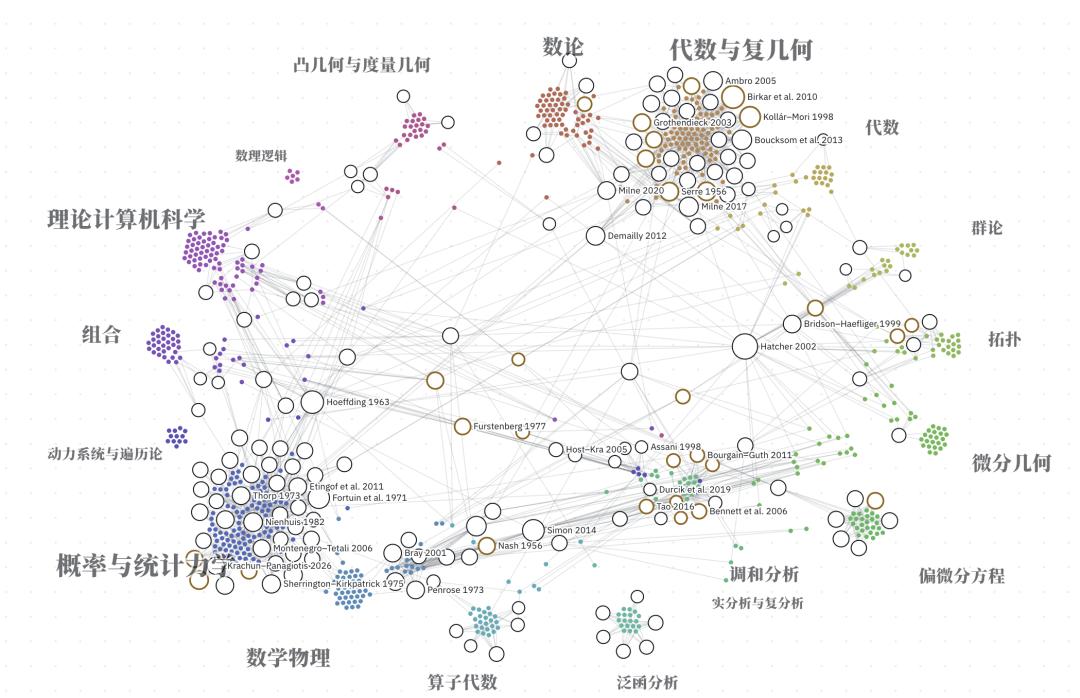
در این تصویر، هر نقطه کوچک نماینده یک پیشچاپ علمی تولیدشده با هوش مصنوعی است که بر اساس رشته تخصصی در مجموعههایی شبیه «قاره» دستهبندی شدهاند. نقاط بزرگتر که با دایره مشخص شدهاند، مقالات انسانی هستند که چندین پیشچاپ بهطور مشترک به آنها استناد کردهاند. اندازه هر نقطه تعداد استنادها را نشان میدهد و جایگاه آن در میان مقالاتی تعیین شده که به آن ارجاع دادهاند.
پروژه «بر شانههای چه کسانی»: seafill.info/Shoulders
منبع دادهها: github.com/openai/math
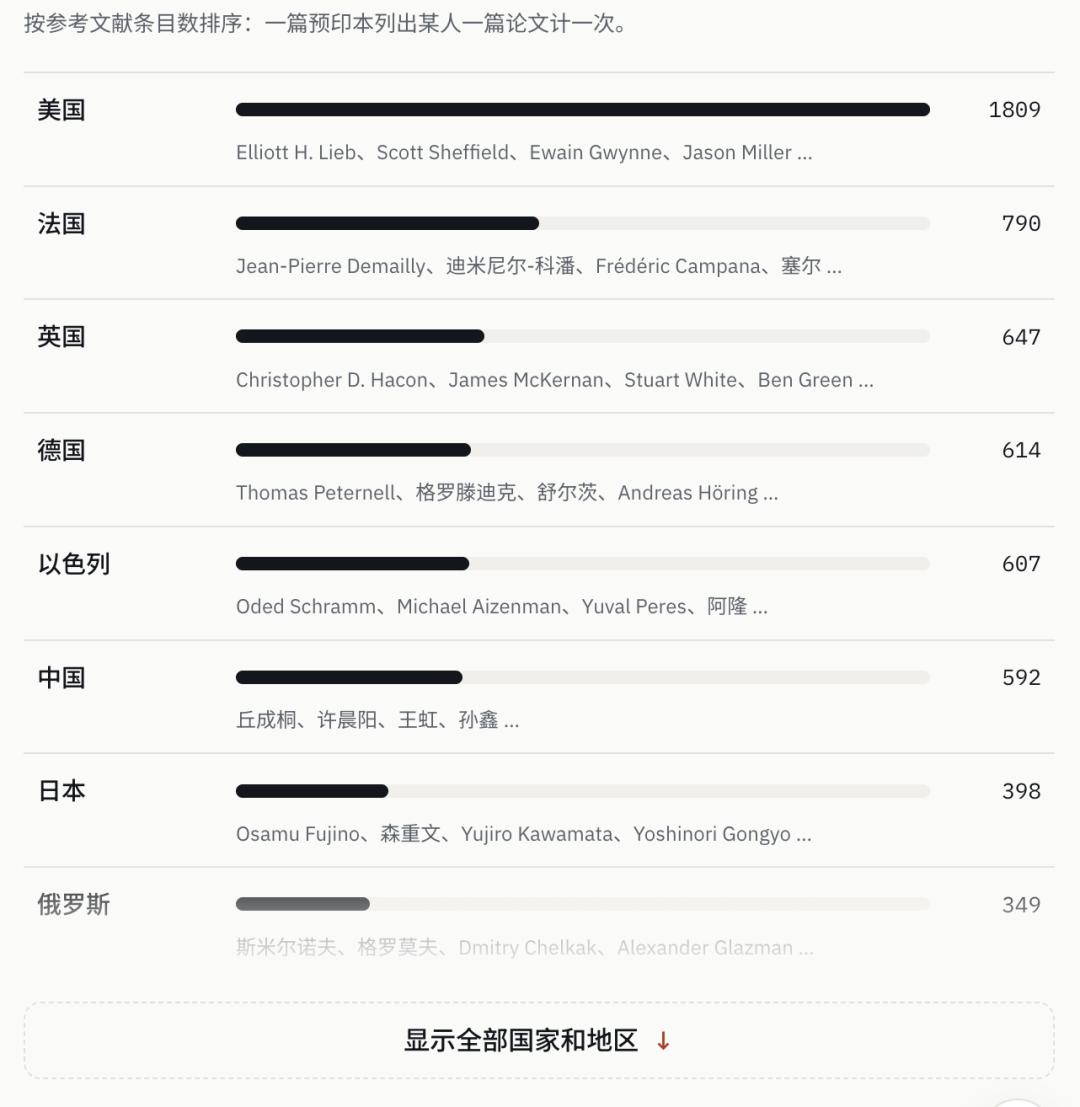
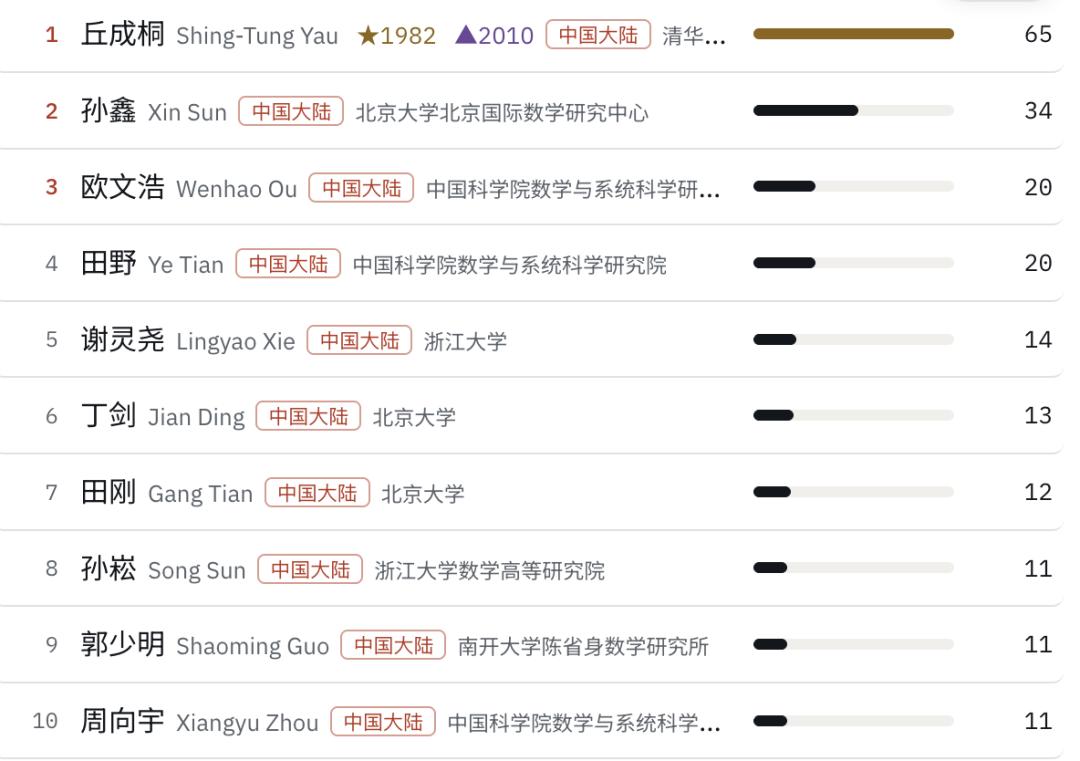
برای نمونه، OpenAI بارها از پژوهشهای شینگتونگ یائو، شین سون، ونهائو او، یه تیان، لینگیائو شیه، جیان دینگ، گانگ تیان، سونگ سون، شائومینگ گوئو، شیانگیو ژو و شماری دیگر از پژوهشگران استفاده کرده است.
نقش ریاضیدانان چینی در این زنجیره پیشرفت علمی:
پژوهش شینگتونگ یائو که در سال ۱۹۷۶ به اثبات حدس کالابی انجامید، در بیش از ۱۰ مقاله مورد استناد قرار گرفته است.
اثبات ذاتی فرمول گاوس–بونه که شینگشن چرن در سال ۱۹۴۴ ارائه کرد و همچنین فرم چرن–سایمونز که او در سال ۱۹۷۴ همراه با جیمز سایمونز معرفی کرد، هرکدام در سه پژوهش به کار رفتهاند. در یکی از این آثار صراحتاً آمده است: «ما از تابعی تراروی چرن–سایمونز استفاده میکنیم.» مسئله سطح ماکسیمال آفین نیز که در دو پژوهش دیگر بررسی شده، دقیقاً همان مسئلهای است که شینگشن چرن در سال ۱۹۷۹ مطرح کرده بود.
در حوزه تحلیل هارمونیک که اخیراً پیشرفت چشمگیری داشته است، مقاله OpenAI درباره مسئله کاکیا در چهار بعد بر اثبات حدس کاکیا در سه بعد توسط هونگ وانگ و جاشوا زال در سال ۲۰۲۵ استوار است. شرط بورگن که در این اثبات به کار رفته نیز به پژوهش سال ۲۰۲۴ هونگ وانگ، شائومینگ گوئو و رویشیانگ ژانگ ارجاع میدهد. در مسئله نزدیک به آن، یعنی بوخنر–ریس، پژوهش سال ۲۰۲۵ شائومینگ گوئو، چانگکون اوه، هونگ وانگ، شوکون وو و رویشیانگ ژانگ، در کنار برآورد محدودسازی دوخطی ترنس تائو در سال ۲۰۰۳، بهعنوان منابع روش بستههای موجی ذکر شدهاند.
مقالهای درباره حدس فراوانی از معیار مربوط به برگبندیها که چنیانگ شو و لی ژانگ ارائه کردهاند پیروی میکند. مقاله دیگری درباره گازهای کره سخت نیز برآوردهای یو دنگ، ظاهر هانی و شیائو ما را برای استخراج معادله بولتزمن از دینامیک ذرات به کار میگیرد.
تکنگاشت گانگ تیان و جان مورگان درباره جریان ریچی و حدس پوانکاره، اثبات حدس ارضاپذیری توسط جیان دینگ، آلن اسلای و نایکی سون، و همچنین مقاله سال ۱۹۵۷ چننینگ یانگ، تسونگدائو لی و کرسون هوانگ درباره گازهای بوزونی کره سخت، همگی در فهرست منابع این آثار دیده میشوند...
این الگو تنها به ریاضیات محدود نیست و درباره دیگر کشفیات علمی نیز صدق میکند. مقاله OpenAI درباره معادلات ناویر–استوکس از معادلهای آغاز میکند که اویلر در سال ۱۷۵۷ مطرح کرد؛ سپس به مفهوم جواب ضعیف که لره در سال ۱۹۳۴ ارائه داد و قضیه منظمبودن جزئی کافارلی، کوهن و نیرنبرگ میپردازد. سامانه آلفافولد گوگل نیز با ساختار پروتئینهایی آموزش دیده که زیستشناسان ساختاری طی دههها، یکبهیک تعیین کردهاند. مبنای علمی این رویکرد را میتوان تا مقاله آنفینسن در سال ۱۹۷۳ دنبال کرد که نشان میداد توالی یک پروتئین، شکل آن را تعیین میکند.
مهندسان ماشین را میسازند و دانشمندان دانش لازم برای یادگیری را فراهم میکنند
در مدلهایی مانند GPT و Claude که توانایی دستیابی به پیشرفتهای علمی را دارند، مهندسان مسئول ساخت ماشین هستند؛ از معماری و کدهای آموزش گرفته تا زیرساخت پردازش داده و توان محاسباتی. در مقابل، دانشمندان محتوای باکیفیتی را فراهم میکنند که مدل باید از آن بیاموزد و همچنین در تعیین مسیر حرکت آن نقش دارند. در مرحله پیشآموزش، مدل یاد میگیرد بر اساس متن پیشین، واژه بعدی را پیشبینی کند.
در یکی از مقالات تولیدشده با هوش مصنوعی آمده است: «بر اساس قضیه تجزیه کلافهای برداری روی خط تصویری، E مجموع مستقیم چند کلاف خطی است.» اما این واقعیت ریاضی را خود مدل کشف نکرده است.
الکساندر گروتندیک در سال ۱۹۵۷ صورت کلاسیک این نتیجه را ارائه کرد. از آن زمان تاکنون، ریاضیدانان بارها این گام استدلالی را در مقالات، کتابهای درسی و جزوههای آموزشی خود نوشتهاند.
شهود دانشمند در این است که بداند در گام بعد باید از کدام لم استفاده کند؛ اما آنچه شهود مدل نامیده میشود، احتمالی است که از هزاران هزار «گام بعدی» نوشتهشده به دست انسانها برآورد میکند. در مرحله تنظیم دقیق نظارتشده، مدل با مجموعهای از زنجیرههای استدلالی که با دقت انتخاب شدهاند، میآموزد چگونه مسائل را گامبهگام حل کند. برخی از این زنجیرهها را انسانها نوشتهاند و برخی دیگر را خود مدل تولید کرده است. بااینحال، زنجیرههای تولیدشده توسط مدل نیز از مسائل و دستورالعملهایی آغاز میشوند که انسانها تعیین کردهاند و تصمیم درباره نگهداشتن یا کنارگذاشتن آنها بر اساس آزمونهایی گرفته میشود که انسانها طراحی کردهاند.
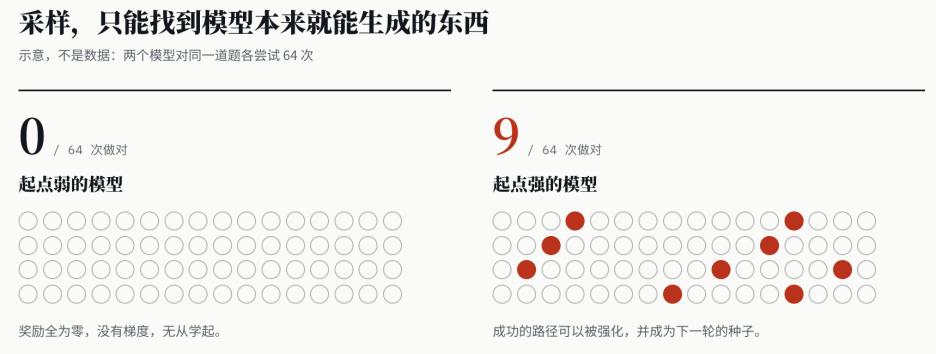
یادگیری تقویتی در مرحله پایانی و نمونهگیری هنگام استنتاج، تنها میتوانند تواناییهایی را تقویت کنند یا پاسخهایی را بیابند که مدل از ابتدا امکان تولید نمونههایی از آنها را داشته است.
در یادگیری تقویتی و نمونهگیری هنگام استنتاج، مدل بارها برای حل یک مسئله تلاش میکند و سامانه راستیآزمایی پاسخهای درست را نگه میدارد. این فرایند به نمونهگیری وابسته است: اگر مدل تقریباً هیچگاه نتواند اثبات درستی بنویسد، تمام پاداشها صفر خواهند بود و در نتیجه چیزی برای یادگرفتن وجود نخواهد داشت.
کیفیت دادههای آموزشی مراحل پیشین است که تا حد زیادی احتمال رسیدن به پاسخ درست را از وضعیتی نزدیک به صفر به رخدادی هرچند گاهبهگاه تبدیل میکند. به بیان ساده، مهندسان امکان یادگیری را فراهم میکنند، اما بخش بزرگی از دانشی که میتوان آموخت، حاصل تلاش دانشمندان رشتههای مختلف است.
دانشمندان سیگنالهای یادگیری باکیفیت فراهم میکنند
پیشآموزش و تنظیم دقیق نظارتشده، شهود و روشهای استدلال را در اختیار مدل قرار میدهند؛ اما دستیابی به نتایج تازه در مرزهای دانش به نمونهگیری گسترده وابسته است. این فرایند میتواند در قالب یادگیری تقویتی هنگام آموزش یا جستوجو و استفاده از عاملهای هوشمند هنگام استنتاج انجام شود. وجه مشترک همه این روشها آن است که مدل فرصت پیدا میکند برای حل یک مسئله بارها تلاش کند و سپس سامانه راستیآزمایی تعیین میکند کدام تلاشها پذیرفتنی هستند.
مسیرهای موفق حل مسئله میتوانند به دادههای آموزشی دور بعدی تبدیل شوند. اما برای آنکه این چرخه «تلاش و راستیآزمایی» واقعاً به افزایش توانایی مدل منجر شود، کیفیت سیگنال تعیینکننده است. گرادیان مشخص میکند مدل از هر نمونه چه چیزی بیاموزد و کیفیت آن نیز به سیگنال زیربنایی وابسته است.
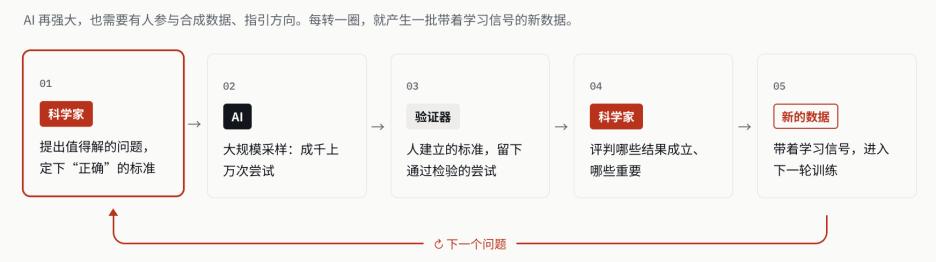
بخش بزرگی از سیگنالهای قوی را دانشمندان فراهم میکنند. اثباتهای دقیق، گامهای بعدی روشنی برای یادگیری در اختیار مدل میگذارند؛ انتخاب درست مسائل مانع از آن میشود که همه پاداشها صفر یا یک باشند؛ و سامانههای راستیآزمایی دقیق اطمینان میدهند که سیگنالها مدل را در مسیر درست هدایت میکنند. چه نمونهگیری هنگام آموزش انجام شود و چه هنگام استنتاج، دانشمندان میتوانند در سه بخش این چرخه نقش داشته باشند.
۱. انتخاب مسائل. آموزش زمانی بیشترین بازده را دارد که مدل روی مسائلی کار کند که حل آنها «در آستانه تواناییاش» قرار دارد. صرف توان محاسباتی هنگام استنتاج نیز برای همین دسته از مسائل بیشترین ارزش را دارد. مسائل خوب، بذرهای ارزشمندی برای دور بعدی آموزش مدل فراهم میکنند، درحالیکه مسائل متوسط تنها بذرهایی متوسط بر جای میگذارند. تشخیص چنین مسائلی به چیزی نیاز دارد که دانشمندان آن را «ذوق علمی» مینامند. فهرست مسائل پل اردوش، شینگتونگ یائو و داوید هیلبرت دقیقاً نمونههایی از همین توانایی در انتخاب مسائل ارزشمند هستند.
۲. تعیین معیار درستی. در مرحله آموزش، سامانه راستیآزمایی میزان پاداش را تعیین میکند و هنگام استنتاج، از میان تلاشهای متعدد مشخص میکند کدام پاسخ باید حفظ شود. اگر معیار راستیآزمایی سهلگیرانه باشد، مدل در جریان آموزش راههایی برای سوءاستفاده از ضعفها و خلأهای آن پیدا میکند. یکی از دلایلی که ریاضیات توانسته به نخستین عرصه آزمون این روشها تبدیل شود، آن است که ریاضیدانان از مدتها پیش مفهوم «اثبات» را با دقتی بسیار بالا تعریف کردهاند.
۳. داوری درباره نتایج. در ۷ اکتبر، OpenAI پس از شناسایی یک خطای نمادین، سه مقاله را پس گرفت و ۱۴ مقاله دیگر را اصلاح کرد. در یادداشت مخزن این شرکت نیز آمده است که برخی نتایج صورتبندینشده به شکل صوری «ممکن است مشکل داشته باشند». تشخیص اینکه کدام نتایج معتبرند، کدامیک اهمیت دارند و صرف توان محاسباتی در دور بعدی برای چه مسیرهایی ارزشمند است، همچنان بر عهده جامعه علمی قرار دارد.
بنابراین، هوش مصنوعی هر اندازه هم قدرتمند شود، همچنان به هدایتکننده نیاز دارد. میتوان این وضعیت را به استخراج نفت تشبیه کرد: حتی اگر دستگاه حفاری بسیار نیرومند باشد، این زمینشناسان هستند که باید محل حفاری را تعیین کنند و تشخیص دهند ماده استخراجشده واقعاً نفت است یا نه. در چرخهای که از این فرایند شکل میگیرد، دانشمندان مسائل را انتخاب میکنند، معیارهای درستی را تعیین میکنند و درباره نتایج داوری میکنند؛ درحالیکه هوش مصنوعی میتواند در مقیاسی فراتر از توان انسان، راهحلهای گوناگون را بیازماید.
اگر دانشمندان کنار بکشند، سیگنال گرادیان ضعیف خواهد شد
اگر دانشمندان واقعاً از این فرایند کنار بکشند، چه اتفاقی خواهد افتاد؟
مدل همچنان به نمونهگیری و آزمودن راهحلها ادامه خواهد داد؛ اما بهتدریج به سمت مسائل محدودتر هدایت میشود، برای غربالکردن پاسخها از سامانههای راستیآزمایی سهلگیرانهتری استفاده میکند و نمونهگیریهای بعدی خود را بر پایه دادههایی هرچه یکنواختتر شکل میدهد. بدون ابزارهای مناسب، نمونهگیری نمیتواند به دانش جدید دست یابد. مسئله نگرانکنندهتر این است که در نبود راستیآزمایی بیرونی، مدلی که عمدتاً از خروجیهای خودش تغذیه میکند، بهتدریج دچار افت عملکرد خواهد شد.
پژوهشهای موجود نشان دادهاند که اگر یک مدل بارها با دادههای تولیدشده توسط خودش آموزش ببیند، بخشهای نادر توزیع دادهها را از دست میدهد و بهتدریج کیفیت آن کاهش مییابد. طرح مسائل تازه، ارائه ایدههای جدید، تولید دادههای آزمایشی نو و ساخت ابزارهای لازم برای آزمودن آنها، همچنان به مشارکت دانشمندان نیاز دارد؛ دانشمندانی که پرسش مطرح میکنند، آزمایش طراحی میکنند و نتایج را میسنجند. ممکن است در آینده بخشی از دادههای جدید از چرخه بسته تعامل میان هوش مصنوعی و جهان فیزیکی، برای مثال در آزمایشگاههای خودکار، به دست آید. بااینحال، تصمیمگیری درباره اینکه چه آزمایشی باید انجام شود، آیا اندازهگیریها دقیق هستند و نتایج چه معنایی دارند، همچنان به حضور متخصصان همان حوزه علمی وابسته خواهد بود.
ازاینرو، این ادعا که «هوش مصنوعی میتواند همهچیز را حل کند و دیگر نیازی به دانشمندان نیست»، صرفاً مسئلهای مربوط به جایگاه دانشمندان نیست. چنین دیدگاهی بر جهتگیری مشوقهای اجتماعی و همچنین بر تمایل جوانان به ورود و وقف زندگی خود به فعالیت علمی تأثیر میگذارد. هر دو عامل در نهایت بر خود مدل نیز اثر خواهند گذاشت: اگر شمار این افراد کاهش یابد، مسائل تازه و سامانههای راستیآزمایی نیز کمتر خواهند شد و در نتیجه سیگنال گرادیان بهطور طبیعی ضعیفتر میشود.
سخن پایانی
هزاران سال، انسان تنها موجود هوشمندی بوده که به پژوهش علمی پرداخته است و بسیاری از کشفیات، حاصل تلاش یک عمر دانشمندان بودهاند.
امروز ابرهوش به مرزهای دانش نزدیک شده است و توانایی آن در اثبات، کشف و پیشبینی پیوسته گسترش خواهد یافت.
اما هر پیشرفتی بر پایه همان چراغهای فروزان علم بنا میشود؛ برترین اندیشهها، عمیقترین تنهاییها و طولانیترین تلاشهای بشر.
دانشمندان پلی هستند که دانش بشری را به هوش مصنوعی پیوند میدهد. این نوشته ادای احترامی به دانشمندان در عصر هوش مصنوعی است؛ نام آنها باید در کنار دستاوردهایی ثبت شود که بر پایه پژوهشهایشان شکل گرفتهاند.
پروژه پژوهشی On Whose Shoulders از تیم هوش مصنوعی SeaFill به ابتکار چیونگشیو لی، استادیار آزمایشگاه امنیت هوش مصنوعی دانشگاه آلبورگ دانمارک، آغاز شده است.
منابع:
seafill.info/Shoulders
این مقاله از حساب رسمی ویچت عصر هوش مصنوعی (AI Era) به قلم LRST منتشر شده و وبسایت 36Kr آن را با مجوز بازنشر کرده است.