
افشای نقشه راه تحقیقاتی آنتروپیک؛ طرح اولیه Claude Code پنج سال پیش تدوین شده بود
باورنکردنی است! مگر آنتروپیک از آینده خبر داشته است؟
در جریان یک شکایت حقوقی مربوط به حق نشر، نقشه راه تحقیقاتی داخلی آنتروپیک که تاریخ آن به ژوئیه ۲۰۲۱ بازمیگردد، بهطور اتفاقی افشا شده است.
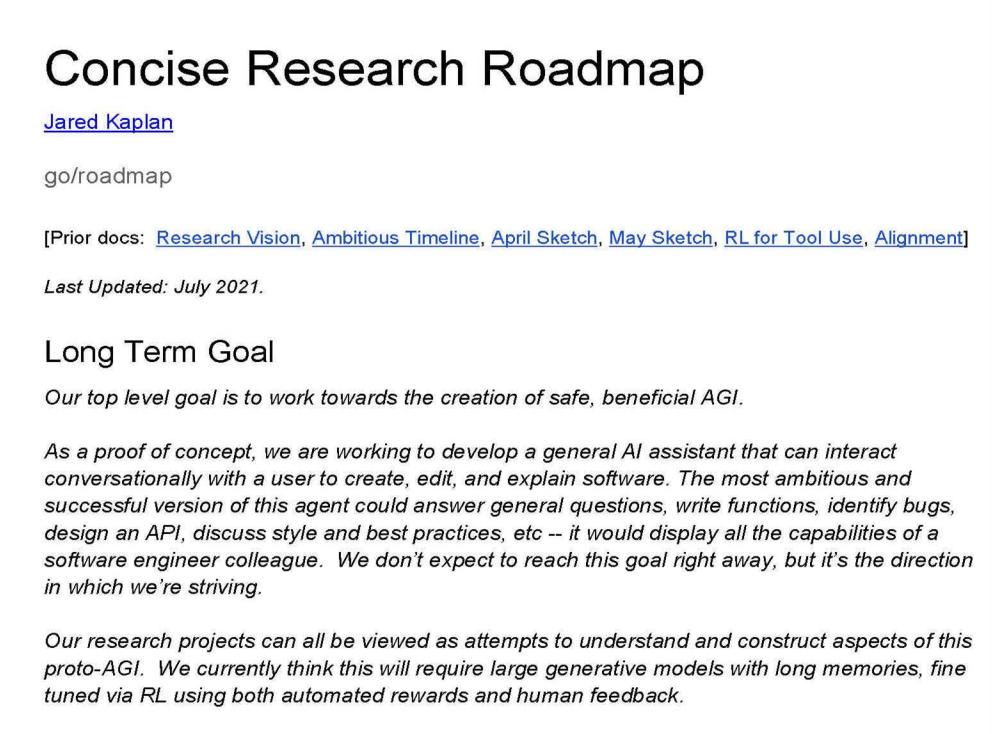
این سند بسیار کوتاه است و محتوای اصلی فایل PDF آن فقط دو یا سه صفحه را شامل میشود.
اما وقتی این سند را که در آن زمان برچسب «فوقمحرمانه» داشت، از ابتدا تا انتها خواندم، واقعاً شوکه شدم؛ البته کمی هم اغراق میکنم!
از Claude Code امروزی گرفته تا استفاده از ابزارها (Tool Use)، خودارزیابی هوش مصنوعی، محاسبات زمان استنتاج (Test-time Compute)، مدلهای دارای تریلیونها پارامتر و حتی پنجرههای زمینه فوقطولانی...
همه این ایدهها پنج سال پیش، تنها چند ماه پس از جدا شدن بنیانگذاران آنتروپیک از OpenAI و زمانی که این شرکت در مجموع فقط حدود دوازده کارمند داشت، بهروشنی در سند ثبت شده بودند.
نقشه راهی که پنج سال پیش نوشته شد
بسیاری تصور میکردند تبدیل مدلهای زبانی بزرگ از چتباتهای ساده به عاملهای هوشمندی که میتوانند کدنویسی کنند و با سیستمعامل کار کنند، نتیجه طبیعی پیشرفت فناوری در دو سال اخیر بوده است.
اما این تصور اشتباه است.
آنتروپیک در همان ابتدای نقشه راه سال ۲۰۲۱، برای هدف نهایی خود، یعنی دستیابی به هوش مصنوعی عمومی ایمن و سودمند (Safe, Beneficial AGI)، تصویر کاملاً مشخصی از محصول موردنظرش ارائه کرده بود:
ساخت یک دستیار هوش مصنوعی همهمنظوره که بتواند از طریق زبان طبیعی با انسان تعامل کند و نرمافزار بسازد، آن را ویرایش کند و عملکردش را تحلیل و تفسیر کند.
اما منظور از دستیار هوش مصنوعی همهمنظوره چیست؟
چنین دستیاری باید بتواند به پرسشهای عمومی پاسخ دهد، تابعهای برنامهنویسی بنویسد، خطاهای نرمافزاری را پیدا کند، رابطهای برنامهنویسی کاربردی (API) طراحی کند و درباره سبک کدنویسی و بهترین شیوههای توسعه نرمافزار بحث کند.
اما شگفتانگیزترین بخش، جمله بعدی سند است:
این دستیار باید بتواند تمام تواناییهای یک همکار مهندس نرمافزار را به نمایش بگذارد.
یک لحظه صبر کنید! مگر این دقیقاً همان چیزی نیست که امروز Claude Code انجام میدهد؟
آن روزها مدت زیادی از مشهور شدن GPT-3 نگذشته بود و همه از اینکه هوش مصنوعی میتوانست شعرهایی بنویسد که حروف آغازین سطرهایشان پیام مشخصی را تشکیل میداد، شگفتزده بودند. اما آنتروپیک از همان ابتدا به تکمیل خودکار کد بهعنوان هدف نهایی نگاه نمیکرد؛ این شرکت مستقیماً ساخت یک عامل هوشمند با توانایی انجام وظایف کامل مهندسی نرمافزار را هدف گرفته بود.
جالبتر اینکه درباره مسیر عملی دستیابی به این هدف نیز بحث داخلی بسیار مهمی شکل گرفته بود.
اندی جونز، پژوهشگر این شرکت، در یکی از نظرات خود یک اختلافنظر اساسی را مطرح کرد: آیا ابتدا باید دستیاری برای برنامهنویسی ساخت که استفاده از آن واقعاً آسان باشد یا بهتر است پیش از هر چیز امکان استفاده مدل از ابزارها اثبات شود؟
تیم در آن زمان با دو مسیر روبهرو بود:
مسیر کاربردی: توسعه قابلیت جستوجو در مخزن کد (Repo Search) تا هوش مصنوعی بتواند به تعریف نوعهای داده در پروژهها دسترسی پیدا کند.
جالب است بدانید تام براون، نویسنده اول مقاله GPT-3، نیز در بحثهای مربوط به این مسیر حضور داشت و پیشنهاد کرده بود کار را با قابلیت مرور مخازن کد (Repo Browsing) آغاز کنند.
اما مسیر دوم چه بود؟
مسیر پژوهشی: توسعه قابلیت اشکالزدایی با printf و انجام عملیات در ویرایشگر کد، با این هدف که ابتدا ثابت شود مدل واقعاً میتواند ابزارها را فراخوانی و استفاده کند.
در نهایت، داریو، مدیرعامل آنتروپیک، تصمیم نهایی را گرفت:
در کوتاهمدت ابتدا امکانپذیر بودن استفاده از ابزارها را بررسی و اثبات میکنیم و در بلندمدت، آن را به یک دستیار برنامهنویسی بسیار کاربرپسند تبدیل خواهیم کرد.
حالا که به روند تکامل Claude Code نگاه میکنیم، میبینیم این محصول تقریباً گامبهگام همان مسیری را طی کرده که داریو در آن زمان ترسیم کرده بود.
خودارزیابی مدلها، تریلیونها پارامتر و حافظه فوقطولانی
این نقشه راه فقط به عاملهای برنامهنویسی محدود نمیشد و پیشبینیهایی درباره فناوریهای زیربنایی هوش مصنوعی نیز در آن دیده میشود.
برای مثال، در بخش پیشآموزش (Pre-training)، آنتروپیک در سال ۲۰۲۱ بهصراحت برنامه آموزش مدلهای بزرگی با یک تریلیون پارامتر (1T) یا بیشتر را مطرح کرده بود. این شرکت همچنین قصد داشت پنجرههای زمینه بسیار بزرگ یا سازوکارهای دیگری را بررسی کند که امکان نگهداری حجم عظیمی از اطلاعات، حافظه و تجربه را فراهم میکنند.
در دورانی که مدلهای ۱۷۵ میلیاردپارامتری غولپیکر محسوب میشدند، آنتروپیک از همان زمان مدلهای تریلیونپارامتری و حافظه فوقطولانی را بخشی از زیرساختهای اصلی آینده در نظر گرفته بود.
اما بخش مربوط به بازخورد انسانی و همراستاسازی هوش مصنوعی (Alignment) حتی جالبتر است.
در سند بهصراحت آمده است:
خودارزیابی مدل (Model Self-judging).
آنتروپیک از سال ۲۰۲۱ در حال بررسی این موضوع بود که چگونه میتوان مدل را قادر ساخت رفتار و کیفیت خروجی خودش را ارزیابی کند و سپس از همین قضاوت بهعنوان سیگنال بازخورد استفاده شود. این دقیقاً همان ایده محوری است که امروز در بازخورد مبتنی بر هوش مصنوعی (AI Feedback) و خوداصلاحی مدلهای استدلالی دیده میشود.
نکته جالبتر اینکه سند حتی به مفهومی اشاره میکند که بعدها به یکی از موضوعات بسیار مهم پژوهش درباره مدلهای بزرگ تبدیل شد:
محاسبات زمان استنتاج (Test-time Compute).
البته در آن زمان، این موضوع در چارچوب پژوهشهای همراستاسازی و مدلهای تمایزدهنده بررسی میشد و هنوز فاصله قابلتوجهی با گسترش محاسبات استدلالی به سبک مدل o1 در سالهای بعد داشت.
بااینحال، همین اشاره نشان میدهد که آنتروپیک از سال ۲۰۲۱ در چشمانداز پژوهشی خود، استفاده از توان محاسباتی در مراحلی فراتر از آموزش مدل را نیز در نظر گرفته بود.
در مجموع، باید اعتراف کرد که این آزمایشگاه تازهتأسیس واقعاً توانمند بوده است. حالا میفهمم چرا ایلیا تا این اندازه شگفتزده شده بود.
واقعاً کنجکاوم بدانم این روزها در آزمایشگاههای پیشرو هوش مصنوعی چه میگذرد و پژوهشگران آنها هر روز با چه ایدههایی سروکار دارند.
لحظات نگرانکننده در بحثهای داخلی
البته وقتی صحبت از آنتروپیک باشد، بحث ایمنی هوش مصنوعی هم ناگزیر مطرح میشود.
اما پس از خواندن سند متوجه شدم اعضای این شرکت واقعاً علاقه زیادی به بحث درباره ایمنی دارند؛ تا جایی که بخش بسیار مفصلی از نقشه راه را به این موضوع اختصاص دادهاند.
آنتروپیک که با محوریت ایمنی هوش مصنوعی تأسیس شده بود، در سال ۲۰۲۱ خطراتی را پیشبینی میکرد که امروز با گسترش عاملهای هوشمند در همهجا، به نگرانیهای جدی تبدیل شدهاند.
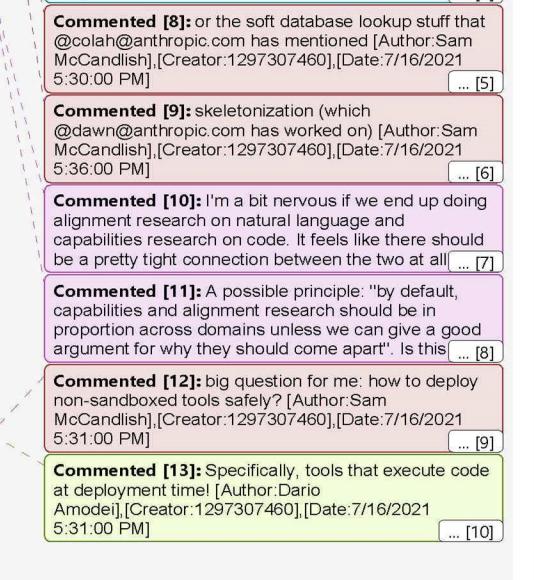
سم مککندلیش، یکی از بنیانگذاران شرکت، در یکی از نظرات خود پرسشی اساسی و نگرانکننده مطرح کرد:
چگونه میتوان ابزارها را بدون جداسازی در محیط ایزوله یا سندباکس (Sandbox)، بهشکلی ایمن مستقر و اجرا کرد؟
داریو بلافاصله در ادامه توضیح داد:
منظور بهطور مشخص ابزارهایی است که هنگام استقرار، کد اجرا میکنند!
راستی، علامت تعجب واقعاً در متن اصلی وجود دارد؛ داریوی شما تا این اندازه با شور و حرارت درباره موضوع صحبت کرده است!
واقعاً حیرتانگیز است.
وقتی هوش مصنوعی بتواند مستقیماً در محیط میزبان کد اجرا کند، فرمانهای شل (Shell) را فراخوانی کند و فایلها را تغییر دهد، خارج شدن آن از کنترل یا گرفتار شدنش در حملات تزریق پرامپت (Prompt Injection) میتواند پیامدهایی غیرقابلتصور داشته باشد.
امروز موضوعاتی مانند افزایش غیرمجاز سطح دسترسی عاملهای هوشمند، فرار از محیطهای محدودشده و آلودهسازی دادهها در سراسر اینترنت مورد بحث قرار گرفتهاند؛ اما پژوهشگران آنتروپیک از سال ۲۰۲۱ درباره مرزهای امنیتی سندباکس گفتوگو میکردند.
شاید دلیلش این باشد که از همان ابتدا قصد داشتند هوش مصنوعی را در همین مسیر توسعه دهند.
نکته دیگر اینکه نام آماندا نیز در این گزارش دیده میشود؛ همان فیلسوف داخلی آنتروپیک که مدتی پیش مورد توجه قرار گرفته بود.
او با جدیت به مسئله مهمی اشاره کرده بود:
کمی نگرانم که پژوهشهای همراستاسازی را روی زبان طبیعی انجام میدهیم، درحالیکه پیشرفت اصلی قابلیتهای مدل را در حوزه کدنویسی دنبال میکنیم. این دو حوزه پژوهشی باید همواره ارتباط نزدیکی با یکدیگر داشته باشند.
اگر پژوهشهای همراستاسازی را در همان حوزهای انجام ندهیم که قابلیتهای مدل در آن پیشرفت میکند، اثربخشی آزمونهای همراستاسازی محدود خواهد شد. این وضعیت ممکن است پیامدهای زنجیرهای ایجاد کند؛ برای مثال، پژوهشهای همراستاسازی بهدلیل ادغام نشدن با روند توسعه از مراحل اولیه، عملاً به حوزهای جداافتاده و منزوی تبدیل شوند.
آماندا حتی پیشنهاد کرد این موضوع به یکی از اصول رسمی شرکت تبدیل شود:
پژوهشهای توسعه قابلیتها و پژوهشهای همراستاسازی در حوزههای مختلف باید بهصورت همزمان و با نسبتی متناسب پیش بروند، مگر آنکه دلایل کافی و قانعکنندهای برای جدا کردن این دو مسیر وجود داشته باشد.
و یک نکته دیگر...
راستش مدتها برایم سؤال بود که چرا آنتروپیک همیشه یک قدم جلوتر از OpenAI به نظر میرسد. حالا ظاهراً پاسخ روشن شده است: مزیت پیشگام بودن.
آنتروپیک در پنج سال گذشته تمرکز خود را حفظ کرده و پیوسته روی سیگنالهای باکیفیت مرتبط با کدنویسی، یادگیری تقویتی و گردشکارهای سازمانی کار کرده است.
در مقابل، OpenAI در تمام این مدت همزمان در چندین جبهه فعالیت داشته است؛ از تولید تصویر از متن و ویدئوهای Sora گرفته تا دستیارهای صوتی و جستوجو. همین گستردگی فعالیتها احتمالاً تا حدی باعث پراکندگی تمرکز و توان این شرکت شده است.
اما درست زمانی که همه مشغول بررسی تفاوت مسیرهای فنی این دو شرکت بودند، ناگهان رسوایی تکاندهندهای در OpenAI مطرح شد؛ ماجرایی که حتی از داستان فیلمهای هالیوودی هم عجیبتر به نظر میرسد.
باور میکنید؟ ظاهراً در داخل OpenAI یک جاسوس پیدا شده است!
بر اساس کیفرخواستی که دادستانهای فدرال آمریکا منتشر کردهاند، عبدالرحمن الفوزان، مهندس ۳۵ ساله سابق تیم محصول OpenAI، رسماً از کار برکنار شده و با اتهامات کیفری فدرال روبهرو است.
اما او چه کرده بود؟
گفته میشود الفوزان در اتاق کنفرانس اصلی ویژه مدیران ارشد در دفتر مرکزی OpenAI در سانفرانسیسکو، مخفیانه یک دستگاه شنود مجهز به قابلیتهای پیشرفته رمزنگاری و انتقال داده را که در دستمال توالت پیچیده شده بود، به درگاه USB پشت تلویزیون متصل کرده بود.
نکته اینجاست که این اتاق کنفرانس محل برگزاری جلسات محرمانه مدیران ارشدی مانند سم آلتمن است؛ جلساتی که در آنها درباره اسرار تحقیق و توسعه ابرهوش مصنوعی، برنامههای محصولی اعلامنشده و گزارشهای مربوط به همکاری با دولت گفتوگو میشود.
و ظاهراً نفوذ به چنین محیط حساسی به همین سادگی امکانپذیر بوده است.
واقعاً گاهی احساس میکنم تمام دنیا با چند تکه وسیله سرهمبندیشده سر پا مانده است...
فایل PDF:
دریافت نقشه راه تحقیقاتی آنتروپیک
این مقاله از حساب رسمی ویچت QbitAI به قلم جی (Jay) منتشر شده و وبسایت 36Kr آن را با مجوز بازنشر کرده است.