
ساخت اپلیکیشنهای هوش مصنوعی با OGX؛ سرور متنباز API برای عاملهای هوشمند
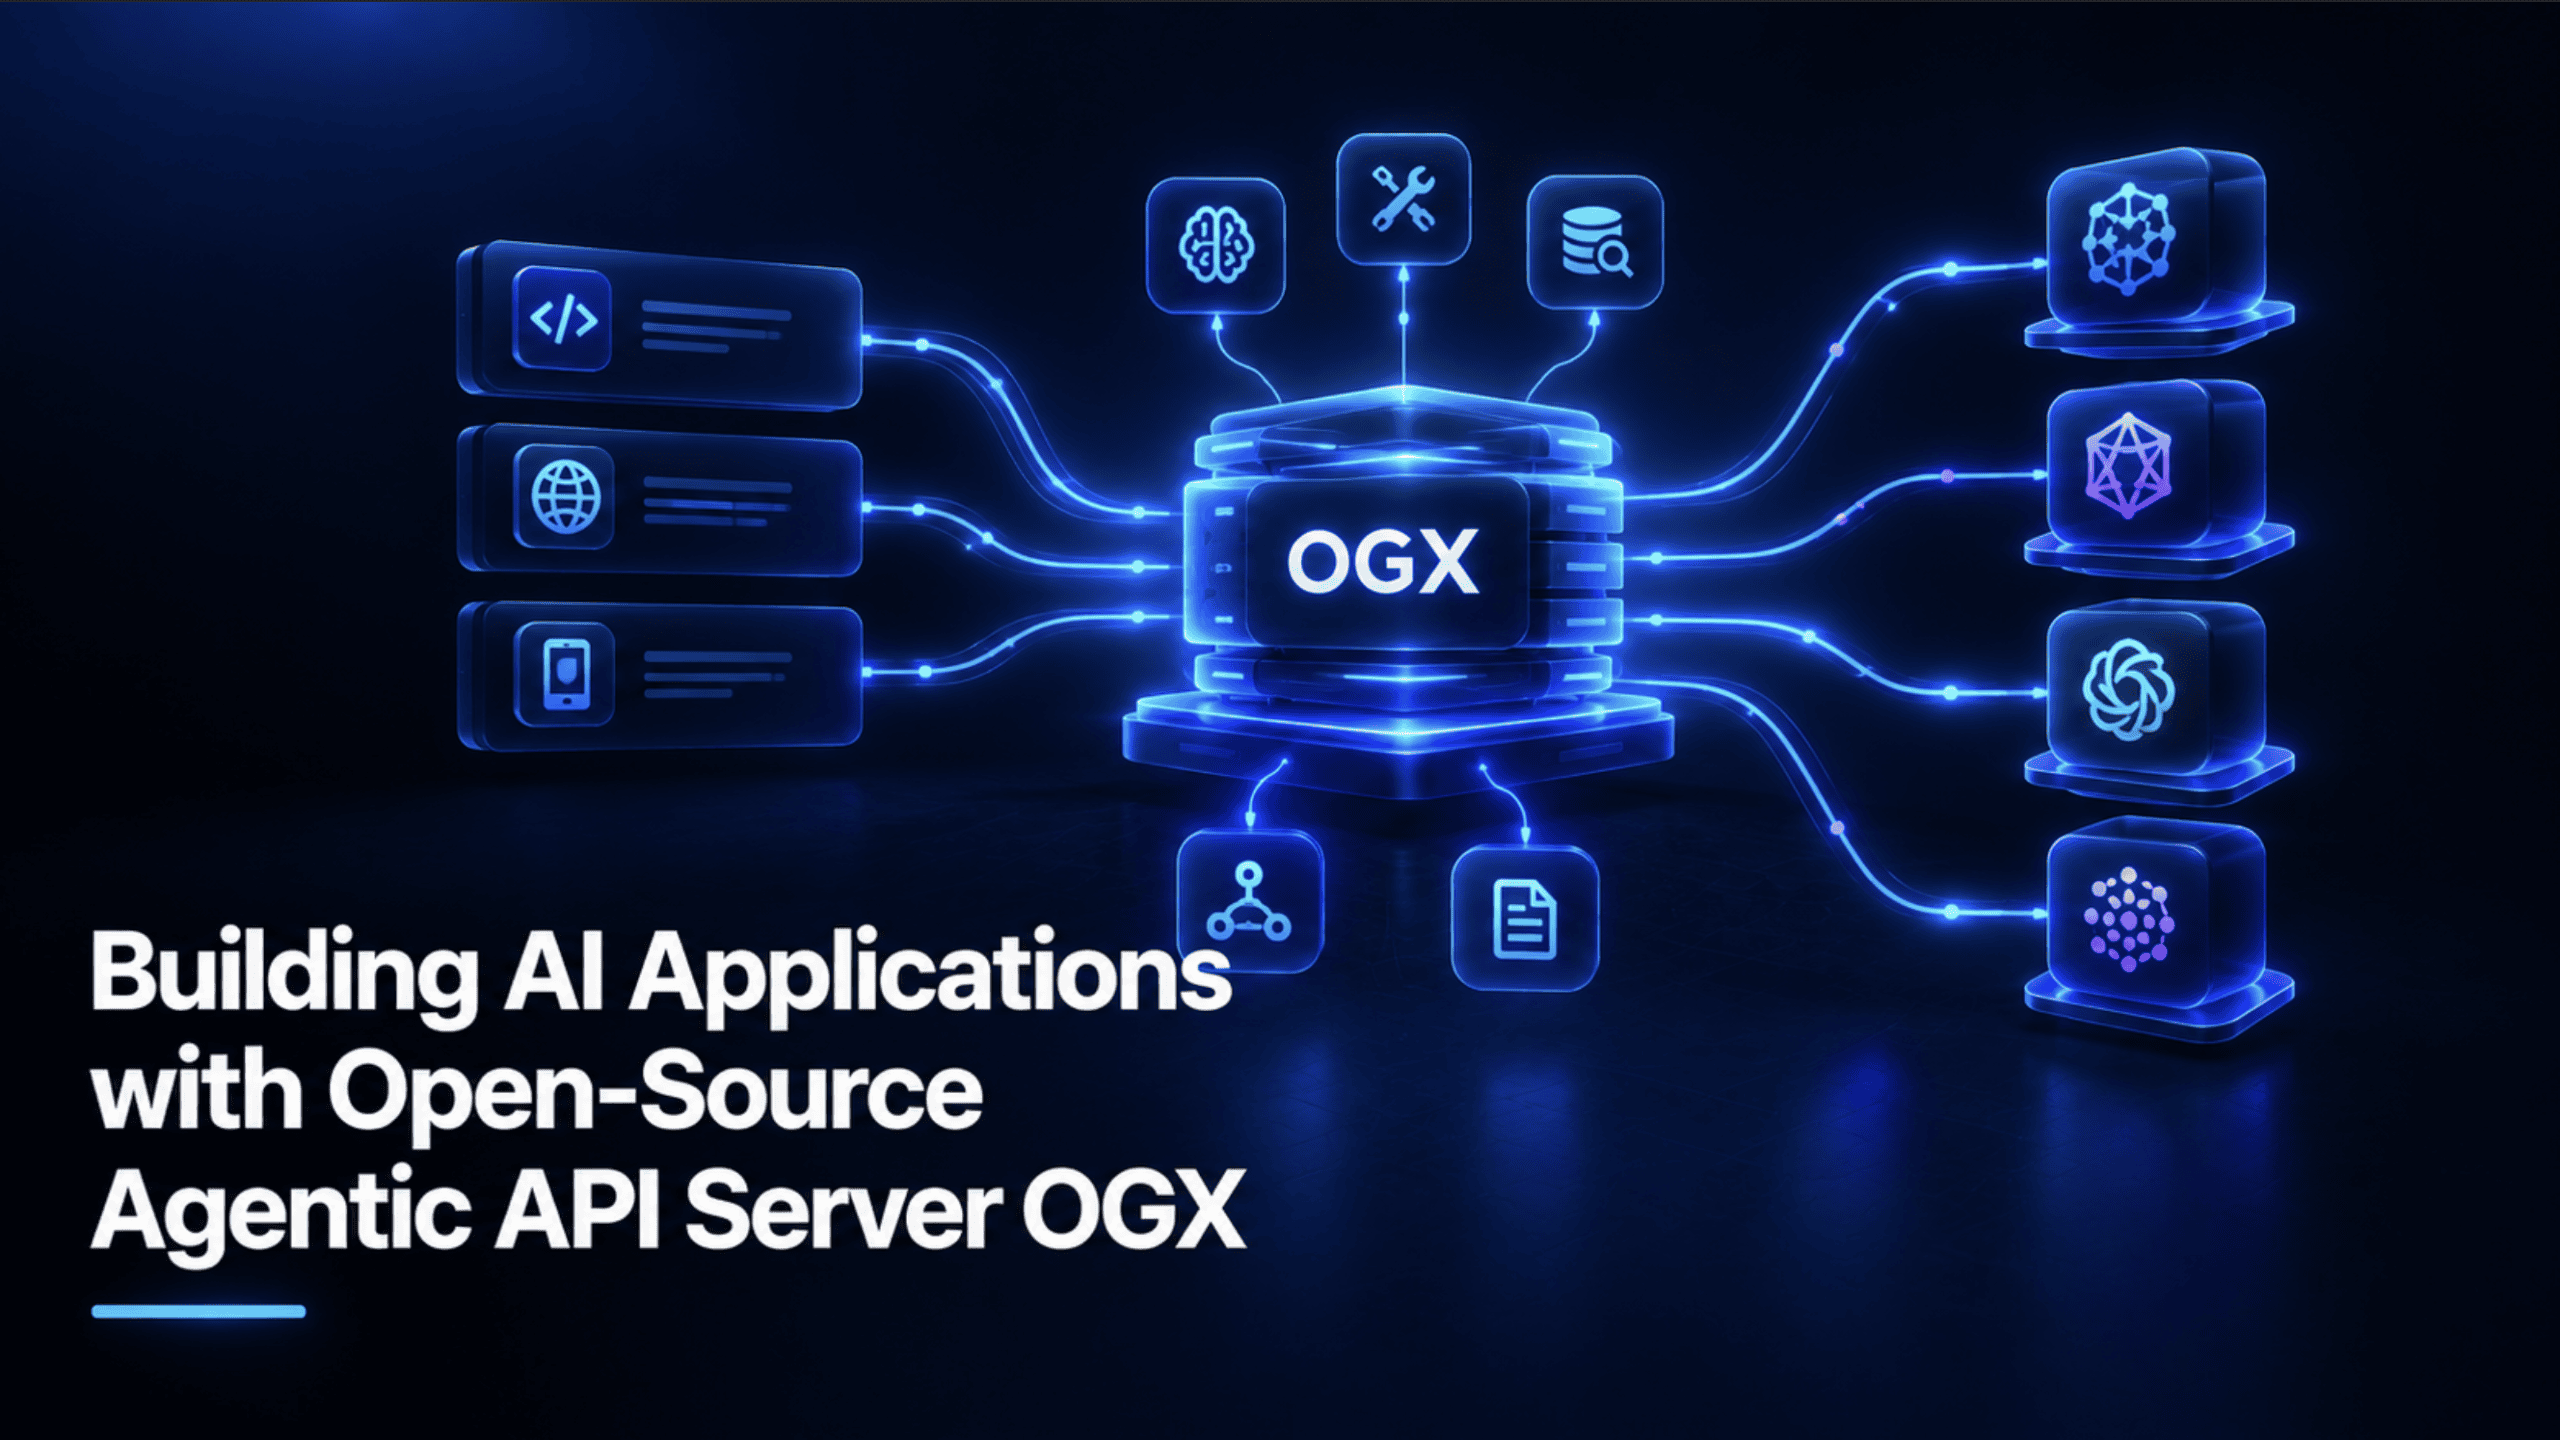
پیش از پرداختن به جزئیات، باید یک نکته مهم را روشن کنیم: OGX همان پروژه Llama Stack شرکت متا است که با نامی جدید توسعه پیدا میکند. در صفحه رسمی این پروژه در گیتهاب نیز بهصراحت اعلام شده است که «Llama Stack اکنون OGX نام دارد». البته این تغییر صرفاً به نام پروژه محدود نمیشود؛ بلکه با تغییر رویکرد آن به سمت پشتیبانی مستقل از مدلهای مختلف، سازگاری با چندین کیت توسعه نرمافزار (SDK) و آمادگی برای استفاده در محیطهای عملیاتی همراه شده است. بنابراین، OGX پروژهای کاملاً جدید و مستقل با معماری مشابه Llama Stack نیست. دانستن همین نکته بسیاری از ابهامهای موجود درباره سرورهای API مبتنی بر عاملهای هوشمند، رابطهای سازگار با OpenAI و توسعه محلی اپلیکیشنهای هوش مصنوعی را برطرف میکند؛ زیرا بخش قابلتوجهی از مطالبی که پیشتر درباره Llama Stack منتشر شدهاند، همچنان درباره OGX نیز صدق میکنند.
OGX چیست و چرا قبلاً Llama Stack نام داشت؟
OGX در معرفی رسمی خود، سروری متنباز برای ساخت اپلیکیشنهای هوش مصنوعی مبتنی بر عاملهای هوشمند معرفی شده است که با APIهای OpenAI سازگاری دارد و میتواند با هر مدل و زیرساختی کار کند. این پروژه با مجوز MIT منتشر شده و برخلاف بسیاری از پروژههای نوپا، جامعه کاربری قابلتوجهی دارد. هنگام نگارش این مقاله، مخزن آن در گیتهاب بیش از ۸۴۰۰ ستاره و ۱۴۰۰ فورک داشته است. همچنین جلسات منظم جامعه توسعهدهندگان برگزار میشود و توسعه پروژه بهصورت فعال ادامه دارد.
ایده اصلی OGX ارائه جایگزینی برای API شرکت OpenAI است که بتوانید آن را مستقیماً روی لپتاپ، در مرکز داده یا در فضای ابری اجرا کنید. سپس کافی است هر کلاینت یا چارچوب توسعه عامل هوشمندی را که با APIهای OpenAI سازگار است، به این سرور متصل کنید. پشت این رابط یکپارچه، معماری انعطافپذیری قرار دارد که امکان اتصال ارائهدهندگان مختلف مدل را فراهم میکند. برای مثال، میتوانید توسعه برنامه را روی رایانه شخصی و با Ollama آغاز کنید، نسخه عملیاتی را با vLLM اجرا کنید یا به یک سرویس ابری مدیریتشده متصل شوید. در تمام این حالتها، رابط API یکسان باقی میماند؛ بنابراین تغییر سرویس پردازش مدل در آینده نیازی به بازنویسی اپلیکیشن نخواهد داشت.
قابلیتهای OGX به تولید پاسخهای متنی در مکالمه محدود نیست. Responses API این پروژه امکان هماهنگسازی فرایندهای عاملمحور در سمت سرور، فراخوانی ابزارها، اتصال به سرورهای MCP و جستوجوی داخلی فایلها برای پیادهسازی تولید پاسخ مبتنی بر بازیابی اطلاعات (RAG) را در قالب یک فراخوانی API فراهم میکند. افزون بر این، OGX بهصورت بومی از SDKهای شرکتهای OpenAI، Anthropic و Google GenAI پشتیبانی میکند؛ یعنی میتوان همه آنها را به یک سرور متصل کرد و به کتابخانه کلاینت یک شرکت خاص محدود نبود.
در این آموزش، اپلیکیشنی به نام DocBrain میسازیم که دو قابلیت اصلی دارد. نخست، یک سامانه واقعی RAG ایجاد میکنیم که میتوانید اسناد خود را در آن بارگذاری کنید و بر اساس محتوای واقعی همان اسناد پاسخ بگیرید. بازیابی اطلاعات بهصورت خودکار انجام میشود و نیازی نیست پایگاه داده برداری را بهطور دستی به برنامه متصل کنید یا اسکریپت جداگانهای برای بازیابی اطلاعات بنویسید.
قابلیت دوم، استفاده واقعی از عامل هوشمند است. DocBrain هنگام بررسی اسناد میتواند ابزار سفارشی ما را فراخوانی کند، کارهایی را که نیازمند پیگیری هستند شناسایی کند و آنها را در فایلی واقعی روی دیسک ذخیره کند؛ برای مثال، مهلت تمدید قرارداد اجاره یا کاری که باید در آینده پیگیری شود. به این ترتیب، برنامه صرفاً توصیه نمیکند چه کاری انجام دهید، بلکه ثبت و مدیریت اطلاعات مربوط به آن کار را نیز بر عهده میگیرد.
پیشنیازها و نصب OGX
برای شروع به uv، ابزار سریع مدیریت بستههای پایتون، و یک زیرساخت محلی برای اجرای مدل نیاز دارید. در این آموزش از Ollama استفاده میکنیم. بااینحال، همین کدها بعداً بدون تغییر با vLLM یا یک ارائهدهنده ابری نیز کار خواهند کرد. این دقیقاً همان مزیتی است که معماری ارائهدهندگان در OGX فراهم میکند.
# Install Ollama, then pull a model
ollama pull llama3.2:3b

# Set up a real project (not the throwaway uvx command from a quick trial)
uv init docbrain && cd docbrain
uv add ogx openai
توضیح کد: دستور uv init ساختار یک پروژه واقعی را ایجاد میکند؛ برخلاف اجرای موقتی یک دستور uvx که معمولاً برای آزمایشهای سریع استفاده میشود. این تفاوت زمانی اهمیت پیدا میکند که پروژه از یک آزمایش پنجدقیقهای فراتر میرود و قرار است به برنامهای تبدیل شود که مرتب از آن استفاده میکنید. دستور uv add ogx openai نیز بسته سرور OGX و کلاینت استاندارد پایتون OpenAI را نصب میکند. همین کلاینت تمام چیزی است که DocBrain برای ارتباط با OGX نیاز دارد.
راهاندازی سرور و اطمینان از عملکرد صحیح آن
uv run ogx goاگر Ollama در حال اجرا باشد و مدل موردنظر را از قبل دریافت کرده باشید، این دستور سرور OGX را در نشانی https://localhost:8321 راهاندازی میکند. پیش از نوشتن کد اپلیکیشن، بهتر است مطمئن شوید سرور بهدرستی کار میکند:
curl -k -s https://localhost:8321/v1/models | python -m json.toolتوضیح کد: طبق مستندات OGX، این سرور بهصورت پیشفرض از HTTPS استفاده میکند و تنظیمات امنیتی اولیه آن از همان ابتدا فعال هستند. به همین دلیل، هنگام آزمایش محلی باید گزینه -k را به دستور curl اضافه کنیم تا بررسی اعتبار گواهی خودامضای سرور محلی انجام نشود. اگر سرور سالم باشد، پاسخ مسیر /v1/models فهرست مدلهای ثبتشده را نمایش میدهد. به این ترتیب، حتی پیش از نوشتن نخستین خط کد اپلیکیشن، میتوانید مطمئن شوید OGX راهاندازی شده و اتصال آن به Ollama درست برقرار است.
پیادهسازی یک گفتوگوی ساده با Responses API
ابتدا سادهترین درخواست واقعی را اجرا میکنیم. این نمونه الگوی اصلی تمام بخشهای بعدی آموزش خواهد بود:
import httpx
from openai import OpenAI

client = OpenAI(
 base_url="https://localhost:8321/v1",
 api_key="fake",
 http_client=httpx.Client(verify=False),
)

response = client.responses.create(
 model="ollama/llama3.2:3b",
 input="What is OGX?",
)
print(response.output_text)
توضیح کد: مقدار api_key="fake" یک مقدار موقت نیست که لازم باشد آن را با کلید واقعی جایگزین کنید. OGX هنگام استفاده از سرور محلی این مقدار را بررسی نمیکند و میتوانید هر رشتهای را در آن قرار دهید. عبارت http_client=httpx.Client(verify=False) نیز معادل گزینه -k در دستور curl است و بررسی گواهی امنیتی را هنگام توسعه محلی غیرفعال میکند.
نام مدل از الگوی provider/model-name پیروی میکند. در این مثال، مقدار ollama/llama3.2:3b به OGX اعلام میکند که درخواست باید به کدام ارائهدهنده پیکربندیشده ارسال شود. ویژگی response.output_text نیز راه سادهای برای دریافت متن نهایی پاسخ از Responses API است و دیگر نیازی به استخراج دستی پاسخ از آرایه choices ندارید.
افزودن قابلیت واقعی RAG: بارگذاری اسناد و ساخت پایگاه داده برداری
در این مرحله، قابلیت بازیابی داخلی OGX را به کار میگیریم. پیادهسازی آن به شکل چشمگیری مختصر است:
# Upload a document
file = client.files.create(
 file=open("lease_agreement.pdf", "rb"),
 purpose="assistants",
)

# Create a vector store and index the file
vector_store = client.vector_stores.create(
 name="docbrain-kb",
 file_ids=[file.id],
)

# Ask questions with file search
response = client.responses.create(
 model="ollama/llama3.2:3b",
 input="Summarize the key points",
 tools=[{
 "type": "file_search",
 "vector_store_ids": [vector_store.id],
 }],
)
print(response.output_text)
توضیح کد: دستور client.files.create فایل اصلی سند را بارگذاری میکند. مقدار purpose="assistants" مشخص میکند که محتوای فایل برای بازیابی اطلاعات توسط دستیار در نظر گرفته شده است، نه مثلاً بهعنوان مجموعهدادهای برای تنظیم دقیق مدل.
بخش اصلی پردازش با client.vector_stores.create انجام میشود. این همان کاری است که در بسیاری از آموزشهای RAG برای انجام دستی آن دهها خط کد نوشته میشود: تقسیم سند به بخشهای کوچکتر، تبدیل این بخشها به بردارهای عددی یا امبدینگ و نمایهسازی آنها در یک مخزن قابل جستوجو. OGX تمام این مراحل را در سمت سرور مدیریت میکند.
فهرست tools در فراخوانی responses.create نیز بازیابی اطلاعات را برای پرسش مشخصشده فعال میکند. ترکیب ابزار file_search با شناسه پایگاه داده برداری به OGX میگوید که پیش از تولید پاسخ، محتوای مرتبط را در آن مخزن جستوجو کند و پاسخ مدل را به اطلاعات بازیابیشده متکی سازد. تمام این فرایند بهصورت خودکار انجام میشود.
افزودن ابزار سفارشی برای شناسایی و ذخیره کارهای ضروری
اکنون به بخش واقعاً عاملمحور DocBrain میرسیم: ساخت یک تابع واقعی پایتون که مدل بتواند در صورت نیاز تصمیم بگیرد آن را فراخوانی کند.
# tools/action_items.py
import json
import os
from datetime import datetime, timezone

ACTION_ITEMS_FILE = "action_items.jsonl"

def save_action_item(description: str, source_document: str, priority: str = "medium") -> dict:
 """Appends one action item as a JSON line to a local file."""
 if not description.strip():
 raise ValueError("description cannot be empty")
 if priority not in ("low", "medium", "high"):
 raise ValueError(f"priority must be low, medium, or high, got '{priority}'")

 entry = {
 "description": description.strip(),
 "source_document": source_document.strip(),
 "priority": priority,
 "flagged_at": datetime.now(timezone.utc).isoformat(),
 }
 with open(ACTION_ITEMS_FILE, "a") as f:
 f.write(json.dumps(entry) + "\n")
 return {"status": "saved", "entry": entry}


def list_action_items() -> list[dict]:
 """Reads back every saved action item, an empty list if none exist yet."""
 if not os.path.exists(ACTION_ITEMS_FILE):
 return []
 with open(ACTION_ITEMS_FILE) as f:
 return [json.loads(line) for line in f if line.strip()]


ACTION_ITEM_TOOL_SCHEMA = {
 "type": "function",
 "name": "save_action_item",
 "description": (
 "Save a genuine, concrete action item found while reviewing a document. "
 "Only call this for real, actionable tasks, not general summary points."
 ),
 "parameters": {
 "type": "object",
 "properties": {
 "description": {"type": "string", "description": "The concrete action item, in one sentence"},
 "source_document": {"type": "string", "description": "Which uploaded document this came from"},
 "priority": {"type": "string", "enum": ["low", "medium", "high"]},
 },
 "required": ["description", "source_document"],
 },
}
توضیح کد: تابع save_action_item پیش از نوشتن هر اطلاعاتی در فایل، ورودیهای خود را اعتبارسنجی میکند. اگر توضیح کار خالی باشد یا مقدار نامعتبری برای اولویت تعیین شده باشد، تابع بلافاصله خطا ایجاد میکند تا اطلاعات نادرست بدون هشدار در فایل ذخیره نشوند.
انتخاب قالب JSON Lines نیز تصمیمی آگاهانه و کاربردی است. در این قالب، هر رکورد بهصورت یک شیء JSON در خطی جداگانه ذخیره میشود و رکوردهای جدید به انتهای فایل اضافه میشوند. افزودن یک خط جدید ساده است و حتی اگر فرایند هنگام نوشتن متوقف شود، نسبت به بازنویسی یک آرایه بزرگ JSON روش مطمئنتری به شمار میرود. در مقابل، برای افزودن صحیح یک عضو به آرایه JSON معمولی، باید هر بار کل فایل را خواند، تغییر داد و دوباره نوشت.
متغیر ACTION_ITEM_TOOL_SCHEMA نیز ساختاری است که تابع را به مدل معرفی میکند. مدل از طریق این تعریف متوجه میشود ابزار چه کاری انجام میدهد و چه ورودیهایی میپذیرد. در اینجا دقت و صراحت توضیحات اهمیت زیادی دارد. برای مثال، عبارت «فقط برای کارهای واقعی و قابل انجام از این ابزار استفاده کن» کمک میکند مدل صرفاً به دلیل مشاهده نکات کلی در خلاصه یک سند، ابزار را بیدلیل فراخوانی نکند. توضیحات مبهم معمولاً باعث میشوند مدل در موقعیتهایی که واقعاً نیازی به اقدام نیست، بیشازحد از ابزار استفاده کند.
اتصال تمام بخشها: ساخت دستیار کامل
# docbrain.py
import httpx
import json
from openai import OpenAI
from tools.action_items import save_action_item, ACTION_ITEM_TOOL_SCHEMA

client = OpenAI(
 base_url="https://localhost:8321/v1",
 api_key="fake",
 http_client=httpx.Client(verify=False),
)
MODEL = "ollama/llama3.2:3b"


def setup_knowledge_base(file_paths: list[str]) -> str:
 file_ids = []
 for path in file_paths:
 uploaded = client.files.create(file=open(path, "rb"), purpose="assistants")
 file_ids.append(uploaded.id)
 vector_store = client.vector_stores.create(name="docbrain-kb", file_ids=file_ids)
 return vector_store.id


def ask(question: str, vector_store_id: str) -> str:
 response = client.responses.create(
 model=MODEL,
 input=question,
 tools=[
 {"type": "file_search", "vector_store_ids": [vector_store_id]},
 ACTION_ITEM_TOOL_SCHEMA,
 ],
 )
 for item in response.output:
 if getattr(item, "type", None) == "function_call" and item.name == "save_action_item":
 args = json.loads(item.arguments)
 save_action_item(**args)
 return response.output_text


if __name__ == "__main__":
 vector_store_id = setup_knowledge_base(["lease_agreement.pdf", "vendor_contract.pdf"])
 answer = ask(
 "Summarize the key terms of these documents, and flag anything "
 "that needs action before a deadline.",
 vector_store_id,
 )
 print(answer)
توضیح کد: هر دو ابزار، یعنی file_search و ابزار سفارشی save_action_item، در یک فهرست tools و در قالب یک درخواست API قرار گرفتهاند. این دقیقاً یکی از اهداف اصلی طراحی Responses API است: بازیابی اطلاعات و فراخوانی ابزارهای سفارشی، دو سامانه مستقل نیستند که بهاجبار به یکدیگر متصل شده باشند؛ بلکه دو قابلیت در یک فهرست مشترک هستند که مدل میتواند هنگام تصمیمگیری هر دو را در نظر بگیرد.
حلقهای که روی response.output اجرا میشود، بخش تعیینکنندهای است که ابزار را از یک قابلیت صرفاً نمایشی به عملکردی واقعی تبدیل میکند. این حلقه تمام خروجیهای تولیدشده توسط مدل را بررسی میکند. هرگاه خروجی از نوع function_call باشد و نام تابع درخواستی با save_action_item مطابقت داشته باشد، آرگومانهای آن از قالب JSON استخراج و تابع واقعاً اجرا میشود. نتیجه این اجرا، ثبت یک خط اطلاعات در فایل action_items.jsonl روی دیسک است.
اجرای پروژه کامل
پس از راهاندازی Ollama و دریافت مدل، ابتدا سرور را اجرا کنید و سپس دستیار را با اسناد خود به کار بگیرید:
uv run ogx go # in one terminal
uv run python docbrain.py # in another, once the server is healthy
نام فایلهای lease_agreement.pdf و vendor_contract.pdf را با نام اسناد خود جایگزین کنید و پرسشی واقعی از دستیار بپرسید. اگر برنامه هنگام پاسخگویی، مهلت مهم یا کاری را شناسایی کند که نیازمند پیگیری است، پس از پایان اجرا فایل action_items.jsonl را بررسی کنید. در این فایل یک رکورد واقعی و ذخیرهشده خواهید دید؛ نه صرفاً متنی که در پنجره ترمینال نمایش داده شده و از مقابل چشمتان گذشته است.
جمعبندی
دلیل اصلی اینکه باید قابلیتهای OGX را جدی گرفت، هیچیک از ویژگیهایی نیست که بهتنهایی در این آموزش بررسی کردیم؛ بلکه امکاناتی است که این معماری برای آینده پروژه فراهم میکند. اپلیکیشنی که در اینجا ساختیم، بهطور کامل با یک مدل محلی در Ollama و بدون هزینه اجرا میشود. اما اگر روزی به پایداری و قابلیت اطمینان در سطح محیطهای عملیاتی نیاز پیدا کنید، میتوانید به vLLM یا یک ارائهدهنده میزبانیشده مهاجرت کنید. برای این کار کافی است نام مدل و تنظیمات ارائهدهنده را تغییر دهید و نیازی به بازنویسی اپلیکیشن نیست. منطق پایگاه داده برداری، ابزار سفارشی و حلقه مدیریت فراخوانیها همگی بدون تغییر باقی میمانند.
همین ویژگی است که تفاوت واقعی میان یک پوشش ساده برای API و یک پلتفرم کامل مبتنی بر عاملهای هوشمند را مشخص میکند. به همین دلیل، OGX میتواند پایه مناسبی برای توسعه یک پروژه ماندگار باشد؛ پروژهای که با افزایش نیازها و ورود به مرحله استفاده جدی، مجبور نباشید آن را کنار بگذارید و همهچیز را از ابتدا بسازید.
شیتو اولومیده مهندس نرمافزار و نویسنده فنی است که به استفاده از فناوریهای پیشرفته برای روایت جذاب موضوعات تخصصی علاقه دارد. او با دقت به جزئیات و توانایی سادهسازی مفاهیم پیچیده شناخته میشود. میتوانید او را در توییتر نیز دنبال کنید.