
جک کلارک از آنتروپیک پیشبینی خود درباره خودبهبودی هوش مصنوعی را به سال ۲۰۲۷ تغییر داد
جک کلارک، همبنیانگذار آنتروپیک، پیشبینی خود درباره زمانی که هوش مصنوعی میتواند به توانایی بهبود کامل خود دست یابد، از سال ۲۰۲۸ به ۲۰۲۷ تغییر داده است. یکی از دلایل این بازنگری، نتایج آزمون جدیدی است که توانایی مدلها در قضاوت پژوهشی را ارزیابی میکند. کلارک در یادداشت ۱۲ اکتبر خود به آزمون TasteVal اشاره کرده و نتایج آن را دلیلی برای بازنگری در این پرسش دانسته است که آیا مدلهای هوش مصنوعی میتوانند خلاقیت لازم برای پیشبرد پژوهشهای این حوزه را فراهم کنند یا خیر.
این پیشبینی که پیشتر نیز در نشریه The Rundown به آن پرداخته شده بود، به مفهوم «خودبهبودی بازگشتی» مربوط میشود؛ فرایندی چرخهای که در آن یک سامانه هوش مصنوعی پژوهشهای لازم برای آموزش نسخهای توانمندتر از خود را انجام میدهد و نسخه جدید نیز میتواند همین روند را تکرار کند. البته این برآورد، پیشبینی شخصی کلارک است و او در بازنگری اخیر خود احتمال عددی تازهای برای تحقق آن اعلام نکرده است.
آزمون TasteVal چه چیزی را اندازهگیری میکند؟
کلارک در یادداشت ۴ مه خود احتمال دستیابی به پژوهش خودکار هوش مصنوعی با توانایی آموزش نسخه جانشین را برای سال ۲۰۲۷ برابر با ۳۰ درصد و تا پایان سال ۲۰۲۸ حدود ۶۰ درصد برآورد کرده بود. تردید اصلی او به جهشهای خلاقانهای مربوط میشد که مدلها هنوز نتوانسته بودند توانایی خود را در انجام آنها بهشکلی قاطع نشان دهند.
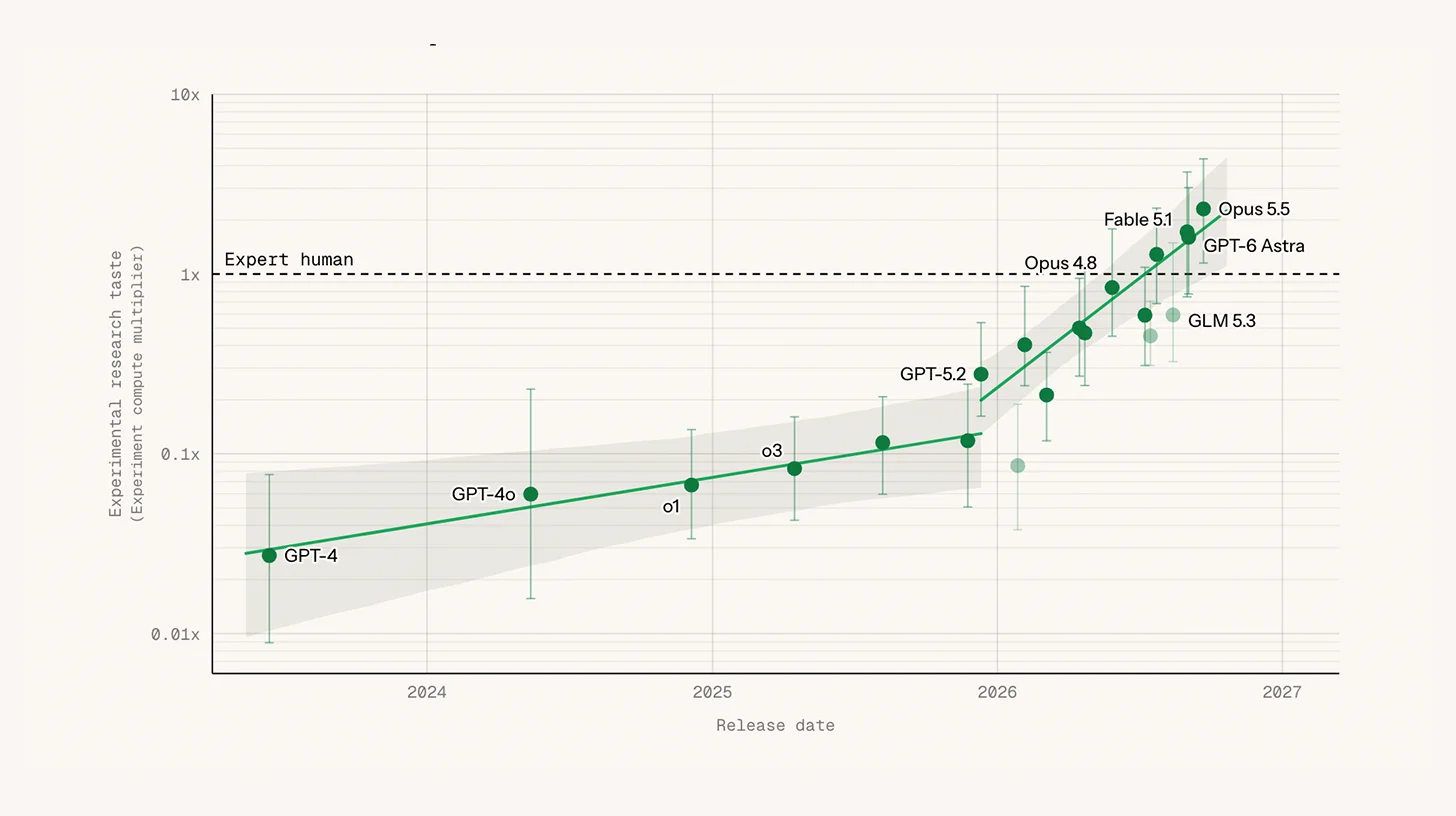
آزمون TasteVal که شرکت پژوهشی P-Zero Research طراحی کرده است، هشت مسئله ثابت در حوزه پژوهش هوش مصنوعی را در اختیار مدلها قرار میدهد. مدلها باید آزمایشها را طراحی و نتایج را تفسیر کنند، درحالیکه اجرای فنی آزمایشها بر عهده یک عامل کدنویسی جداگانه و ثابت است. برای مقایسه عملکرد مدلها با انسان، بهترین تلاش انجامشده برای هر مسئله از میان عملکرد ۲۴ متخصص انتخاب شده است؛ متخصصانی که اخیراً با سازمانهایی از جمله OpenAI و گوگل دیپمایند همکاری داشتهاند.
به گزارش P-Zero، مدل Opus 5.5 آنتروپیک از نظر شاخص بهرهوری محاسباتی آزمایشها، بهترین عملکرد را در میان مدلهای ارزیابیشده داشته است. برآوردهای ارائهشده در مقاله پژوهشی این شرکت نشان میدهد هزینه هر بار اجرای آزمون با Opus 5.5 حدود ۲۸۲ دلار بوده، درحالیکه هزینه اجرای مشابه توسط انسان به ۹٬۱۲۳ دلار رسیده است. به این ترتیب، میانگین هزینه هر تلاش برای انجام آزمون با این مدل تقریباً یکسیام هزینه انسانی بوده است. در محاسبه این هزینهها، مبالغ پرداختی برای استفاده از API مدلها، زمان پردازش GPU با نرخ ساعتی ۲٫۵۰ دلار و دستمزد نیروی انسانی با نرخ ساعتی ۱۱۹ دلار لحاظ شده است.
نویسندگان پژوهش اذعان کردهاند که بررسی درستی نتایج مسائل انتخابشده نسبتاً آسان است و گروه انسانی مبنای مقایسه نیز پژوهشگران طراز اول را شامل نمیشود. افزون بر این، مدل Opus 5.5 از انجام یکی از هشت مسئله خودداری کرده است و پژوهشگران نتیجه آن را بهعنوان داده مفقود در نظر گرفتهاند. بااینحال، مقایسه عملکرد در هفت مسئله باقیمانده نیز به نتیجهای مشابه منجر شده است.
پیشرفت در کدنویسی، محدودیتهای تازهای را آشکار میکند
آنتروپیک پیشتر نیز از جهش چشمگیر در حجم کدنویسی خبر داده بود. این شرکت در مطلب فنی منتشرشده در ۱۳ اکتبر اعلام کرد تعداد تغییرات کدی که روزانه در کد اصلی پروژهها ادغام میشوند، از حدود ۲٬۵۰۰ مورد در ماه مه به بیش از ۳۰ هزار مورد در سپتامبر رسیده است. به گفته آنتروپیک، «کدنویسی دیگر گلوگاه کار نیست» و اکنون مدیریت نسخههای کد منبع، فرایندهای ساخت نرمافزار و یکپارچهسازی مداوم به محدودیتهای اصلی تبدیل شدهاند.
چرا این موضوع اهمیت دارد؟
OpenAI نیز مارس ۲۰۲۸ را بهعنوان زمان هدف برای دستیابی به یک پژوهشگر خودکار هوش مصنوعی تعیین کرده است. در برنامه این شرکت، چنین پژوهشگری میتواند با هدایت انسانها در بهبودهای پیدرپی سامانههای هوش مصنوعی نقش داشته باشد. این هدف، در کنار پیشبینی جدید و نزدیکتر کلارک، از حرکت بهسوی آیندهای حکایت دارد که در آن هوش مصنوعی سهم بیشتری از پژوهشهای تعیینکننده توانایی سامانههای نسل بعد را بر عهده میگیرد.
برای آزمایشگاههای پژوهشی، بهبود توانایی قضاوت درباره آزمایشها میتواند استفاده مؤثرتری از بودجه محاسباتی موجود را امکانپذیر کند. اگر پیشرفتهای مشاهدهشده در آزمون TasteVal به پژوهشهای واقعی نیز تعمیم پیدا کنند، گروههای تحقیقاتی خواهند توانست با همان منابع قبلی به نتایج مفید بیشتری دست یابند. بااینحال، هنوز مشخص نیست چنین انتقالی تا چه اندازه امکانپذیر است؛ بهویژه در پژوهشهایی که نخستین و مهمترین گام آنها تشخیص این است که اساساً کدام مسائل ارزش بررسی دارند.
شتاب بزرگتر زمانی پدید میآید که یک چرخه بازخورد تکرارشونده شکل بگیرد. یک پژوهشگر هوش مصنوعی توانمند میتواند در آموزش نسخهای قویتر از خود مشارکت کند و نسخه جدید نیز در چرخه توسعه بعدی نقش مؤثرتری داشته باشد. اگر این فرایند بهدرستی عمل کند، پیشرفتها میتوانند در نسلهای متوالی روی هم انباشته شوند و سرعت بهبود را افزایش دهند. بنابراین، با وجود پیشرفتهای سریعی که آزمایشگاهها امروز گزارش میکنند، ممکن است شتابگیری واقعی هنوز آغاز نشده باشد.
تجربه آنتروپیک نشان میدهد افزایش سرعت تولید خروجی چگونه میتواند فشار کاری را به بخشهای دیگر منتقل کند. با افزایش حجم فعالیت عاملهای هوش مصنوعی، گروههای پژوهشی ممکن است با نیاز بیشتری به آزمایش، یکپارچهسازی و بررسی صحت نتایج روبهرو شوند. ازاینرو، آزمایشگاهها برای سنجش میزان سودمندی این افزایش خروجی باید پیشرفت خود را بر اساس کارهای تکمیلشده و اعتبارسنجیشده ارزیابی کنند، نه صرفاً حجم کار تولیدشده.
هدایت انسانی همچنان بخشی از هدف OpenAI است. انسانها اولویتهای پژوهشی را تعیین میکنند، نتایج را میسنجند و درباره گسترش مقیاس فعالیتها، توقف آنها یا استقرار سامانهها تصمیم میگیرند. این شرکت گزارش داده است که در بیش از نیمی از وظایف موفقی که انجام آنها برای یک انسان بین چهار تا هشت ساعت زمان میبرد، مداخله انسانی صورت گرفته است. بنابراین، سریعتر شدن آزمایشها ممکن است نیاز به بازبینی و قضاوت انسانی را نیز افزایش دهد.
OpenAI همچنین اعلام کرده است که هنوز نمیداند چگونه میتوان به خودبهبودی بازگشتی کامل بهشکلی ایمن دست یافت. بررسی میزان دفعاتی که مداخله انسان ضروری میشود و سنجش اینکه نتایج پژوهشها تا چه اندازه در بررسیهای بعدی معتبر باقی میمانند، میتواند به آزمایشگاهها کمک کند پیشرفت خود را در مسیر ایجاد چرخهای قابلاعتماد از مدلهایی که نسخههای جانشین خود را بهبود میدهند، ارزیابی کنند.
نویسنده: تیم تحریریه The Rundown | بازبینی: کلی پیتس | تاریخ انتشار: ۱۵ اکتبر ۲۰۲۶ | زمان مطالعه: ۳ دقیقه
این گزارش بر پایه مطالب منتشرشده در خبرنامه The Rundown در ۱۴ اکتبر ۲۰۲۶ تهیه شده است.