
طراحی مدارهای کوانتومی کارآمدتر با کلود
رایانههای کوانتومی برای اجرای الگوریتمهای کاربردی روی سختافزارهای محدود، به مدارهایی نیاز دارند که با دقت طراحی شده باشند. ما مشخصات هشت مدار را که از حوزههای شیمی، بهینهسازی، شبیهسازی فیزیکی و نظریه اعداد انتخاب شده بودند، به زبان طبیعی در اختیار کلود قرار دادیم و برنامهای خودکار نیز فراهم کردیم تا طرحهای آن را بررسی و امتیازدهی کند. کلود که عمدتاً بهصورت مستقل کار میکرد، مدارهایی طراحی کرد که از بهترین مدارهای منتشرشده پیشین کارآمدتر بودند؛ در برخی موارد، بهبود عملکرد به یک مرتبه بزرگی یا بیشتر میرسید. چنین پیشرفتهایی منابع کوانتومی موردنیاز برای کاربردهای عملی را بهشدت کاهش میدهند و میتوانند دستیابی به رایانههای کوانتومی کاربردی را زودتر از انتظار ممکن کنند.
این پژوهش را اندی گو در قالب برنامه پژوهشگران علوم، فناوری، مهندسی و ریاضیات (STEM Fellows Program) آنتروپیک هدایت کرد. الک کمنی، فیزیکدان کوانتومی آنتروپیک، راهنمایی این پروژه را بر عهده داشت و سوزان یلین از دانشگاه هاروارد و میخائیل لوکین از دانشگاه هاروارد و شرکت QuEra Computing نیز با گروه همکاری کردند. متن کامل مقاله در arXiv در دسترس است.
رایانههای کلاسیک اطلاعات را در قالب بیتهایی ذخیره میکنند که مقدار هرکدام یا صفر است یا یک. در مقابل، رایانههای کوانتومی از کیوبیت استفاده میکنند؛ واحدهایی که میتوان آنها را با اتمهای منفرد، مدارهای ابررسانا یا ذرات نور ساخت. کیوبیتها از پدیدههای کوانتومی مانند برهمنهی بهره میبرند؛ پدیدهای که به یک سامانه کوانتومی اجازه میدهد همزمان ترکیبی از چند حالت را داشته باشد. این ویژگی میتواند پردازش اطلاعات را به شیوههایی ممکن کند که حل برخی مسائل در حوزههایی مانند شیمی، علم مواد و نظریه اعداد را عملی میسازد؛ مسائلی که ممکن است برای رایانههای متعارف بیش از حد دشوار باشند.
رایانههای کوانتومی ساختهشده تا امروز تنها صدها تا چند هزار کیوبیت دارند؛ تعداد محدودی که برای اجرای بسیاری از الگوریتمهای دارای مزیت عملی بالقوه نسبت به رایانههای کلاسیک کافی نیست. افزون بر این، کیوبیتها بهشدت در برابر نویز محیطی، از جمله گرما، ارتعاش و حتی پرتوهای کیهانی، حساساند. اختلالی بسیار کوچک میتواند حالت یک کیوبیت را تغییر دهد و انباشتهشدن این خطاهای جزئی در نهایت باعث شود رایانه پاسخ نادرستی تولید کند.
از آنجا که هم کیوبیتها و هم زمان محاسباتی منابعی محدودند، پژوهشگران میکوشند الگوریتمهای کوانتومی را بهگونهای بازطراحی کنند که با کیوبیتهای کمتر و در زمان کوتاهتری اجرا شوند. نمونهای روشن از اهمیت این کار، شبیهسازی FeMoco است؛ خوشهای از آهن و گوگرد که در مرکز آنزیم نیتروژناز قرار دارد. باکتریها از این آنزیم برای تبدیل نیتروژن موجود در هوا به آمونیاک استفاده میکنند. شناخت سازوکار آن میتواند به دانشمندان در طراحی کاتالیزورهای صنعتی بهتر کمک کند؛ موادی که تولیدکنندگان برای سرعتبخشیدن به واکنشهای شیمیایی به کار میبرند.
پژوهشگران در سال ۲۰۱۷ برآورد کردند که برای محاسبه انرژی حالت پایه FeMoco، یعنی انرژی پایدارترین آرایش آن که شیمیدانان برای پیشبینی واکنشهای این خوشه به آن نیاز دارند، حدود ۵۰ تریلیون دروازه تافولی لازم است. رایانههای کوانتومی نیز مانند رایانههای معمولی با اجرای توالیهای طولانی از عملیات سادهای به نام «دروازه» روی کیوبیتها محاسبه میکنند. دروازه تافولی یکی از پرهزینهترین دروازهها برای اجراست؛ ازاینرو، شمارش این دروازهها روشی متداول برای برآورد زمان موردنیاز یک محاسبه محسوب میشود.
در پی مجموعهای از پیشرفتهای الگوریتمی، برآورد تعداد دروازههای موردنیاز به حدود ۳۴۰ میلیون کاهش یافته است؛ یعنی تقریباً ۱۵۰ هزار برابر کمتر از برآورد اولیه. این میزان به چند ساعت محاسبه روی یک رایانه کوانتومی آینده با حدود سه میلیون کیوبیت فیزیکی نیاز دارد.۱
این کاهشها عمدتاً حاصل بازطراحی مدارهای انجامدهنده محاسبات بودهاند، نه پیشرفت در سختافزار. کلود در بهینهسازی الگوریتمهای کلاسیک توانایی چشمگیری نشان داده است؛ بنابراین، میخواستیم بررسی کنیم که آیا اگر فقط توضیحی به زبان طبیعی از محاسبه موردنیاز هر مدار به آن بدهیم، میتواند الگوریتمهای کوانتومی را نیز به همین شکل بهینه کند.
کلود به چند دلیل برای این کار مناسب است. نخست، الگوریتمهای کوانتومی در قالب مدارهای کوانتومی پیادهسازی میشوند که از توالیهایی از دروازهها، مانند دروازههای تافولی، تشکیل شدهاند. این مدارها را میتوان با کد توصیف کرد؛ بنابراین، کلود میتواند از توانایی برنامهنویسی خود برای نوشتن، اجرا و بازبینی طرحهای مداری در قالب برنامههای معمولی استفاده کند. دوم، در رده نسبتاً رایجی از الگوریتمهای کوانتومی که قصد داشتیم بهینه کنیم، میتوان درستی عملکرد را بهسرعت آزمود، زیرا هر ورودی خروجی مشخصی دارد که یک رایانه معمولی قادر به بررسی آن است. در نتیجه، میتوانستیم از یک برنامه ارزیاب مستقل برای اعتبارسنجی طرحهای پیشنهادی کلود استفاده کنیم. در نهایت، امکان تعیین یک معیار روشن و عینی برای بهبود وجود داشت: حاصلضرب تعداد کیوبیتها در تعداد دروازهها، که معیاری تقریبی برای مدتزمان اجرای مدار است.
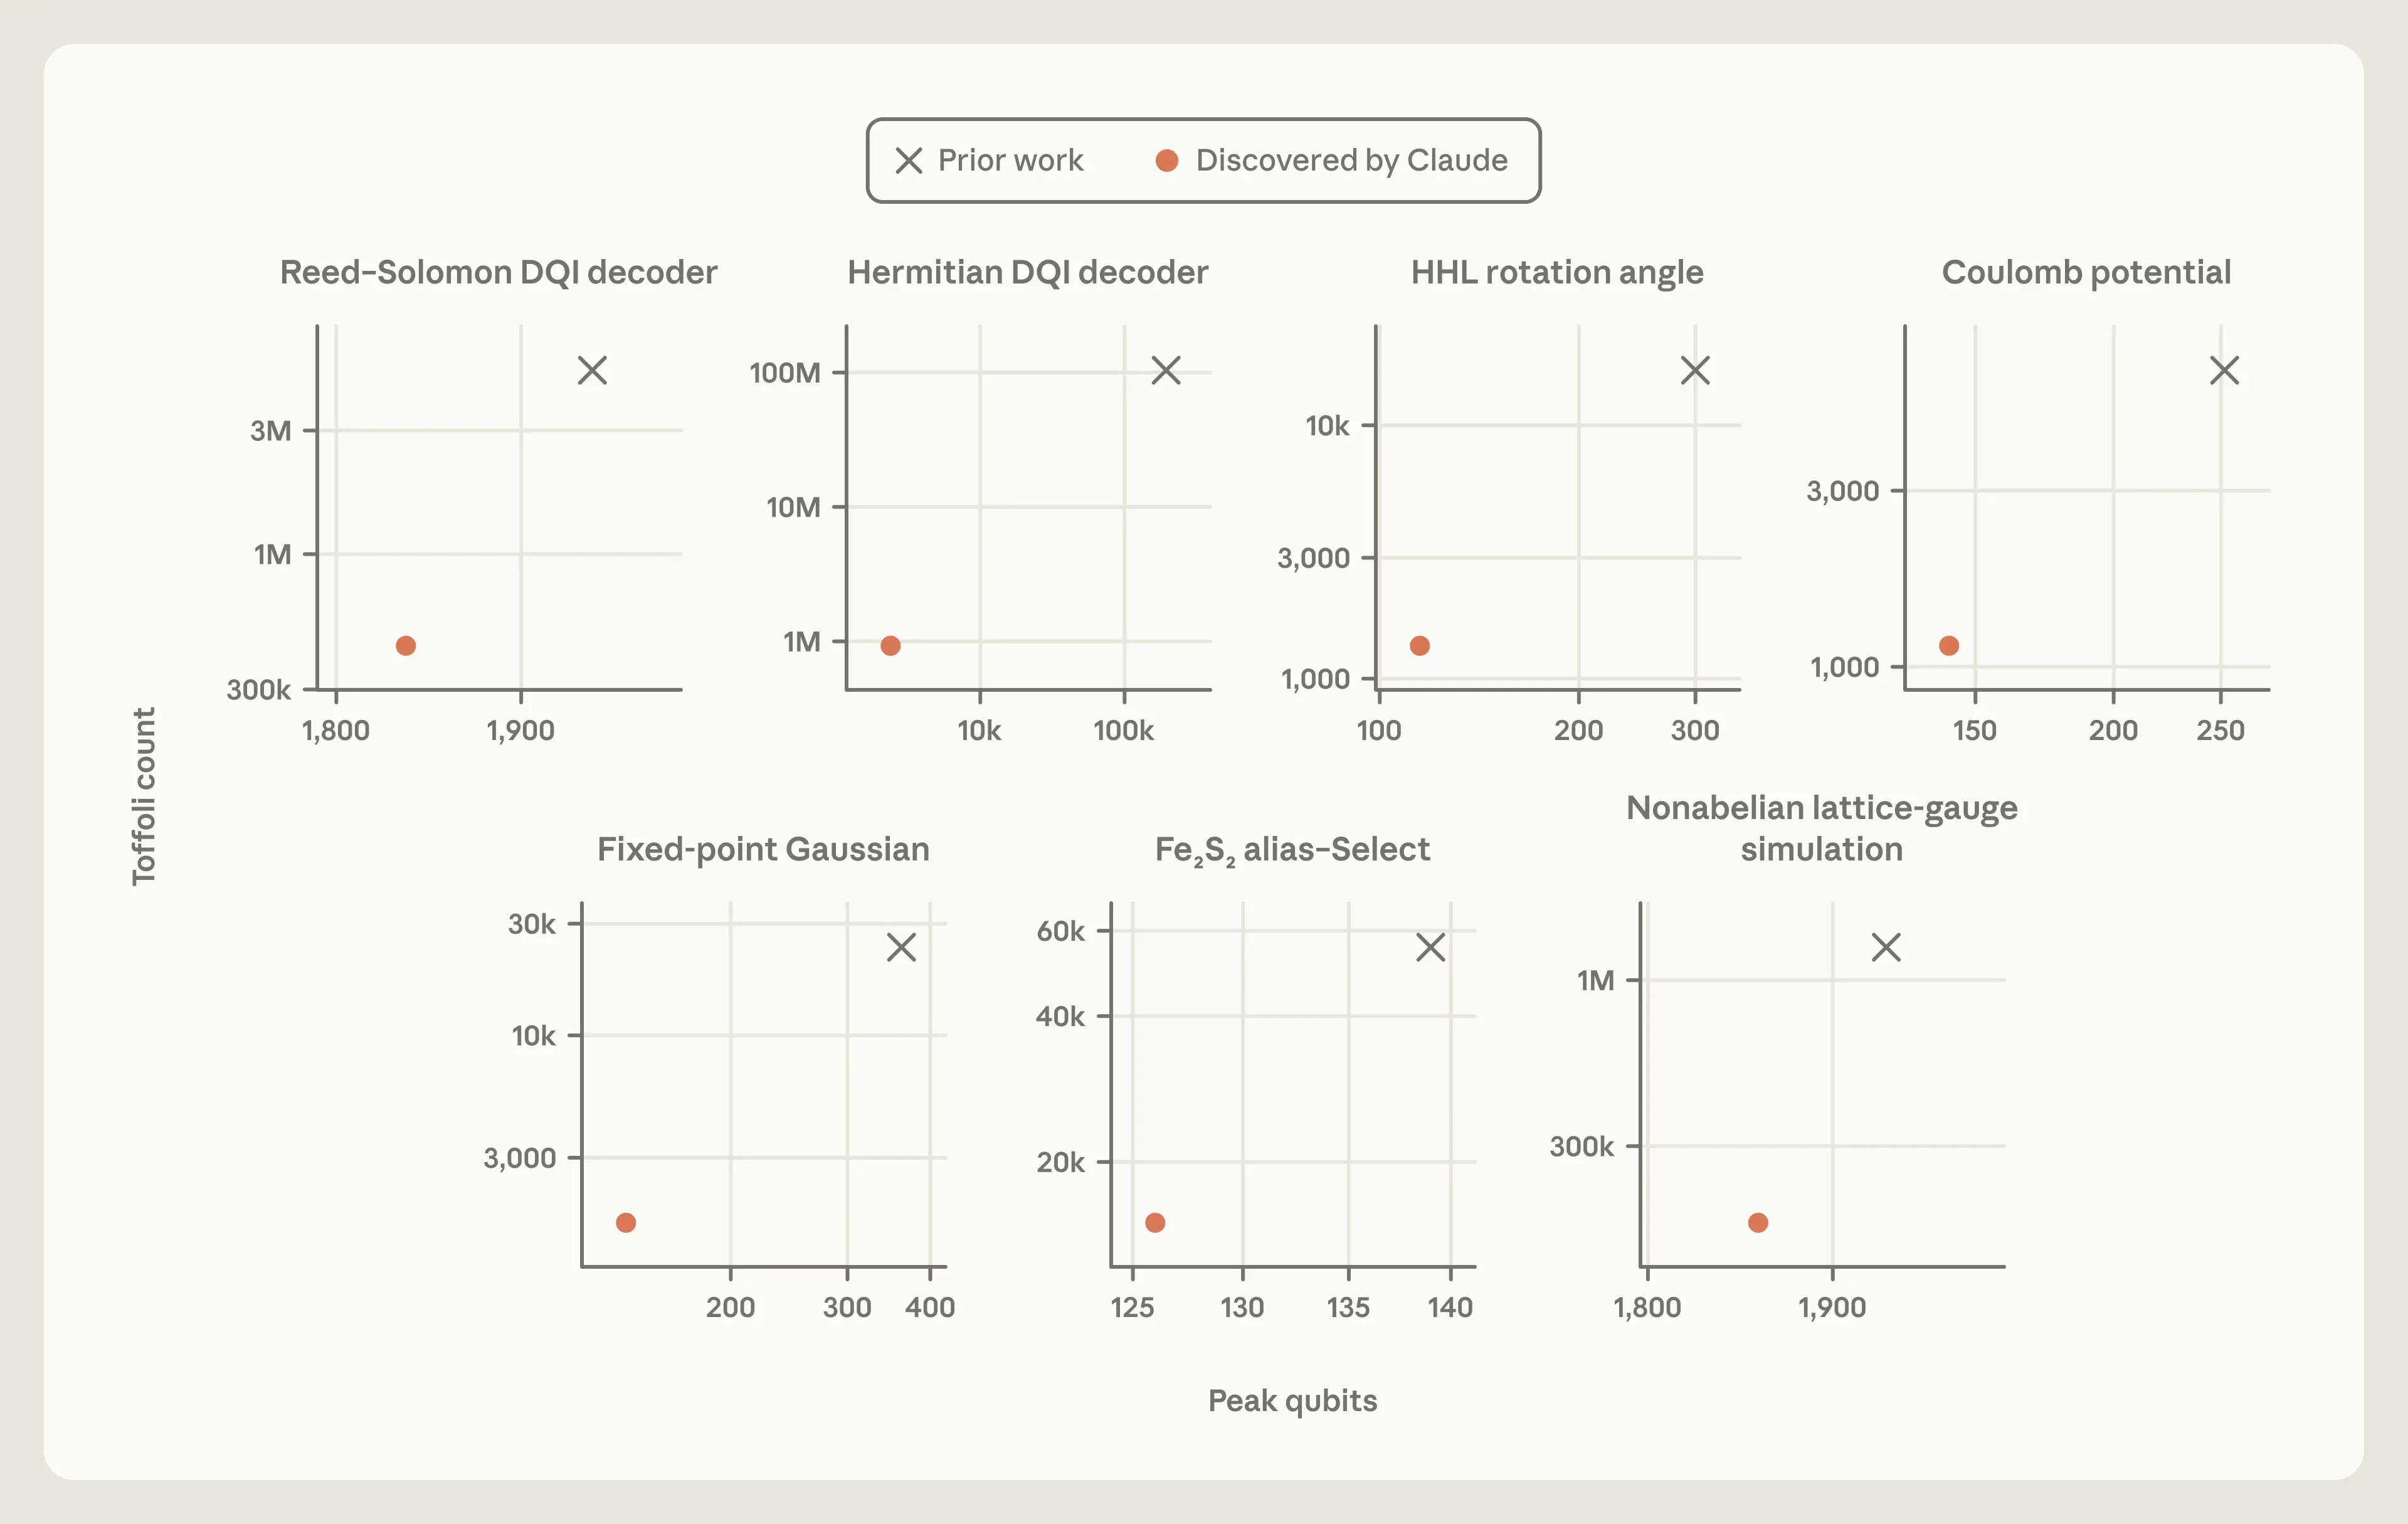
مشاهده کردیم که Claude Mythos 5 میتواند یک چرخه بهینهسازی بسته را با موفقیت اجرا کند: ابتدا طرحی برای مدار ارائه دهد، سپس بازخورد و امتیاز برنامه ارزیاب را دریافت کند و با استفاده از آن، تلاش بعدی خود را بهبود بخشد؛ آن هم بدون دخالت انسان در فاصله میان مراحل (شکل ۱). کلود در هشت وظیفه محاسباتی پایه، یعنی رویههای بنیادی سازنده الگوریتمهای کوانتومی بزرگتر، در حوزههای شیمی، بهینهسازی، شبیهسازی کوانتومی، نظریه اعداد و محاسبات عددی، طرحهایی تازه کشف کرد که هم به کیوبیتهای کمتر و هم به دروازههای کمتری از بهترین الگوریتمهای منتشرشده پیشین نیاز داشتند (شکل ۲).
در همه این موارد، پیشرفت حاصل کشف بینشهای ساختاری و ریاضی جدید درباره مسئله بود، نه صرفاً تنظیم دقیق طرحهای موجود. برای نمونه، هنگام کامپایل مداری برای شبیهسازی یک مولکول سولفید آهن، کلود متوجه شد که تقارنها و ساختار تکرارشونده مولکول اجازه میدهند برخی نتایج فقط یک بار محاسبه و سپس دوباره استفاده شوند؛ بنابراین لازم نیست برای هر بخش از سامانه آنها را از نو محاسبه کرد. در موارد دیگر نیز دریافت که مدارهای موجود اجزای پرهزینهای دارند که فقط برای ورودیهای بسیار نادر ضروریاند و توانست مدارها را بدون آن اجزا بازطراحی کند.
در ادامه، دو مورد از دستاوردهای کلود را شرح میدهیم. نخست، روشی جدید برای محاسبه معکوس پیمانهای است؛ عملیاتی حسابی که پرهزینهترین مرحله محاسبات منحنی بیضوی به شمار میرود. دستاورد دوم، هزینه پرهزینهترین مرحله یکی از الگوریتمهای پیشرو در بهینهسازی کوانتومی را حدود ۱۲ برابر کاهش میدهد.
این نتایج نشان میدهند که هوش مصنوعی اکنون میتواند در بازطراحی مدارهای کوانتومی، که گامی اساسی برای سریعتر و آسانتر کردن اجرای الگوریتمهای کوانتومی است، نقش داشته باشد. طراحی سریعتر مدارها میتواند حل مسائلی را که رایانههای کوانتومی برای آنها ساخته میشوند، از طراحی داروهای جدید و باتریهای بهتر گرفته تا یافتن روشهای پاکتر برای تولید کود شیمیایی، زودتر در دسترس قرار دهد.
الگوریتمی برگشتپذیر و جدید
طراحی مدار کوانتومی با دو محدودیت روبهروست که در برنامهنویسی معمولی وجود ندارند. نخست اینکه مدار کوانتومی نمیتواند مانند یک برنامه معمولی بر اساس شرط «اگر ـ آنگاه» تصمیم بگیرد. یک برنامه عادی میتواند مقداری را بررسی کند و سپس فقط یکی از دو بخش کد را اجرا کند. اما رایانه کوانتومی با برهمنهی ورودیهای متعدد کار میکند؛ برخی از این ورودیها باید به اجرای بخش اول و برخی دیگر به اجرای بخش دوم منجر شوند. بنابراین، مدار ناگزیر است عملیات مربوط به هر دو مسیر را در هر بار اجرا در خود داشته باشد.
محدودیت دوم این است که مدار کوانتومی نمیتواند اطلاعات را دور بریزد. یک برنامه معمولی پس از پایان کار میتواند دادههای موقت خود را بازنویسی یا حذف کند؛ اما در رایانه کوانتومی، اطلاعات میانی را نمیتوان بهسادگی پاک کرد، زیرا تمام مراحل مدار باید برگشتپذیر باشند. نگهداشتن این اطلاعات نیز راهحل مناسبی نیست، چون دادههای موقت باقیمانده میتوانند نتیجه نهایی را مختل کنند. تنها راه حذف اطلاعات، «محاسبه معکوس» یا اجرای وارونه محاسبهای است که آن اطلاعات را تولید کرده؛ کاری که به دروازههای اضافی نیاز دارد. این دو محدودیت باعث میشوند مدارهای کوانتومی از نظر زمان اجرا و تعداد کیوبیتها بسیار پرهزینهتر از همتایان کلاسیک خود باشند.
این محدودیتها مصالحهای دشوار میان فضا، یعنی تعداد کیوبیتها، و زمان ایجاد میکنند. در یک سوی این طیف، مدار میتواند بهمحض استفاده از نتایج میانی، آنها را با محاسبه معکوس پاک کند. این کار کیوبیتها را آزاد میکند، اما اگر همان نتایج بعداً دوباره لازم شوند، باید از نو محاسبه شوند؛ در نتیجه، تعداد دروازهها و زمان اجرا افزایش مییابد. در سوی دیگر، مدار میتواند نتایج میانی را تا زمانی که دیگر نیازی به آنها نیست نگه دارد. به این ترتیب، محاسبات تکراری حذف میشوند، اما ممکن است به کیوبیتهای بسیار بیشتری نیاز باشد.
به همین دلیل، طراحی مدار کوانتومی آزمونی جالب برای سنجش تواناییهای کلود است. مدارها را میتوان با کد معمولی نوشت، اما بهینهسازی آنها مستلزم استدلال در چارچوب مجموعهای از محدودیتهاست که با محدودیتهای برنامهنویسی متعارف تفاوت زیادی دارند.
آزمونی دشوار در آغاز: معکوس پیمانهای
نخستین وظیفهای که به کلود دادیم، جمع نقاط بود؛ عملیاتی که دو نقطه روی یک منحنی ریاضی، موسوم به منحنی بیضوی، را با هم ترکیب میکند تا نقطه سومی به دست آید. جمع نقاط، گام اصلی الگوریتمهای کوانتومی برای حل مسئله لگاریتم گسسته روی منحنیهای بیضوی است: اگر نقطه آغاز و نتیجه افزودن مکرر آن به خودش به تعداد n بار را داشته باشیم، باید مقدار n را پیدا کنیم. رایانههای معمولی نمیتوانند این مسئله را برای منحنیهای بزرگ در زمان معقول حل کنند، اما یک رایانه کوانتومی بهاندازه کافی بزرگ ممکن است از عهده آن برآید.
این الگوریتمها بارها عملیات جمع نقاط را انجام میدهند و حتی آن را در جهت معکوس اجرا میکنند. این عملیات بخش عمده هزینه آنها از نظر تعداد کیوبیت و زمان اجرا را تشکیل میدهد. مسائلی از این دست، که محاسبه مستقیم آنها آسان اما وارونهکردنشان بسیار دشوار است، از نخستین نمونههایی بودند که در آنها برتری نمایی رایانههای کوانتومی نسبت به رایانههای معمولی نشان داده شد. از همین رو، جمع نقاط به یکی از معیارهای استاندارد ارزیابی در این حوزه تبدیل شده است. این مسئله آزمونی سخت برای کلود بود؛ بنابراین از آن خواستیم مشخص کند جمع نقاط واقعاً به حداقل چند کیوبیت و چند دروازه نیاز دارد.
شرحی یکپاراگرافی در اختیار کلود گذاشتیم که قاعده ریاضی جمع نقاط و نحوه بررسی درستی هر مدار پیشنهادی و امتیازدهی به آن بر اساس تعداد کیوبیتها و دروازهها را توضیح میداد. همچنین به آن دستور دادیم چند رویکرد متفاوت را بهطور موازی بررسی کند. کلود پس از ۵۳ ساعت کار، با حداقل دخالت انسان ــ محدود به شرح اولیه و گاه درخواستهایی برای بررسی گستردهتر ایدهها ــ به رویکردی کاملاً جدید برای حل مسئله رسید.
نیازهای حافظهای روش divsteps
بخش عمده هزینه جمع نقاط به یک مرحله اختصاص دارد: معکوس پیمانهای. در حساب پیمانهای منحنیهای بیضوی، اعداد پس از رسیدن به حدی ثابت دوباره از ابتدا محاسبه میشوند. معکوس پیمانهای نسخهای از تقسیم در این نظام حسابی است: برای عدد صحیح a باید مقداری به نام x پیدا کنیم که رابطه ax ≡ 1 (mod p) را برآورده کند. رایانههای معمولی این عملیات را بهکمک روشی به نام divsteps بهطور کارآمد انجام میدهند. این روش با یک جفت عدد آغاز میشود و در دورهای متوالی آنها را سادهتر میکند. در هر دور، divsteps جفت اعداد فعلی را بررسی میکند و بسته به شرایط، آنها را جابهجا میکند یا عملیات جمع، تفریق یا نصفکردن را انجام میدهد. در این فرایند، فقط اطلاعات لازم برای محاسبه معکوس پیمانهای در پایان نگه داشته میشود.
با وجود موفقیت divsteps در رایانههای معمولی، این روش هنوز به مدار کوانتومی کاربردی تبدیل نشده بود، زیرا با محدودیت برگشتپذیری که توضیح دادیم سازگارکردنش دشوار بود. سابقه اینکه در هر تکرار کدام عملیات انتخاب شده است، «اطلاعات شاخه» نام دارد و نوعی داده موقت است که یک برنامه سنتی میتواند بهسادگی دور بریزد. اما مدار کوانتومی باید این سابقه را نگه دارد تا محاسبه بتواند در جهت معکوس اجرا شود. در نتیجه، پیادهسازی مستقیم divsteps در قالب مدار کوانتومی ناچار است سابقه طولانی اطلاعات شاخه را انباشته کند و برای ذخیره آن به تعداد بسیار زیادی کیوبیت اضافی نیاز دارد.
چگونه کلود مشکل حافظه را حل کرد
کلود تشخیص داد که روش divsteps میتواند برای مدارهای کوانتومی امیدوارکننده باشد، به شرط آنکه راهی برای پرهیز از ذخیره کل سابقه محاسبات پیدا شود. ایده آن این بود که شاید اصلاً نیازی به ذخیره این سابقه نباشد. کلود استدلال کرد که با بررسی دقیق جفت اعداد پس از هر تکرار، میتوان اطلاعات شاخه را مستقیماً استنباط یا «رمزگشایی» کرد. به بیان دیگر، خود اعداد میتوانستند سابقه عملیات را در خود بازتاب دهند. در این صورت، مدار را میشد بدون نیاز به کیوبیتهای اضافی برای ذخیره سابقه، بهصورت معکوس اجرا کرد.
کلود برای آزمودن این ایده، چند قاعده ساده پیشنهادی برای رمزگشایی را بررسی کرد. این قواعد اولیه روی نمونههای کوچک جواب میدادند، اما هنگام آزمایش در اندازه واقعی مسئله، یعنی روی اعداد ۲۵۶ بیتی، شکست خوردند.
سپس کلود رویکردی نظریتر را در پیش گرفت. بهجای حدسزدن و آزمودن قواعد مختلف، تلاش کرد رفتار divsteps را از نظر ریاضی توضیح دهد. این مدل چندین نتیجه درباره فرایند تکرار اثبات کرد که در میان آنها چند همانی جبری جدید نیز وجود داشت. کلود با استفاده از این همانیها، فرمول دقیقی برای قاعده رمزگشایی به دست آورد که میتوانست اطلاعات شاخه را از جفت اعداد بهدرستی بازیابی کند. سپس فرمول را ابتدا با شبیهسازیهای عددی در مقیاس بزرگ آزمود و در ادامه، ادعای ریاضی خود را در سامانه اثباتگر Lean صورتبندی و تأیید کرد. پس از تکمیل اعتبارسنجی، کلود نخستین پیادهسازی برگشتپذیر divsteps را ارائه داد که به ذخیره سابقه شاخهها نیاز نداشت.
خانوادهای از طرحهای جدید
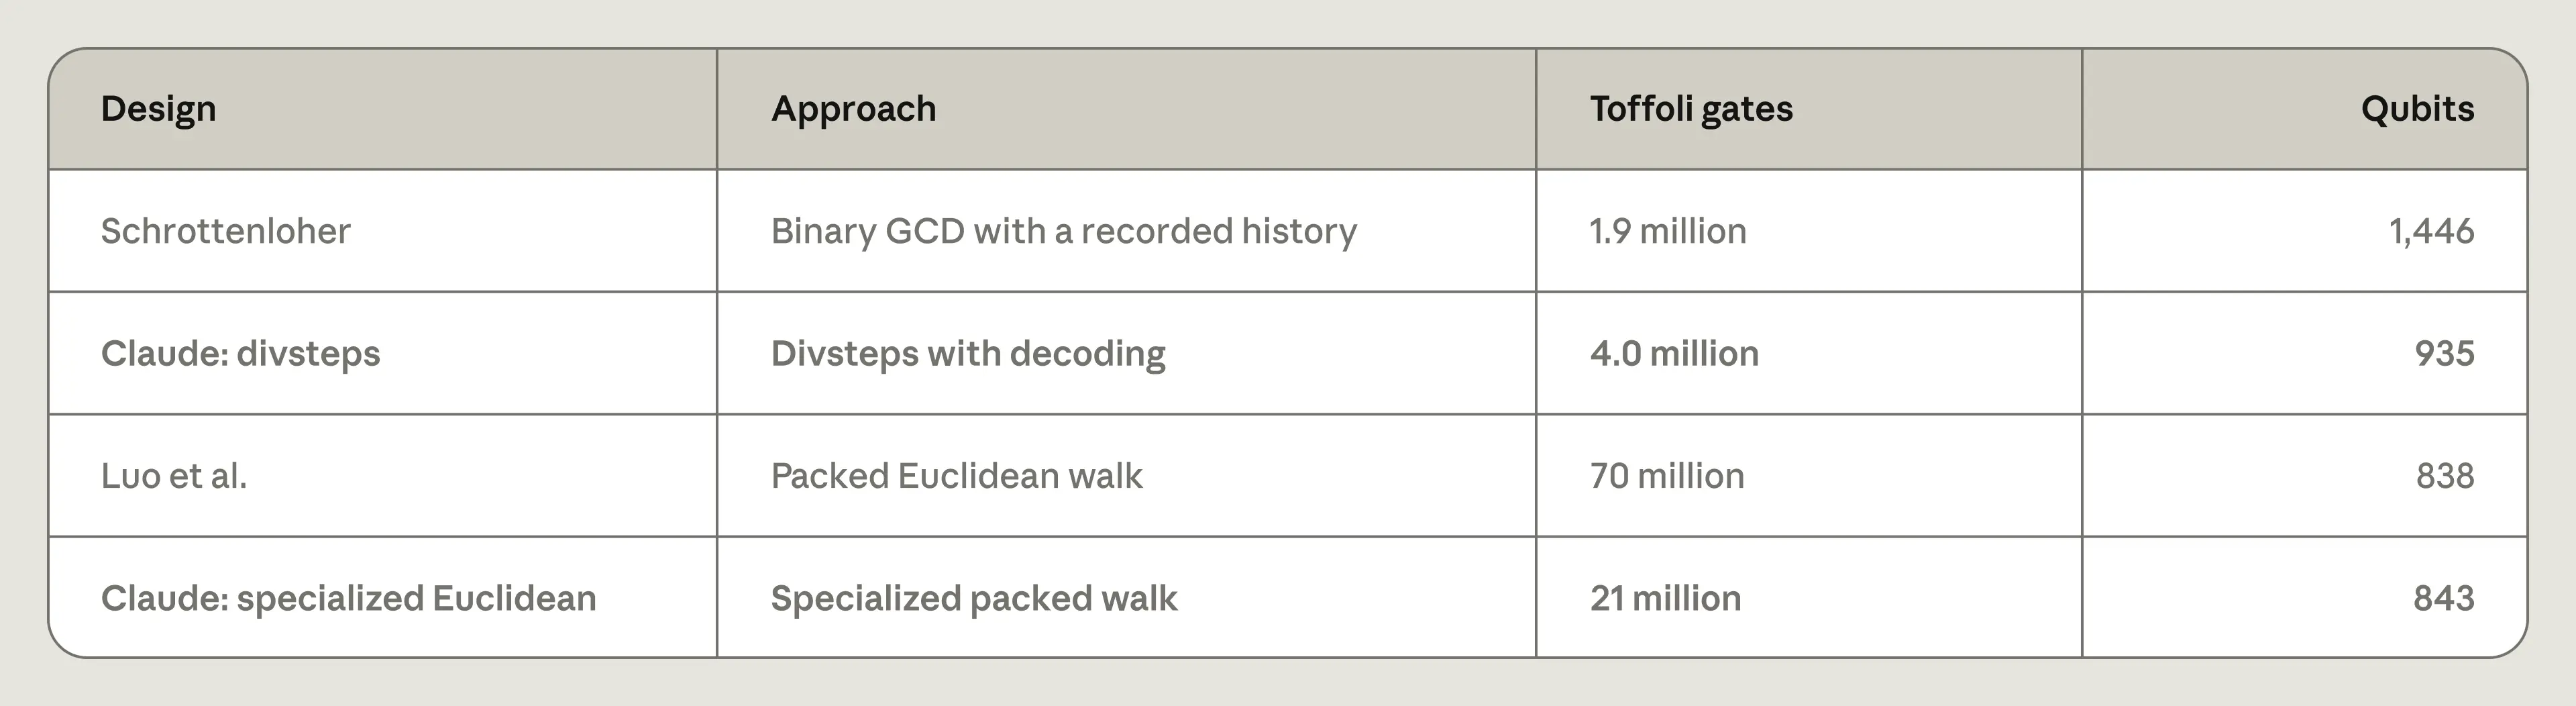
رمزگشایی تعداد کیوبیتها را کاهش میدهد، اما زمان بیشتری میگیرد. کلود برای بهبود بیشتر، موقعیتهایی را جستوجو کرد که در آنها ذخیره اطلاعات شاخه از رمزگشایی آن ارزانتر باشد. با تغییر آستانهای که تعیین میکرد مدار اطلاعات شاخه را ذخیره کند یا آن را رمزگشایی کند، مجموعهای از طرحهای جدید میان این دو حالت حدی ساخت. یکی از مدارهای این مجموعه، در مقایسه با کوچکترین طرح پیشین، به ۱۲ درصد کیوبیت بیشتر نیاز دارد، اما تعداد دروازههای آن ۱۷ برابر کمتر است. بهطور کلی، طرحهای جدید مرز پارتو را گسترش میدهند و ترکیبهایی از تعداد کیوبیت و زمان اجرا را فراهم میکنند که پیشتر در دسترس نبودند (جدول ۱).
بهینهسازی یک الگوریتم بهینهسازی کوانتومی
مسائل بهینهسازی در طیف گستردهای از فعالیتها، از زمانبندی و لجستیک گرفته تا طراحی مواد، نقشی اساسی دارند. در مسئله بهینهسازی، مجموعهای از محدودیتهای رقیب مطرح میشود و هدف یافتن راهحلی است که تا حد امکان آنها را برآورده کند. الگوریتمهای کوانتومی زیادی برای چنین مسائلی پیشنهاد شدهاند، اما بیشتر آنها تنها بهبودهایی محدود یا نامطمئن نسبت به رایانههای معمولی وعده میدهند. یکی از گزینههای جدی برای دستیابی به شتاب کوانتومی ابرچندجملهای، روش تداخلسنجی کوانتومی رمزگشاییشده (DQI) است؛ مزیتی که با بزرگترشدن مسائل بهسرعت افزایش مییابد.
وقتی رایانه کوانتومی محاسبهای را به پایان میرساند، اندازهگیری کیوبیتها تنها یک پاسخ را آشکار میکند که بهطور تصادفی از میان حالتهای موجود در برهمنهی انتخاب شده است. روش DQI با آمادهسازی یک حالت کوانتومی کار میکند که در آن احتمال مشاهده راهحلهای خوب بیشتر از راهحلهای نامطلوب است. برای این کار باید از یک رمزگشای اصلاح خطا استفاده کرد که فهرستی کوتاه از «خطاها» را از خلاصهای فشرده بازیابی میکند. این مرحله پرهزینهترین بخش الگوریتم است؛ بنابراین، اگر رمزگشای سریعتری بسازیم، اجرای DQI نیز سریعتر خواهد شد.
رمزگشای کوانتومی کارآمدتر
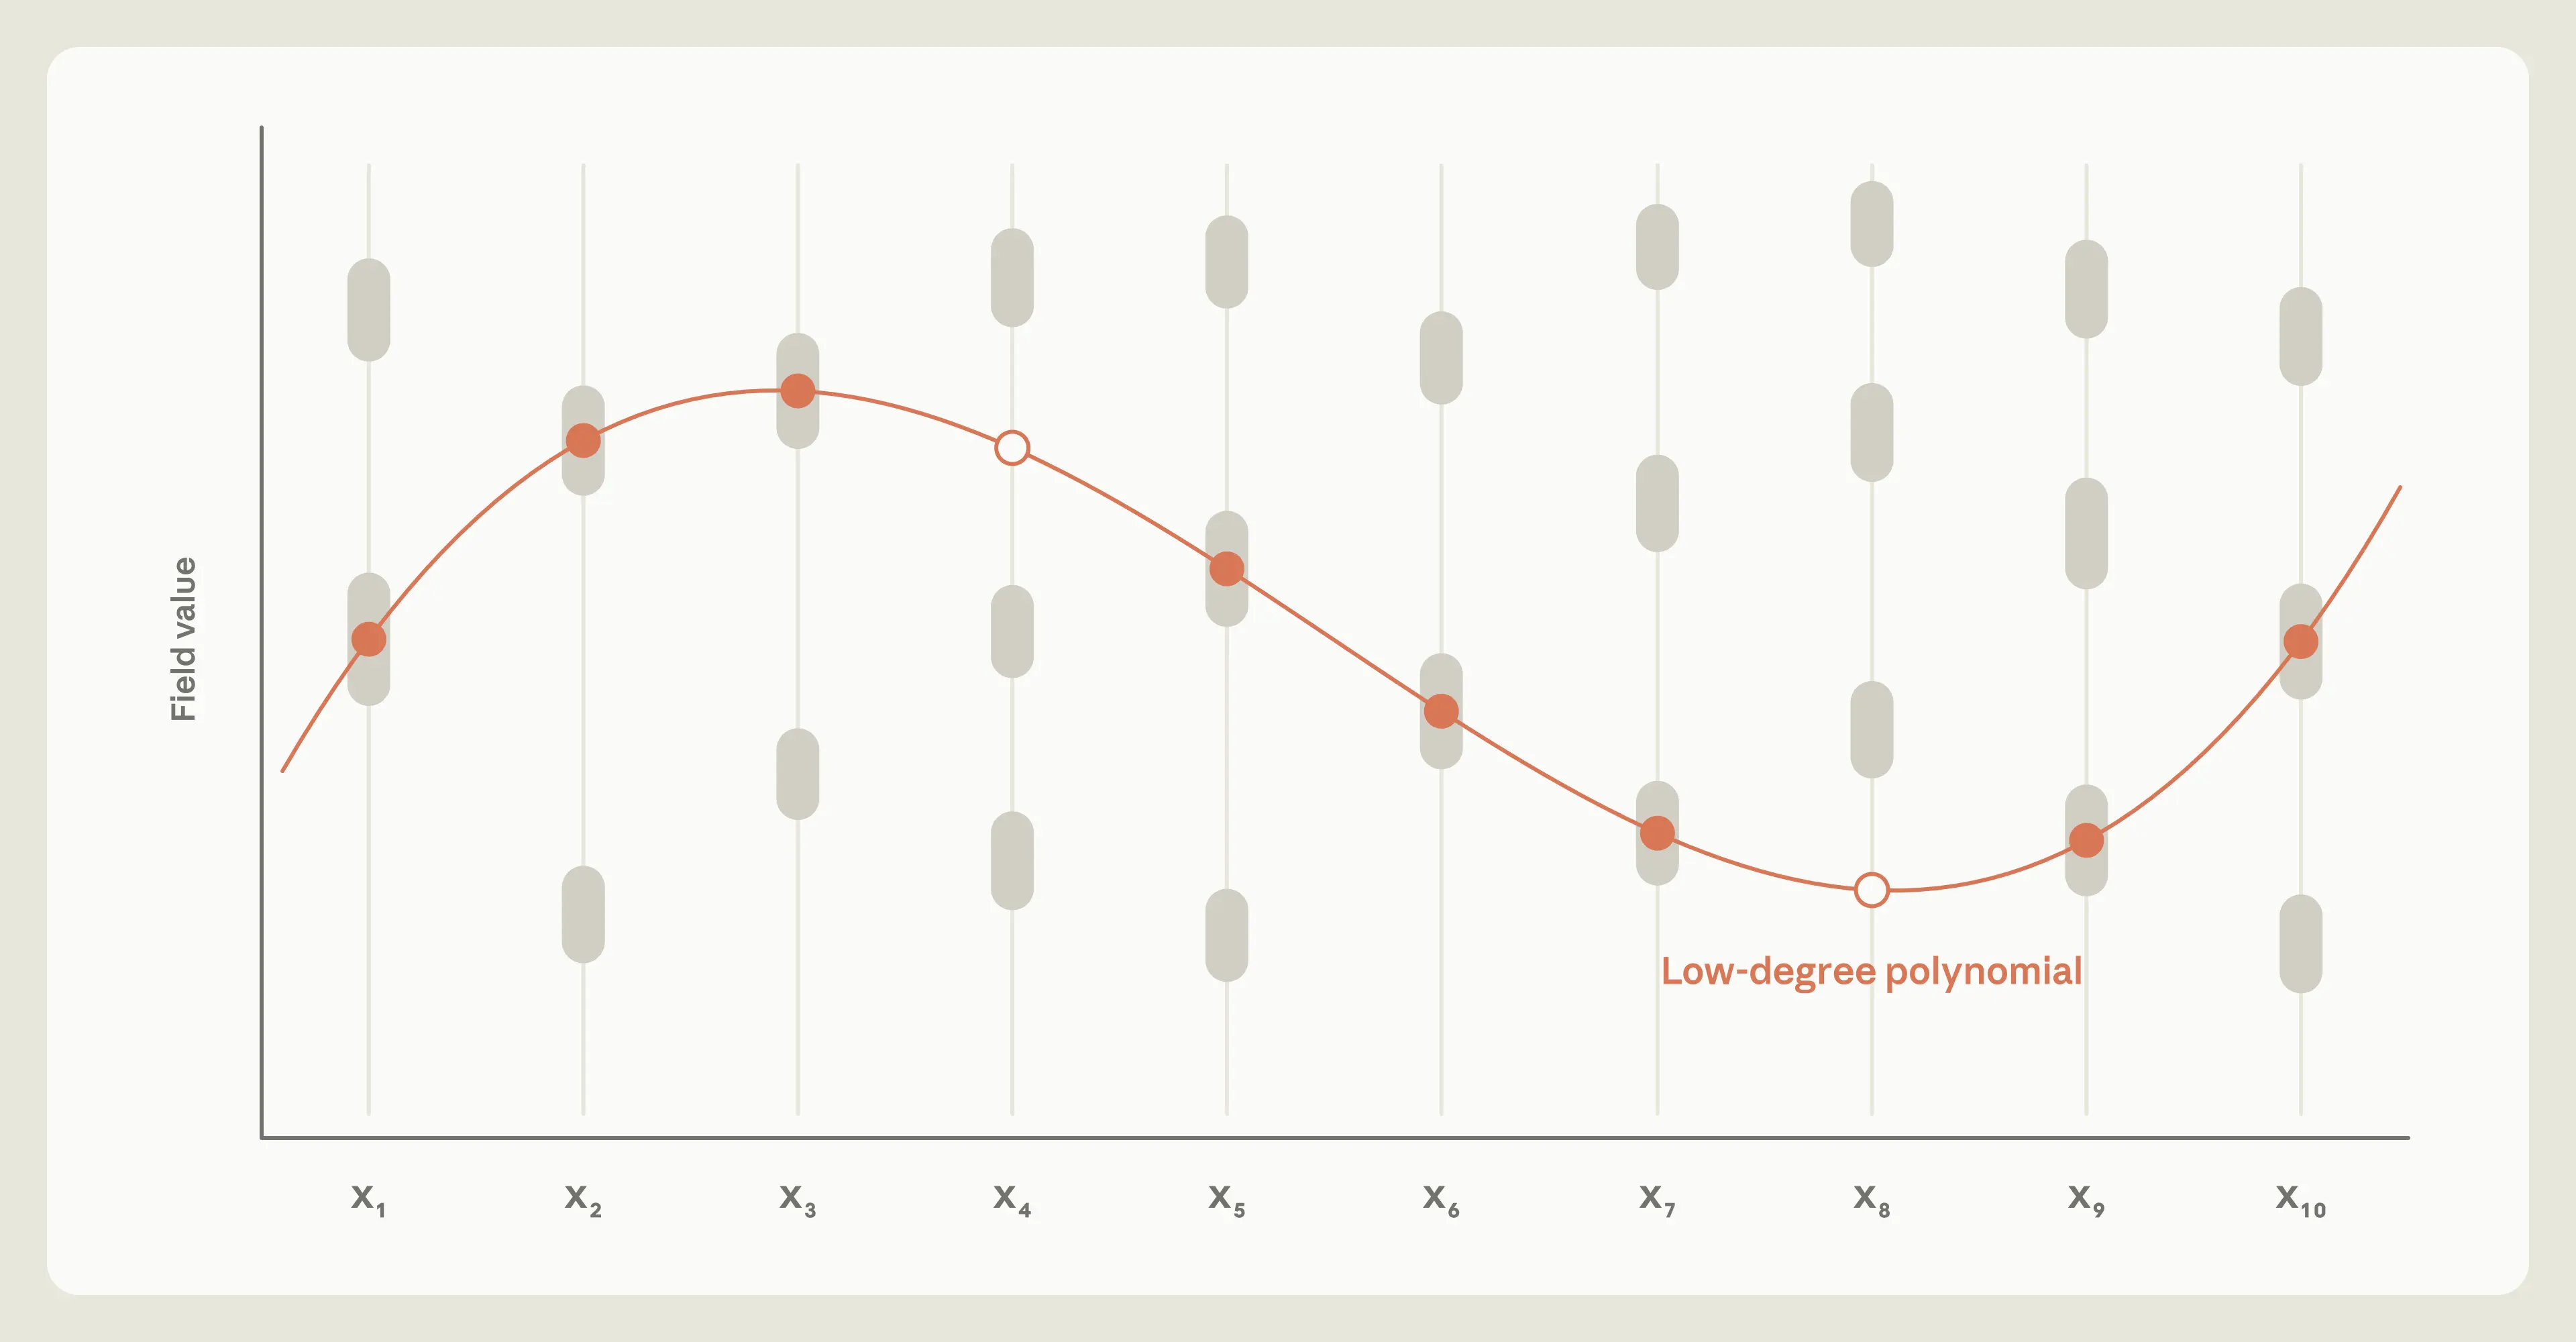
پژوهشگرانی که روش DQI را معرفی کردند، آن را روی مسئلهای به نام تقاطع بهینه چندجملهای (OPI) آزمایش کردند؛ نوعی برازش منحنی روی شبکه (شکل ۳). شبکهای را تصور کنید که در هر موقعیت x چند مقدار قابلقبول برای y وجود دارد. هدف، یافتن منحنی سادهای، یعنی چندجملهای با درجه پایین، است که از خانه قابلقبول در بیشترین تعداد موقعیتهای x عبور کند. DQI این مسئله بهینهسازی را با استفاده از نوع مشخصی از رمزگشا به نام رمزگشای رید–سولومون حل میکند.
رمزگشایی رید–سولومون با همان خلاصه فشرده خطاها که پیشتر توضیح داده شد آغاز میشود؛ این خلاصه «سندروم» نام دارد. وظیفه رمزگشا آن است که از روی این خلاصه، محل وقوع خطاها در دادهها و ماهیت آنها را تشخیص دهد. بهترین مدار کوانتومی پیشین برای پردازش این سندرومها از الگوریتم اقلیدسی توسعهیافته استفاده میکرد؛ مجموعهای از تقسیمها و جابهجاییها که تعداد و ترتیب مراحل آن به ورودی مشخص بستگی دارد. در اینجا محدودیتهای مدار کوانتومی دوباره خود را نشان میدهند: یک برنامه معمولی میتواند برای هر ورودی مسیر متفاوتی را دنبال کند، اما مدار کوانتومی که همزمان با ورودیهای متعدد کار میکند، باید همه آنها را با یک توالی ثابت از دروازهها پردازش کند. برای کنارآمدن با این محدودیت، طرح قبلی محاسبات را در تعداد دورهای بسیار بیشتری از آنچه هر ورودی بهتنهایی نیاز داشت، پخش میکرد و همه عملیات را در تمام دورها اجرا میکرد؛ حتی در مواردی که ضرورتی نداشتند.
بهبود این رمزگشا میتواند زمان اجرای DQI را بهطور چشمگیری کاهش دهد. برآوردهای پژوهشگران Google Quantum AI نشان میدهد که حل یک نمونه مشخص از مسئله OPI روی ابررایانه Frontier، یکی از قدرتمندترین ابررایانههای جهان، حدود سه ماه طول میکشد؛ درحالیکه اجرای DQI روی یک رایانه کوانتومی آینده میتواند همان مسئله را تقریباً در یک ساعت حل کند. بخش عمده این یک ساعت صرف رمزگشایی رید–سولومون خواهد شد.
به همین دلیل، از کلود خواستیم مداری کوانتومی کارآمدتر برای مرحله رمزگشایی طراحی کند. کلود بهسرعت به این نتیجه رسید که الگوریتم اقلیدسی توسعهیافته گزینه مناسبی برای مدار کوانتومی نیست. در عوض، مدار خود را بر پایه روش دیگری به نام رمزگشایی برلکمپ–مَسی سازمان داد. این روش سندرومها، یعنی خلاصههای خطاها، را یکییکی بررسی میکند و بهتدریج سادهترین قاعدهای را مییابد که بتواند هر عدد فهرست را بر اساس اعداد پیش از آن پیشبینی کند. پس از یافتن این قاعده، خطاها مشخص میشوند. برخلاف الگوریتم اقلیدسی توسعهیافته، روش برلکمپ–مسی در هر دور نوع یکسانی از عملیات را انجام میدهد و همواره با تعداد دورهای ثابتی اجرا میشود. این ویژگی با ساختار مدار کوانتومی، که به توالی ثابتی از دروازهها نیاز دارد، سازگار است و در نهایت پایهای بسیار کارآمدتر برای طراحی مدار در اختیار کلود قرار داد.
رویکردی سادهتر برای ذخیرهسازی
جایگزینی الگوریتم اقلیدسی توسعهیافته با روش برلکمپ–مسی نیاز مدار به پیمودن مسیرهای متفاوت برای ورودیهای مختلف را برطرف کرد. اما برگشتپذیرکردن این روش چالش دیگری به وجود آورد که این بار ناشی از محدودیت محاسبه معکوس بود. مدار در هر دور مقادیر موقتی محاسبه میکند که فقط برای مدت کوتاهی به آنها نیاز دارد، اما نمیتوان این اطلاعات را مستقیماً حذف کرد؛ زیرا برای محاسبه معکوس در مراحل بعد، مدار باید بتواند آنها را بازیابی کند.
ذخیرهکردن همه این اطلاعات هزینهای بیش از حد بالا داشت. بنابراین، کلود رویکردی مشابه روش divsteps در پیش گرفت و راهی یافت تا بیشتر اطلاعات را از حالت فعلی مدار بازسازی کند و دیگر نیازی به ذخیره آنها نباشد. بااینحال، چند مقدار استثنایی را نمیشد به این روش بازیابی کرد و لازم بود ذخیره شوند.
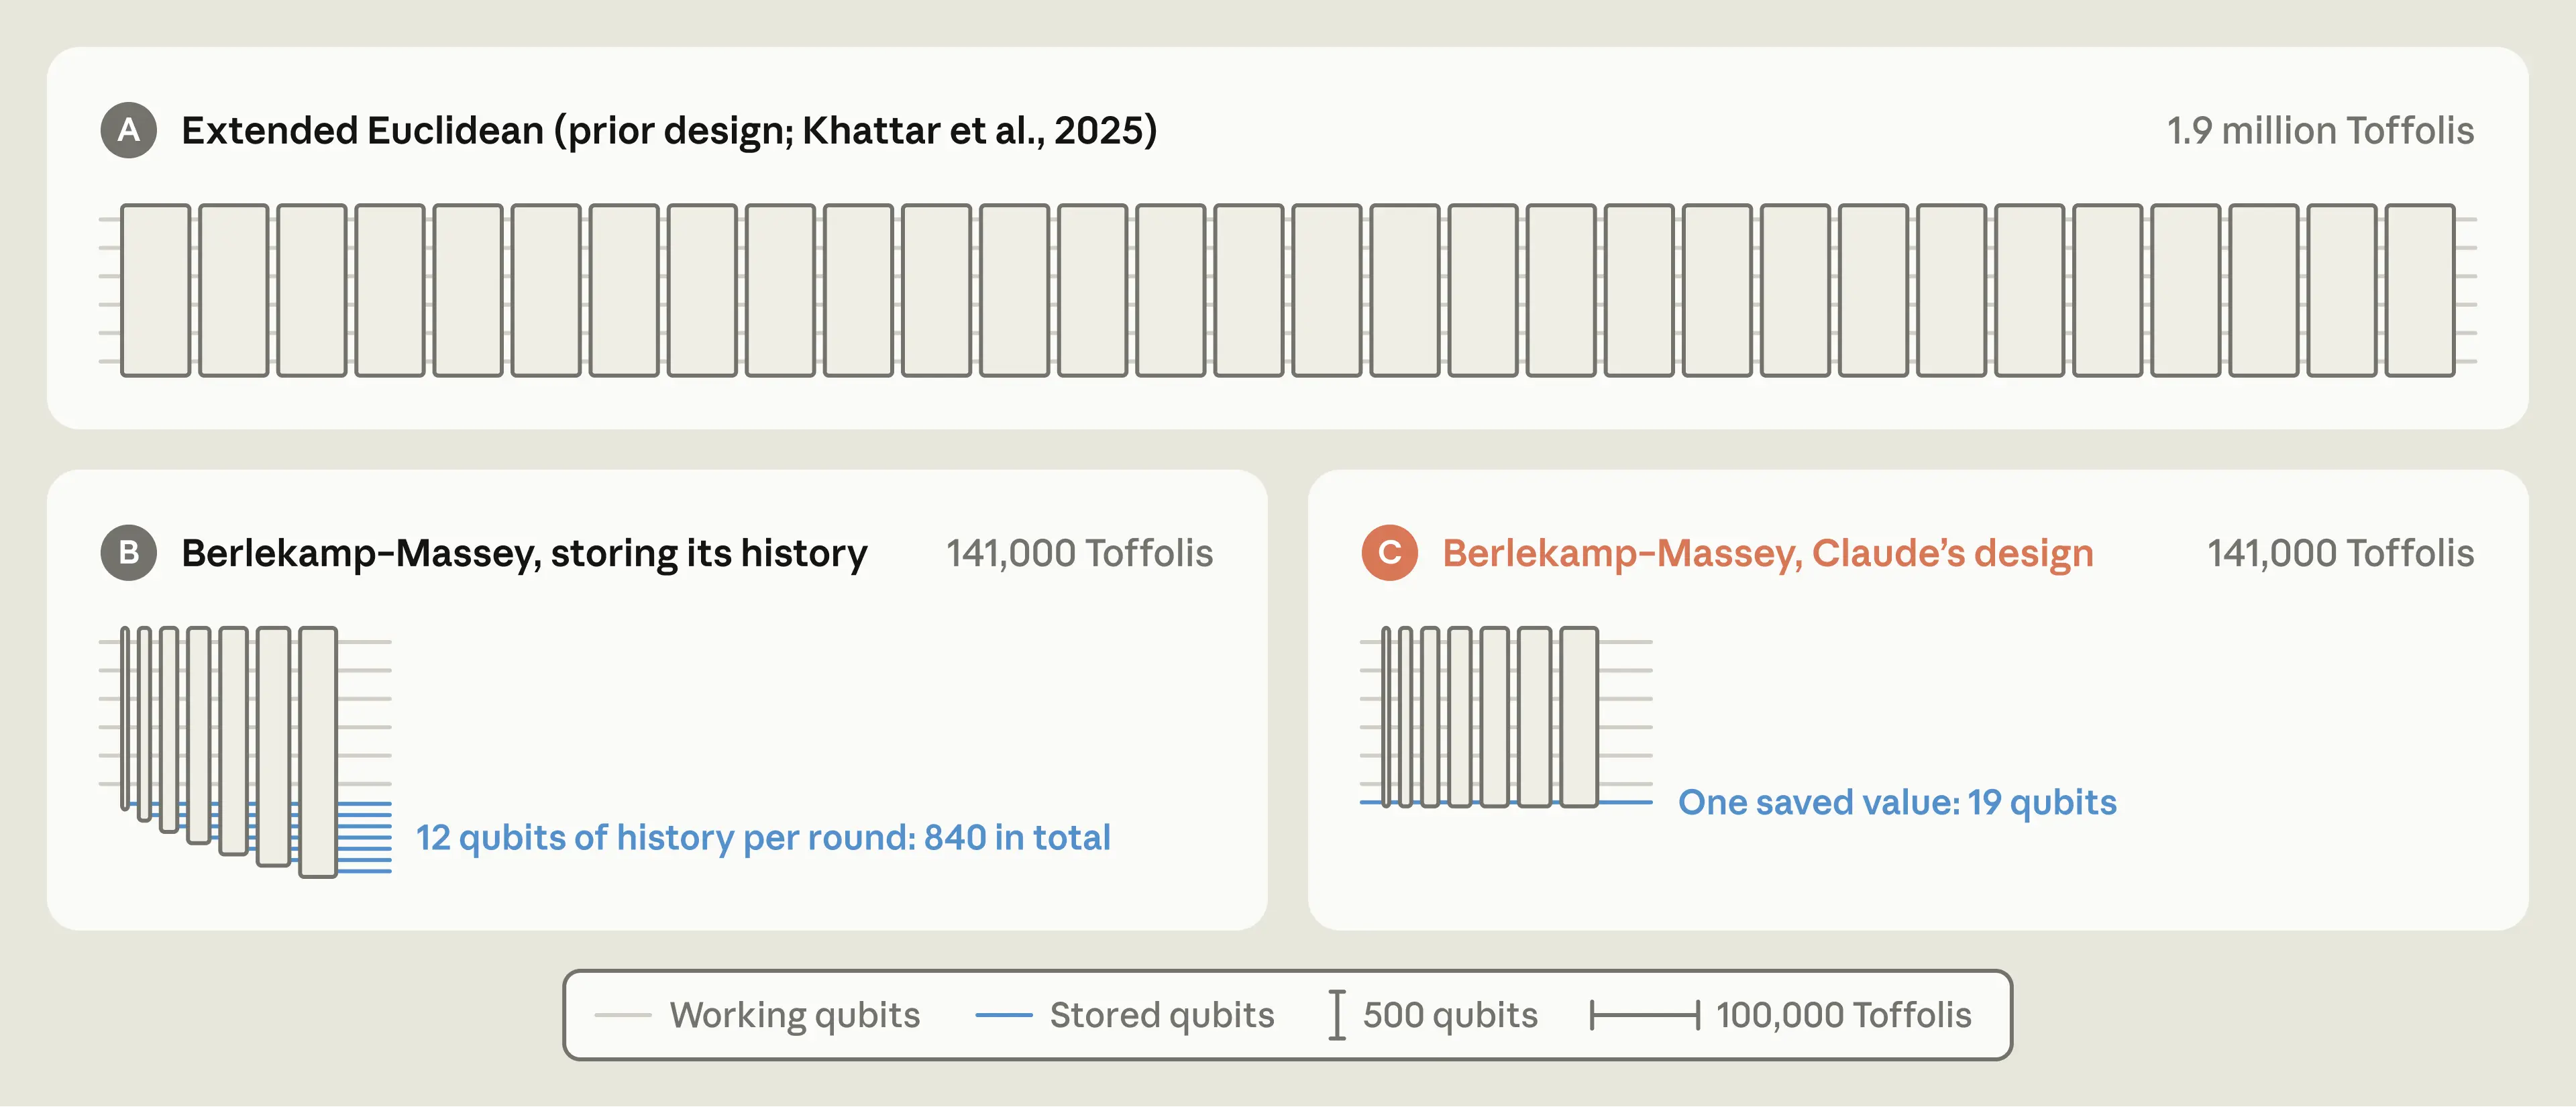
اگر برای بدترین حالت ممکن حافظه کافی در نظر گرفته میشد، یعنی حالتی که در ۳۵ دور مختلف مقدار استثنایی ایجاد شود، مدار به ۶۶۵ کیوبیت نیاز داشت. کلود بهجای این کار، شبیهسازی پرسرعتی نوشت و ۴۰۳ میلیون نمونه رمزگشایی را اجرا کرد تا فراوانی واقعی این استثناها را اندازه بگیرد. تقریباً در تمام اجراها، حداکثر ذخیره یک مقدار کافی بود. به همین دلیل، مدار کلود فقط برای یک مقدار ذخیرهشده، معادل ۱۹ کیوبیت، فضا اختصاص میدهد. در حدود یک اجرا از هر ۱۰ هزار اجرا به حافظهای بیش از این نیاز است و شکست میخورد؛ اما این میزان در محدوده نرخ خطای مجاز برای مسئله قرار دارد. این بهبودها جای ذخیرهسازی گسترده برای بدترین حالت را با تعداد اندکی کیوبیت و دروازه ثابت گرفتند (شکل ۴).
مجموع این بهینهسازیها تعداد دروازههای رمزگشا را در مقایسه با طرح پیشین گوگل ۱۲ برابر کاهش داد. این پیشرفت حاصل بازطراحی محاسبه در سه سطح بود: استفاده از روشی متفاوت، یعنی جایگزینی الگوریتم اقلیدسی توسعهیافته با رمزگشایی برلکمپ–مسی؛ تغییر معماری مدار از طریق بازسازی مقادیر موقت بهجای ذخیره آنها؛ و بازنگری در بودجه منابع بر اساس اندازهگیری دقیق میزان حافظه و محاسبات واقعاً موردنیاز. هیچیک از این تغییرها بهتنهایی کافی نبود، اما در کنار یکدیگر هزینه پرهزینهترین مرحله DQI را به کمی بیش از یکدوازدهم مقدار قبلی رساندند.
آنچه آموختیم
پیشرفت علمی اغلب زمانی رخ میدهد که ایدههای نظری به راهکارهایی عملی تبدیل شوند. یکی از راههای اصلی تحقق این امر، سریع و ارزانکردن فرایندی است که پیشتر اجرای آن غیرعملی به نظر میرسید. طراحی مدارهای کوانتومی نمونهای روشن از این روند است: کاهش ۱۵۰ هزار برابری برآورد منابع لازم برای شبیهسازی FeMoco که در بالا شرح دادیم، حاصل هشت سال تلاش چندین گروه پژوهشی بود و هر مرحله آن معمولاً ماهها زمان میبرد. در مقابل، طرح کلود برای محاسبات منحنی بیضوی در یک نوبت اجرای ۵۳ ساعته به دست آمد.
نتایج ما نشان میدهند که هوش مصنوعی میتواند به طراحی مدارها کمک کند و پیادهسازیهایی ارائه دهد که اجرای محاسبات کوانتومی کاربردی را به تواناییهای سختافزار واقعی نزدیکتر میکنند. اگر هوش مصنوعی بتواند این فرایند را سرعت ببخشد، رایانش کوانتومی کاربردی نیز ممکن است زودتر محقق شود.
با وجود عملکرد امیدوارکننده کلود در این وظایف، محدودیتهایی نیز مشاهده کردیم. در آزمایشهای اولیه، کلود ذاتاً محتاط بود. این مدل بارها در بهبودهای ظاهری تردید میکرد و گاهی نتایجی را که شواهد کافی برای تأییدشان وجود داشت، دو یا حتی سه بار بررسی میکرد. این احتیاط گاهی مفید بود؛ برای مثال، کلود را بر آن داشت تا برای اعتبارسنجی طرح divsteps خود، اثباتهایی در Lean بنویسد. اما در عین حال، باعث میشد به روشهای شناختهشده و تثبیتشده بیش از رویکردهای نوآورانه تمایل نشان دهد.
برای کاهش این مشکل، دو اقدام انجام دادیم. نخست، از کلود خواستیم چند رویکرد با تفاوتهای اساسی پیشنهاد کند و آنها را بهطور موازی توسعه دهد. دوم، گاهی با درخواستهایی مشخص، آن را به گسترش دامنه جستوجوی خود ترغیب کردیم. این مداخلات باعث شدند کلود ایدههای جسورانهتری را دنبال کند. برای نمونه، دستاورد مربوط به منحنیهای بیضوی از حذف چند دروازه در یک طرح موجود حاصل نشد؛ بلکه نتیجه بررسی روشی برای انجام معکوس پیمانهای برگشتپذیر بود که پیشتر امکانپذیر نبود، و سپس استخراج نتایج ریاضی لازم برای عملیکردن آن. پس از شکلگیری ایده، کلود این رویکرد را توسعه داد، پیادهسازی کرد و بهطور مستقل درستی آن را تأیید کرد.
طراحی مدار تنها یکی از بخشهای ساخت یک رایانه کوانتومی کاربردی است. بهدلیل شکنندگی کیوبیتها، دستگاه باید هنگام اجرا بتواند خطاهای خود را تشخیص دهد و اصلاح کند. این کار به اجزای متعددی وابسته است؛ از کدهای اصلاح خطا و رمزگشاهای سریع گرفته تا کنترل خود سختافزار. این اجزا بر یکدیگر اثر میگذارند، اما برای مدیریت پیچیدگی معمولاً هرکدام جداگانه طراحی میشوند. بسیاری از آنها ویژگیهایی دارند که طراحی مدار را به کاری مناسب برای کلود تبدیل کرده است: میتوان طرح را به شکل کد نوشت، درستی آن را بررسی کرد و بر اساس هزینهاش به آن امتیاز داد.
این موضوع احتمال جالبی را مطرح میکند: بهجای طراحی جداگانه هر جزء، هوش مصنوعی میتواند همه آنها را بهصورت یکپارچه بهینه کند؛ از الگوریتم گرفته تا سختافزار، تا رایانهای کوانتومی با اصلاح خطا ساخته شود که برای مسئلهای مشخص طراحی شده باشد. چنین طرحهایی همچنین میتوانند به سازندگان سختافزار نشان دهند که برای هر کاربرد، کدام قابلیتها اهمیت بیشتری دارند. این رویکرد ممکن است حل مسائلی مانند طراحی کاتالیزورها و شناخت مواد جدید را با نخستین رایانههای کوانتومی مقاوم در برابر خطا امکانپذیر کند.
قدردانی
از آرجون کار و وینای رامش برای گفتوگوهای سودمندشان در مراحل آغازین این پروژه سپاسگزاریم.
پانویسها
- هر دو برآورد به مدل یکسان FeMoco با ۵۴ اوربیتال مربوطاند که در جدول ۱ مقاله لو و همکاران، با عنوان «شبیهسازی کوانتومی سریع ساختار الکترونی از طریق تقویت طیف» (۲۰۲۵)، آمده است: مقاله لو و همکاران. برآورد سال ۲۰۱۷ از مقاله رایهر و همکاران گرفته شده است. برآوردهای میانی برای همین مدل نیز در پژوهشهای بری و همکاران (۲۰۱۹)، فون بورگ و همکاران (۲۰۲۱)، لی و همکاران (۲۰۲۱) و روکا و همکاران (۲۰۲۴) ارائه شدهاند. بازگشت به متن