
دیپسیک مدل V4.1-Flash-1017 را عرضه کرد؛ برتری در برخی بنچمارکها نسبت به کلود اپوس ۵
به نظر میرسد آزمایشگاههای هوش مصنوعی چین در مقایسه با سه ماه پیش فاصله بیشتری با پیشرفتهترین مدلهای جهان پیدا کردهاند، اما همچنان محصولات چشمگیری عرضه میکنند.
دیپسیک نسخه بهروزشدهای از مدل Flash خود را منتشر کرده و این آزمایشگاه چینی آن را مجموعهای از بهبودهای همزمان معرفی میکند: امتیازهای بهتر، پاسخهای سریعتر و خروجیهای کوتاهتر در مقایسه با نسخه قبلی. مدل جدید در شماری از بنچمارکهای مربوط به عاملهای هوش مصنوعی و برنامهنویسی حتی توانسته است اندکی از کلود اپوس ۵ شرکت آنتروپیک پیشی بگیرد؛ مدلی که در حال حاضر یکی از قدرتمندترین رقبای این حوزه در رقابت هوش مصنوعی برای برنامهنویسی و عملکرد عاملها به شمار میرود.
شرکت اعلام کرده است که DeepSeek-V4.1-Flash-1017 اکنون از طریق وبسایت، اپلیکیشن و API دیپسیک در دسترس است. این شرکت در مطلب معرفی محصول، بهروزرسانی جدید را در مقایسه با نسخه قبلی، DeepSeek-V4.1-Flash، «بهبودی پارتویی در عملکرد و هزینه» توصیف کرده است؛ به این معنا که به ادعای دیپسیک، کیفیت مدل افزایش یافته، بیآنکه سرعت آن کاهش پیدا کند یا هزینه اجرای آن بالا برود. این شرکت همچنین گفته است مدل جدید برای کار با DeepSeek Harness، ابزارهای CodeBuddy و WorkBuddy شرکت تنسنت و سایر ابزارهای برنامهنویسی مبتنی بر عامل هوش مصنوعی بهینهسازی شده است. دیپسیک به توسعهدهندگان توصیه کرده برای بهرهمندی کامل از این بهبودها، به نسخه v0.2.1-rc.1 یا نسخههای جدیدتر DeepSeek Harness ارتقا دهند.
دیپسیک V4.1-Flash-1017
دیپسیک جدول نسبتاً مفصلی از نتایج بنچمارکها منتشر کرده که در آن، V4.1-Flash-1017 با نسخه قبلی خود، DeepSeek V4.1-Flash، و همچنین مدلهای Kimi K3 از مونشات، GLM 5.3 از ژیپو، GPT 5.6-Sol از اوپنایآی و Claude Opus 5 از آنتروپیک مقایسه شده است. نتایج نشاندهنده برتری مطلق مدل جدید در همه آزمونها نیست، اما مشخص میکند که این مدل در چند آزمون مبتنی بر عاملهای هوش مصنوعی از اپوس ۵ جلو افتاده و در برخی دیگر همچنان از آن عقب است.
در ادامه، عملکرد دو مدل در بنچمارکهای منتشرشده مقایسه شده است.
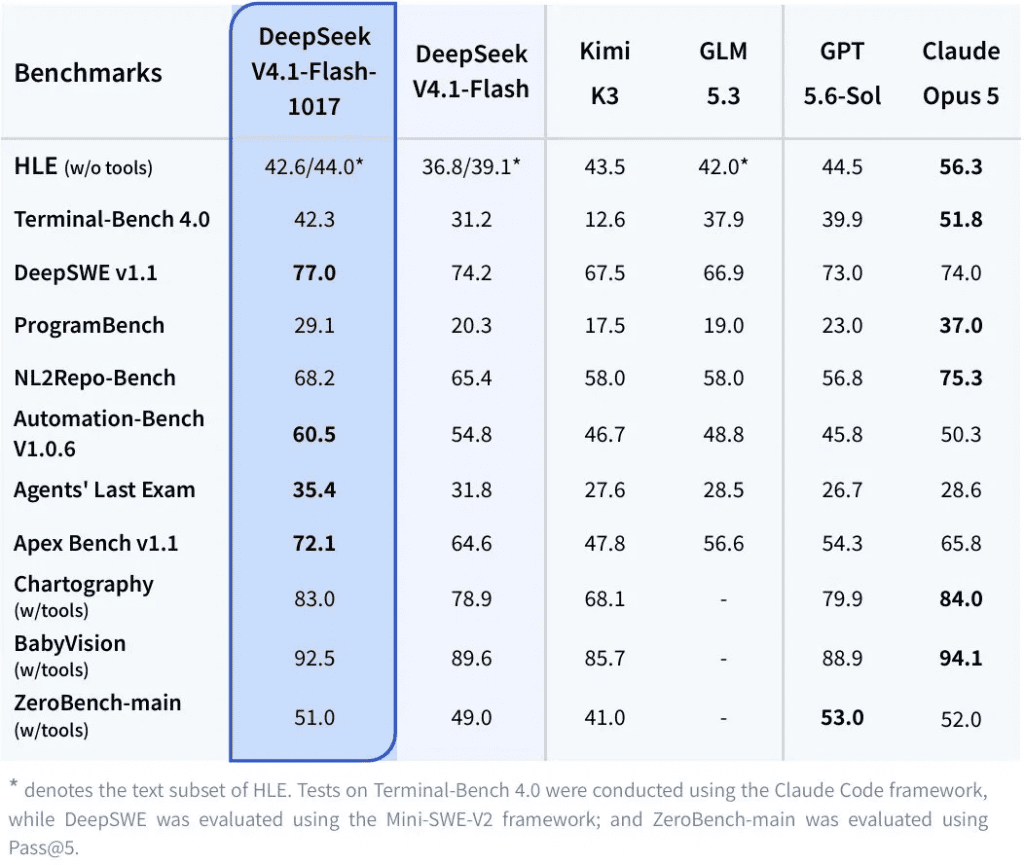
نکته برجسته در نتایج، آزمونهایی است که دیپسیک در آنها پیشتاز شده است: DeepSWE v1.1، یک بنچمارک مهندسی نرمافزار، Automation-Bench، Agents’ Last Exam و Apex Bench. همه این آزمونها بر فرایندهای چندمرحلهای مبتنی بر عاملهای هوش مصنوعی تمرکز دارند که در آنها مدل از ابزارها استفاده میکند؛ بنابراین، صرفاً توانایی پاسخگویی به یک پرسش در یک مرحله را نمیسنجند. DeepSeek-V4.1-Flash-1017 بیشترین اختلاف امتیاز خود با اپوس ۵ را در آزمون Agents’ Last Exam ثبت کرده است؛ جایی که امتیاز آن به ۳۵٫۴ میرسد، درحالیکه اپوس ۵ امتیاز ۲۸٫۶ را کسب کرده است. این مدل در Automation-Bench V1.0.6 نیز با امتیاز ۶۰٫۵ در برابر ۵۰٫۳ از رقیب خود پیش افتاده است.
در مقابل، کلود اپوس ۵ در آزمونهای سنجش دانش عمومی و استدلال، مانند Humanity’s Last Exam، با امتیاز ۵۶٫۳ در برابر امتیازهای ۴۲٫۶ و ۴۴٫۰ برای دیپسیک، برتری محسوسی دارد. این مدل همچنین در وظایف برنامهنویسی در سطح مخزن کد، از جمله NL2Repo-Bench و ProgramBench، عملکرد بهتری نشان میدهد. در بنچمارکهای بینایی و چندوجهی مبتنی بر استفاده از ابزارها، یعنی Chartography، BabyVision و ZeroBench-main، عملکرد دو مدل به هم نزدیک است و اپوس ۵ در هر آزمون تنها یک یا دو امتیاز برتری دارد.
در مقایسه با سایر رقبا، DeepSeek-V4.1-Flash-1017 تقریباً در تمام بنچمارکهای فهرستشده عملکرد بهتری از Kimi K3، GLM 5.3 و GPT 5.6-Sol دارد. این مدل همچنین در همه آزمونها از نسخه قبلی خود، DeepSeek V4.1-Flash، پیشی میگیرد؛ موضوعی که در واقع ادعای اصلی دیپسیک درباره این نسخه جدید است.
دیپسیک V4.1-Flash-1017؛ مزیت هزینه
دیپسیک علاوه بر امتیازهای خام، نموداری منتشر کرده است که امتیاز Pass@1 را در برابر هزینه اجرای مدل نشان میدهد. این نمودار بر اساس جدول رتبهبندی اختصاصی دیپسیک در بنچمارک DeepSWE v1.1 و با استفاده از چارچوب mini-swe-agent تهیه شده است و تصویر روشنتری از جایگاه نسخه جدید Flash ارائه میدهد. DeepSeek-V4.1-Flash-1017 حتی در پایینترین سطح تلاش استدلالی، امتیازی بالاتر از ۷۲ درصد کسب میکند، درحالیکه هزینه هر وظیفه حدود ۰٫۱۵ تا ۰٫۲۰ دلار است. در بالاترین سطح تلاش نیز امتیاز مدل به ۷۷ درصد میرسد و هزینه هر وظیفه همچنان کمتر از ۰٫۲۵ دلار باقی میماند.

برای مقایسه، کلود اپوس ۵ در سطوح بالاتر تلاش استدلالی به بیش از ۱۰ دلار هزینه برای هر وظیفه نیاز دارد تا به امتیازی در حدود ۷۳ درصد برسد. مدلهایی مانند GPT-6 Astra و Gemini 3.8 Flash نیز برای دستیابی به امتیازهایی مشابه، در بازه هزینهای ۲ تا ۱۰ دلار قرار میگیرند. نمودار دیپسیک، V4.1-Flash-1017 را در گوشه بالای سمت چپ نمودار قرار میدهد؛ ناحیهای که نشاندهنده دقت بالا و هزینه پایین است. این شرکت با استناد به این نمودار استدلال میکند که در این جدول رتبهبندی مشخص، مدل جدید Flash برای انجام وظایف مشابه، در مقایسه با بیشتر رقبا، از جمله کلود اپوس ۵، هزینه کمتری دارد و درعینحال کیفیتی برابر یا بهتر ارائه میدهد.
این تأکید بر بهرهوری هزینه با رویکردی همخوان است که دیپسیک از زمان عرضه مدل اولیه V3 دنبال کرده است؛ مدلی که برای نخستین بار انتظارات مربوط به قیمتگذاری در صنعت هوش مصنوعی را به چالش کشید. هدف این شرکت آن نیست که در تمام جدولهای رتبهبندی بهترین مدل باشد، بلکه میخواهد بخش بزرگی از عملکرد مدلهای پیشرفته را با کسری از هزینه محاسباتی آنها ارائه کند.
چرا این موضوع اهمیت دارد؟
DeepSeek-V4.1-Flash-1017 مدعی نیست که کلود اپوس ۵ را بهطور کامل از جایگاه خود کنار زده است. مدل آنتروپیک همچنان در استدلال خام، درک کد در مخازن بزرگ و دارای زمینه طولانی و بیشتر آزمونهای استفاده از ابزارهای چندوجهی برتری دارد. بااینحال، قابل توجه است که یک مدل در رده Flash، یعنی محصول سریعتر و احتمالاً ارزانتر دیپسیک، میتواند در بنچمارکهای عاملهای هوش مصنوعی مانند Agents’ Last Exam و DeepSWE v1.1 از مدلی پیشرفته همچون اپوس ۵ بهتر عمل کند. این اتفاق بازتابدهنده روند گستردهتری در صنعت هوش مصنوعی طی سال جاری است؛ روندی که در آن، آزمایشگاههای متنباز و چینی در حوزه وظایف مبتنی بر عاملهای هوش مصنوعی و برنامهنویسی فاصله خود را با آزمایشگاههای پیشرو آمریکایی کاهش دادهاند، هرچند شرکتهایی مانند آنتروپیک، اوپنایآی و گوگل همچنان در آزمونهای دشوارتر استدلال برتریهایی دارند.
برای توسعهدهندگانی که ابزارهای برنامهنویسی مبتنی بر عاملهای هوش مصنوعی میسازند، ترکیب امتیازهای رقابتی در بنچمارکهای عاملمحور، خروجیهای کوتاهتر و هزینه بسیار کمتر برای هر وظیفه احتمالاً از پیروزی در یک جدول رتبهبندی خاص قانعکنندهتر خواهد بود. دیپسیک اعلام کرده است که مدل جدید از پیش برای DeepSeek Harness، CodeBuddy و WorkBuddy بهینه شده و از توسعهدهندگانی که از نسخههای قدیمیتر چارچوب استفاده میکنند خواسته است برای مشاهده کامل بهبودها، به نسخه v0.2.1-rc.1 یا نسخههای جدیدتر ارتقا دهند.