
توکنمکسینگ؛ چگونه بیشترین بهره را از مدلهای هوش مصنوعی ببریم؟
اوایل امسال، کارکنان متا در مدت ۳۰ روز ۶۰ تریلیون توکن هوش مصنوعی مصرف کردند تا در جدول رتبهبندی داخلی این شرکت، معروف به «کلودونومیکس» (Claudeonomics)، جایگاه بالاتری به دست آورند. گرگلی اوروس، ستوننویس حوزه فناوری، هزینه این مصرف را برآورد کرد و به این نتیجه رسید که محاسبه آن بر اساس قیمتهای فهرستشده انتروپیک، حدود ۹۰۰ میلیون دلار میشود؛ هرچند متا احتمالاً بسیار کمتر از این مبلغ میپردازد.
جو وانگ، مشاور شرکت بینالمللی بیناند کامپنی، نمونههای کمسروصداتری از همین اتلاف منابع را در شرکتهای مختلف میبیند. او تابستان امسال به آسوشیتدپرس گفت: «شرکتها و کاربران زیادی برای همهچیز، حتی نوشتن ایمیل، بهطور پیشفرض از اوپوس استفاده میکنند.» او به مدلهای پیشرفته انتروپیک اشاره داشت. اگر شما هم همین کار را میکنید، مثل این است که آلبرت اینشتین را استخدام کنید تا باقی پول خریدتان را حساب کند.
هر کلمهای که در چتجیپیتی یا کلود تایپ میکنید و هر کلمهای که این ابزارها در پاسخ مینویسند، بر اساس واحدهایی به نام توکن محاسبه میشود؛ بخشهایی از متن که هرکدام بهطور متوسط حدود سهچهارم یک کلمه را تشکیل میدهند. در اشتراکی با هزینه ماهانه ۲۰ دلار، تعداد توکنها تعیین میکند چه زمانی به سقف استفاده خود میرسید. در رابط برنامهنویسی کاربردی یا API، که توسعهدهندگان برای اتصال مدلها به برنامههای خود و پرداخت هزینه بهازای مصرف توکن از آن استفاده میکنند، همین معیار مبلغ صورتحساب را مشخص میکند.
فهرست قیمت فعلی انتروپیک برای هر یک میلیون توکن به شرح زیر است:
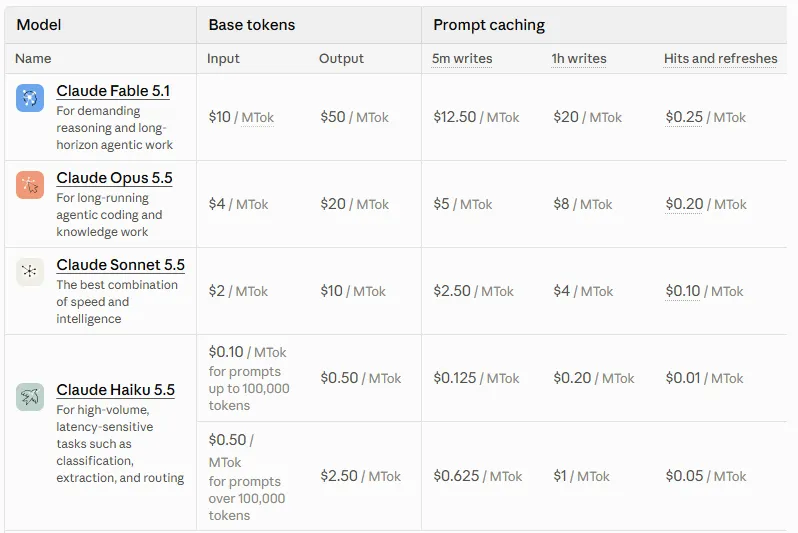
تعرفه مدل هایکو برای درخواستهایی با کمتر از ۱۰۰ هزار توکن اعمال میشود؛ درخواستهای طولانیتر پنج برابر هزینه دارند.
هزینه استفاده از پیشرفتهترین مدل انتروپیک ۱۰۰ برابر مدل کوچکتر آن است. در مجموعه مدلهای اوپنایآی نیز همین اختلاف دیده میشود: قیمت هر یک میلیون توکن ورودی از ۱۰ دلار تا ۰٫۱۰ دلار متغیر است. این هزینههای توکنی برای شرکتهای سازنده مدل و کاربرانشان بهسرعت افزایش مییابد. نرخ درآمد سالانه انتروپیک از حدود ۹ میلیارد دلار در پایان سال ۲۰۲۵ به بیش از ۴۷ میلیارد دلار در ماه مه رسید؛ در همین حال، اوپنایآی برای حفظ موقعیت خود با جنگ قیمتی روبهرو است.
چند عادت ساده میتواند این هزینهها را بهشدت کاهش دهد. پنج توصیه نخست این راهنما حتی به یک خط کدنویسی هم نیاز ندارند.
توکنمکسینگ چیست و باید به چه معنا باشد؟
توکنمکسینگ (Tokenmaxxing) ابتدا به نوعی خودنمایی در سیلیکونولی تبدیل شد؛ نمونهای از آن طرح کلودونومیکس متا بود. مایکروسافت، شاپیفای و آمازون نیز کارکنان خود را با جدولهای رتبهبندی مشابه بر اساس میزان مصرف توکن ارزیابی میکردند. جنسن هوانگ، مدیرعامل انویدیا، در ماه مارس و در پادکست «All-In» به این روند دامن زد. او گفت اگر مهندسی با حقوق ۵۰۰ هزار دلار دستکم ۲۵۰ هزار دلار توکن مصرف نکند، «عمیقاً نگران» خواهد شد.
کارکنان هم واقعاً توکن مصرف کردند؛ اما بخش زیادی از این مصرف صرف کارهای بیفایده و غیرمولد شد.
در آمازون، کارکنان اعتراف کردند که با اجرای ابزار هوش مصنوعی داخلی شرکت برای کارهای نامرتبط، آمار مصرف خود را عمداً بالا میبردند. سرانجام یکی از معاونان ارشد شرکت به کارکنان گفت: «لطفاً فقط برای اینکه از هوش مصنوعی استفاده کرده باشید، از آن استفاده نکنید.»
این راهنما از معنایی دفاع میکند که مهندسان اکنون بر آن تأکید دارند: باید بیشترین ارزش را از هر توکن به دست آورد، نه اینکه صرفاً تعداد توکنهای مصرفشده را افزایش داد.
برای فهمیدن اینکه توکنها کجا مصرف میشوند، باید با سه مفهوم آشنا شد. نخست، چرخه اجرای عامل هوش مصنوعی است. عامل، مدلی است که میتواند از ابزارها استفاده کند؛ بنابراین فکر میکند، در وب جستوجو میکند یا کد اجرا میکند، نتیجه را میخواند و این روند را تا زمانی ادامه میدهد که تشخیص دهد کار تمام شده است. در هر دور از این چرخه، کل مکالمه دوباره ارسال میشود.
هماهنگسازی چند عامل (Orchestration) هزینه را بیشتر میکند. در این روش، یک مدل نقش مدیر را بر عهده میگیرد، درخواست را به بخشهای کوچکتر تقسیم میکند، هر بخش را به مدلهای دیگری به نام عاملهای فرعی میسپارد و در نهایت پاسخهای آنها را کنار هم قرار میدهد. هر عامل فرعی چرخه اجرای مستقل و حافظه خودش را دارد. به همین دلیل، انتروپیک میگوید گروههای عامل در کلود کد، هنگامی که اعضای گروه در حالت برنامهریزی کار میکنند، ممکن است حدود هفت برابر یک نشست معمولی توکن مصرف کنند. این حالت در توصیههای سطح متوسط این راهنما توضیح داده میشود.
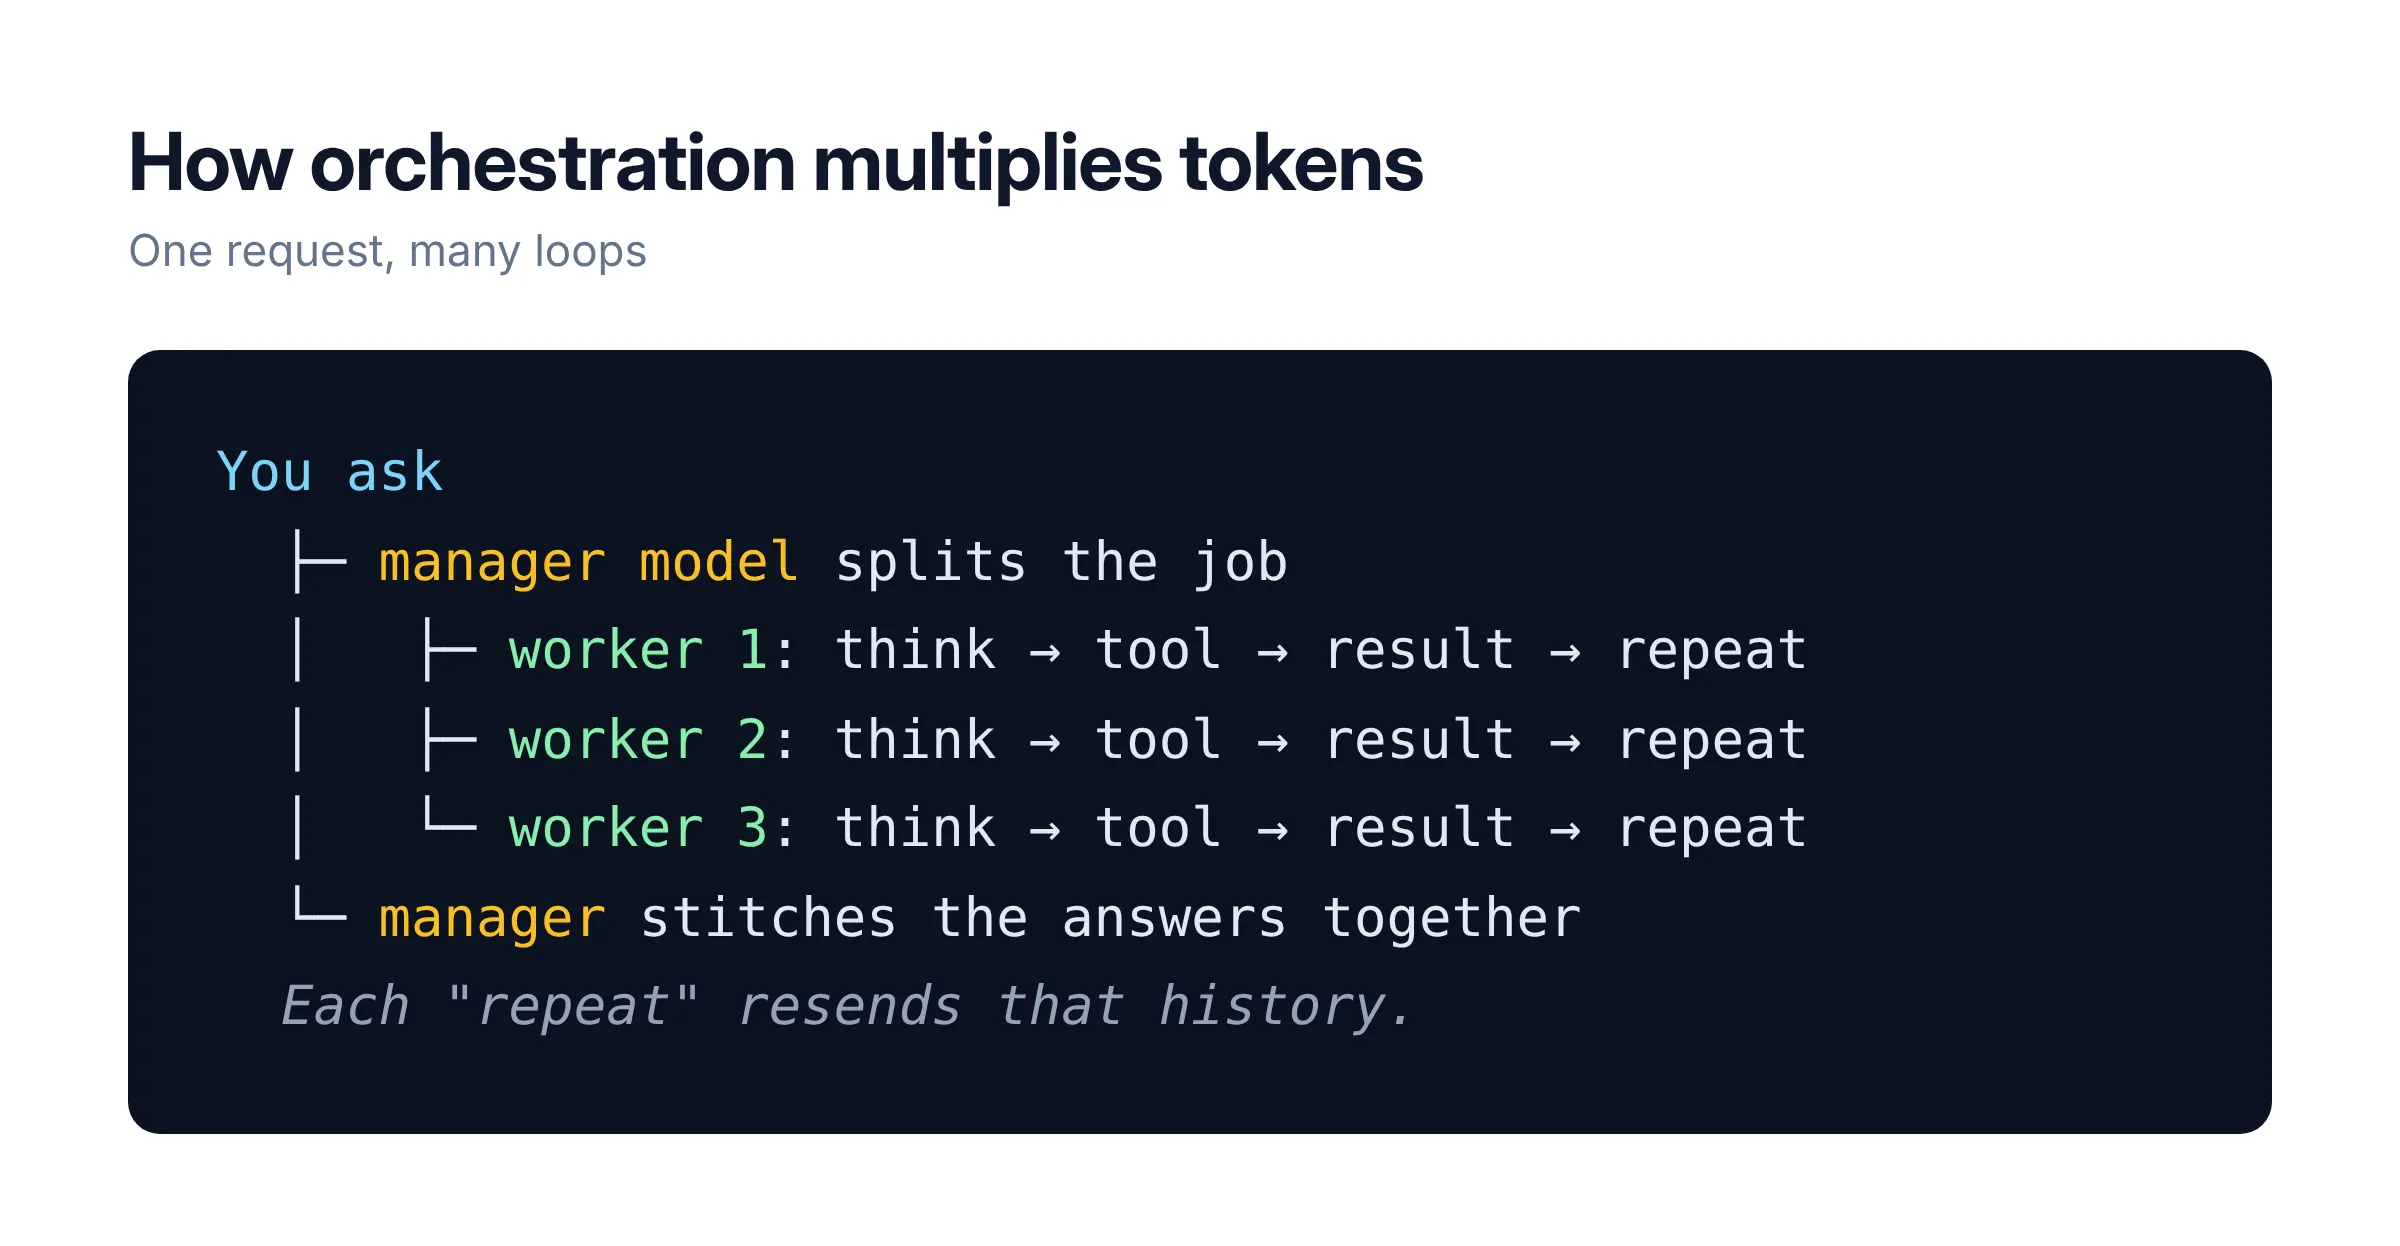
توسعهدهندگان برای جلوگیری از سرگردانشدن این چرخهها از نمودارهای گردش کار استفاده میکنند. چارچوبهایی مانند LangGraph امکان ترسیم روند کار، شبیه نقشه مترو، را فراهم میکنند. ایستگاهها یا گرهها وظایف را انجام میدهند و مسیرهای اتصال یا یالها مشخص میکنند که مرحله بعدی کدام است. در نتیجه، مدل از یک مسیر ازپیشتعیینشده پیروی میکند، بهجای آنکه بیوقفه ادامه دهد تا ایدههایش تمام شود یا بودجه به پایان برسد.
به بیان دیگر، چرخههای اجرایی به خودکارسازی کارها و افزایش کیفیت کمک میکنند، اما هزینه زیادی هم دارند. بنابراین، استفاده کارآمد از آنها اهمیت زیادی دارد. توصیههای زیر میتوانند در این زمینه مفید باشند.
سطح مبتدی: کارهای کوچک، مدلهای کوچک
۱. برای هر کار، مدل مناسب را انتخاب کنید
اگر تازه کار با هوش مصنوعی را شروع کردهاید، احتمالاً از رابط گرافیکی یک برنامه استفاده میکنید.
روی نام مدل در برنامه گفتوگوی خود کلیک کنید؛ در چتجیپیتی این گزینه بالای صفحه گفتوگو قرار دارد و در کلود یا هرمس، کنار دکمه ارسال دیده میشود. سپس برای نوشتن ایمیل، خلاصهسازی و بازنویسی، مدل کوچکتر و سریعتری انتخاب کنید. مدل پیشرفته را برای استدلالهای دشوار و تصمیمهایی نگه دارید که یک اشتباه جزئی در آنها میتواند هزینه مالی واقعی داشته باشد.
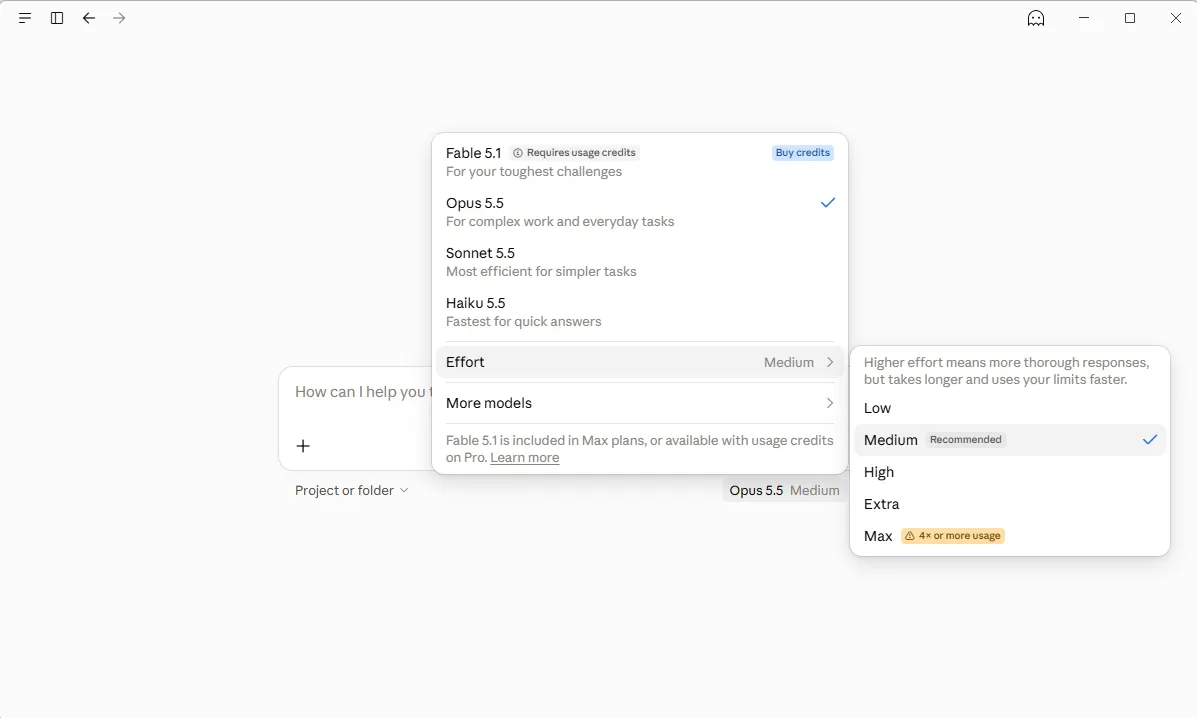
پنج مورد از کارهایی را که هفته گذشته انجام دادهاید، با هر دو مدل آزمایش کنید و پاسخها را کنار هم بگذارید. اگر مدل کوچکتر نتیجه قابلقبولی ارائه داد، همان را انتخاب کنید. در اشتراک ماهانه، این کار باعث میشود دیرتر به سقف مصرف برسید و در API میتواند هزینه را تا ۹۹ درصد کاهش دهد.
۲. بهجای پنج دستور نامناسب، یک دستور خوب بنویسید
اگر سه بار مجبور شوید بگویید «نه، فقط جمع کل را بده» یا «این را بهتر و دقیقتر کن»، مدل هر بار کل مکالمه را دوباره پردازش میکند. یک دستور روشن باید وظیفه و قالب دقیق پاسخ را از ابتدا مشخص کند. برای مثال، میتوانید چنین درخواستی بنویسید:
شماره فاکتور، تاریخ، نام فروشنده و مبلغ کل را از متن زیر استخراج کن. مقادیر را دقیقاً همانطور که نوشته شدهاند نگه دار. برای هر مورد یک خط بنویس و اگر اطلاعاتی وجود ندارد، عبارت «موجود نیست» را درج کن.
آزمایشهای خود اوپنایآی نشان دادهاند که دستورهای کوتاهتر و شفافتر، با مصرف توکن کمتر، امتیاز بالاتری کسب میکنند.
۳. هنگام تغییر موضوع، گفتوگوی تازهای باز کنید
مدل هر بار که دکمه ارسال را میزنید، کل مکالمه را دوباره میخواند. بنابراین، اگر رشتهای شامل ۵۰ پیام درباره تعطیلات داشته باشید، پرسیدن سؤال مالیاتی در همان گفتوگو هم هزینه را بیشتر میکند و هم میتواند کیفیت پاسخ را کاهش دهد.
انتروپیک برای این افت کیفیت ناشی از انباشتهشدن زمینه مکالمه اصطلاح «فرسودگی زمینه» (Context Rot) را به کار میبرد.
پس هر زمان موضوع گفتوگو تغییر کرد، یک گفتوگوی تازه باز کنید.
۴. پاسخ را به اندازه نیازتان محدود کنید
در مدلهای پیشرفته انتروپیک و اوپنایآی، هزینه توکنهای خروجی پنج برابر توکنهای ورودی است. در پایان دستور خود عباراتی مانند «سه نکته، در کمتر از ۱۰۰ کلمه» یا «فقط خطوط تغییرکرده» را اضافه کنید تا مدل فضای کمتری برای تولید متن اضافی داشته باشد.
وقتی طول پاسخ از ابتدا محدود شود، مصرف توکن کاهش مییابد؛ این روش بهویژه برای کارهای خلاقانه، مانند نوشتن یا پژوهش، مفید است، زیرا برخلاف کارهای دارای پاسخ مشخص، مانند کدنویسی یا حل مسائل ریاضی، این وظایف میتوانند به شکلهای بسیار متفاوتی انجام شوند.
۵. پیش از پرداخت، گزینههای رایگان را امتحان کنید
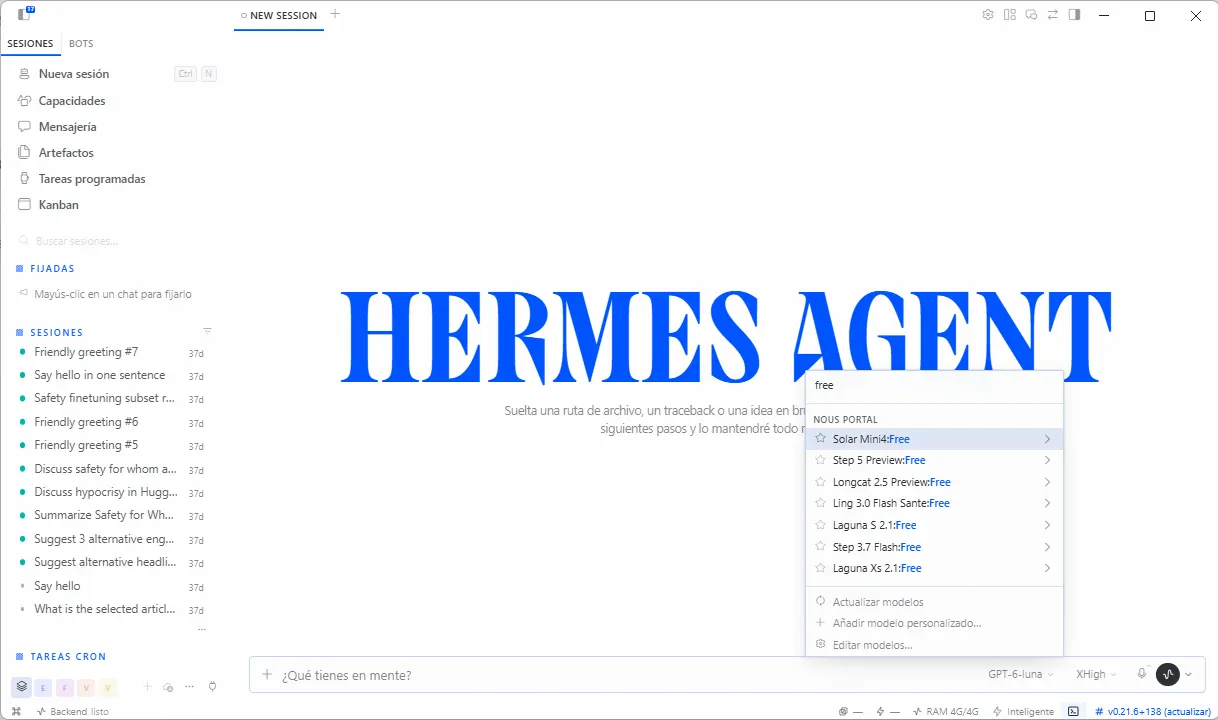
سایت اوپنروتر که دسترسی به صدها مدل هوش مصنوعی را از طریق یک حساب فراهم میکند، مسیریاب رایگانی دارد که درخواست شما را به یکی از حدود ۲۰ مدل بدون هزینه میفرستد. همچنین میتوانید با استفاده از الام استودیو یا اولاما، مدلها را بهصورت محلی روی رایانهای با کارت گرافیک دارای ۸ گیگابایت حافظه ویدئویی یا روی مک مجهز به تراشه سری M اپل اجرا کنید.
طرحهای رایگان ممکن است یکشبه از دسترس خارج شوند؛ بنابراین، پروژههای مهم خود را به آنها وابسته نکنید و پیش از واردکردن اطلاعات حساس، سیاست حفظ حریم خصوصی و استفاده از دادهها را بخوانید.
بااینحال، میتوانید با استفاده از پیشنهادهای رایگان، دفعات آزمایش و اصلاح درخواستهای خود را افزایش دهید. هرمس مجموعه مناسبی از مدلهای رایگان دارد که ممکن است نیاز شما را برطرف کنند؛ انویدیا نیز چنین گزینههایی ارائه میدهد. بهتر است دستور خود را با یک مدل رایگان و کمتوانتر اصلاح کنید تا اینکه برای انجام همان کار، فقط با سرعت بیشتر، هزینه مدل گرانقیمت را بپردازید.
چند توصیه دیگر برای مبتدیان
برای پرسشهای ساده، قابلیت استدلال طولانی را غیرفعال کنید یا در مدلهای جدیدتر کلود، سطح تلاش استدلالی را پایین بیاورید؛ در برخی مدلها امکان خاموشکردن کامل این قابلیت وجود ندارد. انتروپیک کل فرایند استدلال را، حتی بخشهایی را که کاربر نمیبیند، بهعنوان خروجی محاسبه و هزینه آن را دریافت میکند.
مشترکان کلود پرو و مکس که اعتبار مصرف اضافه را فعال میکنند، میتوانند از مسیر تنظیمات و سپس بخش مصرف (Usage)، سقف هزینه ماهانه تعیین کنند.
سطح متوسط: عامل شما بیش از حد میخواند
از این بخش به بعد، مثالها بر اساس کلود کد نوشته شدهاند؛ عامل انتروپیک که در ترمینال اجرا میشود و فایلها را ویرایش میکند. دستورها مستقیماً در کادر گفتوگوی آن وارد میشوند. ابزارهای مشابه نیز معمولاً منطق یکسانی دارند.
اگر فقط از برنامههای گفتوگومحور استفاده میکنید، توصیه شماره ۸ در هر پنجره گفتوگویی قابل اجراست.
۶. با مدل ارزان شروع کنید و فقط در صورت شکست سراغ مدل قویتر بروید
برای تغییر مدل، دستور /model را وارد کنید. سونت را مدل پیشفرض نگه دارید و تنها زمانی به اوپوس ارتقا دهید که سونت در انجام وظیفه مشخصی شکست بخورد؛ مثلاً پس از دو تلاش نتواند یک باگ را برطرف کند. مستندات انتروپیک پیشنهاد میکنند برای کارهای ساده عاملهای فرعی، مدل را در تنظیمات آنها روی haiku قرار دهید.
۷. میان کارهای نامرتبط، زمینه مکالمه را پاک کنید
هنگام جابهجایی به کاری نامرتبط، دستور /clear را وارد کنید. این دستور هزینهای ندارد و سابقه قبلی را حذف میکند. اگر به حفظ بخشی از سابقه نیاز دارید، میتوانید از دستور /compact همراه با توضیح استفاده کنید؛ برای مثال، /compact keep the database decisions تا تصمیمهای مربوط به پایگاه داده حفظ شوند. از این روش فقط زمانی استفاده کنید که سابقه واقعاً لازم است، زیرا فشردهسازی خود یک درخواست نسبتاً بزرگ به شمار میرود.
۸. محاسبات تکراری را به کد بسپارید
اگر صفحهگستردهای با ۵۰۰۰ ردیف را در گفتوگو جایگذاری کنید، مدل باید تمام ردیفها را بخواند و حتی در این صورت ممکن است تعدادها را اشتباه محاسبه کند؛ زیرا مدل زبانی، هرقدر هم هزینه آن بالا باشد، ماشینحساب نیست.
بهجای این کار، از مدل بخواهید یک فرمول یا اسکریپت کوتاه بنویسد، آن را خودتان اجرا کنید و فقط نتیجه را به مدل بدهید.
۹. تعداد ابزارهای متصل را کاهش دهید
سرورهای MCP افزونههایی هستند که مدل را به برنامههایی مانند گیتهاب یا گوگل درایو متصل میکنند. هر سرور، نام ابزارها و دستورالعملهای تازهای به تمام نشستها اضافه میکند.
برای دیدن اینکه چه چیزی فضای زمینه را اشغال کرده است، دستور /context را وارد کنید و با دستور /mcp سرورهایی را که پروژه به آنها نیاز ندارد، غیرفعال کنید.
چند توصیه دیگر برای سطح متوسط
برای مشاهده محل مصرف توکنها، دستور /usage را اجرا کنید. فایل دستورالعمل CLAUDE.md یا Soul.md را که عامل در ابتدای هر نشست میخواند، به کمتر از ۲۰۰ خط محدود کنید.
برای تغییرات بزرگتر، کلیدهای Shift و Tab را فشار دهید تا به حالت برنامهریزی بروید. در این حالت، عامل پیش از دستزدن به فایلها طرحی پیشنهاد میکند که میتوانید آن را تأیید کنید. اگر دیدید در مسیر اشتباهی پیش میرود، فوراً کلید Esc را بزنید. همچنین با دستور /effort میتوانید سطح استدلال را برای کارهای ساده، مانند تغییر نام یک متغیر، کاهش دهید.
انتروپیک نشان داده است که با بارگذاری صرفاً تعریف ابزارهای موردنیاز، مصرف توکن یک عامل از ۱۵۰ هزار توکن به ۲ هزار توکن کاهش یافته است. به همین دلیل، ابزارهای خط فرمان مانند ابزار gh گیتهاب که تا پیش از اجرا هزینهای ندارند، اغلب از افزونهای که دائماً فعال است، گزینه بهتری هستند.
سطح پیشرفته: محدودیتهای ایمنی و کنترلی را در خود سیستم تعبیه کنید
فرض کنید توسعهدهندهای باید ۱۰۰۰ فاکتور را پردازش کند که هرکدام ۲۰۰۰ توکن دارند و پاسخ مربوط به هر فاکتور نیز ۲۰۰ توکن است. پیش از اعمال روشهای صرفهجویی که در ادامه میآیند، این کار با فِیبل ۵.۱ حدود ۳۰ دلار و با هایکو ۵.۵ حدود ۰٫۳۰ دلار هزینه خواهد داشت.
۱۰. بخشهایی را که تغییر نمیکنند، در حافظه نهان ذخیره کنید
دستورالعملهای ثابت را در ابتدای درخواست و بخشهای متغیر را در انتهای آن قرار دهید و بخش ثابت را برای ذخیرهسازی در حافظه نهان مشخص کنید. در API انتروپیک، این کار با افزودن یک فیلد انجام میشود:
"system": [
 {
 "type": "text",
 "text": "Your invoice instructions...",
 "cache_control": {"type": "ephemeral"}
 }
]
خواندن اطلاعات از حافظه نهان کسری از هزینه معمول توکن ورودی را دارد، اما نوشتن در حافظه نهان پیشفرض پنجدقیقهای هزینه اضافی ایجاد میکند. فیلد cache_read_input_tokens را در پاسخ هر درخواست بررسی کنید. اگر پس از نخستین فراخوانی همچنان مقدار صفر را نشان میدهد، حافظه نهان بهدرستی کار نمیکند.
۱۱. هر کاری را که میتواند منتظر بماند، دستهای پردازش کنید
اوپنایآی و انتروپیک هر دو برای پردازش دستهای درخواستها ۵۰ درصد تخفیف در نظر میگیرند. اوپنایآی وعده میدهد نتایج را ظرف ۲۴ ساعت تحویل دهد. بهجای ارسال ۱۰۰۰ درخواست جداگانه و همزمان، فاکتورها را در یک فایل دستهای بارگذاری کنید تا هزینه به میزان قابلتوجهی کاهش یابد.
۱۲. برای عاملها محدودیت تعیین کنید
برای هر بار اجرای عامل، حداکثر تعداد گامها و سقف هزینه دلاری تعیین کنید و پیش از شروع، دقیقاً مشخص کنید که پایان موفقیتآمیز کار چه معنایی دارد. کلود کد در اجراهای اسکریپتی از پرچم --max-budget-usd پشتیبانی میکند. شاپیفای نیز از کلیدهای قطع اضطراری استفاده میکند که در صورت افزایش ناگهانی هزینههای یک توسعهدهنده طی یک روز، میتوانند دسترسی او را فوراً قطع کنند. این سازوکار برای شناسایی عاملهایی طراحی شده است که از کنترل خارج میشوند.
در حال حاضر، رویکرد رایج این است که عاملها را آزاد بگذارند تا آنقدر چرخه اجرا را ادامه دهند که نتیجه بهاصطلاح بینقص شود. اما اگر بودجه کافی ندارید، نباید تشخیص اینکه چه چیزی «بینقص» است را بدون محدودیت به عاملهای خود بسپارید.
چند توصیه دیگر برای سطح پیشرفته
در دستورهای طولانی، اطلاعات حیاتی را در ابتدا یا انتهای متن قرار دهید. پژوهشی به سرپرستی دانشگاه استنفورد نشان داده است که مدلها اطلاعات موجود در این دو موقعیت را بهتر به کار میگیرند و اطلاعات مدفون در بخش میانی متن را ضعیفتر پردازش میکنند. متن پژوهش این یافته را شرح میدهد.
فقط زمانی هزینه استفاده از یک مدل دوم برای بررسی نتیجه را بپردازید که اشتباهکردن هزینه زیادی داشته باشد؛ برای مثال، هنگام بررسی یک بند قرارداد یا مبلغ پرداخت. در API اوپنایآی، برای هر پروژه سقف سخت هزینه تعیین کنید، زیرا هشدارهای هزینه این سرویس صرفاً به شما اطلاع میدهند و جلوی ادامه درخواستها را نمیگیرند.
با یک آزمایش شروع کنید
برای یک هفته، ارزانترین مدلی را که در آزمون پنجوظیفهای توصیه شماره ۱ شما قبول شده است، مدل پیشفرض قرار دهید و تنها زمانی به مدل قویتر بروید که شکست بخورد. سپس صفحه مصرف خود را با هفته قبل مقایسه کنید. در مثال پردازش فاکتورها، تنها با هدایت درخواستها به مدل مناسب، هزینه از ۳۰ دلار به ۳٫۹۰ دلار کاهش یافت؛ این رقم حتی پس از پرداخت هزینه استفاده از اوپوس ۵.۵ برای انجام دوباره ۳۰۰ مورد ناموفق به دست آمد.
البته ارزانشدن توکنها بهتنهایی مشکل را حل نمیکند. بر اساس شاخص هزینه مصرف توکن شرکت سیلیکون دیتا، قیمت هر توکن از سال ۲۰۲۳ بیش از ۹۰ درصد کاهش یافته است، اما هزینهکرد برای مدلهای زبانی بزرگ از اواخر سال ۲۰۲۵ تاکنون دو برابر شده است.
اقتصاددانان این پدیده را «پارادوکس جونز» مینامند: وقتی استفاده از یک منبع آنقدر ارزان میشود که مردم در مجموع بیشتر از آن مصرف میکنند. گزارشی از بیناند کامپنی در ماه ژوئن نیز همین الگو را نشان داد؛ هزینه توکنها از دسامبر ۲۰۲۴ تا دسامبر ۲۰۲۵ به نصف رسید، درحالیکه تعداد توکنهای مصرفشده ۴۵۰ درصد افزایش یافت.
نکته مثبت این است که کاهش قیمتها بهمحض آنکه مصرف بیهوده توکنها را کنار بگذارید، به سود شما تمام میشود. اگر این کاهش قیمت را با عادتهای پیشنهادی بالا همراه کنید، میتوانید هم هزینه استفاده از هوش مصنوعی را پایین بیاورید و هم کیفیت کار را بهبود دهید.