
اوپنایآی قابلیت ساخت صدا با توصیف متنی و ۹ صدای جدید را به API مدل GPT-Live اضافه کرد
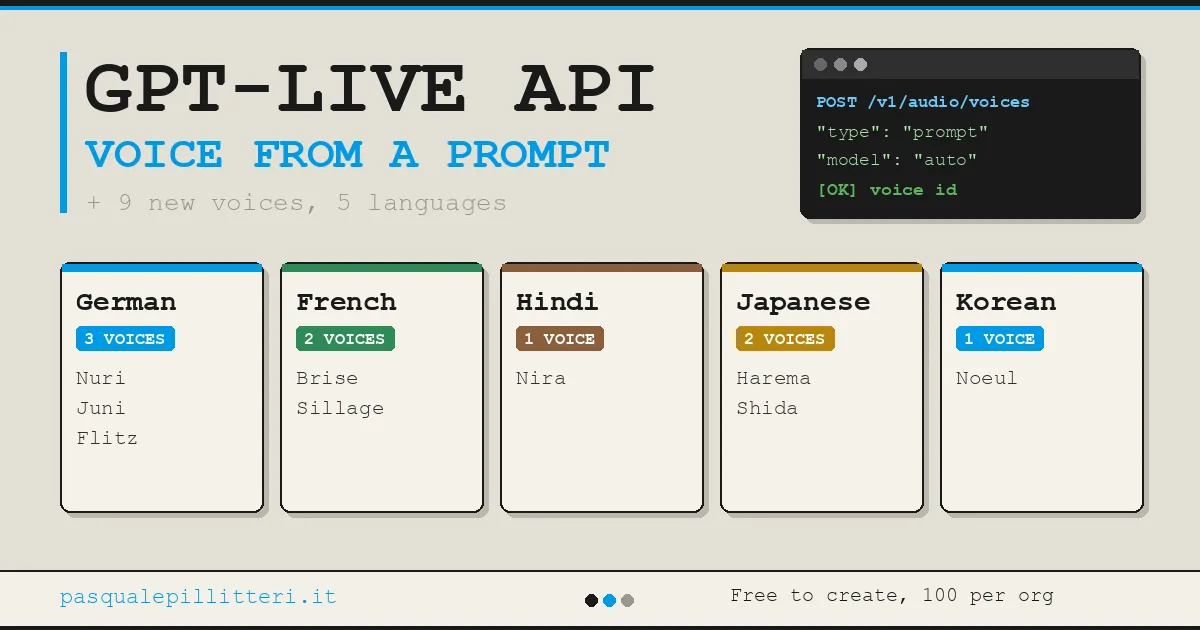
اوپنایآی در ۱۶ اکتبر قابلیت ساخت صدای سفارشی از روی توصیف متنی (Prompt-to-Voice) را برای همه مشتریان API خود در دسترس قرار داد و ۹ صدای طبیعی جدید نیز به مدل GPT-Live افزود. این صداها به پنج زبان آلمانی، فرانسوی، هندی، ژاپنی و کرهای ارائه شدهاند. بر اساس تاریخچه تغییرات ابزارهای توسعهدهندگان این شرکت مستقر در کالیفرنیا، ساخت صدای سفارشی رایگان است، اما استفاده از آن برای تولید گفتار، مطابق تعرفه معمول جلسات محاسبه میشود.
GPT-Live مدل صوتی اوپنایآی است که میتواند همزمان به صحبتهای کاربر گوش دهد و پاسخ دهد؛ قابلیتی موسوم به تمامدوطرفه (Full-duplex) که تجربهای شبیه تماس تلفنی واقعی فراهم میکند و نیازی به انتظار برای پایان نوبت صحبت طرف مقابل ندارد. این مدل در ماه ژوئیه با قابلیت صوتی ChatGPT برای گوشدادن و صحبتکردن همزمان معرفی شد. از ۱۰ سپتامبر نیز از طریق API در اختیار توسعهدهندگان قرار گرفت. افرادی که دستیار تلفنی یا عامل صوتی میسازند، میتوانند این مدل را به برنامه خود متصل کنند و صدای موردنظرشان را برای تعامل با کاربران انتخاب کنند. همین خانواده از صداها پیشتر برای کنترل صوتی عاملها در نسخه دسکتاپ ChatGPT نیز به کار گرفته شده بود. اعلامیه جدید اوپنایآی که حساب کاربری @OpenAIDevs نیز آن را منتشر کرده، مستقیماً بر همین امکان انتخاب و شخصیسازی صدا تمرکز دارد.
Building apps with GPT-Live-1? Give them a voice that fits.
Here’s how to shape a voice with a prompt or choose from new international preset voices: https://t.co/HtMsozvqE7
همین حالا امتحان کنید
قابلیت ساخت صدا از روی توصیف متنی برای همه مشتریان API اوپنایآی در دسترس است. کاربران میتوانند از محیط Voice Playground یا با ارسال درخواست به مسیر /v1/audio/voices از آن استفاده کنند. برای این کار، داشتن حساب کاربری و کلید API ضروری است. ساخت صدا هزینهای ندارد، اما شنیدن آن در محیط Playground یک جلسه پولی GPT-Live محسوب میشود.
مشاهده راهنمای ساخت صداهای سفارشی
اوپنایآی در ۱۶ اکتبر چه قابلیتهایی منتشر کرد؟
مدخل تاریخ ۱۶ اکتبر در تاریخچه تغییرات با برچسب gpt-live-1 ثبت شده و دو مسیر /v1/audio/voices و /v1/live/sessions را در بر میگیرد. این بهروزرسانی شامل دو تغییر است. نخست، اوپنایآی قابلیتی را که از آن با عنوان «انتشار قابلیت ساخت صدا از روی توصیف متنی برای همه مشتریان API» یاد میکند، ارائه کرده است. با این امکان، توسعهدهندگان میتوانند ویژگیهای صدای دلخواه خود را با زبان معمولی توصیف کنند و سپس در جلسات GPT-Live از آن استفاده کنند. تغییر دوم، افزودن ۹ صدای ازپیشآماده طبیعی است که بدون نیاز به نوشتن توصیف قابل انتخاباند.
این بهروزرسانی با برچسب gpt-live-1.1 منتشر نشده است. اوپنایآی یک روز پیشتر، نسخه ۱.۱ را برای ChatGPT، Codex و dots معرفی کرده بود که ۱۳ صدای جدید داشت؛ بااینحال، درباره عرضه این نسخه برای API فقط عبارت «بهزودی» را اعلام کرده بود و تاریخی مشخص نکرده بود. جزئیات آن در گزارش عرضه GPT-Live-1.1 در ChatGPT با ۱۳ صدای جدید آمده است. بنابراین، ۹ صدای جدید امروز قابلیت جداگانهای هستند که برای توسعهدهندگان نرمافزار در نظر گرفته شدهاند. سایر تغییرات نسخه ۱.۱ فعلاً به API راه نیافتهاند.
چگونه در API مدل GPT-Live با توصیف متنی صدا بسازیم؟
برای ساخت صدا، باید یک درخواست JSON به مسیر /v1/audio/voices ارسال کنید و نوع را روی prompt قرار دهید، برای صدا نامی انتخاب کنید و ویژگیهای صوتی آن را شرح دهید. پاسخ سرویس شناسه صدای جدید را برمیگرداند. هنگام ایجاد جلسه GPT-Live، باید این شناسه را در فیلد session.audio.output.voice.id قرار دهید. برای این فرایند به فایل ضبطشده صدا یا فرم رضایتنامه نیازی نیست.
راهنمای صداهای سفارشی جزئیات عملی بیشتری ارائه میدهد. در نمونه کد این راهنما، مقدار فیلد مدل auto است. همچنین میتوان بهصورت اختیاری متنی نمونه با نام script_hint ارائه کرد که حداکثر ۲ هزار نویسه دارد و به هدایت فرایند تولید صدا کمک میکند. اگر این فیلد ارائه نشود، سرویس متن نمونهای را بر اساس توصیف صدا میسازد. پاسخ API فقط فرادادههایی مانند شناسه، نام، تاریخ ایجاد و متن توصیف را در بر میگیرد و هیچ فایل صوتی، حتی یک پیشنمایش کوتاه، ارائه نمیکند. برای شنیدن صدا باید یک جلسه باز کنید؛ حتی اگر این کار فقط در محیط Playground انجام شود، هزینه جلسه محاسبه خواهد شد.
در توصیف صدا میتوان به لهجه، سن، جنسیتنمایی صدا، زیر یا بم بودن، طنین، بافت صوتی از زبر تا شفاف، شدت صدا، سرعت صحبتکردن و میزان متمایز بودن آن اشاره کرد. این ویژگیها بهصورت واژه و عبارت در متن توصیف نوشته میشوند و پارامترهای جداگانهای نیستند. در نمونه انگلیسی اوپنایآی، صدایی آرام و اطمینانبخش برای پشتیبانی مشتریان درخواست شده است که متعلق به فردی بزرگسال باشد، لهجه آمریکایی داشته باشد، از نظر زیر و بمی در محدوده متوسط قرار بگیرد و با سرعتی یکنواخت صحبت کند.
یک نکته مهم که ممکن است بهآسانی نادیده گرفته شود، این است که برای رسیدن به نتیجه مطلوب باید همان توصیف صدا را در کنار دستورهای مکالمه برنامه، در فیلد session.instructions نیز وارد کنید. به این ترتیب، مشخصات صدا در دو بخش ثبت میشود. اگر توسعهدهنده مرحله دوم را فراموش کند، صدای تولیدشده ممکن است بهاندازه کافی با توصیف اولیه مطابقت نداشته باشد. به همین دلیل، اوپنایآی توصیه میکند شناسه صدا همراه با متن اصلی توصیف آن ذخیره شود.
راهنمای اوپنایآی برای تنظیم صدا رویکردی محتاطانه پیشنهاد میکند: هر بار فقط یک ویژگی را تغییر دهید و نتایج را با استفاده از یک متن کوتاه یکسان و چند خط گفتوگو مقایسه کنید. هنگام ارزیابی، به لهجه و سرعت صحبتکردن توجه کنید. قواعد مکالمه، از جمله طول پاسخها، نحوه مدیریت قطعشدن صحبت و زمان واگذاری کار به مدلی قدرتمندتر، باید در دستورهای جلسه تعریف شوند، نه در توصیف صدا. یکی از نمونههای رسمی مناسب، صدایی با عنوان «راهنمای پرانرژی» است که شفاف، کمی زیرتر، سرزنده و سریع صحبت میکند، اما همچنان بهراحتی قابل دنبالکردن است.
۹ صدای جدید به تفکیک زبان
بر اساس فهرست منتشرشده در تاریخچه تغییرات، ۹ صدای ازپیشآماده جدید در پنج زبان ارائه شدهاند.
| زبان | صداهای جدید در API |
|---|---|
| آلمانی | Nuri، Juni، Flitz |
| فرانسوی | Brise، Sillage |
| هندی | Nira |
| ژاپنی | Harema، Shida |
| کرهای | Noeul |
نام صداهای API با صداهای موجود در اپلیکیشن ChatGPT یکسان نیست. در ChatGPT، صداهای فرانسوی Aube و Rivage و صداهای آلمانی Sonna و Miko هستند. اما فهرست API متفاوت است: زبان آلمانی سه صدای جدید دارد، درحالیکه برای هندی و کرهای فقط یک صدا ارائه شده است. در تاریخچه تغییرات نیز اشارهای به اسپانیایی مکزیکی یا Bubbie، صدای انگلیسی اضافهشده به ChatGPT، نشده است. بنابراین، توسعهدهندگانی که خدماتی برای مشتریان هند یا کره ارائه میکنند، در میان صداهای ازپیشآماده انتخابهای محدودی دارند. قابلیت ساخت صدا با توصیف متنی جایگزین دیگری است، هرچند راهنما مشخص نمیکند که این قابلیت از چه زبانهایی پشتیبانی میکند.
چرا این تغییر برای توسعهدهندگان مهم است؟
تا پیش از این، توسعهدهندگانی که میخواستند دستیارشان صدایی متمایز و قابلشناسایی داشته باشد، ناچار بودند به صداهای ازپیشآماده بسنده کنند یا برای دسترسی به صداهای ساختهشده از روی فایلهای ضبطشده درخواست مجوز بدهند. قابلیت ساخت صدا با توصیف متنی این انتخاب را در اختیار هر کسی قرار میدهد که کلید API داشته باشد. برای مثال، دستیار یک بانک ممکن است به صدایی آرام و متین نیاز داشته باشد، درحالیکه دستیار یک باشگاه ورزشی میتواند صدایی پرانرژیتر داشته باشد. اکنون میتوان این تفاوت را در چند خط توصیف کرد، بهجای آنکه در میان فهرستی از صداها به دنبال گزینه مناسب گشت. اوپنایآی تنها شرکت فعال در حوزه صدای تمامدوطرفه نیست؛ برای نمونه، مایکروسافت مدل MAI Realtime را با پشتیبانی از ۱۷ زبان ارائه کرده است. در راهکار اوپنایآی، مانع اصلی بیشتر به شیوه کار مربوط میشود تا هزینه، زیرا ساخت صدا رایگان است و هزینه آزمایش آن بر اساس مدت جلسه محاسبه میشود.
یک روز پیشتر، در ۱۵ اکتبر، تغییر دیگری برای GPT-Live در تاریخچه تغییرات ثبت شده بود: یکپارچهسازی بومی با Decisions. این قابلیت به برنامه اجازه میدهد زمانی که کاربر هنوز صحبت میکند اقدامی انجام دهد یا به صحبتهای مدل Live واکنش نشان دهد. همچنین Live میتواند از طریق واگذاری مستقیم کار، Decisions را فراخوانی کند. این دو تغییر در کنار هم معنا پیدا میکنند: یکی به نحوه صحبتکردن دستیار مربوط است و دیگری به کارهایی که هنگام صحبتکردن میتواند انجام دهد.
بااینحال، باید یک محدودیت را در نظر داشت. طبق هشدار راهنما، منحصربهفرد بودن صداها تضمین نمیشود و شناسه هر صدا باید همراه با توصیفی که آن را تولید کرده است نگهداری شود. بنابراین، متن توصیف بهتر است مانند یکی از فایلهای اصلی پروژه در نظر گرفته شود و در کنار کد، تحت مدیریت نسخه قرار بگیرد. بر اساس تجربه نویسنده، این همان بخشی است که هنگام انتقال مسئولیت برنامه به افراد دیگر، زودتر از بقیه گم میشود.
محدودیتها و مقررات استفاده
شرایط ذکرشده در راهنمای اوپنایآی برای برنامههایی که این قابلیت را به اشخاص ثالث ارائه میکنند، اهمیت ویژهای دارد.
- هر سازمان حداکثر میتواند ۱۰۰ صدای ساختهشده با توصیف متنی داشته باشد. این محدودیت زمانی هم اعمال میشود که برنامه به نمایندگی از مشتریان خود صدا ایجاد کند.
- صداهای ساختهشده با توصیف متنی فقط با GPT-Live سازگارند. سرویس تبدیل متن به گفتار (Text to Speech)، API ریلتایم (Realtime API) و قابلیت تکمیل مکالمه همراه با صوت (Chat Completions with audio) از آنها پشتیبانی نمیکنند.
- ساخت صدا از طریق
/v1/audio/voicesبا قابلیت نگهداری صفر داده (Zero Data Retention) سازگار نیست. بااینحال، اگر این گزینه برای سازمان فعال باشد، گفتار تولیدشده توسط GPT-Live میتواند مشمول آن شود. - فقط ساخت صداهای بزرگسال مجاز است. بر اساس سیاستهای استفاده اوپنایآی، نمیتوان درخواست تقلید صدای یک فرد واقعی، شخصیت داستانی یا چهره عمومی را مطرح کرد.
- باید به شنوندگان اطلاع داده شود که گفتار با هوش مصنوعی تولید شده است. همچنین فرادادههای مربوط به منشأ محتوا یا واترمارکها باید حفظ شوند.
- منحصربهفرد بودن صدا تضمین نمیشود. اوپنایآی هشدار میدهد که مشتریان دیگر نیز ممکن است با توصیفی مشابه، صدایی نزدیک به صدای شما تولید کنند.
محدودیت ۱۰۰ صدا از مهمترین مواردی است که باید در طراحی محصول در نظر گرفته شود. سرویسی که برای هر مشتری صدای اختصاصی میسازد، پیش از رسیدن به مشتری شماره ۱۵۰ با اتمام سهمیه روبهرو میشود. در چنین شرایطی، باید یک صدا را میان چند مشتری به اشتراک گذاشت یا از صداهای ساختهشده بر اساس فایل ضبطشده استفاده کرد؛ گزینه دوم فقط برای مشتریان واجد شرایط در دسترس است و شامل همه نمیشود. ساخت صدا بر اساس ضبط صدای یک فرد واقعی موضوع جداگانهای است که پیشتر در گزارش شبیهسازی صدا با استفاده از سه ثانیه فایل صوتی بررسی شده بود.
پرسشهای متداول
۱. آیا ساخت صدا با توصیف متنی هزینه دارد؟
خیر، ساخت صدا رایگان است. هزینه مربوط به استفاده از صداست که بر اساس تعرفه معمول جلسات GPT-Live محاسبه میشود. شنیدن صدا در محیط Playground نیز یک جلسه محسوب میشود. اوپنایآی در ماه سپتامبر برای GPT-Live بهازای هر دقیقه ۰٫۰۵ دلار بابت لایه صوتی دریافت میکرد و هزینه مدل استدلالی جداگانه محاسبه میشد. جزئیات این تعرفه در مطلب معرفی GPT-Live در API آمده است.
۲. آیا میتوان در میانه مکالمه صدای دستیار را تغییر داد؟
خیر. صدا هنگام شروع جلسه انتخاب میشود. برای امتحانکردن صدای دیگر باید جلسه جدیدی باز کنید؛ بنابراین، آزمایش سه صدا مستلزم ایجاد سه جلسه جداگانه است.
۳. آیا صدای ساختهشده با توصیف متنی میتواند انگلیسی صحبت کند؟
این موضوع در مستندات مشخص نشده است. راهنما فهرستی از زبانهای پشتیبانیشده ارائه نمیکند و تنها نمونه آن به صدایی با لهجه انگلیسی آمریکایی مربوط است. در فهرست صداهای ازپیشآماده منتشرشده در ۱۶ اکتبر نیز صدای انگلیسی وجود ندارد. پیش از ساخت محصولی مبتنی بر این قابلیت، بهتر است آن را با چند عبارت انگلیسی آزمایش کنید؛ البته باید توجه داشت که هزینه جلسه برای این آزمایش محاسبه میشود.
۴. آیا به قرارداد یا تماس با واحد فروش نیاز است؟
برای ساخت صدا با توصیف متنی، خیر. این قابلیت برای همه مشتریان API در دسترس است و به ثبتنام جداگانه یا ارائه رضایتنامه نیاز ندارد. در مقابل، برای ساخت صدا از روی فایل ضبطشده باید با تیم فروش اوپنایآی تماس گرفت و این امکان فقط به مشتریان واجد شرایط ارائه میشود.
۵. نسخه GPT-Live-1.1 چه زمانی به API اضافه میشود؟
هنوز تاریخی اعلام نشده است. اوپنایآی در ۱۵ اکتبر عبارت «بهزودی» را به کار برد و در تاریخچه تغییرات ۱۶ اکتبر نیز اطلاعات تازهای در این زمینه منتشر نکرد. تا زمان عرضه این نسخه، توسعهدهندگان از مدل gpt-live-1 استفاده میکنند؛ همان مدلی که ۹ صدای جدید نیز به آن اضافه شده است.