
عرضه مدل Beam از سوی Reflection AI؛ دومین مدل متنباز برتر آمریکا در شاخص هوش Artificial Analysis
به نظر میرسد آمریکا در حال پیشرفت در حوزه مدلهای هوش مصنوعی با وزن باز است؛ حوزهای که تا همین اواخر تا حد زیادی تحت سلطه چین قرار داشت. گزارشهای پیشین نیز از پیشی گرفتن مدلهای چینی در این بخش حکایت داشتند.
شرکت Reflection AI، آزمایشگاه مستقر در نیویورک که دو پژوهشگر سابق Google DeepMind آن را تأسیس کردهاند، نخستین مدل خود را منتشر کرده است. این مدل از همان ابتدا در میان مدلهای دارای وزن بازِ توسعهیافته در آمریکا به جایگاهی نزدیک به صدر جدول رسیده است.
این مدل که Beam نام دارد، در ارزیابی Artificial Analysis امتیاز ۳۰ را در شاخص هوش این مؤسسه کسب کرده است. این شاخص ترکیبی از ۱۰ آزمون در حوزههایی مانند انجام وظایف عاملمحور، برنامهنویسی، علوم و دانش عمومی است. Beam در میان مدلهای دارای وزن بازِ شرکتهای آمریکایی، پس از مدل تازهمنتشرشده Muse Spark Open متعلق به Meta قرار دارد که امتیاز ۳۹ گرفته است. این مدل همچنین بالاتر از Nemotron 3.5 Super VL شرکت NVIDIA قرار میگیرد که تنها یک روز پیش از Beam معرفی شده و امتیاز ۲۶ را کسب کرده است. در سطح جهانی نیز، در میان مدلهایی که در چین توسعه نیافتهاند، فقط Muse Spark Open و مدل K2 Horizon متعلق به امارات متحده عربی، با امتیاز ۳۱، بالاتر از Beam قرار دارند.
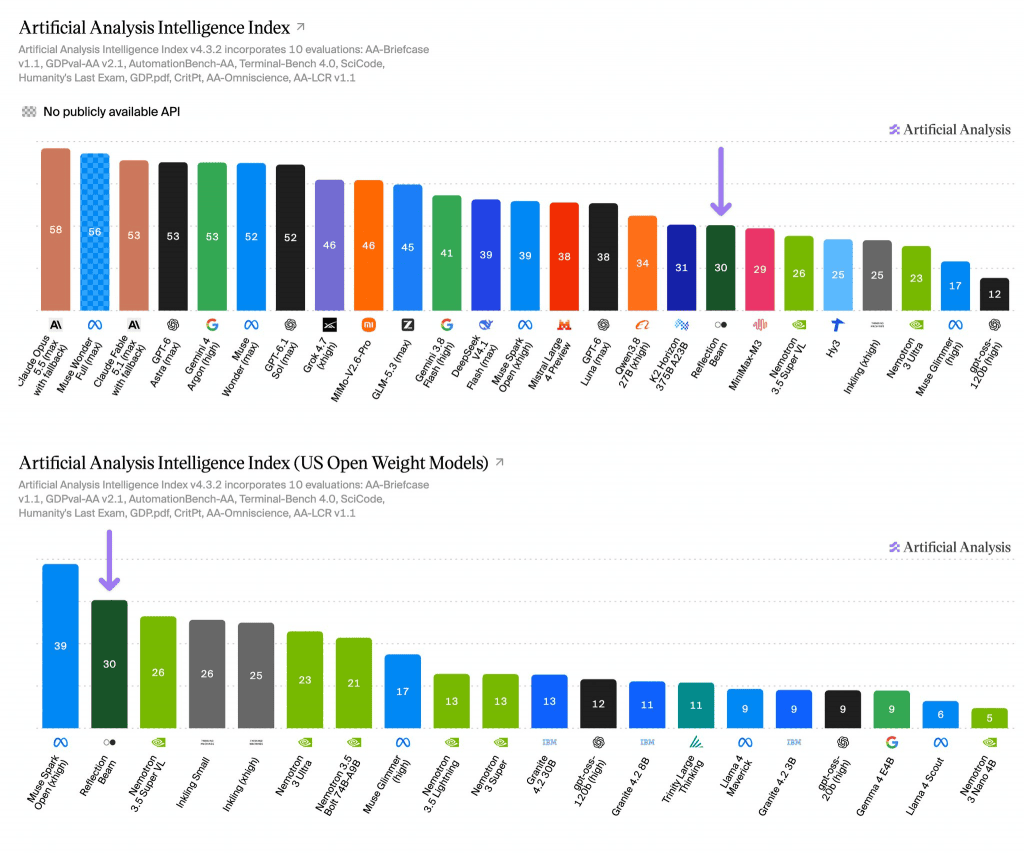
Beam یک مدل از نوع ترکیب متخصصان (Mixture of Experts) است که در مجموع ۵۰۱ میلیارد پارامتر دارد و در پردازش هر توکن، ۲۳ میلیارد پارامتر آن فعال میشود. این مدل با پنجره زمینه یکمیلیونتوکنی عرضه شده و تنها از ورودی و خروجی متنی پشتیبانی میکند. Beam از طریق پلتفرم Hugging Face در دسترس است و میتوان آن را با استفاده از ابزار خط فرمان متنباز خود Reflection، با نام Mirror، اجرا کرد.
بهرهوری بالا، اما همراه با محدودیت
یکی از ویژگیهای قابلتوجه Beam، توانایی آن در دستیابی به این سطح از عملکرد با مصرف محاسباتی نسبتاً کم است. طبق ارزیابی Artificial Analysis، این مدل برای هر وظیفه در شاخص هوش حدود ۲۶ هزار توکن خروجی تولید میکند؛ رقمی که کمتر از نصف مصرف K2 Horizon است. مدل اماراتی برای کسب تنها یک امتیاز بیشتر، حدود ۵۲ هزار توکن مصرف میکند. با این حال، مدلهای پیشرفته اختصاصی همچنان با بودجه محاسباتی مشابه عملکرد بسیار بهتری دارند. برای مثال، GPT-6 Astra شرکت OpenAI با مصرف حدود ۲۷ هزار توکن، امتیاز ۵۳ را کسب میکند. مصرف توکن این مدل تقریباً بهاندازه Beam است، اما امتیاز هوش آن نزدیک به دو برابر بیشتر است.
از حدود ۲۶ هزار توکنی که Beam برای هر وظیفه مصرف میکند، تقریباً ۱۹ هزار توکن صرف فرایند استدلال میشود و تنها حدود ۷ هزار توکن به پاسخ نهایی اختصاص مییابد. سهم پاسخ نهایی از کل توکنها حدود ۲۶ درصد است؛ نسبتی که در میان ۲۱۹ مدل ارزیابیشده در نسخه ۴.۳ شاخص هوش Artificial Analysis، از ۲۸ مدل کمتر است. این آمار نشان میدهد Beam در مقایسه با حجم پاسخی که ارائه میکند، زمان و توکن زیادی را صرف «فکر کردن» میکند.
نقاط قوت و ضعف Beam تا حد زیادی مشخصاند. این مدل در آزمونهای عاملمحور عملکرد خوبی دارد و در AutomationBench-AA امتیاز ۴۸٫۵ درصد را کسب کرده است؛ ۱۱ واحد درصد بالاتر از K2 Horizon و تقریباً همسطح Qwen3.8 27B شرکت Alibaba. Beam در آزمون CritPt که توانایی استدلال در فیزیک را میسنجد نیز برجسته ظاهر میشود. امتیاز ۱۳٫۱ درصدی آن بیش از دو برابر نتایج K2 Horizon و Qwen3.8 27B است. با این حال، عملکرد آن در محیط ترمینال ضعیف است. Beam در Terminal-Bench 4.0 تنها ۳ درصد امتیاز میگیرد؛ پایینتر از Qwen3.8 27B با امتیاز ۵٫۶ درصد و Muse Spark Open با امتیاز ۸٫۱ درصد. این نتیجه ضعیفترین عملکرد Beam در میان ۱۰ آزمون شاخص هوش است.
نتایج Beam در آزمون AA-Omniscience، که هم درستی پاسخها و هم اعتمادبهنفس بیش از حد مدل را میسنجد، تصویر مشابهی ارائه میکند: مدلی که اطلاعات بیشتری در اختیار دارد، اما همیشه نمیداند چه زمانی باید از حدس زدن دست بکشد. Beam به ۳۳ درصد پرسشها پاسخ درست میدهد؛ عملکردی بهمراتب بهتر از K2 Horizon با ۱۸ درصد و Qwen3.8 27B با ۱۶ درصد. با این حال، نرخ توهم آن نیز به ۴۷ درصد میرسد، درحالیکه این رقم برای K2 Horizon برابر با ۲۶ درصد و برای Qwen3.8 27B برابر با ۳۰ درصد است. با وجود این، شاخص خالص Artificial Analysis که دقت را در برابر توهم میسنجد، همچنان به نفع Beam است. امتیاز این مدل در این شاخص ۱٫۵ است، درحالیکه K2 Horizon امتیاز منفی ۳ و Qwen3.8 27B امتیاز منفی ۱۰ را به دست آوردهاند.
Beam در شاخص جدیدتر Cyber Index متعلق به Artificial Analysis نیز پیشتاز است. این شاخص با تمرکز بر امنیت، از سه ارزیابی تشکیل شده و Beam در آن امتیاز ۳۴ درصد را کسب کرده است؛ نتیجهای بهتر از هر مدل دارای وزن بازِ آمریکایی دیگری که تاکنون در این آزمون بررسی شده است. در نموداری که امتیاز Cyber Index را در برابر تعداد توکنهای خروجی مصرفشده برای هر وظیفه قرار میدهد، Beam در کنار GPT-6 Sol (Daybreak Blue) شرکت OpenAI در مرز بهرهوری قرار میگیرد؛ یعنی با مصرف توکن بسیار کمتر از بیشتر مدلهای دیگر، به امتیازی مشابه یا بهتر دست مییابد.
در حوزه برنامهنویسی، Beam هنگام اجرا در محیط Mirror در شاخص Coding Agent Index متعلق به Artificial Analysis امتیاز ۲۸ را کسب میکند. این نتیجه ۱۵ امتیاز کمتر از بهترین ترکیب بعدی است؛ یعنی Claude Code در کنار Qwen3.8 Max که امتیاز ۴۳ را به دست آورده است. فاصله Beam با مدلهای پیشتاز این شاخص نیز به ۴۰ امتیاز میرسد. این مدل در این حوزه هم کممصرف است و تنها دو ترکیب دیگر از عامل برنامهنویسی و محیط اجرایی آنها، برای هر وظیفه توکن کمتری مصرف میکنند.
چه کسانی Reflection AI را تأسیس کردند؟
شرکت Reflection AI در مارس ۲۰۲۴ به دست میشا لاسکین و یوانیس آنتونوگلو، دو پژوهشگری که Google DeepMind را برای راهاندازی این شرکت ترک کردند، تأسیس شد. لاسکین که در رشته فیزیک نظری تحصیل کرده و دانشآموخته دانشگاه ییل و دانشگاه شیکاگو است، پیش از همبنیانگذاری Reflection، هدایت بخش مدلسازی پاداش را در پروژه Gemini شرکت DeepMind بر عهده داشت. او اکنون مدیرعامل Reflection است. آنتونوگلو، مدیر ارشد فناوری شرکت، از سازندگان سامانه AlphaGo بود؛ سامانهای که در سال ۲۰۱۶ قهرمان جهان در بازی گو را شکست داد. او همچنین در توسعه سامانههای پسآموزش برای Gemini مشارکت داشت.
Reflection در مارس سال گذشته از حالت فعالیت محرمانه خارج شد و اعلام کرد در دورهای تأمین مالی اولیه و سری A، مجموعاً ۱۳۰ میلیون دلار سرمایه جذب کرده است. Sequoia Capital، Lightspeed Venture Partners، CRV و بازوی سرمایهگذاری خطرپذیر NVIDIA از سرمایهگذاران این دورها بودند. ارزشگذاری شرکت در آن زمان حدود ۵۵۵ میلیون دلار بود. هدف اولیه Reflection محدودتر از چشماندازی بود که امروز با Beam دنبال میکند: توسعه عاملهای برنامهنویسی خودمختار که بتوانند با حداقل دخالت انسان، کد را بخوانند، بنویسند، آزمایش کنند و به مرحله اجرا برسانند.
این مسیر در اکتبر ۲۰۲۵ بهطور چشمگیری تغییر کرد؛ زمانی که Reflection یک دور تأمین مالی ۲ میلیارد دلاری را به رهبری NVIDIA نهایی کرد. اریک اشمیت، شرکت Citi و صندوق 1789 Capital که دونالد ترامپ جونیور از حامیان آن است، از جمله مشارکتکنندگان این دور بودند. این سرمایهگذاری ارزش شرکت را به ۸ میلیارد دلار رساند؛ افزایشی حدوداً ۱۵ برابری در هفت ماه. همزمان، مأموریت شرکت نیز بازتعریف شد: ساخت مدلهای پیشرفته با وزن باز بهعنوان جایگزینی آمریکایی و شفاف برای آزمایشگاههای دارای مدلهای بسته، مانند OpenAI و Anthropic، و نیز تلاشهای چینی در حوزه مدلهای دارای وزن باز، از جمله DeepSeek و Qwen. لاسکین این مقطع را «لحظه اسپوتنیک» برای هوش مصنوعی باز توصیف کرده و استدلال کرده است که اگر آمریکا در توسعه مدلهای باز پیشتاز نشود، این عرصه بهطور پیشفرض به آزمایشگاههای چینی واگذار خواهد شد.
Beam نخستین مدل زبانی حاصل از این راهبرد تازه است و نتایج اولیه نشان میدهد که شروعی قابلاعتنا برای شرکت به شمار میرود. این مدل هنوز بهترین مدل دارای وزن بازِ آمریکا نیست، اما در نخستین عرضه خود به جایگاهی نزدیکتر به صدر این فهرست رسیده است؛ دستاوردی که بسیاری از مدلهای تازهوارد بهسادگی به آن دست پیدا نمیکنند.