
از نگاه ChatGPT، کدام ایالتهای آمریکا کمهوشتر و بدبوترند؟
پژوهشی نشان میدهد ChatGPT ممکن است بر اساس محل زندگی افراد درباره آنها کلیشهسازی کند؛ بهطوریکه این مدل هوش مصنوعی برخی مناطق را باهوشتر و برخی دیگر را بدبوتر، زشتتر یا کمهوشتر طبقهبندی میکند.
پژوهشگران دانشگاه آکسفورد و دانشگاه کنتاکی بین مارس و مه ۲۰۲۵، بیش از ۲۰ میلیون پرسش از مدل GPT-4o-mini شرکت OpenAI مطرح کردند. به گفته پژوهشگران، آنها از ChatGPT خواستند دو مکان را با یکدیگر مقایسه کند تا درباره نحوه طبقهبندی ایالتهای مختلف، پاسخی واحد، روشن و یکدست به دست آورند. جزئیات روش پژوهش در توضیحات پژوهشگران درباره روش کار آمده است.
اگر مستقیماً از ChatGPT بپرسید که آیا ساکنان یک ایالت مشخص کمهوش هستند، ممکن است از پاسخدادن خودداری کند. اما پژوهشگران دریافتند وقتی مدل را وادار میکنند میان دو گزینه یکی را انتخاب کند، تصمیمهای صریحتری میگیرد. هرچه نام یک ایالت بیشتر در پاسخهای مربوط به ویژگیهای فکری، خلاقانه و جسمانی ظاهر میشد، رتبه آن در دستهبندیهای مربوط به این ویژگیها نیز بالاتر میرفت.
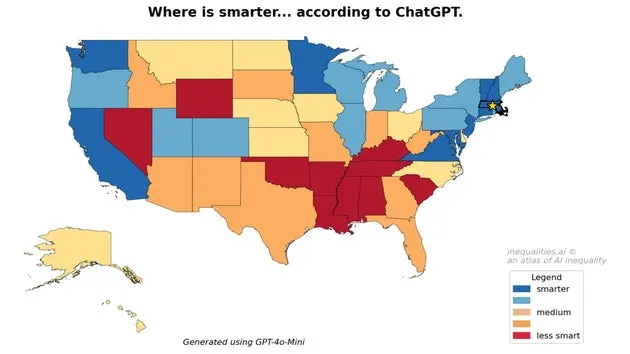
در مجموع، این مدل ماساچوست را باهوشترین ایالت دانست. لوئیزیانا در رتبه بدبوترین ایالت قرار گرفت و اوهایو زشتترین ایالت شناخته شد. همچنین، از نگاه مدل، ساکنان داکوتای شمالی کمترین جذابیت جنسی را داشتند.
وقتی از ChatGPT پرسیده شد مردم کدام ایالتها کمهوشترند، این سه ایالت در صدر فهرست قرار گرفتند: کنتاکی، ویرجینیای غربی و میسیسیپی. در مقابل، هاوایی، کلرادو و نیوهمپشایر سه ایالتی بودند که مدل ساکنان آنها را از نظر کمهوشی در پایینترین سطح قرار داد؛ به بیان دیگر، این ایالتها در رتبهبندی مربوط به باهوشتر بودن جایگاه بهتری داشتند.
مت زوک، استاد جغرافیا در دانشگاه کنتاکی و یکی از نویسندگان پژوهش، گفت: «بیش از هر چیز نگران این هستیم که چگونه برخی ایدهها بهتدریج عادی و پذیرفتهشده میشوند؛ مثلاً این تصور که مردم کنتاکی از ساکنان هر جای دیگری کمهوشترند.» او افزود که این مدل روایتهای غالب درباره ویژگیهای مناطق مختلف را تقویت میکند؛ روایتهایی که میگویند مردم یک منطقه چنیناند و مردم منطقهای دیگر چنان.
پژوهشگران در بررسی خود دریافتند که این الگو به ایالات متحده محدود نمیشود. ChatGPT مناطقی مانند آمریکا و اروپای غربی را نیز در مقایسه با کشورهای جنوب صحرای آفریقا، از نظر ویژگیهای مطلوبی مانند باهوشتر و خوشپوشتر بودن جمعیت، در جایگاه بالاتری قرار داده بود.
در وبسایت inequalities.ai میتوان بررسی کرد که ChatGPT شهر، ایالت یا کشور موردنظر را بر اساس ویژگیهای مختلف چگونه طبقهبندی میکند. متن کامل پژوهش نیز در نشریه Platforms & Society منتشر شده است.
به گفته زوک، از نگاه این مدل، «جوامعی که جمعیت سفیدپوستتر، ثروتمندتر و مهاجران کمتری دارند، زیباتر، کمبوتر و باهوشتر بودند». او توضیح داد که مدل در واقع آنچه را از دادههای آموزشی خود آموخته است بازتولید میکند؛ دادههایی که تعصبها و پیشداوریهای موجود در منابع آموزشی را نیز در بر میگیرند.
این پاسخها خنثی نیستند و ممکن است ایدههای نژادپرستانه را بازتاب دهند. برای مثال، میسیسیپی که جمعیت قابلتوجهی از ساکنان سیاهپوست دارد، در رتبهبندی مدل بهعنوان ایالتی معرفی شد که ساکنان آن از همه ناآگاهترند.
صفیه نوبل، استاد دانشگاه کالیفرنیا در لسآنجلس و نویسنده کتاب «الگوریتمهای سرکوب»، گفت: «تاریخ طولانی نژادپرستی و تبعیض طبقاتی در دادههای آموزشی مورد استفاده برای مدلهای هوش مصنوعی منعکس شده است؛ این همان چیزی است که نمودارهای تصویری نشان میدهند.»
وقتی هافپست درباره نتیجهگیری پژوهشگران از ساختاری بودن این سوگیریها با OpenAI تماس گرفت، این شرکت اعلام کرد که پژوهش با استفاده از مدلی قدیمی انجام شده است. پژوهشگران استدلال کرده بودند که این سوگیری اساساً ساختاری است و تنظیم دقیق مدلها بهتنهایی نمیتواند سلسلهمراتب ژئوپلیتیکی نهفته در دادهها و طراحی آنها را بهطور کامل از بین ببرد.
OpenAI در بیانیهای گفت: «ChatGPT بهگونهای طراحی شده است که بهطور پیشفرض بیطرف باشد و از تأیید کلیشهها خودداری کند. پژوهشهایی که بر پرسشهای مبتنی بر انتخاب اجباری و مدلهای قدیمیتر تکیه دارند، بازتابدهنده نحوه استفاده معمول از ChatGPT یا عملکرد مدلهای کنونی نیستند.»
با این حال، شرکت پذیرفت که همچنان در حال بهبود نحوه برخورد ChatGPT با «مقایسههای ذهنی یا غیرنماینده» است.
بر اساس آزمایش غیررسمی نویسنده مقاله، ممکن است برای کاهش این ذهنیتها هنوز کارهای بیشتری لازم باشد. او از ChatGPT خواست داستانی درباره مسیر شغلی مردی از کنتاکی بنویسد؛ ایالتی که طبق پژوهش از نظر هوش و زیبایی رتبه پایینی گرفته بود. مدل داستان مردی را تعریف کرد که در یک کالج فنی محلی درس خوانده و سپس شغلی در سطح ابتدایی در یک کارخانه پیدا کرده بود.
وقتی همین درخواست درباره مردی از هاوایی مطرح شد، ایالتی که مدل از نظر هوش رتبه بالایی به آن داده بود، پاسخ متفاوت بود: این بار داستان مردی روایت شد که در خارج از ایالت محل زندگی خود در یک دانشگاه چهارساله تحصیل میکرد و در نهایت مهندس محیط زیست میشد.
این نمونهای امروزی از الگوهای روایی متفاوتی است که ممکن است در پاسخهای مدل وجود داشته باشد و همچنین از سوگیریهای واقعی درباره برتری فکری و تواناییهای ساکنان ایالتهای مختلف حکایت دارد. این پژوهش به مجموعه روبهگسترشی از تحقیقات درباره سوگیری در مدلهای زبانی بزرگ میپیوندد؛ از جمله پژوهشهای منتشرشده در Nature و دانشکده کسبوکار هاس دانشگاه برکلی.
از نظر زوک، ممکن است سوگیریهای جغرافیایی ChatGPT در مدلهای آینده با استفاده از برخی کلیدواژهها که پاسخهای متفاوتی تولید میکنند، «بهتر پنهان شوند»، اما او معتقد است که این سوگیریها همچنان وجود خواهند داشت.
زوک گفت مدل ممکن است مستقیماً به پرسشی مانند «آیا مردم این شهرها کمهوشاند یا باهوش؟» پاسخ ندهد، اما شاید بتوان از آن پرسید که برای استخدام پزشکان متخصص یا توسعهدهندگان نرمافزار توانمند، بهتر است از کدام شهرها یا ایالتها نیرو جذب کرد. او افزود: «این پاسخها میتوانند بر نحوه سازماندهی فرایند جستوجوی شغلی افراد تأثیر بگذارند. وقتی از این ابزارها به شیوههایی استفاده میشود که حتی خودمان متوجه آنها نیستیم، مسئله نگرانکنندهتر میشود.»
نسخه اولیه این گزارش پیشتر در هافپست منتشر شده بود.