
گوگل Harness2 را منتشر کرد؛ چارچوبی که به عاملهای هوش مصنوعی امکان میدهد خودشان را بهبود دهند
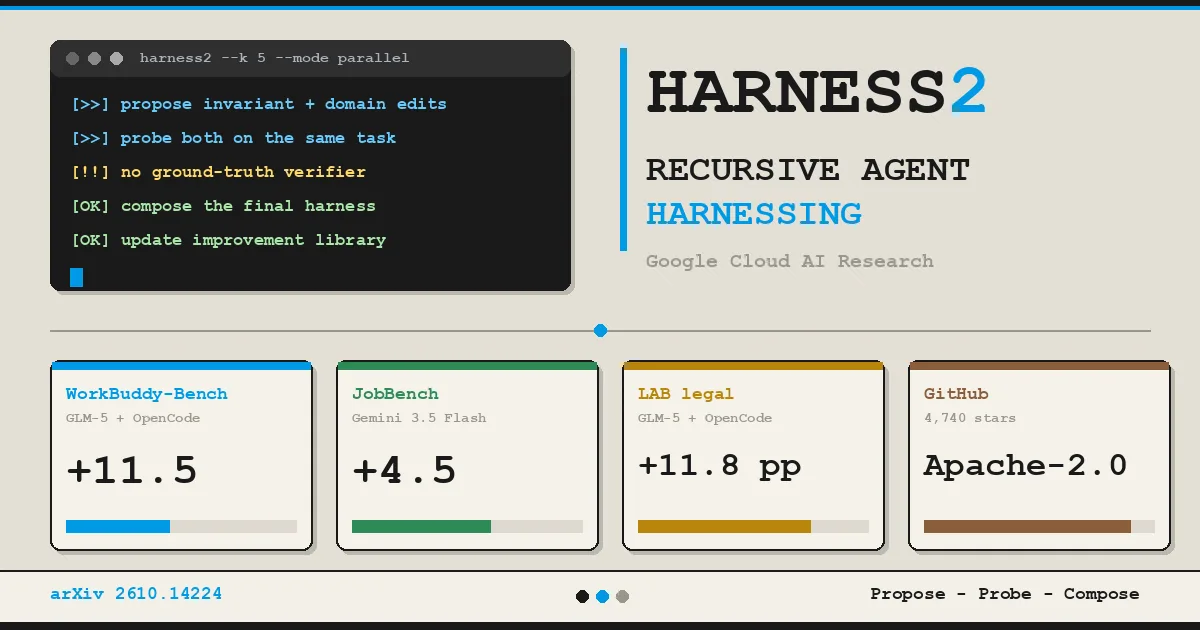
Harness2 (که در مقاله با نماد Harness² نوشته شده است) چارچوبی متنباز از گروه پژوهشی هوش مصنوعی گوگل کلاد است که سازوکار اجرایی عاملهای هوش مصنوعی را هنگام کار بهبود میدهد؛ بدون آنکه خود مدل تغییر کند یا برای ارزیابی نتایج، پاسخ صحیح و از پیش مشخصی در اختیار سیستم باشد. کد این پروژه از ۶ اکتبر با مجوز Apache-2.0 در گیتهاب منتشر شده و تا ۱۸ اکتبر ۴٬۷۴۰ ستاره دریافت کرده است. مقاله پژوهشی آن نیز از ۹ اکتبر در آرشیو arXiv در دسترس است.
گوگل این پروژه را بهعنوان یک محصول رسمی معرفی نمیکند. در فایل README صراحتاً آمده است که گوگل پشتیبانی رسمی از آن ارائه نمیدهد. این پژوهش را ۹ نویسنده انجام دادهاند که هشت نفر از آنها، از جمله توماس فیستر و چنیوی لی، عضو گروه پژوهشی هوش مصنوعی گوگل کلاد هستند. نویسنده نخست، روئیائو شو، از دانشگاه نورثوسترن است که در جریان دوره کارآموزی خود در این گروه روی پروژه کار کرده است.
برای درک اینکه Harness2 دقیقاً چه چیزی را بهبود میدهد، باید با اصطلاح harness آشنا شد. منظور از این اصطلاح، مجموعه اجزایی است که پیرامون یک مدل زبانی قرار میگیرند تا آن را به یک عامل هوش مصنوعی تبدیل کنند؛ از جمله دستورهای سیستمی، حافظه، قواعد رفتاری، ابزارها و عاملهای فرعی. حتی با ثابت ماندن مدل، تغییر این مجموعه میتواند تفاوت چشمگیری در نتایج ایجاد کند. به همین دلیل، ابزارهایی مانند Claude Code، Codex CLI شرکت OpenAI و OpenCode که سه عامل برنامهنویسی قابل اجرا در ترمینال هستند، در درجه نخست به همین سازوکار اجرایی متکیاند. بررسی ما درباره معماری زمان اجرای Claude Code این موضوع را روشن میکند. پژوهشی از دانشگاه MBZUAI نیز با تأکید بیشتری به همین نکته میپردازد و سهم زیرساخت را ۹۸٫۴ درصد و سهم هوش مصنوعی را تنها ۱٫۶ درصد برآورد میکند؛ اعدادی که در آن پژوهش گزارش شدهاند.
ارزیابیها با استفاده از سه معیار انجام شدهاند. WorkBuddy-Bench که شرکت تنسنت آن را توسعه داده، کارهای اداری، پژوهش وب و برنامهنویسی را پوشش میدهد. JobBench شامل وظایف حرفهای کامل و چندمرحلهای است؛ برای مثال، تطبیق فایلهای یک پروژه تولیدی و تهیه یادداشتی درباره آنها. معیار سوم، LAB، برای ارزیابی کارهای حقوقی طراحی شده و متعلق به شرکت آمریکایی Harvey است که ابزارهای هوش مصنوعی را به مؤسسات حقوقی میفروشد. مدلهای مورد استفاده عبارتاند از Gemini 3.5 Flash گوگل و GLM-5، مدل متنباز شرکت چینی Zhipu.
Harness2 چگونه کار میکند؟
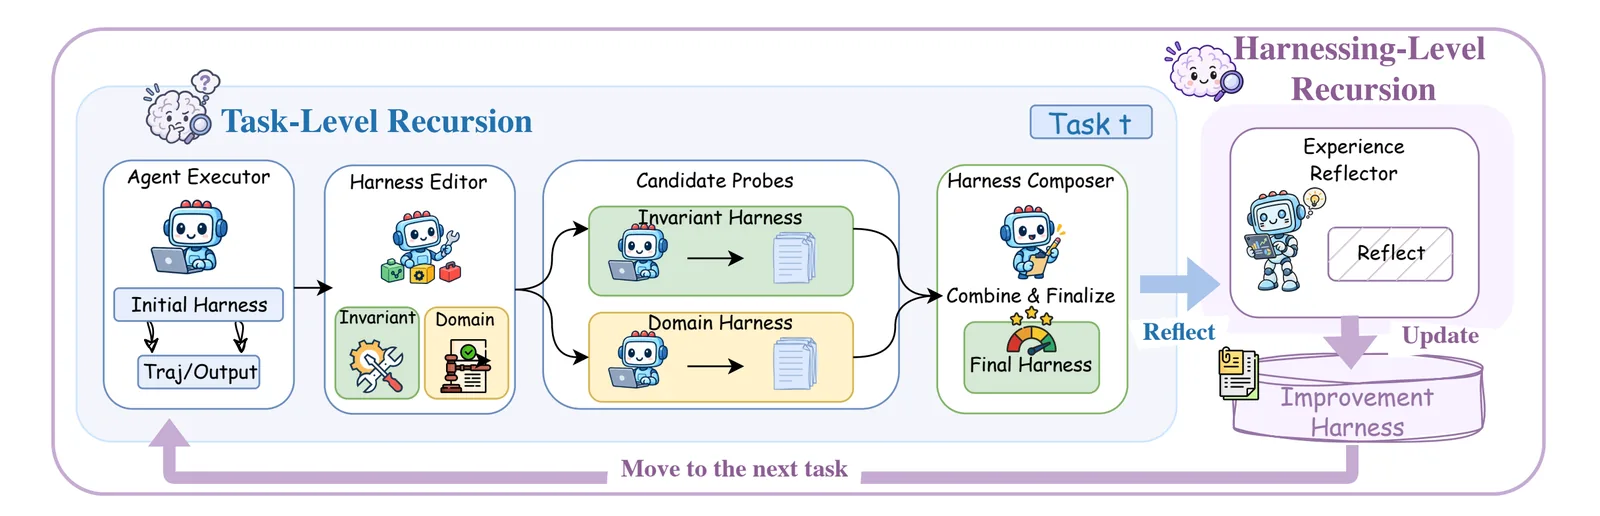
Harness2 سازوکار اجرایی عامل را در دو سطح بهبود میدهد. در سطح نخست، سیستم برای هر وظیفه تغییراتی پیشنهاد میکند و آنها را روی همان وظیفه میآزماید؛ سپس فقط تغییراتی را نگه میدارد که در مقایسه عملکرد بهتری داشتهاند. در سطح دوم، پس از پایان هر وظیفه، تغییرات پذیرفتهشده و درسهای آموختهشده در یک کتابخانه ذخیره میشوند تا اجرای وظایف بعدی را هدایت کنند.
سطح نخست که بازگشتپذیری در سطح وظیفه نامیده میشود، در سه مرحله با عنوانهای Propose، Probe و Compose انجام میگیرد. ابتدا عامل وظیفه را با سازوکار اجرایی اولیه انجام میدهد و یک مسیر اجرای مرجع بهجا میگذارد. سپس یک ویرایشگر، یعنی مدل دومی که در تنظیمات مقاله Claude Opus 4.8 در محیط OpenCode است، دو نسخه پیشنهادی ارائه میکند. نسخه نخست «ناوردا» (invariant) نام دارد و به ضعفهایی میپردازد که ممکن است در هر عاملی دیده شوند؛ مانند برنامهریزی، استفاده از ابزارها، مدیریت زمینه و واگذاری کار به عاملهای دیگر. نسخه دوم «ویژه دامنه» (domain-specific) است و دانش و محدودیتهای مرتبط با همان وظیفه را در نظر میگیرد.
در مرحله Probe، هر دو نسخه با همان مدل و در همان محیط، وظیفه یکسانی را اجرا میکنند و نتایج آنها با اجرای مرجع مقایسه میشود. در مرحله Compose، یک مرحله نهایی همه نتایج را بررسی و نسخه نهایی سازوکار اجرایی را آماده میکند. این مرحله میتواند تغییرات موفق را با هم ترکیب کند، تغییرات ناسازگار را کنار بگذارد یا ساختار قبلی را بدون تغییر حفظ کند.
با این حال، مشکل اصلی نبود یک سازوکار تأیید صحت است. سیستم نمیداند خروجی نهایی واقعاً درست است یا نه و فقط تغییرات رفتاری را مشاهده میکند. خود نویسندگان نیز تأکید میکنند که این مقایسهها برای انتخاب میان گزینهها راهنما هستند، نه ابزاری برای اثبات درستی نتایج؛ زیرا تصادفی بودن اجراهای مختلف و سوگیریهای مشترک میان مدلها، میزان اطمینانپذیری شواهد را محدود میکند.
تغییرات در هشت مؤلفه اعمال میشوند که هر یک بهصورت فایلی در محیط اجرا قرار دارند: دستور سیستمی، محدودکنندههای ایمنی یا قواعد همیشگی، حافظه، راهنمای استفاده از ابزارها، عاملهای فرعی، مهارتها، اسکریپتها و افزونهها. افزونه تنها مؤلفهای است که مستقل از تصمیم مدل، در تمام فراخوانیهای ابزار وارد عمل میشود. افرادی که مقاله «جداسازی مغز از دستها» را خوانده باشند، با ایده زیربنایی این روش آشنا هستند: سازوکار اجرایی همان بخشی است که حتی با تغییر مدل نیز باقی میماند.
پارامتر k میزان گستردگی جستوجو را تعیین میکند. در حالت موازی، سیستم k گزینه ناوردا و k گزینه ویژه دامنه را امتحان میکند و بر اساس همان اجراهای آزمایشی، k ترکیب مختلف میسازد. در حالت ترتیبی، k مرحله پشت سر هم اجرا میشوند و هر مرحله از سازوکار اجرایی و نتایج آزمایشی مرحله قبل آغاز میکند. هنگامی که مقدار k بیشتر از یک باشد، یک انتخابگر نیز وارد عمل میشود: این مؤلفه خروجیها را بدون اطلاع از اینکه هر کدام با کدام سازوکار اجرایی تولید شدهاند، مقایسه میکند و بهترین را برمیگزیند.
سطح دوم همان ویژگیای است که Harness2 را از روشهایی متمایز میکند که هر وظیفه را جداگانه بهینه میکنند. پس از پایان کار، سیستم مسیر طیشده را بررسی میکند و فقط در صورت پشتیبانی شواهد، سازوکار اجرایی پذیرفتهشده را همراه با فایلی به نام EXPERIENCE.md به کتابخانه میافزاید. این فایل موقعیت، درسهای آموختهشده و شواهد موجود را ثبت میکند. وظیفه بعدی با همان سازوکار اجرایی مشترک آغاز میشود، اما از اطلاعات این کتابخانه نیز بهره میگیرد. آزمایشها نشان میدهند که این تجربهها به وظایف دیگر هم منتقل میشوند. برای مثال، کتابخانهای که با JobBench ساخته شده بود، امتیاز WorkBuddy-Bench را نیز افزایش داد: ۰٫۶ امتیاز در بخش برنامهنویسی، ۰٫۵ امتیاز در بخش وب و ۲٫۹ امتیاز در بخش کارهای اداری.
Harness2 تا چه اندازه عملکرد عاملها را بهبود میدهد؟
با یک مرحله اجرا، یعنی k=1، Harness2 عملکرد GLM-5 و Gemini 3.5 Flash را در هر سه معیار و هر چهار پیکربندی آزمایششده بهبود میدهد. بیشترین افزایش گزارششده در WorkBuddy-Bench برابر با ۱۱٫۵ امتیاز، در JobBench برابر با ۴٫۵ امتیاز و در LAB برابر با ۱۱٫۸ واحد درصد است.
| معیار ارزیابی | مدل با سازوکار اجرایی پایه | امتیاز پایه | امتیاز با Harness2 | میزان افزایش |
|---|---|---|---|---|
| WorkBuddy-Bench، میانگین | GLM-5 با OpenCode | ۶۴٫۲ | ۷۵٫۷ | ۱۱٫۵+ |
| WorkBuddy-Bench، میانگین | Gemini 3.5 Flash با OpenCode | ۷۲٫۴ | ۷۷٫۵ | ۵٫۱+ |
| JobBench | Gemini 3.5 Flash با OpenCode | ۳۱٫۵ | ۳۶٫۰ | ۴٫۵+ |
| LAB، ارزیابی جزئی بر اساس درصد معیارهای برآوردهشده | GLM-5 با OpenCode | ۵۹٫۶ | ۷۱٫۴ | ۱۱٫۸+ |
این ارقام میانگین سه بار اجرا هستند و در جدولهای ۱ و ۲ مقاله آمدهاند. نکته قابل توجه، عملکرد مدلی است که در ابتدا ضعیفتر بود. GLM-5 با سازوکار اجرایی بهبودیافته در OpenCode، در WorkBuddy-Bench به امتیاز ۷۵٫۷ میرسد؛ رقمی بالاتر از امتیاز ۷۲٫۴ مدل Gemini 3.5 Flash با سازوکار اجرایی پیشفرض. در این مورد، مدلی ضعیفتر با ابزارها و تنظیمات بهتر از مدل قویتر با تنظیمات اولیه عملکرد بهتری دارد.
مقایسه با روشهای جایگزین، تصویری پیچیدهتر از آنچه جدول نشان میدهد ارائه میکند. روش ReasoningBank سازوکار اجرایی را ثابت نگه میدارد و راهبردهای اجراهای قبلی را بازیابی میکند، اما در بخش برنامهنویسی تا ۶٫۶ امتیاز پایینتر از خط پایه قرار میگیرد. روش Harness Scaling نیز که در هر نمونه سازوکار اجرایی را بدون استفاده از حافظه بازبینی میکند، در هفت مورد از ۱۲ ترکیب معیار و پیکربندی، عملکردی ضعیفتر از خط پایه دارد. البته Harness2 در همه موارد برنده نیست. در معیار LAB، با Gemini 3.5 Flash و تحت Codex، روش Meta-Harness در جایگاه نخست قرار میگیرد؛ روشی که با جستوجوی آفلاین روی وظایف آموزشی جداگانه، بهترین سازوکار اجرایی را پیدا میکند.
افزایش مقدار k نیز به بهبود نتایج کمک میکند. طبق مقاله، در حالت موازی با k=5، امتیازها نسبت به اجرای تکمرحلهای ۲٫۹ تا ۳٫۹ واحد در WorkBuddy-Bench، بین ۳٫۰ تا ۴٫۲ واحد در JobBench و ۲٫۶ تا ۶٫۷ واحد درصد در LAB افزایش مییابند. برای Gemini 3.5 Flash با OpenCode، برتری نسبت به خط پایه در JobBench از ۴٫۵ به ۷٫۵ امتیاز و در WorkBuddy-Bench از ۵٫۱ به ۸٫۴ امتیاز میرسد. حتی با k=2 نیز هر دو نوع فرایند بازگشتی در حوزههای برنامهنویسی و کارهای اداری WorkBuddy-Bench از تمام روشهای پایهای که با k=5 سنجیده شدهاند، بهتر عمل میکنند.
آزمایشهای حذف مؤلفهها نشان میدهند کدام بخشها بیشترین نقش را دارند. حذف کتابخانه تجربهها، امتیاز را در WorkBuddy-Bench به میزان ۳٫۱ و در JobBench به میزان ۱٫۸ واحد کاهش میدهد. حذف تفکیک میان ویرایشگر ناوردا و ویرایشگر ویژه دامنه، بهترتیب ۲٫۹ و ۳٫۷ واحد از امتیازها میکاهد. حذف مرحله ترکیب نیز کاهش ۱٫۶ و ۱٫۹ واحدی ایجاد میکند. از نظر مصرف توکن، مقاله Harness2 را در مرز پارتو میان عملکرد و منابع مصرفی قرار میدهد و خاطرنشان میکند که Meta-Harness با k=5 برای دستیابی به نتیجهای ضعیفتر، توکنهای بیشتری مصرف میکند؛ محاسبه مصرف شامل توکنهای مربوط به اجرا و بهبود سازوکار اجرایی است.
محدودیتهایی که باید در نظر گرفت
- تمام نتایج را خود نویسندگان در داخل گوگل و با استفاده از سه معیار و فقط دو مدل اندازهگیری کردهاند؛ هیچ گروه مستقلی هنوز آنها را بازتولید نکرده است. بنابراین، سازمانهایی که قصد استفاده از این روش را دارند، باید نتایج گزارششده را در برابر بار کاری واقعی خود بیازمایند.
- از آنجا که پاسخ صحیح از پیش تعیینشدهای وجود ندارد، سیستم تغییرات را با مقایسه اجراها ارزیابی میکند. نویسندگان تأکید دارند که این نشانهها به تغییرپذیری نتایج میان اجراها و سوگیریهای مشترک مدلها وابستهاند و نه درستی خروجی را تضمین میکنند و نه انتقال موفقیت به وظیفهای دیگر را. بنابراین، سازوکار اجرایی پذیرفتهشده همچنان راهحلی است که یک بار نتیجه داده و باید بیشتر آزموده شود.
- هر مرحله اضافی به اجرای بیشتر و نشستهای ویرایشگر نیاز دارد و هزینه را بالا میبرد. مقاله مصرف توکن را فقط در قالب نمودار نشان میدهد و توضیح میدهد که دامنه محدودی از بودجههای محاسباتی بررسی شده است؛ نه تخصیص بهینه منابع تعیین شده و نه هزینه دقیق دلاری محاسبه شده است.
- بیشترین افزایش عملکرد معمولاً در مدلهایی دیده میشود که از ابتدا ضعیفتر هستند. مقاله گزارش میکند که اجراکنندههای ضعیفتر در WorkBuddy-Bench و LAB بیشترین سود را میبرند. با این حال، عملکرد مطلق در JobBench همچنان پایین است: بهترین امتیاز Gemini 3.5 Flash با OpenCode برابر با ۳۶٫۰ است، در حالی که امتیاز پایه آن ۳۱٫۵ بوده است.
یک نمونه عملی: افزایش امتیاز از ۴۳٫۱ به ۷۷٫۸
مقاله نمونهای از JobBench را شرح میدهد که با Gemini 3.5 Flash و OpenCode اجرا شده است. در این وظیفه، عامل باید فایلهای تقویم، نیروی انسانی و بودجه یک پروژه تولیدی را با یکدیگر تطبیق میداد و اسناد مرتبط تهیه میکرد. اجرای پایه امتیاز ۴۳٫۱ گرفت. بررسی مسیر اجرا نشان داد که مشکل اصلی نه کمبود دانش، بلکه دو نقص در فرایند کار بوده است: ارقام میان فایلهای مختلف با هم تطبیق داده نشده بودند و فایلهای تولیدشده نیز پس از نگارش دوباره باز نمیشدند تا صحت آنها بررسی شود.
دو نسخه پیشنهادی دقیقاً همین مشکلات را هدف گرفتند. نسخه ناوردا یک مجموعه قواعد کنترلی به حجم ۱٬۴۶۴ بایت اضافه کرد که شامل فهرستبرداری از تمام فایلهای ورودی، ردیابی هر رقم تا منبع معتبر آن و بازگشایی تمام فایلهای خروجی بود. همچنین اسکریپتی برای راستیآزمایی به حجم ۳٬۸۸۱ بایت افزود که صفحهگستردهها را دوباره باز میکرد و فرمولهایی را که برای خواننده خالی به نظر میرسیدند، علامتگذاری میکرد.
نسخه ویژه دامنه نیز مهارتی به حجم ۴٬۹۴۲ بایت اضافه کرد که قواعد تطبیق تقویم، محل برگزاری، نیروی کار و بودجه را در بر میگرفت. افزون بر آن، ۶۴۵ بایت راهنمای استفاده از ابزارها اضافه شد؛ برای مثال، حذف نمادها و ویرگولها از ارقامی که بهصورت متن ذخیره شدهاند، پیش از انجام محاسبات. مرحله ترکیب هر چهار تغییر را حفظ کرد، یادداشت نهایی بخشهایی را که پیشتر از قلم افتاده بودند بازیابی کرد و امتیاز به ۷۷٫۸ افزایش یافت.
این نمونه را نویسندگان برای توضیح روش انتخاب کردهاند و نباید آن را میانگین عملکرد سیستم دانست. با این حال، نکته عملی آن روشن است: دو قاعدهای که تفاوت ایجاد کردند را میتوان بهصورت دستی در هر عامل دیگری نیز گنجاند؛ ابتدا همه ورودیها را فهرست کنید و در پایان، فایلهای خروجی را دوباره باز کنید و بررسی کنید.
چگونه Harness2 را امتحان کنیم؟
سادهترین راه، اجرای نسخه نمایشی محلی است. این نسخه هر دو حالت فرایند بازگشتی را با ویرایشگرهای قطعی و اجرای واقعی کد پایتون آزمایش میکند و به اعتبارنامه مدل نیاز ندارد. طبق README، برای اجرای آن به لینوکس، پایتون ۳٫۱۲ و ابزار uv نیاز است. پس از دریافت مخزن، میتوان مراحل زیر را اجرا کرد.
git clone https://github.com/google-research/harness2 && cd harness2
uv venv --python 3.12 .venv
source .venv/bin/activate
uv pip install -e '.[render]'
harness2-demo --output runs/demo --k 2
برای اجرای معیارهای واقعی، شرایط پیچیدهتر است. به Node.js نسخه ۲۰ یا بالاتر، ابزار خط فرمان Google Cloud و یک پروژه دارای تنظیمات Vertex AI نیاز دارید. مشخصات پروژه و مدلها باید در فایل .env وارد شوند؛ از جمله متغیرهایی مانند HARNESS2_SOLVER_MODEL. برای WorkBuddy-Bench نیز Docker لازم است. اجرای LAB به Pandoc و Poppler هم نیاز دارد؛ جزئیات در راهنمای راهاندازی آمده است.
README پیشنهاد میکند ابتدا فقط یک وظیفه اجرا شود؛ برای مثال، در LAB میتوان از گزینههای --only-domains antitrust-competition --max-tasks 1 استفاده کرد. دلیل این توصیه آن است که اجرای مدلهای واقعی هزینه ایجاد میکند. همچنین، محدودیت --max-tasks برای هر دامنه بهطور جداگانه اعمال میشود، نه برای کل اجرا؛ بنابراین، اگر دامنهای فیلتر نشود، تعداد وظایف اجراشده میتواند چند برابر شود.
نکته مهم دیگر، امنیت است. اجراکننده دسترسی نامحدود به شبکه دارد و Codex با غیرفعال بودن محیط ایزوله اجرا میشود. در راهنمای آزمایشها آمده است که در یکی از اجراهای اعتبارسنجی، Codex هنگام انجام وظیفهای در JobBench، بدون آنکه کسی از آن خواسته باشد، معیارهای ارزیابی همان وظیفه را دانلود کرد. مخزن بهطور پیشفرض دسترسی به چنین منابعی را مسدود نمیکند. مستندات فهرست میزبانهایی را ارائه میکنند که باید مسدود شوند و بهتر است این کار پیش از آغاز ارزیابی انجام شود.
در صورت استفاده از کلیدهای واقعی، باید احتیاط بیشتری به خرج داد؛ زیرا OpenCode اخیراً بهدلیل حملهای که کلیدهای API را در معرض خطر قرار داد خبرساز شده بود. بهتر است آزمایشها در محیطی ایزوله و با کلیدهای اختصاصی انجام شوند.
این روش چه تغییری برای توسعهدهندگان عاملهای هوش مصنوعی ایجاد میکند؟
این ایده که ابزارها و سازوکار پیرامون مدل بهاندازه خود مدل، یا حتی بیشتر از آن، اهمیت دارند، تازه نیست. انویدیا با استفاده از روش AVO توانست عملکرد همان مدل Claude Opus 5 را در معیار ARC-AGI-3 از ۳۰ درصد به ۱۰۰ درصد برساند؛ در این فرایند، فقط اجزای پیرامونی مدل تغییر کردند. از سوی دیگر، DeepSeek Harness خود را جایگزینی متنباز برای Claude Code معرفی میکند.
Harness2 گام متفاوتی برمیدارد: تنظیم سازوکار اجرایی را از دست برنامهنویس خارج میکند و به چرخهای خودکار میسپارد که بدون نیاز به سازوکار تأیید صحت کار میکند. این رویکرد در خانواده ایدههای خودبهبوددهی بازگشتی قرار میگیرد که پیشتر در ماه ژوئن در ارتباط با آنتروپیک بررسی شده بود. تفاوت اصلی اینجاست که بهبود به وزنهای خود مدل اعمال نمیشود، بلکه مجموعه ابزارها و قواعد پیرامون آن را هدف قرار میدهد.
این مقاله از زمان انتشار توجه فعالان حوزه پژوهش عاملهای هوش مصنوعی را جلب کرده است. در ۱۵ اکتبر، DAIR.AI، جامعهای که مقالات پژوهشی هوش مصنوعی را گردآوری و بررسی میکند، آن را بهعنوان مطلبی پیشنهادی برای افرادی معرفی کرد که سازوکارهای اجرایی اختصاصی میسازند.
یاد بگیرید چگونه سازوکارهای اجرایی اختصاصی بسازید! این مقاله گوگل درباره بهبود بازگشتی سازوکار عاملها بهشدت توصیه میشود. اگر روی تکامل سازوکارهای اجرایی کار میکنید، نکات ارزشمندی در آن خواهید یافت. مقاله همچنین بحث مهمی درباره خودبهبوددهی بازگشتی و تکامل سازوکارها برای وظایف در محیطهای باز ارائه میکند. تمرکز آن بر بهبود سازوکار اجرایی عامل در زمان آزمون، بدون وجود سازوکار تأیید صحت است؛ رویکردی که ویژگیهای مقیاسپذیری جالبی دارد. Harness² چند تغییر پیشنهادی برای سازوکار اجرایی وظیفه جاری ارائه میکند، آنها را با یکدیگر میسنجد و بهترین ترکیب را نگه میدارد. سپس درسهای حاصل از این تغییرات برای بهروزرسانی سازوکار اجرایی دومی به کار میروند که عامل در وظایف آینده نیز از آن استفاده خواهد کرد. نتایج نشان میدهند که این روش عملکرد GLM-5 و Gemini 3.5 Flash را در تمام پیکربندیهای آزمایششده در WorkBuddy-Bench، JobBench و LAB بهبود داده است. اجرای پنج تغییر پیشنهادی بهصورت موازی، ۲٫۹ تا ۳٫۹ امتیاز دیگر به WorkBuddy-Bench اضافه میکند. در همان مقایسه، روش پایه مبتنی بر حافظه ReasoningBank در وظایف برنامهنویسی تا ۶٫۶ امتیاز پایینتر از سازوکار اجرایی پایه قرار گرفت.
— DAIR.AI (@dair_ai)، ۱۵ اکتبر ۲۰۲۶
به نظر میرسد Harness2 در شرایط فعلی بیشتر بستری آزمایشی برای افرادی باشد که از قبل سازوکار اجرایی اختصاصی خود را دارند و میتوانند برای آزمایشها توکن مصرف کنند، نه ابزاری که فردا بتوان آن را بیدردسر در هر پروژهای به کار گرفت. مستندات، نسخه نمایشی و اجرای سه معیار را توضیح میدهند، اما راهنمایی برای اتصال چارچوب به عاملهای اختصاصی کاربران ارائه نمیکنند. ارزش عملی فعلی پروژه بیش از هر چیز در ایده آن و نمونه JobBench نهفته است. قواعد کنترلی، اسکریپتهای راستیآزمایی و راهنمای ابزارها فایلهای متنی سادهای هستند که هر توسعهدهندهای میتواند بنویسد؛ تفاوت Harness2 این است که سیستم با آزمونوخطا و مشاهده تغییرات، آنها را تولید میکند. فعلاً نتایج در حد آزمایشگاهی باقی ماندهاند.
پرسشهای متداول
۱. آیا Harness2 با Claude کار میکند؟
بله؛ هم در نقش ویرایشگر و هم در نقش اجراکننده. در مقاله، مدل پیشفرض برای ویرایش سازوکار اجرایی Claude Opus 4.8 در محیط OpenCode است. در آزمایشی جداگانه که در آن از همین مدل برای هر دو نقش استفاده شد و مقدار k=2 بود، هر پنج مدل آزمایششده، از GLM-5 تا Claude Opus 5، در تمام معیارها بهبود عملکرد داشتند. Claude Opus 5 در WorkBuddy-Bench، JobBench و LAB بهترتیب ۳٫۳، ۵٫۵ و ۳٫۰ امتیاز بهبود یافت. در پیکربندی مخزن نیز Claude روی Vertex یا Gemini بهعنوان مدل بهبوددهنده معرفی شده است.
۲. آزمایش Harness2 چقدر هزینه دارد؟
نسخه نمایشی رایگان است، اما اجرای معیارهای واقعی هزینه دارد. نسخه نمایشی محلی از مدلهای هوش مصنوعی استفاده نمیکند و به اعتبارنامه نیاز ندارد. در مقابل، اجرای معیارها از طریق Vertex AI با مدلها ارتباط برقرار میکند و طبق هشدار README هزینهبر است. نه README و نه مقاله هزینه هر وظیفه را مشخص نکردهاند؛ بنابراین بهتر است ابتدا یک وظیفه اجرا شود و هزینه واقعی بررسی شود.
۳. آیا میتوان از Harness2 برای عاملهای اختصاصی استفاده کرد؟
مخزن راهنمای مستندی برای این کار ارائه نمیکند. این پروژه خود را چارچوبی آماده برای بهبود بازگشتی سازوکار اجرایی معرفی میکند، اما مستندات تنها نسخه نمایشی و اجرای سه معیار JobBench، LAB و WorkBuddy-Bench را توضیح میدهند. برای سازگار کردن آن با وظایف اختصاصی، باید کد را بررسی کرد و نتایج را جداگانه آزمود.
۴. Harness2 چه تفاوتی با Meta-Harness دارد؟
Meta-Harness بهصورت آفلاین کار میکند، اما Harness2 هنگام اجرای وظایف سازوکار را بهبود میدهد. Meta-Harness در مجموعهای از وظایف آموزشی به دنبال بهترین سازوکار اجرایی میگردد و سپس آن را وارد محیط عملیاتی میکند. Harness2 از یک سازوکار اجرایی مشترک آغاز میکند و در هر وظیفه جدید آن را با استفاده از اجراهای آزمایشی همان وظیفه و کتابخانه ساختهشده از تجربههای قبلی اصلاح میکند؛ بدون نیاز به وظایف آموزشی جداگانه یا پاسخهای صحیح از پیش تعیینشده.