
چگونه بدون آموزش مجدد مدل، عملکرد یک عامل هوش مصنوعی را بهبود دهیم؟
برای بهبود عملکرد یک عامل هوش مصنوعی بدون آموزش مجدد مدل، باید روی «چارچوب اجرایی عامل» (Agent Harness) کار کرد؛ یعنی مجموعه تمام اجزایی که مدل زبانی را احاطه میکنند، از جمله دستورالعملهای سیستمی، قواعد همیشگی، حافظه، راهنمای استفاده از ابزارها، عاملهای فرعی، مهارتها، اسکریپتها و افزونهها. در این رویکرد، وزنهای مدل ثابت میمانند و فقط اجزای پیرامونی آن تغییر میکنند. آزمایشهای اخیر نشان دادهاند که همین تغییرات، بدون عوض کردن مدل، میتوانند نتایج را چند واحد درصد بهبود دهند.
گوگل با انتشار کد Harness2 بار دیگر توجهها را به این ایده جلب کرده است. این سامانه که پژوهشگران Google Cloud AI Research منتشر کردهاند، هنگام کار عامل، چارچوب اجرایی آن را بهصورت خودکار بازنویسی میکند. در مقاله این پژوهش در arXiv که ۹ اکتبر منتشر شده، جدولی کامل به مقایسه روشهای رقیب اختصاص دارد. بررسی موردی این سامانه را در مقاله اختصاصی درباره Harness2 جدید گوگل آوردهایم. در این مطلب، موضوع را از دیدی گستردهتر بررسی میکنیم تا سازندگان و پیکربندیکنندگان عاملها بدانند چه اهرمهایی در اختیار دارند، کدامیک ارزیابی شدهاند و کدام تغییرات را همین امروز میتوانند بهصورت دستی اعمال کنند.
برای روشن شدن نامهایی که در این حوزه مطرح میشوند، باید به دو نکته توجه کرد. Meta-Harness پروژهای از دانشگاه استنفورد و مؤسسه فناوری ماساچوست (MIT) است که KRAFTON نیز در میان وابستگیهای سازمانی آن قرار دارد و بهطور خودکار به جستوجوی بهترین کد چارچوب اجرایی میپردازد. ReasoningBank پژوهشی درباره حافظه عاملهاست که در کنفرانس ICLR 2026 پذیرفته شده است. سه پیشنویس پژوهشی منتشرشده در ژوئیه ۲۰۲۶ نیز با نامهای Harness Scaling، TTHE و Recursive Harness Self-Improvement به بازنگری چارچوب اجرایی در حین استفاده از عامل میپردازند. در ادامه، هرکدام را جداگانه بررسی میکنیم.
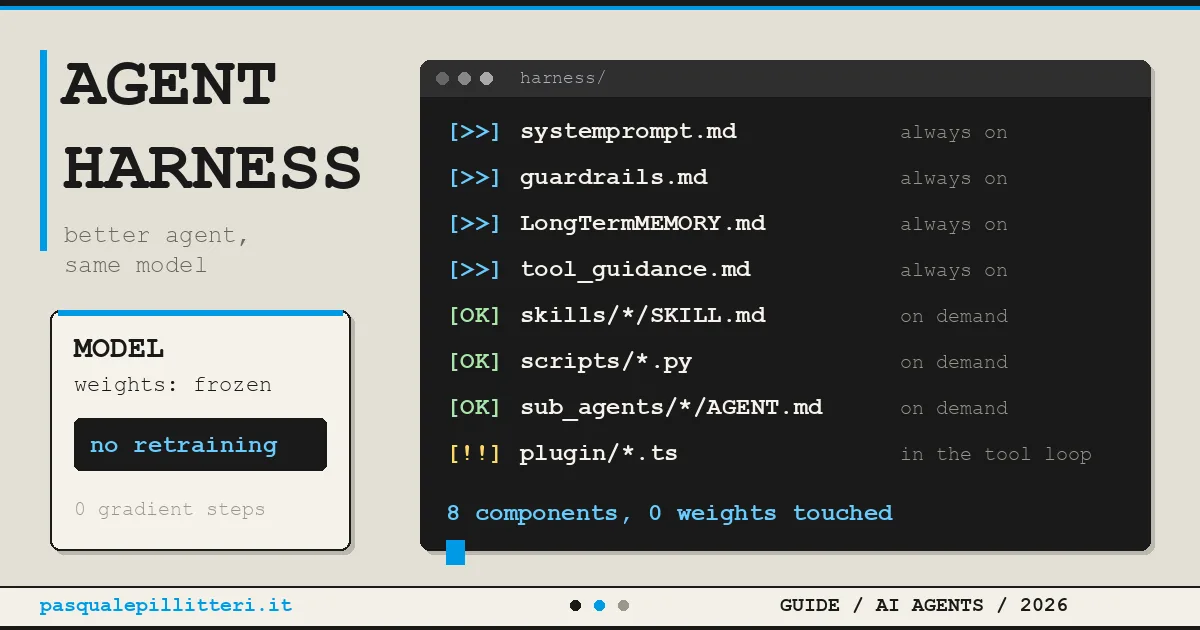
چارچوب اجرایی عامل چیست؟
چارچوب اجرایی عامل مجموعهای از کدها، فایلها و قواعد است که یک مدل زبانی را به عامل تبدیل میکند. این چارچوب زمینهای را میسازد که مدل میخواند، ابزارهای در دسترس مدل را تعیین میکند، اطلاعات لازم را از یک نشست به نشست بعدی انتقال میدهد و روند اجرای کار را کنترل میکند. در فایل راهنمای Harness2، این مفهوم بهعنوان سامانه پیرامون مدل تعریف شده و به بهینهسازی آن با ثابت نگه داشتن وزنهای مدل، اصطلاح harnessing اختصاص یافته است.
Claude Code، ابزار خط فرمان Codex شرکت OpenAI، OpenCode و Gemini CLI چهار نمونه از عاملهای برنامهنویسی هستند که از طریق ترمینال اجرا میشوند و بخش اصلی ساختارشان را همین چارچوب اجرایی تشکیل میدهد. در تحلیل معماری زمان اجرای Claude Code توضیح دادهایم که خود مدل تنها بخش کوچکی از کل سامانه است. پژوهشی از دانشگاه MBZUAI نیز این نسبت را بهصورت کمی بیان میکند: ۹۸٫۴ درصد زیرساخت و ۱٫۶ درصد هوش مصنوعی. کسانی که مطلب جداسازی مغز از دستها در معماری عاملهای هوش مصنوعی را خواندهاند، با ایده اصلی آشنا هستند؛ چارچوب اجرایی همان بخشی است که هنگام تعویض مدل همچنان باقی میماند.
چرا بهجای مدل، چارچوب اجرایی را بهبود دهیم؟
دلیل اصلی این است که معمولاً امکان کنترل خود مدل را نداریم، اما میتوانیم چارچوب اجرایی آن را تغییر دهیم؛ ضمن اینکه همین تغییرات، با ثابت ماندن مدل، ممکن است نتایج را به میزان چشمگیری بهبود دهند. انویدیا با استفاده از روش AVO و صرفاً با تغییر اجزای پیرامونی مدل، عملکرد همان Claude Opus 5 را در آزمون ARC-AGI-3 از ۳۰ درصد به ۱۰۰ درصد رساند. DeepSeek Harness نیز بهعنوان جایگزینی متنباز برای یک چارچوب اجرایی مشخص، یعنی چارچوب Claude Code، شکل گرفت.
پیشنویسهای پژوهشی سال ۲۰۲۶ اعداد کوچکتری گزارش میکنند، اما نتایج آنها در آزمونهای عمومی اندازهگیری شده است. در مقاله Harness2، مدل ضعیفتر GLM-5 شرکت Zhipu با استفاده از چارچوب اجرایی بهبودیافته در آزمون WorkBuddy-Bench امتیاز ۷۵٫۷ را به دست میآورد؛ این نتیجه از امتیاز ۷۲٫۴ مدل Gemini 3.5 Flash با چارچوب پیشفرضش بالاتر است. پژوهش Recursive Harness Self-Improvement نیز گزارش میکند که عاملهایی با سطح تلاش استدلالی پایین، پس از چند دور اصلاح، از پیکربندی دارای حداکثر تلاش بهتر عمل میکنند و در عین حال تا ۶۰ درصد هزینه استنتاج کمتری دارند. این اعداد، نتایج گزارششده از سوی نویسندگان در وظایف مشخصاند و محدودیتهایی دارند که در ادامه بررسی میکنیم؛ بااینحال، همگی به یک جهت اشاره دارند.
دلیل عملی دیگری هم وجود دارد: چارچوب اجرایی از فایلهای متنی و اسکریپتهای کوچک تشکیل میشود. بنابراین میتوان آن را خواند، نسخهبندی کرد، تغییراتش را با ابزارهای مقایسه نسخه بررسی کرد و به مدل دیگری انتقال داد. تنظیم دقیق مدل یا فاینتیونینگ چنین مزایایی را فراهم نمیکند.
هشت مؤلفه چارچوب اجرایی کداماند؟
مقاله Harness2 چارچوب اجرایی را به هشت مؤلفه تقسیم میکند که هرکدام بهصورت فایلی در محیط اجرا قرار میگیرند. این مؤلفهها بر اساس زمان استفاده دستهبندی شدهاند: چهار مورد همواره در زمینه در دسترس مدل قرار دارند، سه مورد فقط هنگام نیاز بارگذاری میشوند و یک مورد در جریان اجرای ابزارها عمل میکند.
| مؤلفه | زمان فعال بودن | محتوا | نمونه |
|---|---|---|---|
| پرامپت سیستمی | همیشه | شخصیت عامل و رویه عمومی معتبر برای همه وظایف | «ابتدا برنامهریزی کن، سپس اجرا کن و در پایان نتیجه را بررسی کن.» |
| قواعد کنترلی (Guardrails) | همیشه | محدودیتهای قطعی که مستقل از وظیفه یا ابزار معتبرند | فهرست کردن فایلهای ورودی و تحویل ندادن خروجی پیش از بررسی آن |
| حافظه | همیشه | اطلاعات پایدار درباره حوزه کاری که از یک وظیفه به وظیفه بعدی حفظ میشوند | قواعد مورد استفاده یک مشتری و قالبهای تکرارشونده فایلها |
| راهنمای ابزارها | همیشه | زمان و شیوه استفاده از هر ابزار موجود | حذف نمادها و ویرگولها از اعدادی که بهصورت متن ذخیره شدهاند، پیش از انجام محاسبات |
| مهارتها (Skills) | در صورت نیاز | رویههای کاملی که فقط هنگام نیاز بارگذاری میشوند و برای وظایف دیگر هزینهای ندارند | روش تطبیق برنامه زمانی، محل برگزاری، نیروی انسانی و بودجه |
| اسکریپتها | در صورت نیاز | کدی که از طریق خط فرمان اجرا میشود و جایگزین استدلال طولانی در قالب توکنها میشود | اسکریپتی برای باز کردن دوباره صفحات گسترده و بررسی آنها |
| عاملهای فرعی | در صورت نیاز | عاملهایی با پنجره زمینه مستقل که فقط نتیجه کار خود را بازمیگردانند | بازبینیکنندهای که کار را بدون اطلاع از سابقه انجام آن دوباره بررسی میکند |
| افزونهها یا میانافزارها | در جریان اجرا | قلابهایی پیرامون فراخوانی ابزارها و نوبتهای اجرا | جلوگیری از اجرای یک فرمان پیش از آغاز آن |
مهمترین تفاوت، تمایز میان درخواست کردن و الزامآور بودن است. پرامپت یا قاعده کنترلی از مدل میخواهد رفتاری مشخص داشته باشد، اما مدل ممکن است از آن پیروی نکند. در مقابل، افزونه به هر فراخوانی ابزار متصل میشود و قاعده را بدون وابستگی به تمایل مدل اجرا میکند. در Claude Code، هوکها (Hooks) همین نقش را دارند؛ مهارتها با بخش مربوط به بارگذاری هنگام نیاز مطابقت دارند و دستورالعملهای فایل CLAUDE.md نیز نقش پرامپت و حافظه را ایفا میکنند و قواعد کنترلی را هم در بر میگیرند.
امکان گسترش حافظه بسیار فراتر از این است و برخی افراد از پایگاه داده محلی برای این کار استفاده میکنند؛ نمونه آن TencentDB Agent Memory است. از سوی دیگر، عاملهای فرعی اهرم اصلی سامانههایی هستند که دهها عامل را بهصورت موازی هماهنگ میکنند؛ مانند Claude Code Dynamic Workflows و عاملهای فرعی Gemini CLI.
چه روشهایی برای بهبود عامل بدون تغییر وزنهای مدل وجود دارد؟
روشهای منتشرشده در سال ۲۰۲۶ را میتوان بر اساس زمان مداخله، مؤلفهای که تغییر میدهند و شیوه سنجش موفقیت تغییرات، در پنج خانواده قرار داد. در تمام این روشها، خود مدل بدون تغییر باقی میماند.
۱. جستوجوی آفلاین برای یافتن چارچوب بهتر؛ مانند Meta-Harness
Meta-Harness (arXiv 2603.28052، منتشرشده در ۳۰ مارس ۲۰۲۶، به قلم Yoonho Lee، Omar Khattab، Chelsea Finn و دیگر پژوهشگران) پیش از استقرار عامل به جستوجوی بهترین کد چارچوب اجرایی میپردازد. یک عامل پیشنهاددهنده، کد منبع، امتیازها و ردپاهای اجرای همه گزینههای قبلی را که در یک پوشه نگهداری میشوند بررسی میکند و گزینههای جدیدی پیشنهاد میدهد. سپس بهترین گزینه انتخاب میشود و بدون تغییر مورد استفاده قرار میگیرد. نویسندگان گزارش میکنند که این روش در یک وظیفه طبقهبندی متن برخط، در مقایسه با یک سامانه پیشرفته مدیریت زمینه، ۷٫۷ واحد امتیاز بهبود ایجاد کرده و تعداد توکنهای زمینه را به یکچهارم کاهش داده است. همچنین، در میانگین ۲۰۰ مسئله ریاضی در سطح المپیاد، با استفاده از پنج مدلی که در فرایند جستوجو دیده نشده بودند، ۴٫۷ واحد امتیاز بهبود ثبت شده است. این روش به وظایف آموزشی دارای امتیاز نیاز دارد و زمانی مناسب است که چنین معیاری در دسترس باشد.
۲. حافظه راهبردی؛ مانند ReasoningBank
ReasoningBank (arXiv 2509.25140، پذیرفتهشده در ICLR 2026) چارچوب اجرایی را تغییر نمیدهد و فقط روی حافظه کار میکند. عامل از تجربههای موفق و ناموفق خود راهبردهای استدلالی قابل تعمیم استخراج میکند؛ ارزیابی این تجربهها را خود عامل انجام میدهد. سپس هنگام مواجهه با وظیفهای مشابه، راهبردهای مرتبط را بازیابی میکند و راهبردهای تازهای نیز به حافظه میافزاید. نویسندگان در آزمونهای پیمایش وب و مهندسی نرمافزار، بهبود عملکرد این روش را در مقایسه با روشهایی گزارش کردهاند که مسیرهای اجرای خام را ذخیره میکنند. این ایده کمهزینه است و آزمایش آن آسانتر از روشهای دیگر به نظر میرسد، اما به افزودن متن به ابتدای پرامپت محدود میشود و ابزارها، قواعد یا اسکریپتها را تغییر نمیدهد.
۳. اصلاح جداگانه برای هر وظیفه؛ مانند Harness Scaling
در مقایسه ارائهشده در مقاله Harness2، اصطلاح Harness Scaling به روشی اشاره دارد که چارچوب اجرایی را برای هر وظیفه بهطور جداگانه اصلاح میکند. فرایند با یک اجرای پایه آغاز میشود؛ سپس چارچوب طی چند دور، با بررسی مسیرهای اجرا و بدون مشاهده امتیاز، اصلاح میشود. هیچیک از این تغییرات به وظیفه بعدی منتقل نمیشود. پژوهشی که در جدول به Wang و همکاران نسبت داده شده است (arXiv 2607.12227) به تکامل چارچوب اجرایی میپردازد و رویکردی انتقادی دارد. در آزمون Terminal-Bench 2.1، تکامل خودکار چارچوب، چه با آزمون و چه بدون آن، نتوانست از روش ساده مقیاسدهی هنگام اجرا، یعنی تکرار و انتخاب بهترین نتیجه، بهتر عمل کند و تعمیمپذیری ضعیفی داشت. بااینحال، در بازیهایی با افق زمانی طولانی، این روش با بودجه برابر در آزمون ARC-AGI-3 بهبودی ۸۰ درصدی و در EdgeBench بهبودی ۱۱ درصدی نسبت به روش جستوجوی مرجع ثبت کرد.
۴. تکامل در حین استفاده؛ مانند TTHE و Recursive Harness Self-Improvement
روش TTHE (arXiv 2607.08124، به قلم Nie و همکاران) چارچوب اجرایی قابلاجرا را وضعیت اصلی فرایند سازگاری در نظر میگیرد. برای هر دسته از وظایف بدون برچسب، مجموعهای از گزینههای مختلف تکامل داده میشود. سپس یک ارزیاب بر اساس ردپاهای اجرا و نشانههای استخراجشده از آنها، یکی از گزینهها را انتخاب میکند. چارچوب انتخابشده نتایج آن دسته از وظایف را تولید میکند و نقطه شروع دسته بعدی میشود.
در مقابل، روش Recursive Harness Self-Improvement (arXiv 2607.15524، به قلم Hyunin Lee، Matei Zaharia، Yujin Tang و دیگران) مشخصات عامل را در چند دور اصلاح میکند و از مقایسه دوتایی میان نسخههای بازنگریشده خود عامل بهعنوان معیار استفاده میکند. این روش روی ۳۰ وظیفه مصنوعی در حوزه پژوهش یادگیری ماشین آزمایش شده است.
۵. بازگشت بازگشتی در دو سطح؛ مانند Harness2
Harness2 (arXiv 2610.14224) ایدههای پیشین را با یکدیگر ترکیب میکند. برای هر وظیفه، دو نسخه متفاوت از چارچوب اجرایی پیشنهاد میدهد، آنها را آزمایش میکند و بدون دسترسی به پاسخ صحیح از پیش تعیینشده، اجزای مؤثر را با یکدیگر ترکیب میکند. در پایان وظیفه نیز آنچه مؤثر بوده در کتابخانهای ذخیره میشود تا وظایف بعدی را هدایت کند. نتایج تفصیلی در مقاله اختصاصی این سامانه آمده است. نکته مهم در اینجا آن است که ارزیابی بر مقایسه اجراها تکیه دارد، نه بر یک سامانه راستیآزمایی مستقل.
مقایسه روشها در یک جدول
| روش | زمان مداخله | مؤلفه تغییریافته | معیار ارزیابی | آنچه به وظیفه بعدی منتقل میشود |
|---|---|---|---|---|
| Meta-Harness | پیش از استفاده؛ آفلاین | کد چارچوب اجرایی | امتیاز وظایف آموزشی | هیچچیز؛ چارچوب انتخابشده ثابت میماند |
| ReasoningBank | حین استفاده | فقط حافظه | ارزیابی عامل از عملکرد خودش | مجموعهای رو به رشد از راهبردها |
| Harness Scaling | برای هر وظیفه بهصورت جداگانه | چارچوب همان وظیفه | مسیرهای اجرا، بدون امتیاز | هیچچیز میان وظایف |
| TTHE | حین استفاده و بهصورت دستهای | چارچوب اجرایی قابلاجرا | ارزیاب مبتنی بر ردپاهای اجرا | چارچوب انتخابشده به دسته بعدی منتقل میشود |
| Recursive Harness Self-Improvement | در هر دور اصلاح | مشخصات عامل | مقایسه دوتایی نسخههای بازنگریشده عامل | سابقه نسخههای بازنگریشده |
| Harness2 | حین استفاده، در دو سطح | هر هشت مؤلفه | مقایسه اجراها، بدون راستیآزمای مستقل | کتابخانهای از چارچوبها و درسآموختهها |
در مجموع، جدول یک نکته اساسی را نشان میدهد: هرچه در این طیف جلوتر میرویم، وابستگی به امتیاز بیرونی کمتر و اتکا به ارزیابی مدل از عملکرد خودش بیشتر میشود. این تغییر ممکن است اجرای روش را عملیتر کند، اما قطعاً مسئله قابلیت اعتماد را جدیتر میسازد. محدودیتهای زیر معنای این تفاوت را روشن میکنند.
محدودیتهایی که باید در نظر داشت
- اعداد گزارششده برای هر روش را نویسندگان همان پژوهش، با مدلها و معیارهای متفاوت اندازهگیری کردهاند. بنابراین نمیتوان روشی را که در WorkBuddy-Bench یازده واحد امتیاز بهبود میدهد، مستقیماً با روشی که در یک وظیفه طبقهبندی متن ۷٫۷ واحد بهبود ثبت کرده است مقایسه کرد. جدول بالا سازوکار روشها را توضیح میدهد، نه اینکه برنده را مشخص کند.
- پژوهش Wang و همکاران از همه انتقادیتر است. در Terminal-Bench 2.1، تکامل خودکار چارچوب نتوانست از تکرار ساده همراه با انتخاب بهترین نتیجه بهتر عمل کند و تعمیمپذیری ضعیفی نشان داد. نویسندگان همچنین انتقاد میکنند که بسیاری از پژوهشهای پیشین از آزمونهای همان معیار ارزیابی برای هدایت فرایند بهبود استفاده میکنند که نتیجه نهایی را نیز با آن میسنجند. بنابراین، هرکس روش خودکاری را به کار میگیرد باید آن را با یک روش پایه ساده و با بودجه برابر مقایسه کند.
- وقتی پاسخ صحیح از پیش مشخص نیست، ارزیابی به تفاوت میان اجراها و سوگیریهای مشترک مدلها وابسته میشود. نویسندگان Harness2 تأکید میکنند که این نشانهها نه صحت نتیجه را تضمین میکنند و نه انتقال موفقیت به وظایف دیگر را. بنابراین، چارچوب انتخابشده صرفاً فرضیهای است که یک بار جواب داده است.
- هر دور بهبود به اجرای بیشتر و در نتیجه هزینه اضافی نیاز دارد. مقاله Harness2 دامنه محدودی از بودجههای محاسباتی را بررسی کرده و بهترین شیوه تخصیص این بودجه را مشخص نمیکند.
امروز چه چیزهایی را میتوان بهصورت دستی پیاده کرد؟
تقریباً همه این تغییرات را میتوان بدون ابزارهای خودکار انجام داد؛ در واقع، سامانههای خودکار فایلهایی تولید میکنند که انسان هم میتواند بهتنهایی بنویسد. یکی از آموزندهترین نمونهها در مقاله Harness2 گزارش شده است. در آزمون JobBench، عامل Gemini 3.5 Flash که با OpenCode اجرا میشد، برای وظیفه تطبیق فایلهای مربوط به یک تولید، شامل برنامه زمانی، محل برگزاری، نیروی انسانی و بودجه، در اجرای پایه امتیاز ۴۳٫۱ گرفت. سامانه بهجای کمبود دانش، دو نقص رویهای را شناسایی کرد: اعداد میان فایلها با یکدیگر تطبیق داده نمیشدند و فایلهای خروجی برای بررسی دوباره باز نمیشدند. پس از چهار تغییر شامل افزودن یک قاعده کنترلی، یک اسکریپت راستیآزمایی، یک مهارت و یک دستورالعمل برای استفاده از ابزارها، امتیاز به ۷۷٫۸ رسید. این نمونهای است که نویسندگان انتخاب کردهاند و میانگین نتایج نیست؛ بااینحال، دو قاعدهای که بیشترین تفاوت را ایجاد کردند، بهسادگی قابل تکرارند.
قاعده کنترلی برای فهرست کردن ورودیهای عامل
اولین تغییر، افزودن یک قاعده مربوط به روند کار است. عامل باید در ابتدای کار فایلهای دریافتی را فهرست کند، منشأ هر عدد را به منبع معتبر آن پیوند دهد و پیش از تحویل، هر فایل تولیدشده را دوباره باز کند. این قاعده باید در فایل دستورالعملی قرار بگیرد که همیشه بارگذاری میشود، مانند CLAUDE.md در Claude Code، نه در پرامپتی که کاربر در هر نشست جداگانه وارد میکند.
# guardrails.md
1. در ابتدای کار، تمام فایلهای ورودی دریافتی را فهرست کن و کاربرد هرکدام را بنویس.
2. برای هر عددی که در نتیجه نهایی میآید، مشخص کن از کدام فایل و کدام سلول گرفته شده است.
اگر دو فایل مقادیر متفاوتی دارند، از منبعی استفاده کن که مرجع معتبر تعیین شده است و اختلاف را گزارش بده.
3. پیش از تحویل، همه فایلهای تولیدشده را دوباره باز کن و بررسی کن که باز میشوند،
همه بخشهای موردنیاز را دارند و هیچ سلولی مقدار خالی نشان نمیدهد.
4. اگر بررسیای ناموفق بود، مشکل را برطرف کن و بررسی را دوباره اجرا کن. تا زمانی که
بررسیای حلنشده باقی مانده است، خروجی را تحویل نده.اسکریپتی برای باز کردن دوباره خروجیها
قاعده «فایلها را دوباره باز کن» زمانی مؤثرتر است که بررسی آن با کد اجرا شود؛ زیرا مدل ممکن است پس از مدتی کار کردن، بهاشتباه تصور کند که نتیجه آماده است. یک بررسی ساده برای صفحات گسترده میتواند فرمولهایی را شناسایی کند که مقدار نمایشدادهشده برای کاربر خالی است. البته نکتهای مهم وجود دارد: فایلی که با کتابخانهای مانند openpyxl ساخته شده باشد، تا زمانی که LibreOffice یا Excel آن را دوباره محاسبه نکند، ممکن است مقادیر محاسبهشده فرمولها را در خود نداشته باشد. بنابراین بهتر است پیش از بررسی، محاسبات فایل دوباره اجرا شوند.
import sys
from openpyxl import load_workbook
def formule_senza_valore(percorso):
formule = load_workbook(percorso) # سلولهای حاوی فرمول
valori = load_workbook(percorso, data_only=True) # آخرین مقدار محاسبهشده
vuote = []
for foglio in formule.worksheets:
for riga in foglio.iter_rows():
for cella in riga:
if isinstance(cella.value, str) and cella.value.startswith("="):
if valori[foglio.title][cella.coordinate].value is None:
vuote.append(f"{foglio.title}!{cella.coordinate}")
return vuote
if __name__ == "__main__":
for percorso in sys.argv[1:]:
for ref in formule_senza_valore(percorso):
print(f"{percorso}: فرمول بدون مقدار در {ref}")راهنمای ابزار برای خطاهایی که عامل مرتب تکرار میکند
سومین اهرم از همه سادهتر است و اغلب نتیجه خوبی میدهد. اگر عامل هنگام استفاده از یک ابزار دو بار به یک مشکل مشابه برخورد کرد، میتوان با افزودن یک خط به راهنمای آن ابزار مشکل را برطرف کرد. در نمونه JobBench، دستور این بود که پیش از محاسبه، نمادها و ویرگولها از اعدادی که بهصورت متن ذخیره شدهاند حذف شوند. در محیط کاری شما ممکن است مشکل چیز دیگری باشد؛ مثلاً ترتیب پارامترهای یک ابزار خط فرمان یا قالب تاریخ. اصل کار یکسان است: خطای تکراری را به دستورالعملی مکتوب تبدیل کنید. اگر رویه طولانی باشد، بهتر است آن را به یک مهارت تبدیل کنید و با آزمونها و معیارهای ارزیابی بسنجید که آیا واقعاً مؤثر است یا نه. اگر قاعده ممنوعیتی مطلق باشد، جای آن در یک هوک است.
چگونه بفهمیم تغییر مؤثر بوده است؟
سامانههای خودکار این بخش را برای شما انجام میدهند، اما هنگام اصلاح دستی اغلب نادیده گرفته میشود. پنج تا ده وظیفه واقعی و تکرارپذیر انتخاب کنید، عامل را پیش و پس از تغییرات اجرا کنید و هر وظیفه را سه بار تکرار کنید. مقاله Harness2 میانگین سه اجرا را گزارش میکند، زیرا نتیجه یک اجرای منفرد ممکن است صرفاً حاصل نوسان تصادفی باشد. هر بار فقط یک مؤلفه را تغییر دهید؛ در غیر این صورت نمیتوانید تشخیص دهید کدام تغییر مؤثر بوده است. اگر اصلاً معیاری برای تشخیص بهتر بودن نتیجه ندارید، هیچ روش خودکاری مشکل را حل نمیکند. نخست باید همان معیار را تعریف کنید.
آزمایشهای دیگری نیز با همین منطق و با تغییر فایلهای مربوط به خود سامانه انجام شدهاند. از جمله SIA، یک عامل متنباز که کد خودش را بازنویسی میکند و، در سطح نظری، پژوهش بهبود خودبازگشتی که در ارتباط با Anthropic بررسی کردهایم. در هر دو مورد، تغییرات به اجزای پیرامونی مدل مربوط میشوند، نه به وزنهای آن.
نکات کلیدی
- وقتی امکان تغییر مدل وجود ندارد، چارچوب اجرایی مهمترین اهرم باقیمانده است. ارزش کار روی آن از اینجا ناشی میشود که فایلهای متنی آن را میتوان خواند، نسخهبندی کرد و به مدل دیگری انتقال داد. در یکی از آزمایشهای مقاله Harness2، مدلی ضعیفتر با چارچوب اجرایی بهبودیافته از مدلی قویتر با چارچوب پیشفرض بهتر عمل کرد.
- هر هشت مؤلفه نقش یکسانی ندارند. مؤلفههایی که همیشه بارگذاری میشوند، در هر فراخوانی بخشی از ظرفیت زمینه را مصرف میکنند، اما مؤلفههای بارگذاریشونده هنگام نیاز چنین هزینهای ندارند. افزونه تنها مؤلفهای است که میتواند یک قاعده را بدون اتکا به تبعیت مدل اجرا کند؛ بنابراین ممنوعیتهای قطعی باید در این لایه اعمال شوند، نه صرفاً در پرامپت.
- نمیتوان پنج روش منتشرشده را مستقیماً با یکدیگر مقایسه کرد، زیرا هرکدام با مدلها و معیارهای متفاوتی آزمایش شدهاند. انتخاب روش باید بر اساس امکانات موجود باشد: جستوجوی آفلاین به امتیاز وظایف شناختهشده نیاز دارد، درحالیکه روشهای یادگیری حین استفاده برای جریان پیوستهای از وظایف مناسباند.
- پیش از خودکارسازی، دو قاعدهای را که بیشترین بهبود را در نمونه JobBench ایجاد کردند، دستی پیاده کنید: فهرست کردن ورودیها و باز کردن دوباره خروجیها. سپس عملکرد را پیش و پس از تغییر، با سه بار اجرا در هر مرحله، بسنجید.
- روش خودکار تنها زمانی ارزش استفاده دارد که با بودجهای برابر از یک روش پایه ساده بهتر عمل کند. بر اساس گزارش Wang و همکاران، این برتری در آزمون Terminal-Bench 2.1 مشاهده نشد.
پرسشهای متداول
۱. آیا بهبود چارچوب اجرایی جایگزین فاینتیونینگ میشود؟
خیر؛ این دو، دو اهرم متفاوتاند. فاینتیونینگ وزنهای مدل را تغییر میدهد و به داده، توان محاسباتی و مدلی نیاز دارد که امکان آموزش آن وجود داشته باشد. در مقابل، چارچوب اجرایی را میتوان با فایلهای متنی اصلاح کرد؛ حتی اگر مدل بسته باشد و فقط از طریق API در دسترس قرار بگیرد. میتوان هر دو روش را با هم به کار گرفت، اما هزینه روش دوم معمولاً بسیار کمتر است.
۲. آیا مهندسی چارچوب اجرایی همان مهندسی زمینه است؟
مهندسی زمینه بخشی از مهندسی چارچوب اجرایی است. مهندسی زمینه مشخص میکند مدل در هر مرحله چه اطلاعاتی را بخواند؛ از جمله پرامپت، حافظه و اسناد بازیابیشده. چارچوب اجرایی علاوه بر این موارد، تواناییهای عملی مدل و شیوه کنترل آن را نیز در بر میگیرد؛ یعنی ابزارها، عاملهای فرعی، اسکریپتها و افزونهها.
۳. بهبود خودکار چارچوب اجرایی چقدر هزینه دارد؟
مقاله Harness2 هزینه را به دلار یا یورو مشخص نمیکند. مقاله توضیح میدهد که هر دور اصلاح به اجراهای اضافی و نشستهای ویرایش نیاز دارد. اجرای موازی نشستها زمان را کاهش میدهد، اما کل توان محاسباتی موردنیاز را کم نمیکند. همچنین دامنه بودجههای بررسیشده محدود بوده است. فایل راهنمای پروژه هشدار میدهد که اجرای آزمونها با مدلهای واقعی هزینه دارد و توصیه میکند کار را با یک وظیفه آغاز کنید.
۴. آیا چارچوب بهبودیافته برای یک مدل روی مدل دیگری هم کار میکند؟
انتقال موفقیت تضمینشده نیست. مقاله Harness2 نشان میدهد کتابخانهای که از JobBench به دست آمده، در WorkBuddy-Bench نیز به بهبود نتایج کمک کرده است؛ بااینحال، نویسندگان تأکید میکنند که نشانههای مورد استفاده آنها انتقال موفقیت به وظایف دیگر را تضمین نمیکنند. Wang و همکاران نیز در Terminal-Bench 2.1 تعمیمپذیری ضعیفی مشاهده کردند. بنابراین، باید این موضوع را در هر مورد جداگانه آزمایش کرد.
۵. آیا میتوان Harness2 را با Claude Code به کار گرفت؟
در فایل راهنمای پروژه، OpenCode بهعنوان محیط اجرایی پیشفرض و Codex بهعنوان گزینه دیگر معرفی شدهاند. Claude Code در فهرست محیطهای اجرایی پشتیبانیشده قرار ندارد. بااینحال، میتوان ایدههای این پژوهش را بهصورت دستی در Claude Code پیاده کرد، زیرا مؤلفههای معرفیشده در مقاله معادلهایی در آن دارند؛ از جمله CLAUDE.md، مهارتها، عاملهای فرعی و هوکها.
۶. بهتر است از کدام روش شروع کنیم؟
در ابتدا، بهتر است سراغ هیچیک از پنج روش خودکار نروید. یک قاعده کنترلی و یک اسکریپت بررسی را دستی بنویسید، عملکرد را روی وظایف واقعی پیش و پس از تغییرات بسنجید و تنها زمانی به سراغ روش خودکار بروید که با مجموعهای از وظایف تکرارشونده و معیاری روشن برای ارزیابی روبهرو باشید. در آن مرحله، انتخاب روش به امکانات و شرایط شما بستگی دارد؛ همانطور که در بخش نکات کلیدی توضیح داده شد.
جمعبندی
بخش قابلتغییر یک عامل هوش مصنوعی بسیار گستردهتر از چیزی است که هنگام بحث درباره مدلها تصور میشود. کسانی که هر روز با عاملهای برنامهنویسی کار میکنند، معمولاً همین حالا هم هشت مؤلفه چارچوب اجرایی را در اختیار دارند: یک فایل دستورالعمل، چند مهارت و یکی دو هوک. بااینحال، در بسیاری از موارد این اجزا را یک بار نوشتهاند و دیگر به سراغ بازبینی آنها نرفتهاند. برای شروع، به چارچوب گوگل نیاز ندارید؛ کافی است فهرستی از وظایف تهیه کنید و یک ساعت وقت بگذارید تا خطاهای تکراری را به دستورالعملهای روشن تبدیل کنید. پس از تهیه این فهرست، مقایسه نتایج با Harness2 دیگر صرفاً مطالعه یک پژوهش نخواهد بود، بلکه به آزمایشی عملی تبدیل میشود که میتوانید خودتان اجرا کنید.