
کلود آنقدر سریع کد مینویسد که گیت از آن عقب میماند؛ آنتروپیک در پنج ماه و با تیمی هفتنفره سامانه کنترل نسخه جدیدی ساخت
آنتروپیک در ماه مه امسال بهطور میانگین روزانه حدود ۲۵۰۰ تغییر کد را ادغام میکرد. این رقم تا سپتامبر از ۳۰ هزار مورد در روز فراتر رفت. به این ترتیب، حجم ادغام کدها تنها در چهار ماه بیش از ۱۲ برابر شد.
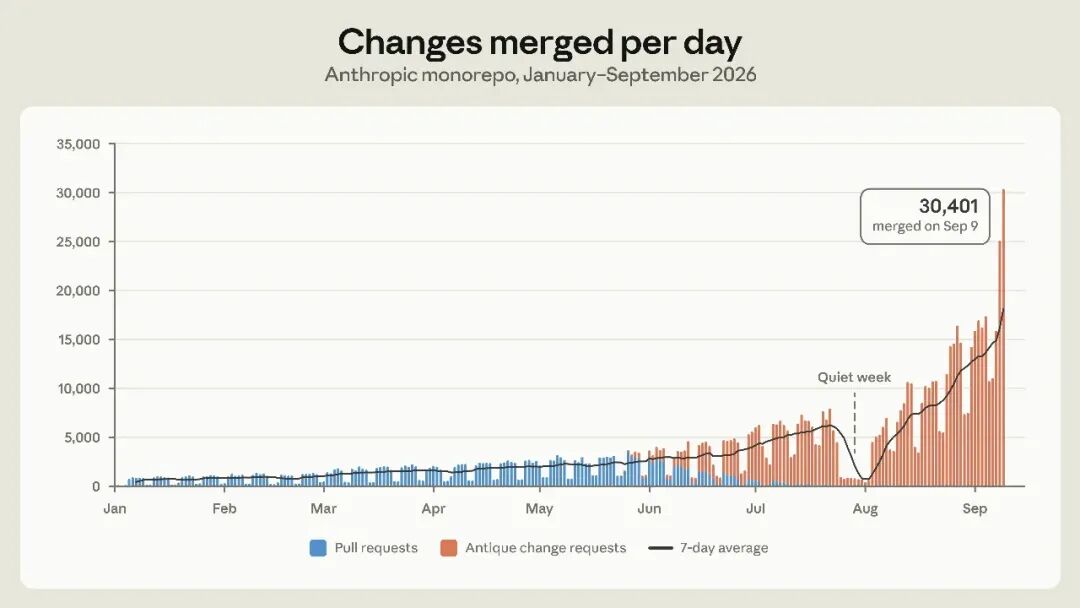
بخش عمده این رشد به کلود، عامل هوش مصنوعی آنتروپیک برای برنامهنویسی، مربوط میشود. این عامل میتواند بهصورت مستقل کد را تغییر دهد، آزمونها را اجرا کند، برنامهها را در چند مرحله بهینهسازی کند و حتی سرویسهایی را از ابتدا بسازد. با افزایش سرعت تولید کد، زیرساختهای توسعه نرمافزار که در اصل برای مهندسان انسانی طراحی شده بودند، بهتدریج از این روند عقب میمانند.
نخستین گلوگاه جدی در این میان گیت بود. تاریخچه شاخه اصلی مخزن یکپارچه کد آنتروپیک (Monorepo) نزدیک به ۱۰۰ گیگابایت حجم دارد و نسخه کاری فشردهشده آن بیش از ۲۵ گیگابایت است. سامانه یکپارچهسازی مداوم (CI) بهتنهایی باید روزانه حدود ۲۵ میلیون بار عملیات دریافت نسخه کد را انجام دهد. اگر برای دریافت دادهها از گیت از روشی ساده و بدون بهینهسازی استفاده شود، حجم انتقال داده موردنیاز در هر روز ممکن است از ۶۰۰ پتابایت فراتر برود.
آنتروپیک پیشتر از روشهای بهینهسازی گوناگونی مانند کلون کمعمق گیت (shallow clone)، دریافت پراکنده فایلها (sparse checkout)، آینههای داخلی و نسخههای لحظهای ذخیرهشده در فضای ذخیرهسازی اشیا استفاده کرده بود. این شرکت در اوج کار حتی صدها سرور آینه گیت را نگهداری میکرد، اما با ادامه رشد تعداد ادغامها، حفظ این مجموعه راهکارها روزبهروز دشوارتر شد.
آنتروپیک در نهایت تصمیمی نسبتاً جسورانه گرفت: سامانه کنترل نسخه اختصاصی خود را از نو توسعه دهد.
این شرکت در ۱۳ اکتبر، پروژه را در وبلاگ رسمی مهندسی خود معرفی کرد. تیمی متشکل از تنها هفت مهندس طی پنج ماه سامانه کنترل نسخه جدیدی به نام Scion ساخت و کل مخزن یکپارچه کد شرکت را به آن منتقل کرد. همزمان، ابزار بازبینی کد Antique، سامانه جستوجوی کد، مدیریت مجوزها و زیرساختهای مکمل دیگری نیز توسعه داده شدند.
پس از این مهاجرت، مصرف پردازنده و حافظه در زیرساخت Scion به حدود یکدویستم راهکار قبلی مبتنی بر آینههای گیت رسید. سرعت دریافت کد برای CI و وظایف پژوهشی نیز حدود دو مرتبه بزرگی افزایش یافت و تنها بخش CI حدود ۲۵ درصد از ظرفیت پردازنده موردنیاز خود را کاهش داد.
نکته جالبتر اینکه کلود نهتنها یکی از عوامل اصلی افزایش فشار بر این زیرساخت بود، بلکه به آنتروپیک کمک کرد تا این تحول فنی را نیز به سرانجام برساند.
۱. روزانه ۳۰ هزار ادغام کد؛ گیت دقیقاً کجا کم میآورد؟
یکی از دلایل اصلی تبدیلشدن گیت به ابزار استاندارد صنعت توسعه نرمافزار، معماری توزیعشده آن است. توسعهدهندگان میتوانند تاریخچه مخزن را بهصورت محلی نگه دارند، ثبت تغییرات (commit) ایجاد کنند، تفاوت نسخهها را مقایسه کنند و حتی بدون اتصال به شبکه بسیاری از عملیات را انجام دهند.
برای بیشتر پروژههای نرمافزاری، این طراحی بسیار موفق بوده است. بااینحال، معنای دیگر آن این است که هر کلاینت باید قابلیتهای نسبتاً کاملی برای کنترل نسخه داشته باشد و دادههای مخزن موردنیاز برای انجام عملیات مختلف را ذخیره کند.
اما حجم کاری آنتروپیک بهطور چشمگیری تغییر کرده است.
نخست اینکه خود مخزن کد روزبهروز بزرگتر میشود. تاریخچه شاخه اصلی با حجمی نزدیک به ۱۰۰ گیگابایت و نسخه کاری فشردهشدهای با حجم بیش از ۲۵ گیگابایت، ایجاد مکرر محیطهای توسعه، محیطهای CI و محیطهای ایزوله برای عاملهای هوش مصنوعی را پرهزینه میکند. دوم اینکه تعداد دفعات دریافت کد بسیار زیاد است. رقم حدود ۲۵ میلیون دریافت در روز، حتی تقاضای اضافی ناشی از محیطهای توسعه مهندسان، محیطهای ایزوله عاملها و وظایف پژوهشی را هم شامل نمیشود.
مهمتر از همه، سرعت تغییر کد بسیار بیشتر از سرعت معمول تیمهای توسعه سنتی شده است. آنتروپیک در مطلب رسمی خود توضیح داد که هر بار یک گلوگاه توسعه برطرف میشود، میزان تولید کد باز هم افزایش مییابد. بنابراین، زیرساخت توسعه باید پیوسته خود را با این رشد تطبیق دهد.
آنتروپیک برای سرپا نگهداشتن گیت، صدها سرور آینه داخلی راهاندازی کرده و نسخههای لحظهای مخزن را در فضای ذخیرهسازی اشیا نگه داشته بود. این راهکارها تعداد دانلودهای تکراری را کاهش میدهند، اما بار نگهداری تازهای نیز ایجاد میکنند. آینهها باید پیوسته همگامسازی شوند، نسخههای ذخیرهشده خیلی زود از شاخه اصلی عقب میمانند و حفظ عملکرد درست عملیات وابسته به تاریخچه، مانند مقایسه تفاوتها (diff) و مشخصکردن منشأ تغییرات هر خط کد (blame)، در محیط کلون جزئی بهمرور پیچیدهتر میشود.
در نتیجه، آنتروپیک یکی از فرضهای دیرینه طراحی گیت را دوباره بررسی کرد: اگر بیشتر عملیات کدنویسی را عاملهایی انجام میدهند که همواره آنلاین هستند و وظایف خودکار را اجرا میکنند، چرا هر کلاینت باید مانند یک کلاینت سنتی گیت بتواند کل تاریخچه مخزن را بهطور مستقل پردازش کند؟
این پرسش نقطه آغاز طراحی Scion شد.
البته، چالش ناسازگاری میان مخازن یکپارچه بسیار بزرگ و گیت موضوع تازهای نیست. گوگل مدتها پیش سامانه کنترل نسخه متمرکز داخلی خود به نام Piper را توسعه داد و متا نیز سالهاست روی Sapling کار میکند. مشکلاتی که آنتروپیک اکنون با آنها روبهرو شده، به مسائل این شرکتهای بزرگ فناوری شباهت دارد، اما عامل ایجاد فشار متفاوت است: در گذشته، بزرگی سازمان مهندسی و حجم مخزن کد عامل اصلی بودند؛ اکنون تعداد زیادی عامل برنامهنویسی که بهصورت موازی کار میکنند نیز فشار مشابهی ایجاد کردهاند.
۲. Scion چگونه طراحی شده است؟ انتقال بخش عمده عملیات کنترل نسخه به سرور
مهمترین تغییر در طراحی Scion، کنارگذاشتن الگوی مبتنی بر مخزن محلی و حرکت بهسوی معماری کلاینت ـ سرور با اتصال دائمی است.
در گیت، کلاینت میتواند بهطور مستقل ثبت تغییرات ایجاد کند، عملیات بازپایهگذاری (rebase) انجام دهد، تاریخچه را بررسی کند و سپس تغییرات را به مخزن راه دور بفرستد. در Scion، عملیات اصلی مانند ثبت تغییرات، ادغام، بازپایهگذاری و جستوجو در تاریخچه به سمت سرور منتقل شدهاند. وظیفه اصلی کلاینت، نگهداری یک حافظه نهان محلی محدود، مدیریت پوشه کاری و رصد تغییرات فایلهاست.
از آنجا که ثبت تغییرات مستقیماً روی سرور انجام میشود، Scion دیگر به مرحله ارسال تغییرات به مخزن راه دور (push) در گردش کار سنتی گیت نیاز ندارد. کلاینت نیز مجبور نیست حجم زیادی از دادههای مخزن را که ارتباطی با وظیفه جاری ندارند دانلود کند.
این تغییر به سامانههای دیگر نیز اجازه میدهد از طریق رابطهای برنامهنویسی کاربردی (API) مستقیماً به قابلیتهای کنترل نسخه دسترسی داشته باشند. برای مثال، اگر یک وظیفه CI فقط بخواهد تفاوت میان یک ثبت تغییرات و نقطه مبنای مشترک آن با شاخه دیگر را محاسبه کند، میتواند مستقیماً نتیجه را از سرور درخواست کند و نیازی نیست ابتدا کل مخزن کد را دریافت کند. ابزارهایی مانند بازگردانی خودکار تغییرات و یافتن ثبت تغییرات مشکلساز نیز میتوانند تاریخچه نسخهها را از طریق API بررسی کنند.
از دیدگاه معماری مهندسی، هدف Scion این است که هزینه عملیات کنترل نسخه بیش از آنکه به اندازه کل مخزن وابسته باشد، با حجم دادههایی متناسب باشد که واقعاً تغییر کردهاند.
برای رسیدن به این هدف، ساختار داده زیربنایی Scion نیز از نو طراحی شده است.
در گیت، هر ثبت تغییرات به درخت پوشهها و فایلهای متناظر ارجاع میدهد. Scion از رکورد تغییری به نام Changeset استفاده میکند که در گزارش ثبت پیشدستانه (Write-Ahead Log) نوشته میشود. هر Changeset فایلهایی را ثبت میکند که نسبت به نخستین ثبت تغییرات والد تغییر کردهاند و همچنین ارجاعهای مبتنی بر محتوا را در خود دارد که به محتوای فشردهشده فایلها اشاره میکنند.
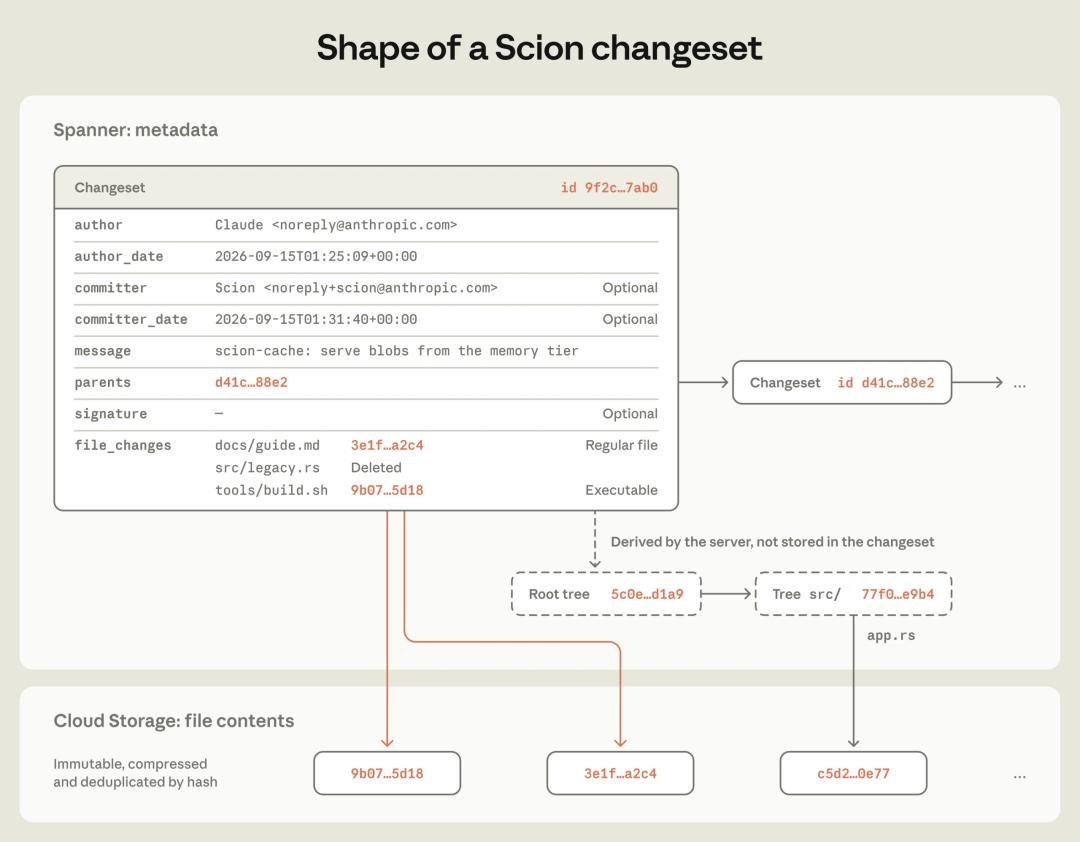
محتوای فایلها در فضای ذخیرهسازی اشیا (Blob Storage) نگهداری میشود و مدیریت روابط میان نسخهها و فرادادههای مرتبط بر عهده سامانه پشتیبان است. Scion برای ذخیره بخشی از فرادادههایی که به هماهنگی میان اجزا نیاز دارند از Spanner استفاده میکند و تا حد امکان، هنگام ایجاد ثبت تغییرات، نیاز به همگامسازی میان سرورها را کاهش میدهد.
این طراحی امکان ایجاد و توزیع سریع ثبت تغییرات را فراهم میکند و بخشی از سربار بستهبندی، مذاکره میان طرفین و نگهداری ناشی از سازوکار Packfile در گیت را نیز از میان میبرد.
Scion همچنان از ارجاعهایی (ref) مشابه شاخهها و برچسبهای گیت پشتیبانی میکند، اما وابستگی به آنها را به حداقل میرساند. از نظر آنتروپیک، اگر تعداد زیادی از عملیات به بهروزرسانی وضعیت مشترک و سراسری نیاز داشته باشند، گلوگاههای هماهنگی دوباره پدیدار میشوند. به همین دلیل، ایجاد عادی ثبت تغییرات در Scion به جابهجایی ارجاعها وابسته نیست و فقط در مواردی مانند شاخه اصلی یا شاخه انتشار، این ارجاعها بهروزرسانی میشوند.
بااینحال، انتقال عملیات به سرور به این معنا نیست که مشکل خودبهخود حل میشود. سرور باید همزمان به درخواستهای تعداد زیادی عامل هوش مصنوعی و وظیفه CI پاسخ دهد. اگر همه کلاینتها مستقیماً به فضای ذخیرهسازی مرکزی دسترسی پیدا کنند، سامانه همچنان ممکن است زیر فشار ترافیک از کار بیفتد.
به همین دلیل، آنتروپیک معماری حافظه نهان چندلایهای طراحی کرده است.
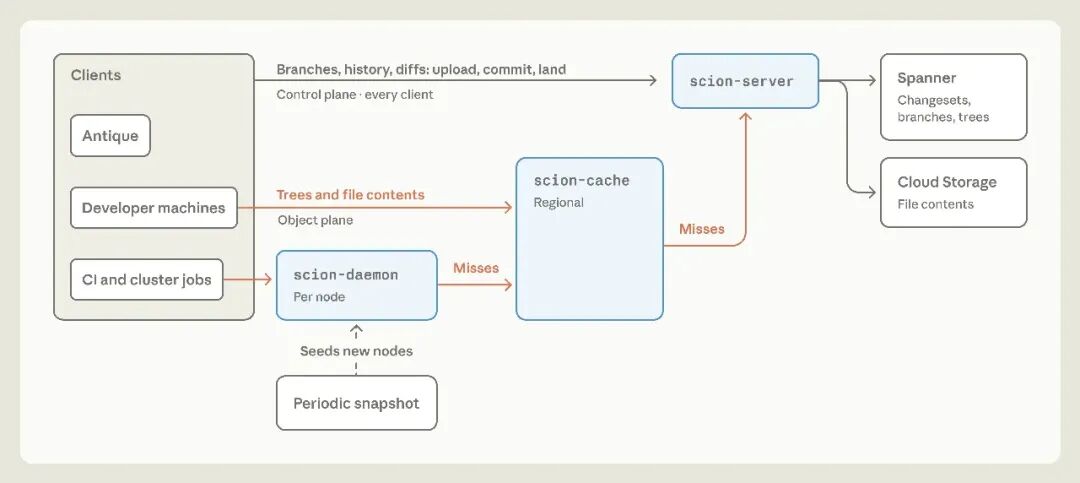
در هر گره محاسباتی، سرویس scion-daemon حافظه نهان اشیای فایل را میان چند وظیفه که روی همان گره اجرا میشوند به اشتراک میگذارد. در سطح منطقه، سرور scion-cache لایه دوم حافظه نهان را فراهم میکند و در نهایت به سرور مرجع scion-server متصل میشود. تنها زمانی که داده موردنیاز در حافظه نهان پیدا نشود، دسترسی به Spanner یا فضای ذخیرهسازی ابری لازم خواهد بود.
کلاینت اشیای مشخص و تغییرناپذیری را درخواست میکند. از آنجا که آدرس هر شیء بر اساس محتوای آن تعیین میشود، حافظه نهان لازم نیست هر بار دوباره بررسی کند که آیا شیء تغییر کرده است یا خیر. همچنین میتوان ظرفیت هر لایه از سرویسها را بهطور مستقل افزایش داد.
آنتروپیک اعلام کرده است که نرخ برخورد موفق با حافظه نهان در هر یک از لایههای این معماری بیش از ۹۹ درصد است. سلسلهمراتب مشخص حافظه نهان همچنین امکان جداسازی خطاها را فراهم میکند و مانع از آن میشود که در صورت از کار افتادن حافظه نهان یک منطقه، حجم عظیمی از درخواستها مستقیماً به سرویسهای بالادستی سرازیر شود.
دریافت پراکنده کد و دریافت مجازیشده نیز از قابلیتهای پایه Scion هستند. کلاینت فقط پوشهها و فایلهای موردنیاز را دریافت میکند و برخی فایلها تا زمانی که واقعاً به آنها دسترسی پیدا نشود، بارگذاری نمیشوند. در وظایفی که صرفاً به فرادادههای کنترل نسخه نیاز دارند، حتی میتوان از ایجاد پوشه کاری نیز صرفنظر کرد.
در نهایت، آنتروپیک گزارش داده است که مصرف پردازنده و حافظه زیرساخت Scion در مقایسه با راهکار قبلی مبتنی بر آینههای گیت حدود ۲۰۰ برابر کاهش یافته، زمان دریافت کد از مقیاس دقیقه به مقیاس ثانیه رسیده و ظرفیت پردازنده موردنیاز CI حدود ۲۵ درصد کمتر شده است.
باید توجه داشت که این ارقام به ابعاد متفاوتی از بهینهسازی اشاره دارند. کاهش ۲۰۰ برابری مربوط به میزان مصرف منابع زیرساختی است، افزایش دو مرتبه بزرگی به سرعت دریافت کد مربوط میشود و رقم ۲۵ درصد نشاندهنده صرفهجویی در ظرفیت CI است. بنابراین، نمیتوان نتیجه گرفت که Scion در تمام عملیات ۲۰۰ برابر سریعتر از گیت است.
۳. هفت نفر، پنج ماه؛ کلود نیز بازطراحی زیرساخت را سرعت بخشید
اگر معماری Scion تغییرات سیستمی ناشی از گسترش استفاده از عاملهای هوش مصنوعی را نشان میدهد، فرایند توسعه آن نیز از تأثیر این عاملها بر شیوه کار سازمانهای مهندسی نرمافزار حکایت دارد.
آنتروپیک اعلام کرده است که Scion و ابزار بازبینی کد همراه آن، Antique، به دست تیمی هفتنفره توسعه داده شدند. این تیم طی پنج ماه، ساخت سامانه و مهاجرت کل مخزن یکپارچه کد شرکت را به پایان رساند و چند سامانه مرتبط دیگر، از جمله جستوجوی کد و مدیریت مجوزها، را نیز تحویل داد.
در این فرایند، کلود بخش زیادی از کار پیادهسازی و بهینهسازی کد را بر عهده داشت.
مطلب رسمی آنتروپیک نمونه مشخصی از این همکاری را شرح میدهد. در مراحل اولیه، خط لوله واردکردن دادههای گیت به Scion عمدتاً بهصورت دستی توسط مهندسان نوشته شده بود و تیم تصور میکرد عملکرد آن از قبل مطلوب است. اما بعداً از نسخه اولیه داخلی Claude Mythos Preview خواستند کل این خط لوله را دوباره پیادهسازی کند.
نسخه جدیدی که کلود تولید کرد، بدون دریافت دستورالعمل تکمیلی، مصرف حافظه را ۲۰ برابر کاهش داد و سرعت اجرا را چهار برابر افزایش داد؛ درعینحال، ترتیب واردکردن دادهها و محدودیتهای مربوط به ساختار داده نسخه اصلی را حفظ کرد.
اهمیت این نمونه در آن است که عاملهای هوش مصنوعی اکنون میتوانند در بهینهسازی عملکرد زیرساختهای پیچیده نیز مشارکت کنند، نه اینکه صرفاً نوشتن توابع کوچک، رابطها یا کدهای مربوط به منطق کسبوکار را بر عهده بگیرند.
بااینحال، آنتروپیک تأکید کرده است که این موضوع به معنای از میان رفتن نقش مهندسان نیست.
اعضای تیم معتقدند کلود در نوشتن کد از خود آنها پیشی گرفته است، اما تصمیمگیریهای مربوط به طراحی در سطح کل سامانه همچنان به مهندسان وابسته است. این تصمیمها شامل درک ارتباط میان اجزای مختلف، ارزیابی بدهبستانهای معماری و تشخیص این موضوع است که کدام مشکلات ارزش حلکردن دارند.
نکته جالبی که در مطلب رسمی شرکت آمده، این است که یکی از وظایف مهم مهندسان، گفتن عبارت «این کار را نکن» به کلود است.
این موضوع به ویژگیهای واقعی پروژه Scion مربوط میشود. میان توان عملیاتی بالا، تأخیر کم، مقیاسپذیری افقی، جداسازی خطاها و سازگاری دادهها، موازنههای پیچیدهای وجود دارد. حتی اگر یک پیادهسازی از کیفیت کد بالایی برخوردار باشد، ممکن است برای نیازهای بلندمدت بهرهبرداری از سامانه مناسب نباشد. مهندسان باید با توجه به معماری کلی و محدودیتهای محیط عملیاتی، تعیین کنند کدام راهکارها قابلقبولاند.
کلود در عملیات روزمره و نگهداری سامانه نیز به کار گرفته میشود. تیم آنتروپیک گروهی از عاملهای کلود را با نام «superfans» ایجاد کرده که هرکدام بر بخش متفاوتی از Scion تمرکز دارند. برای نمونه، یک عامل بهطور مداوم scion-daemon را پایش میکند، عامل دیگری بر scion-cache متمرکز است و عامل اختصاصی دیگری صف ادغام Antique را زیر نظر دارد.
این عاملها میتوانند دادههای تلهمتری و گزارشهای ثبت رویداد را بخوانند، وضعیت سامانه را پیوسته بررسی کنند و ناهنجاریهایی را بیابند که تشخیص آنها با قواعد نظارتی سنتی آسان نیست. آنتروپیک به همین دلیل هشدارهای معمول را حذف نکرده، بلکه از عاملها بهعنوان لایهای تکمیلی برای تحلیل استفاده کرده است.
کلود از پیادهسازی کد و بهینهسازی عملکرد گرفته تا پایش عملیات، در سراسر چرخه مهندسی Scion نقش داشته است.
۴. با کدنویسی مداوم عاملها، حتی CI و قواعد ادغام کد نیز باید از نو طراحی شوند
Scion مشکل مقیاسپذیری سامانه کنترل نسخه را حل میکند، اما آنتروپیک متوجه شده است که بخشهای زیادی از فرایند توسعه نرمافزار بر اساس ریتم کاری مهندسان انسانی شکل گرفتهاند. صف ادغام (Merge Queue) نمونهای از این بخشهاست.
صف ادغام سنتی، ترتیب ورود کد به شاخه اصلی را مدیریت میکند تا سازگاری میان ثبت تغییرات تا حد امکان حفظ شود. همچنین پیش از ادغام، آزمونها را اجرا میکند. این سازوکار خطرهای ناشی از تغییرات همزمان را کاهش میدهد، اما هزینههایی مانند انتظار و هماهنگی را نیز به همراه دارد.
وقتی تعداد ادغامهای کد به دهها هزار مورد در روز میرسد، مسئله پیچیدهتر میشود.
درحالیکه یک آزمون هنوز در حال اجراست، ممکن است صدها یا حتی هزاران تغییر دیگر وارد شاخه اصلی شده باشند. در این شرایط، وضعیت کدی که نتیجه آزمون به آن مربوط است، میتواند تفاوت زیادی با وضعیت فعلی شاخه اصلی داشته باشد. اگر تمام تغییرات الزاماً و بهصورت ترتیبی از یک صف ادغام مشترک عبور کنند، توان عملیاتی سامانه محدود خواهد شد.
آنتروپیک اعلام کرده است که تیم هنوز راهکار مؤثری برای پیادهسازی صف ادغام مبتنی بر قفل سراسری مخزن، که در صنعت رایج است، در چنین مقیاسی پیدا نکرده است. به همین دلیل، منابع بیشتری را به آزمون پس از ادغام و آزمون خودکار پیش از استقرار اختصاص داده است.
این رویکرد به این معناست که برخی تعارضهای ناشی از تغییرات همزمان ممکن است تنها پس از ادغام شناسایی شوند. آنتروپیک معتقد است کلود معمولاً میتواند این تعارضها را سریعتر از مهندسان انسانی برطرف کند.
بااینحال، این روش مسائل مهندسی تازهای نیز ایجاد میکند.
وقتی کد ادغامشده ممکن است حاوی تعارضهای کشفنشده باشد، تیم چگونه میتواند از در دسترس و قابلاستفاده بودن شاخه اصلی اطمینان حاصل کند؟ چه تقسیم کاری باید میان آزمون پس از ادغام و آزمون پیش از استقرار وجود داشته باشد؟ اگر چند عامل بهطور پیوسته یک مجموعه از فایلهای مشترک را تغییر دهند، چگونه میتوان دامنه گسترش خطا را کنترل کرد؟
مطلب آنتروپیک راهکارهای این مشکلات را بهطور کامل تشریح نمیکند و اطلاعاتی نیز درباره نرخ نقص، نرخ بازگردانی تغییرات یا رخدادهای عملیاتی پس از اجرای فرایند جدید ارائه نمیدهد. بنابراین، در حال حاضر میتوان تأیید کرد که آنتروپیک سازوکار ادغام و اعتبارسنجی کد را تغییر داده است، اما هنوز مشخص نیست که این الگو از نظر کیفیت و قابلیت اطمینان، در مجموع بهتر از فرایند سنتی عمل میکند یا خیر.
با وجود این، این تغییر همچنان قابلتوجه است. در گذشته، زیرساخت مهندسی نرمافزار عمدتاً حول فرایندی شکل میگرفت که در آن توسعهدهندگان کد را ارسال میکردند، آزمونها اجرا میشدند، بررسی کد در انتظار میماند و سپس تغییرات ادغام میشدند. با برعهده گرفتن بخش بیشتری از کار توسعه توسط عاملهای هوش مصنوعی، تولید و ارسال کد ممکن است به فعالیتی پیوسته در پسزمینه تبدیل شود. در چنین شرایطی، سامانههای کنترل نسخه، CI، بازبینی کد و انتشار نرمافزار همگی باید خود را با الگوهای جدید حجم کاری و اجرای همزمان تطبیق دهند.
آیا گیت جایگزین خواهد شد؟ خود آنتروپیک هم چنین اعتقادی ندارد
وقتی آنتروپیک سامانه کنترل نسخه خود را از نو میسازد، ممکن است برخی به این نتیجه برسند که در عصر عاملهای برنامهنویسی، گیت بهتدریج کنار گذاشته خواهد شد.
اما آنتروپیک به چنین نتیجهای نرسیده است.
در واقع، شرکتهای بزرگ فناوری مدتهاست برای مدیریت مخازن یکپارچه بسیار بزرگ، سامانههای کنترل نسخه اختصاصی توسعه میدهند.
گوگل از سامانه کنترل نسخه متمرکز داخلی خود، Piper، استفاده میکند و متا نیز مدتهاست روی Sapling کار میکند. متا هنگام معرفی عمومی Sapling در سال ۲۰۲۲ توضیح داد که سامانههای کنترل نسخه متنباز سنتی نمیتوانند نیازهای مخازن بسیار بزرگ این شرکت را که میلیونها فایل و ثبت تغییرات دارند، برآورده کنند. Sapling با استفاده از سازوکارهایی مانند سرورهای اختصاصی، سامانه فایل مجازی و دریافت تاریخچه در زمان نیاز، مشکل مقیاسپذیری را حل میکند و درعینحال قابلیت تعامل با مخازن گیت را حفظ میکند.