
یادگیری ماشین برای عیبیابی قابلیت اطمینان
این مقاله روشی تحلیلی و ساختاریافته برای تشخیص تغییرپذیری عملکرد و رفتار مرتبط با قابلیت اطمینان در توربینهای گازی LM6000 جنرال الکتریک (GE) ارائه میکند. در این روش، دادههای عملیاتی سری زمانی با غربالگری آماری، تحلیل مبتنی بر نظریه اطلاعات و تکنیکهای یادگیری ماشین ترکیب میشوند تا متغیرهای کلیدی مؤثر بر عملکرد توربین در شرایط کاری متفاوت شناسایی شوند.
در این مطالعه، دو توربین گازی مشتقشده از موتورهای هواپیما، از نوع LM6000، که در دو محل متفاوت فعالیت میکنند، بررسی شدهاند تا تفاوتهای ویژگیهای عملیاتی، پاسخ دینامیکی و تعامل میان متغیرها مشخص شود. مجموعهای مشخص از متغیرهای فرایندی و کنترلی، از جمله توان توربین، دبی سوخت، فشار خروجی کمپرسور، موقعیت اجزای هندسه متغیر، شرایط ورودی و پارامترهای محیطی، برای تشکیل مجموعهدادهای چندبعدی و نماینده شرایط کار توربین به کار رفتهاند.
این روش بر تفکیک تعامل میان متغیرها، شناسایی رفتار سیستم پیش از وقوع رویداد و تشخیص رژیمهای کاری مختلف تمرکز دارد تا تفسیر پویاییهای پیچیده سیستم آسانتر شود. برای بررسی همبستگیهای خطی از تحلیل همبستگی استفاده شده و سپس آنتروپی انتقال به کار رفته است تا وابستگیهای جهتدار و غیرخطی میان متغیرها شناسایی شوند. همچنین، اقداماتی برای رفع چالشهای رایج در مجموعهدادههای پربُعد، از جمله افزونگی ویژگیها و نشت داده، در نظر گرفته شده است.
هدف این پژوهش نشان دادن چگونگی استفاده از چارچوبی دادهمحور و مبتنی بر دانش فیزیکی در ماشینهای توربوماشینی است؛ چارچوبی که میتواند شناسایی عوامل اصلی عملکرد را بهبود دهد و فرایندهای عیبیابی را کارآمدتر کند. در این تحلیل، میزان سازگاری یافتههای حاصل از دادهها با ارزیابیهای مستقل سازنده اصلی تجهیزات (OEM) نیز بررسی میشود تا اعتبار روش از جنبه دیگری تأیید شود.
آشنایی با توربینهای گازی
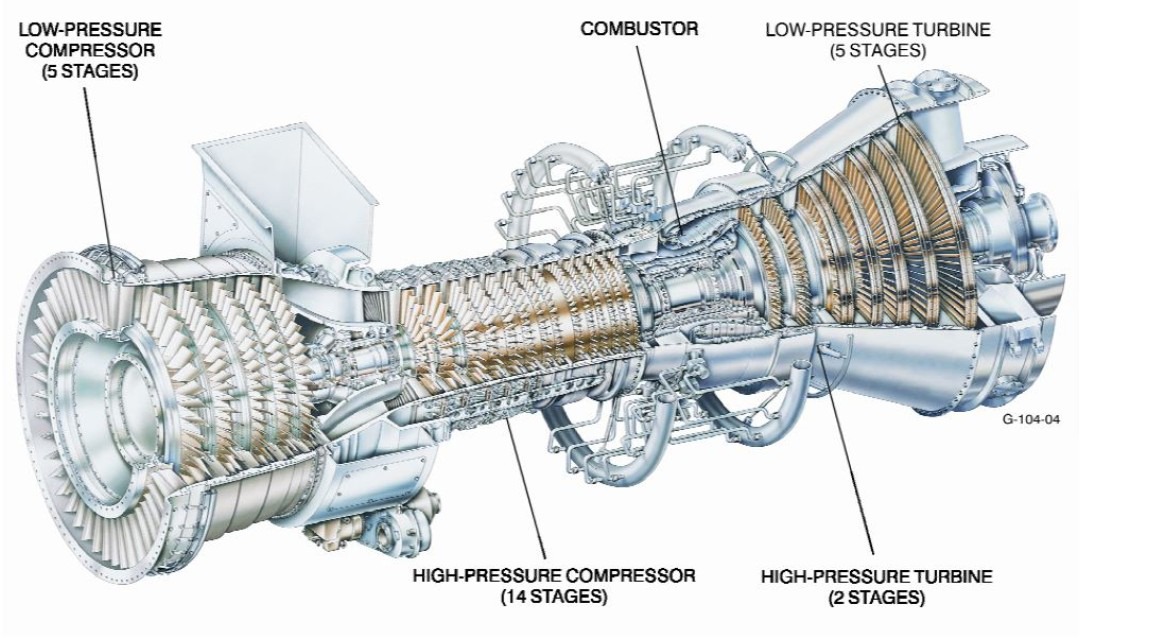
شکل ۱ نمایی کلی از ساختار توربین گازی LM6000 ارائه میدهد و زمینه فیزیکی لازم را برای تحلیلهای دادهمحور و یادگیری ماشین در بخشهای بعدی فراهم میکند. بررسی مختصر تاریخچه موتورهای توربین گازی LM6000 جنرال الکتریک نشان میدهد که این ماشینها سامانههایی پیچیده، مهندسیشده و پربازده هستند. این موتورها از نوع مشتقشده از موتورهای هواپیما، با انتقال مستقیم توان و سوخت گازیاند. بهطور مشخص، LM6000 از موتور هواپیمای CF6-80C2، یک موتور توربوفن با ضریب کنارگذر بالا، مشتق شده است.
در این موتورها، اتصال مکانیکی برقرار است، نه اتصال آیرودینامیکی، و اجزا روی یک محور مشترک کار میکنند. به بیان دقیقتر، موتور دارای توربین آزاد تولید توان است که از طریق اتصال مکانیکی به ژنراتور متصل میشود. نویسنده میخواهد بر تفاوت این آرایش با توربینهای دارای اتصال آیرودینامیکی تأکید کند. در نوع دوم، بار محرک میتواند از طریق مسیر گاز بر عملکرد کمپرسور اثر بگذارد، نه از طریق یک محور مکانیکی. اما در LM6000، تأثیر بار از مسیر گاز اعمال نمیشود، بلکه از طریق سازوکار مکانیکی منتقل میشود؛ به همین دلیل، این سامانه دارای اتصال مکانیکی است.
در چنین سامانهای، تغییر بار بلافاصله نقطه کار موتور یا حاشیه پایداری در برابر واماندگی کمپرسور را جابهجا نمیکند، زیرا عملکرد کمپرسور مستقیماً به بار وابسته نیست؛ این موضوع از جمله تفاوتهای مهم این آرایش است. این تمایز اهمیت دارد، زیرا مقاله تغییرات توان و اثر آنها را با استفاده از مدلهای یادگیری ماشین بررسی میکند. وجود توربین آزاد تولید توان، مبنای مناسبی برای این فرض فراهم میکند که رفتار کمپرسور و حاشیه پایداری آن را میتوان مستقل از بار ژنراتور تحلیل کرد؛ هرچند اثر بار ممکن است بهطور غیرمستقیم و از طریق فشار برگشتی اگزوز وارد شود.
هدف مقاله جایگزین کردن دانش طراحی و بهرهبرداری از توربین LM6000 نیست. تمرکز آن بر این است که یادگیری ماشین، تحلیل دادهها و استفاده از عاملهای نرمافزاری چگونه میتوانند زمان ارزیابی دادهها را کاهش دهند و به شناسایی سریعتر متغیرهایی کمک کنند که از وضعیت عادی منحرف میشوند و احتمال بروز مشکل را در موتوری پیچیده مانند LM6000 افزایش میدهند.
روششناسی یادگیری ماشین
یک خط لوله تحلیل و ارزیابی قابلیت اطمینان مبتنی بر پایتون برای پردازش و تحلیل دادههای سری زمانی توربینها توسعه داده شد. این بخش روشهای پایه تحلیل داده و یادگیری ماشین را توضیح میدهد؛ برای آشنایی عمیقتر با الگوریتمهای مشخص و جزئیات پیادهسازی، مطالعه منابع تکمیلی توصیه میشود. ساختار این خط لوله بر یک متغیر هدف مشخص، یعنی توان توربین، استوار است و در کنار آن از سرعت دورانی روتور (RPM) برای شناسایی و توصیف رویدادهای توقف ناگهانی توربین استفاده میشود. تحلیل اولیه با غربالگری ارتباطها و ارزیابی روابط خطی از طریق همبستگی آغاز میشود. سپس، پس از گسستهسازی دادهها، آنتروپی انتقال برای شناسایی وابستگیهای جهتدار و غیرخطی به کار میرود. ترکیب این روشها درک جامعتری از تعامل متغیرها، فراتر از همبستگی ساده، فراهم میکند.
در مرحله بعد، رویدادها شناسایی میشوند تا توقفهای ناگهانی توربین و نوسانهای توان مشخص شوند. در دورههایی که توقف رخ نمیدهد، تحلیل بر انحرافهای رفتار توان متمرکز است. برای تعیین عوامل مؤثر بر این رویدادها، متغیرها در بازههای زمانی مشخص پیش از وقوع رویداد بررسی میشوند تا رفتار سیستم در فاصله کوتاه پیش از توقف یا نوسان ثبت شود. در این روش، ویژگیهای آماری در بازههای زمانی گسسته، از جمله میانگین، انحراف معیار و روندهای خطی یا شیب تغییرات، ارزیابی میشوند تا رفتار متغیرها پیش از رویداد توصیف شود. این تحلیل امکان شناسایی ویژگیهایی را فراهم میکند که احتمال ارتباط آنها با پیامدهای مشخص بیشتر است.
برای ارزیابی اهمیت ویژگیها و شناسایی متغیرهایی که بیشترین ارتباط را با توقفها و نوسانهای توان دارند، از طبقهبندی جنگل تصادفی (Random Forest) استفاده شد. همچنین، هرجا امکانپذیر بود، از روش توضیحات افزایشی شاپلی (SHAP) برای تفسیر بهتر خروجی مدلها بهره گرفته شد. رویدادهای نوسان توان بهصورت مواردی تعریف شدند که در آنها متغیر هدف بیش از ±X درصد از خط مبنای میانه متحرک فاصله میگیرد. رویداد توقف نیز بهصورت گذار به وضعیتی تعریف شد که سرعت دورانی به کمتر از یک آستانه مشخص برسد؛ مقدار پیشفرض این آستانه صفر یا کمتر از صفر (≤۰) بود. زمان رویداد، نخستین لحظهای در نظر گرفته شد که شرط ورود به وضعیت توقف برقرار میشد.
برای هر رویداد شناساییشده، ویژگیها از پنجرهای پیش از رویداد با طول W نمونه استخراج شدند. در این مرحله، برای جلوگیری از نشت داده دقت شد؛ نشت داده زمانی رخ میدهد که متغیرهایی که مستقیماً تعریف رویداد را رمزگذاری میکنند، ناخواسته وارد مدل شوند. برای مثال، چون توقف با افت سرعت دورانی تعریف میشود، استفاده از ویژگیهای مشتقشده از RPM میتواند رویداد را بهصورت بدیهی پیشبینی کند، بیآنکه بینش معناداری درباره عوامل مؤثر فراهم شود. برای جلوگیری از این مشکل، ویژگیهای مهندسیشده مشتقشده از RPM از مدلهای پیشبینی توقف حذف شدند و ویژگیهای مشتقشده از متغیر هدف نیز در مدلهای پیشبینی نوسان توان به کار نرفتند.
با توجه به تعداد زیاد متغیرها در سامانههای پیچیدهای مانند LM6000، شناسایی رژیمهای کاری برای درک این موضوع ضروری است که آیا ناهنجاریها یا توقفها با شرایط مشخصی ارتباط دارند یا خیر. در این مطالعه، رژیمهای کاری با استفاده از خوشهبندی میانگینهای K (k-means) و بر مبنای زیرمجموعهای از متغیرهای فرایندی دارای واریانس بالا شناسایی شدند. پیش از خوشهبندی، متغیرها استانداردسازی و مقادیر گمشده با میانگین جایگزین شدند. سپس، مرکز خوشههای حاصل دوباره به واحدهای مهندسی تبدیل شد تا تفسیر آنها آسانتر باشد.
تحلیل دادهها و مهندسی ویژگیها
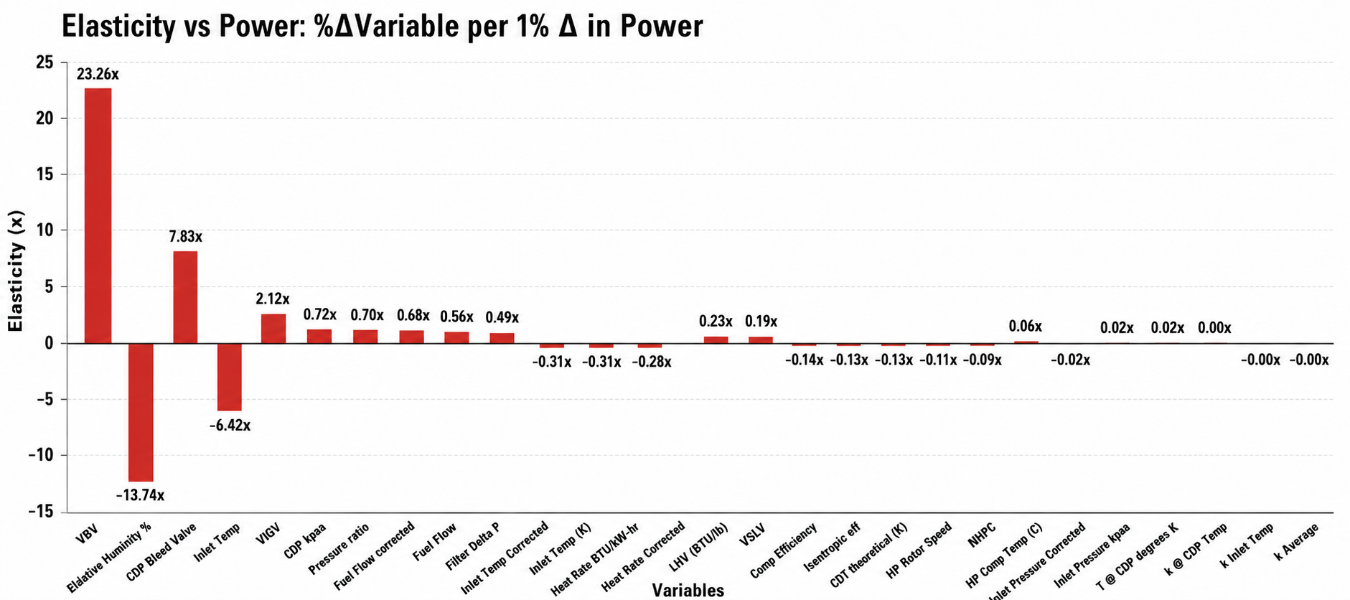
بررسی کشسانی متغیرهای کلیدی میتواند به درک بهتر این موضوع کمک کند که کدام متغیرها با تغییر درصدی یک متغیر مشخص ارتباط دارند؛ شکل ۲ این موضوع را نشان میدهد. در این شکل، اثر ویژگیهای مختلف، از جمله شیرهای تخلیه متغیر (VBV)، رطوبت نسبی و دمای هوای ورودی، بر تغییر یکدرصدی توان نمایش داده شده است. این اطلاعات به محدود کردن دامنه ویژگیهای کلیدی و ارزیابی اثر آنها بر متغیر مورد مطالعه کمک میکند و در نتیجه، انتخاب مناسبترین ویژگیها برای ورود به الگوریتمهای یادگیری ماشین را آسانتر میسازد. همچنین، میتوان با این تحلیل تشخیص داد کدام متغیرها بهطور فعال در پاسخ به تغییرات واکنش نشان میدهند و کدام متغیرها تحت کنترل قرار دارند.
البته، این نتایج به معنای آن نیست که یک متغیر مشخص علت نوسان توان است؛ بلکه نشان میدهد آن متغیر در واکنش به تغییر توان چگونه رفتار میکند. در مرحله بعد، طبقهبندهای جنگل تصادفی برای تمایز میان شرایط پیش از رویداد و عملکرد عادی آموزش داده شدند. متغیرهای اثرگذار بر اساس معیارهای اهمیت ویژگی و، در صورت دسترسی، میانگین قدرمطلق مقادیر انتساب SHAP رتبهبندی شدند. همچنین، مسیر تغییرات متغیرها همتراز با زمان وقوع رویداد ترسیم شد تا تحول ویژگیهای کلیدی در فاصله منتهی به رویداد قابل مشاهده باشد.
باید توجه داشت که همبستگی به معنای رابطه علت و معلولی نیست. نقشههای حرارتی همبستگی در شناخت ارتباطهای خطی مفیدند، اما آنتروپی انتقال جریان اطلاعات جهتدار میان متغیرها را اندازهگیری میکند و به تفسیر دقیقتر روابط بالقوه علّی کمک میکند. هر دو روش در مهندسی ویژگیها و ارزیابی کلان سیستم نقش مهمی دارند.
برای مقایسه همبستگی میان متغیرهای مختلف دو توربین 1A و 1B، نقشه حرارتی همبستگی نیز تهیه شد. این مقایسه بینش بیشتری درباره نحوه تعامل متغیرها فراهم میکند و در کنار تحلیل کشسانی شکل ۲ قرار میگیرد. از آنجا که درک رابطههای علّی، علاوه بر همبستگی، اهمیت دارد، از آنتروپی انتقال و ابزارهای دیگر تحلیل داده نیز استفاده شده است. شکل ۳ مقایسهای از شاخصهای کلیدی دو توربین ارائه میدهد. در این تحلیل، آنتروپی انتقال معیاری از تأثیرگذاری جهتدار میان متغیرها فراهم میکند و بهعنوان شاخصی تقریبی برای بررسی روابط علّی در سیستم به کار میرود. برخلاف نقشههای حرارتی همبستگی که فقط ارتباطهای خطی را ثبت میکنند، آنتروپی انتقال جریان اطلاعات میان متغیرها را ارزیابی میکند و قادر است روابط غیرخطی و جهتدار را نیز شناسایی کند.
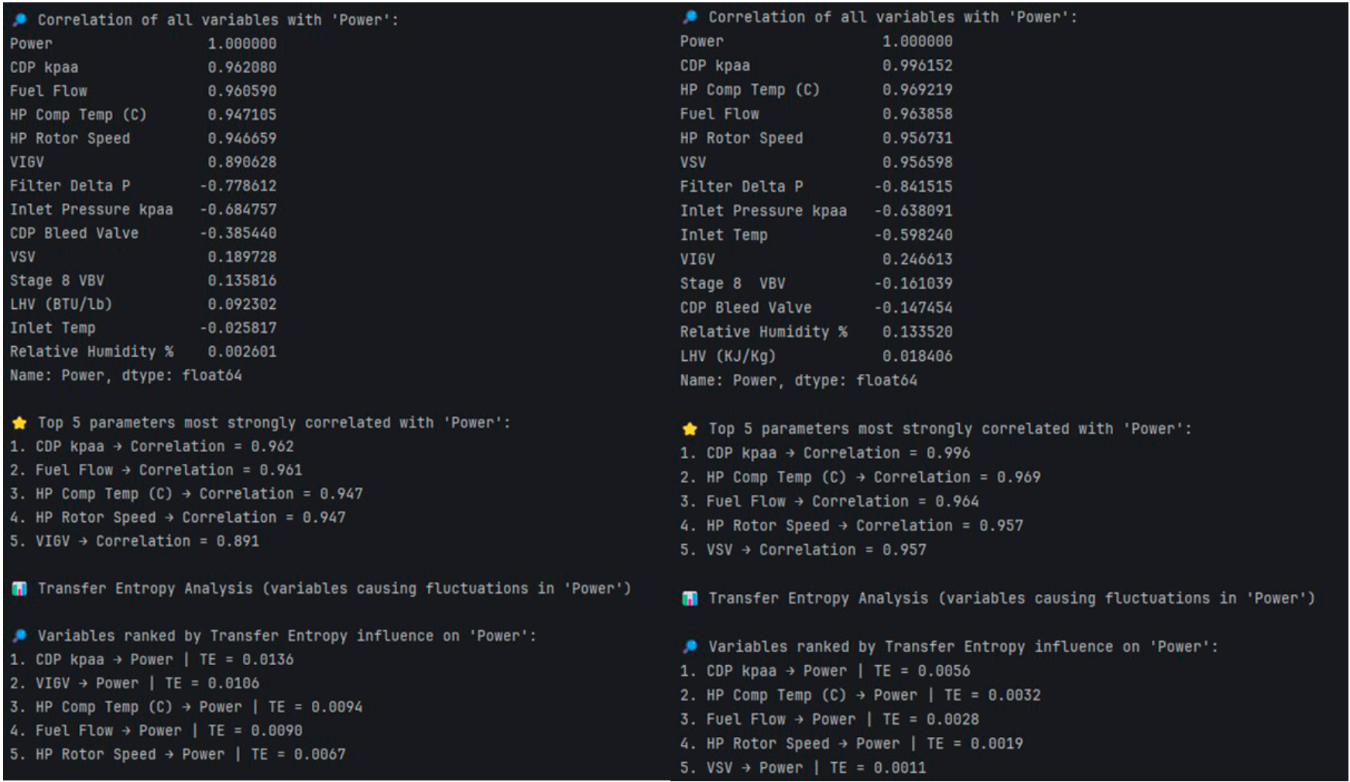
بر اساس این تحلیل، در شرایط کاری بررسیشده، موقعیت پرههای راهنمای ورودی متغیر (VIGV) در توربین 1A نسبت به توربین 1B تأثیر بیشتری بر توان دارد. این یافته نشان میدهد که رفتار VIGV در تغییرپذیری توان توربین 1A نقش مهمتری ایفا میکند و بررسی بیشتر پاسخ سامانه کنترل، وضعیت مکانیکی یا راهبرد بهرهبرداری این توربین را بهعنوان مسیرهای احتمالی پیگیری مطرح میسازد.
اعتبارسنجی مهندسی و کاربرد عملی
یکی از جنبههای مهم تحلیل دادههای پیچیده توربوماشینها، تقسیم شرایط کاری به رژیمهای متمایز است. با تفکیک مجموعهداده به رژیمهای نماینده، میتوان بهتر تشخیص داد که سیستم عمدتاً در چه شرایطی کار میکند و رویدادهای توقف یا ناهنجاری در چه وضعیتهایی رخ میدهند. توصیه سازنده اصلی تجهیزات بر اساس بررسی یکی از توربینها این بود که شستوشوی آبی انجام شود. با این حال، پایش پارامترهای کلیدی کمپرسور، مانند هد پلیتروپیک و بازده، میتواند بهسرعت مشخص کند که آیا عملکرد کمپرسور رو به افت است و آیا واقعاً به اقداماتی مانند شستوشوی آبی نیاز دارد یا خیر. در این مورد، شستوشوی آبی به تعویق افتاد، زیرا هد و بازده کمپرسور نشانهای از وجود مشکل ناشی از تجمع رسوبات در مسیر گاز کمپرسور نشان نمیدادند.
تفکیک رژیمهای کاری چارچوبی فشرده برای شناسایی محدودههای عملکردی مرتبط با رفتار غیرعادی فراهم میکند و به تحلیل ریشهای مؤثرتر و هدفمندتر کمک میرساند. نقشههای رژیم کاری، محدودههایی را که رفتار غیرعادی در آنها رخ میدهد بهشکلی روشن نمایش میدهند و از این طریق، تحلیل علت ریشهای را بهبود میبخشند. برای مثال، ممکن است انتشار اکسیدهای نیتروژن (NOX) تنها در رژیمهای کاری مشخصی افزایش یابد. در چنین شرایطی، بهتر است مسئله بهصورت یک وظیفه طبقهبندی تعریف شود؛ یعنی شرایطی شناسایی شوند که در آنها انتشار NOX بالا میرود، نه اینکه مدل صرفاً مقادیر دقیق آلایندگی را با روش رگرسیون پیشبینی کند. این رویکرد امکان شناسایی روشنتر شرایط عملیاتی منجر به افزایش ناگهانی آلایندگی را فراهم میکند؛ وضعیتی که ممکن است به کاهش بار توربین و افت توان خروجی بر حسب مگاوات بینجامد.
در کاربردهای عملی یادگیری ماشین روی مجموعهدادههای پربُعد توربوماشینها، عملکرد مدلهایی مانند جنگل تصادفی یا XGBoost ممکن است هنگام ارزیابی با معیارهای رگرسیونی نظیر ضریب تعیین (R2) یا میانگین مربعات خطا (MSE) ضعیف به نظر برسد. این وضعیت اغلب ناشی از ضعف خود الگوریتمها نیست، بلکه میتواند به عواملی مانند تعداد زیاد ویژگیها، افزونگی ویژگیها یا نشت داده مربوط باشد. گاهی متغیرهایی که رفتار هدف را مستقیماً رمزگذاری میکنند، خروجی مدل را سوگیرانه میسازند؛ در مقابل، حذف متغیرهای کلیدی مبتنی بر فیزیک ممکن است توانایی مدل در بازنمایی پویایی سیستم را محدود کند. بنابراین، لازم است هدف تحلیل بهروشنی تعریف و چارچوب مدلسازی متناسب با آن انتخاب شود.
هنگامی که هدف، شناسایی شرایط مرتبط با رویدادهایی مانند افزایش انتشار NOX یا نوسان توان است، روشهای مبتنی بر طبقهبندی اغلب مناسبترند. در چنین مواردی، معیارهایی مانند مساحت زیر منحنی مشخصه عملکرد گیرنده (ROC-AUC) یا مساحت زیر منحنی دقت ـ بازخوانی (PR-AUC) ارزیابی نمایندهتری از اثربخشی مدل ارائه میدهند تا معیارهای سنتی رگرسیون.
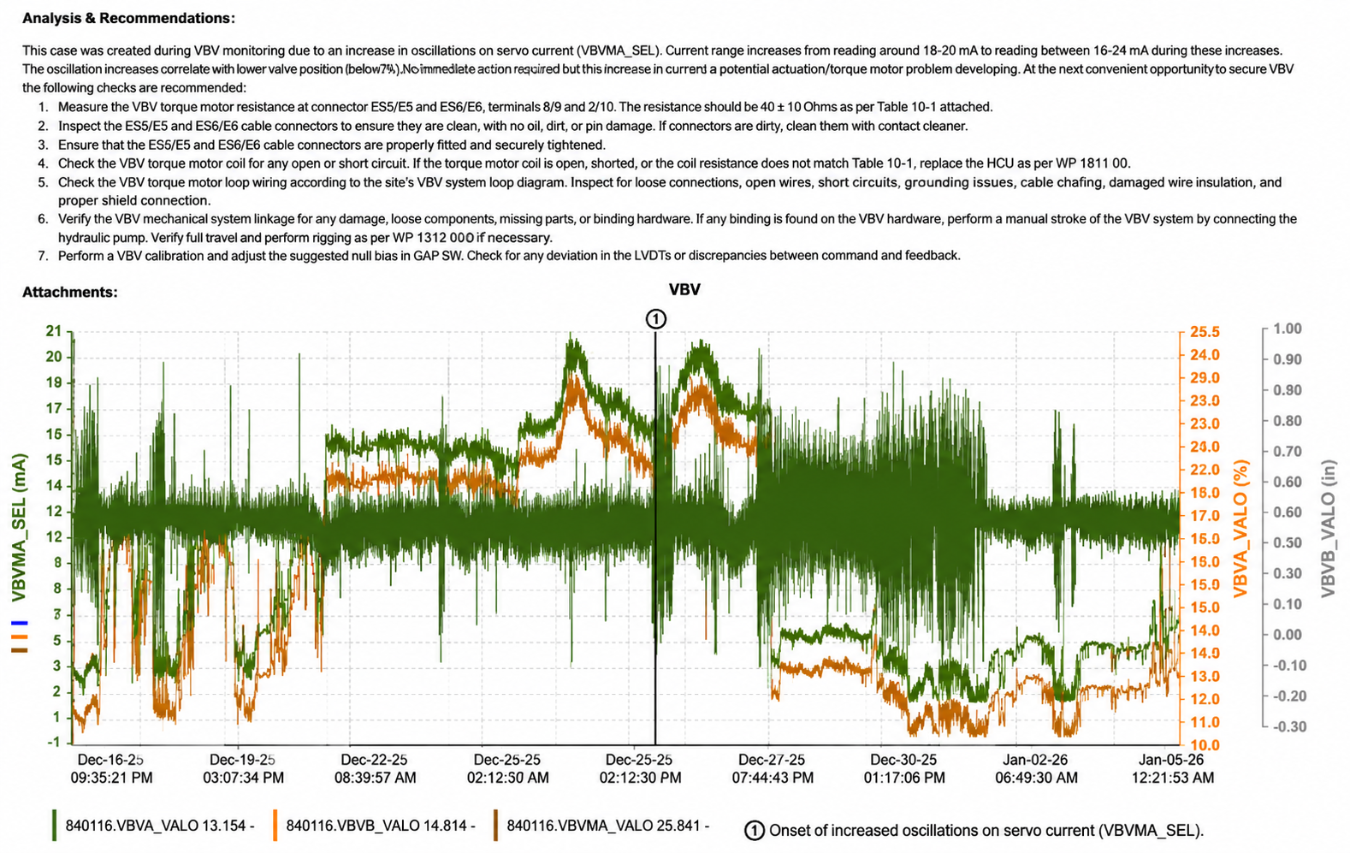
اگر مدلهای یادگیری ماشین بهدرستی طراحی شوند، میتوان از آنها برای اندازهگیری اهمیت نسبی متغیرها و سهم هر یک در پیامدهای مشخص استفاده کرد. نتایج شکل ۴ نشان میدهد که با وجود ابعاد بالای مجموعهداده، رفتار منجر به توقف ناگهانی توربین تحت تأثیر شمار محدودی از متغیرها قرار دارد. همین روش را میتوان برای رویدادهای نوسان توان نیز به کار گرفت تا عوامل غالب شناسایی شوند. نکته مهم این است که متغیرهای شناساییشده در این تحلیل با یافتههای بررسی مستقلی که سازنده اصلی تجهیزات انجام داده است، همخوانی دارند؛ بررسیای که نگرانیهایی را درباره عملکرد شیر تخلیه متغیر (VBV) مطرح کرده بود. شواهد تکمیلی مربوط به رفتار VBV، از جمله پاسخ نوسانی مشاهدهشده در سامانه کنترل، در شکل ۵ ارائه شده است. سازگاری میان تحلیل دادهمحور و عیبیابی سازنده، اعتبار چارچوب تحلیلی را تقویت میکند و مبنایی برای اقدامات بعدی هدفمند، مانند ارزیابی سامانه کنترل یا بازرسی قطعات، فراهم میآورد.
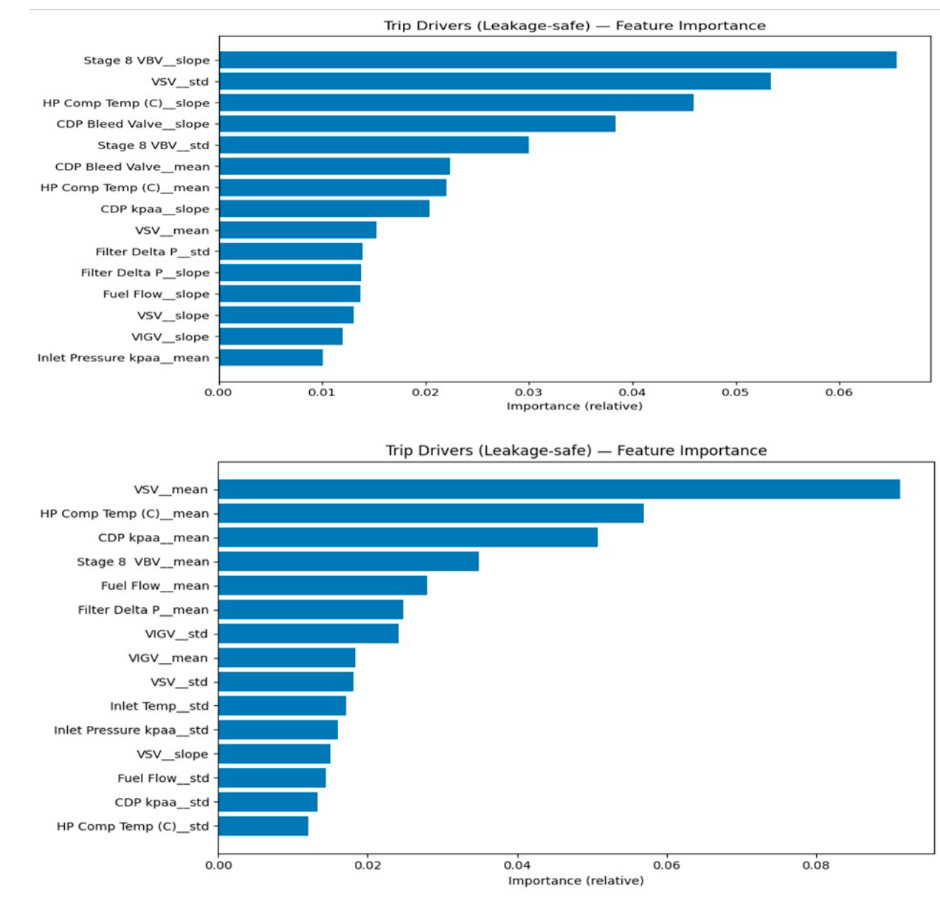
مقایسه ویژگیهای مؤثر در دو توربین همچنین نشان میدهد که حتی در شرایط کاری مشابه، میزان تأثیر متغیرها در واحدهای مختلف یکسان نیست. تفاوت در اهمیت نسبی پارامترهایی مانند موقعیت VIGV و متغیرهای مرتبط با کمپرسور، بر رفتار ویژه هر واحد تأکید دارد و نشان میدهد که تحلیل هر توربین باید بهصورت مستقل انجام شود، نه بر اساس فرضهای کلی. تحلیلهای تکمیلی، از جمله بررسی حساسیت یا کشسانی، میتوانند پاسخ متغیرهای سیستم به تغییر توان توربین را کمّی کنند. این روشها نشان میدهند که اختلالات چگونه در سیستم منتشر میشوند و به ارزیابی حاشیههای پایداری و سازوکارهای افت عملکرد کمک میکنند.
از نظر بهرهبرداری و اقتصاد، اگر مشکلات عملکردی در سامانههای پیچیدهای مانند LM6000 بهموقع شناسایی و رفع نشوند، ممکن است زیان مالی قابلتوجهی به بار آورند. برای مثال، افزایش انتشار NOX ممکن است کاهش بار توربین را ضروری کند و مستقیماً توان خروجی را پایین بیاورد. از آنجا که هر مگاوات تولید برق ظرفیت درآمدزایی دارد، حتی کاهش اندک توان نیز در دورههای طولانی بهرهبرداری میتواند به زیان انباشته قابلتوجهی منجر شود.
برای نمونه، کاهش پایدار یک مگاوات از توان تولیدی، با فرض قیمت برق ۷۵ دلار آمریکا بهازای هر مگاواتساعت، حدود ۷۵ دلار در ساعت یا نزدیک به ۶۵۰ هزار دلار در سال هزینه فرصت ایجاد میکند. بنابراین، از دست رفتن چند مگاوات توان در هر ماه میتواند بهراحتی میلیونها دلار درآمد ازدسترفته به همراه داشته باشد؛ هزینه تعمیرات نیز جدا از این مبلغ است. این برآورد ساده عواملی مانند کاهش بهرهوری مصرف سوخت، جریمههای قراردادی یا نوسانهای بازار را در نظر نمیگیرد؛ عواملی که میتوانند اثر کلی را بیشتر کنند. در عمل، اگر تمام ملاحظات عملیاتی و تجاری لحاظ شوند، هزینه افت عملکرد ممکن است بهمراتب بیشتر باشد.
روش ارائهشده در این پژوهش برای بهینهسازی آلایندگی یک توربین گازی LM6000 نیز به کار گرفته شده است. در این کاربرد، با استفاده از رویکردی مشابه در یادگیری ماشین که دادهمحوری را با دانش فیزیکی ترکیب میکند، منیفولد سوخت توربین B بهعنوان عامل اصلی افزایش انتشار NOX شناسایی شد. بر اساس این یافتهها، سازنده اصلی تجهیزات با هدایت فنی نویسنده، نقشه سوخترسانی را بیشتر بررسی و تنظیم کرد. در نتیجه، انتشار NOX از حدود ۱۳ قسمت در میلیون به حدود ۱۰ قسمت در میلیون کاهش یافت، بیآنکه عملکرد توربین افت کند. سازنده سپس نقشه اصلاحشده سوخت را تأیید کرد. این نتیجه نشان میدهد که تحلیل دادهمحور، در صورت همراهی با تخصص مهندسی و همکاری با سازنده تجهیزات، میتواند به بهبودهای قابلاندازهگیری در عملکرد آلایندگی و بهرهوری عملیاتی منجر شود.
جمعبندی
نتایج این مطالعه بر اهمیت شناسایی زودهنگام انحرافهای عملکردی و ارزیابی نظاممند متغیرهای مؤثر تأکید میکنند. چارچوب تحلیلی ارائهشده امکان اولویتبندی عوامل کلیدی را فراهم میسازد و به بررسی متمرکزتر رفتار توربین کمک میکند. با این حال، اجرای این روشها مستلزم توجه دقیق به انتخاب ویژگیها، ساختار مدل و راهبرد اعتبارسنجی است. فرضهای نادرست یا مدلسازی ضعیف میتوانند به تفسیرهای گمراهکننده منجر شوند. ازاینرو، تکنیکهای یادگیری ماشین باید در کنار دانش مهندسی تثبیتشده به کار گرفته شوند تا نتایج از نظر فیزیکی معنادار و در زمینه بهرهبرداری از توربوماشینها قابل استفاده باشند.
نوشته اومیت باچو، شرکت پایپلاین پمبینا (Pembina Pipeline Corp.)