
کلود هایکو ۵.۵؛ قابلیتهای جدید و راهکار استفاده از آن برای اجرای سریع و کمهزینه گردشکارهای هوش مصنوعی
شرکت آنتروپیک در ۷ اکتبر ۲۰۲۶ مدل کلود هایکو ۵.۵ را عرضه کرد و آن را ارزانترین، سریعترین و توانمندترین مدل کوچک خود معرفی کرد. شناسه این مدل در API برابر با claude-haiku-5-5 است. برای درخواستهایی با حداکثر ۱۰۰ هزار توکن، هزینه هر یک میلیون توکن ورودی ۰٫۱۰ دلار و هر یک میلیون توکن خروجی ۰٫۵۰ دلار است. در این مقاله، تغییرات هایکو ۵.۵ نسبت به نسخه ۴.۵، روش ساخت گردشکارهای سریع و کمهزینه هوش مصنوعی با پایتون و کاربردهایی مانند دستهبندی، استخراج اطلاعات و استفاده از عاملهای فرعی بررسی میشود. همچنین توضیح داده میشود که در چه شرایطی انتخاب مدل بزرگتر کلود همچنان مناسبتر است.
آنتروپیک هایکو ۵.۵ را برای کارهای پرتعداد و حساس به هزینه، مانند خلاصهسازی، فشردهسازی محتوا، پرسوجو از پایگاههای داده و دستهبندی اطلاعات، پیشنهاد میکند. این مدل همچنین میتواند در کنار اوپوس ۵.۵ و سونت ۵.۵ نقش عامل فرعی را بر عهده بگیرد. هایکو ۵.۵ از طریق پلتفرم کلود، خدمات وب آمازون (AWS)، گوگل کلود و مایکروسافت آژور در دسترس است. ارزیابیهای ایمنی آن در سند فنی و ارزیابیهای سیستم منتشر شدهاند. بر اساس صفحه آنتروپیک درباره پایان پشتیبانی مدلها، زودترین تاریخ بازنشستگی این مدل ۷ اکتبر ۲۰۲۷ است.
چه چیزهایی نسبت به هایکو ۴.۵ تغییر کرده است؟
| ویژگی | هایکو ۴.۵ | هایکو ۵.۵ |
|---|---|---|
| پنجره زمینه | ۲۰۰ هزار توکن | یک میلیون توکن |
| حداکثر خروجی | ۶۴ هزار توکن | ۱۲۸ هزار توکن |
| کنترل فرایند استدلال | تعیین دستی بودجه استدلال | استدلال تطبیقی با امکان تنظیم سطح تلاش؛ نخستین بار در خانواده هایکو |
| هزینه هر یک میلیون توکن برای درخواستهای حداکثر ۱۰۰ هزار توکنی؛ ورودی و خروجی | ۱٫۰۰ و ۵٫۰۰ دلار | ۰٫۱۰ و ۰٫۵۰ دلار |
| هزینه برای درخواستهای بیش از ۱۰۰ هزار توکن | ۱٫۰۰ و ۵٫۰۰ دلار | ۰٫۵۰ و ۲٫۵۰ دلار |
| حداقل اندازه درخواست قابل ذخیره در حافظه نهان | ۴۰۹۶ توکن | ۵۱۲ توکن |
| امتیاز GDPval-AA در کارهای دانشی | ۷۳۵ | ۱۶۲۰ |
| امتیاز OSWorld 2.1 در بخش آفلاین، برای کار با رایانه | ۱۵٫۷٪ | ۷۲٫۴٪ |
| امتیاز آزمون Humanity’s Last Exam بدون ابزار | ۱۰٫۲٪ | ۴۵٫۹٪ |
| امتیاز Terminal-Bench 4.0 در برنامهنویسی عاملمحور | ۰٫۰٪ | ۳۹٫۲٪ |
اعداد مربوط به آزمونهای عملکرد در جدول، نتایج منتشرشده از سوی خود آنتروپیک هستند. صفحه معرفی مدل نشان میدهد که سونت ۵.۵ در هر چهار آزمون عملکرد بهتری دارد؛ برای مثال، امتیاز آن در Terminal-Bench 4.0 برابر با ۷۰٫۶ درصد است. در عمل، کاهش هزینه ممکن است به اندازه تفاوت قیمتهای فهرستشده نباشد. هایکو ۵.۵ از توکنساز جدیدتری استفاده میکند و در نتیجه، همان متن تقریباً ۳۰ درصد توکن بیشتری تولید میکند. آنتروپیک با در نظر گرفتن تفاوت توکنساز و این واقعیت که ۱۰ درصد درخواستها از ۱۰۰ هزار توکن فراتر میروند، میانگین صرفهجویی را حدود ۷۵ درصد برآورد میکند.
سه تغییر ممکن است باعث از کار افتادن کدهای فعلی مبتنی بر هایکو ۴.۵ شوند. طبق مستندات قابلیتهای جدید، ارسال پارامترهای temperature، top_p یا top_k خطا ایجاد میکند؛ پایان دادن پیامها با پیشپرکردن پاسخ دستیار نیز به خطا میانجامد؛ و استفاده از استدلال دستی همراه با budget_tokens پذیرفته نمیشود. دو تغییر رفتاری دیگر هم اهمیت دارند. استدلال تطبیقی بهطور پیشفرض فعال است، بنابراین ممکن است پاسخ با یک بلوک استدلال آغاز شود و توکنهای مربوط به استدلال نیز در محدودیت max_tokens محاسبه میشوند. افزون بر این، سامانههای ایمنی ممکن است درخواست را رد کنند؛ بنابراین کد باید وضعیت stop_reason: "refusal" را مدیریت کند. آنتروپیک میگوید سازوکارهای حفاظتی امنیت سایبری در هایکو ۵.۵ سختگیرانهتر از نسخه ۴.۵ هستند و آزمون نفوذ را مسدود میکنند.
استفاده از هایکو ۵.۵ برای گردشکارهای سریع و کمهزینه
برای اجرای مثالهای این مقاله به پایتون نسخه ۳.۱۰ یا جدیدتر، یک کلید API از کنسول کلود و نسخه جدیدی از SDK آنتروپیک نیاز دارید؛ زیرا کدها از پارامتر جدیدتر output_config استفاده میکنند.
pip install -U anthropic
export ANTHROPIC_API_KEY="your-key-here"
دستور نخست، SDK رسمی پایتون را نصب یا بهروزرسانی میکند. دستور دوم کلید API را در محیط همان نشست شِل تنظیم میکند و SDK بهصورت خودکار متغیر محیطی ANTHROPIC_API_KEY را میخواند. در ویندوز و محیط PowerShell، از دستور زیر استفاده کنید:
$env:ANTHROPIC_API_KEY="your-key-here"گام اول: دستهبندی و استخراج اطلاعات
این دو وظیفه از کاربردهای اصلی هایکو هستند: دریافت ورودی کوتاه و تولید پاسخ ساختاریافته و کوتاه، آن هم در هزاران درخواست تکراری. کد زیر از خروجی JSON استفاده میکند تا پاسخ مدل به طرحوارهای که تعریف کردهاید محدود شود. همچنین جدول مشترک قیمتها و تابع محاسبه هزینه را تعریف میکند که در دو اسکریپت بعدی نیز به کار میروند.
# haiku_tasks.py
"""Fast, cheap Claude Haiku 5.5 calls: classification and extraction with JSON outputs."""
import json
import anthropic

MODEL = "claude-haiku-5-5"
client = anthropic.Anthropic() # reads ANTHROPIC_API_KEY from the environment

# USD per million tokens (input, output) for prompts up to 100K tokens.
PRICES = {
 "claude-haiku-5-5": (0.10, 0.50),
 "claude-sonnet-5-5": (2.00, 10.00),
 "claude-opus-5-5": (4.00, 20.00),
}

CATEGORY_SCHEMA = {
 "type": "object",
 "properties": {"category": {"type": "string", "enum": ["billing", "shipping", "technical", "other"]}},
 "required": ["category"],
 "additionalProperties": False,
}

INVOICE_SCHEMA = {
 "type": "object",
 "properties": {
 "vendor": {"type": "string"},
 "invoice_number": {"type": "string"},
 "total": {"type": "number"},
 "currency": {"type": "string"},
 "due_date": {"type": "string", "description": "ISO date, YYYY-MM-DD"},
 },
 "required": ["vendor", "invoice_number", "total", "currency", "due_date"],
 "additionalProperties": False,
}


def cost_usd(model, usage):
 price_in, price_out = PRICES[model]
 return (usage.input_tokens * price_in + usage.output_tokens * price_out) / 1_000_000


def ask_json(schema, instruction, text, model=MODEL, effort="low"):
 """One request whose reply must be JSON matching `schema`. Returns (data, usage)."""
 reply = client.messages.create(
 model=model,
 max_tokens=1000, # thinking tokens count toward this limit, so leave headroom
 system=instruction,
 messages=[{"role": "user", "content": text}],
 output_config={"effort": effort, "format": {"type": "json_schema", "schema": schema}},
 )
 if reply.stop_reason in ("refusal", "max_tokens"):
 raise RuntimeError(f"No usable answer, stop reason: {reply.stop_reason}")
 # A reply can start with a thinking block, so pick the text block by type.
 answer = "".join(block.text for block in reply.content if block.type == "text")
 return json.loads(answer), reply.usage


def classify(text, model=MODEL):
 data, usage = ask_json(CATEGORY_SCHEMA, "Classify the customer message.", text, model)
 return data["category"], usage


def extract_invoice(text, model=MODEL):
 data, usage = ask_json(INVOICE_SCHEMA, "Extract the invoice fields from the text.", text, model)
 return data, usage


if __name__ == "__main__":
 for message in ["I was charged twice this month.", "My parcel never arrived.", "The app crashes on login."]:
 category, usage = classify(message)
 print(f"{category:<10} {usage.input_tokens} in / {usage.output_tokens} out <- {message}")

 invoice = "Acme Cloud Ltd, invoice AC-2291. Total due: 1,240.50 USD by 15 November 2026."
 fields, usage = extract_invoice(invoice)
 print(fields, f"(${cost_usd(MODEL, usage):.6f})")
جدول PRICES قیمت هر یک میلیون توکن ورودی و خروجی را برای سه مدل مشخص میکند؛ این ارقام از صفحه معرفی هایکو و صفحه قیمتگذاری آنتروپیک گرفته شدهاند. تابع cost_usd تعداد توکنهای مصرفشده در یک پاسخ را به هزینه دلاری تبدیل میکند. دو طرحواره نیز ساختار خروجی مورد انتظار را تعریف میکنند: CATEGORY_SCHEMA مقدار فیلد category را به چهار گزینه مجاز محدود میکند و INVOICE_SCHEMA پنج فیلد را مشخص میسازد.
تابع اصلی این بخش ask_json است. این تابع یک درخواست ارسال میکند و طرحواره را در مسیر output_config.format قرار میدهد. مقدار effort نیز روی low تنظیم شده است تا مدل برای وظایف ساده زمان کمتری صرف استدلال کند. قابلیت خروجی ساختاریافته JSON آنتروپیک تضمین میکند که خروجی، JSON معتبر و مطابق با طرحواره باشد. نکته مهم این است که پارامتر temperature در کد وجود ندارد، زیرا هایکو ۵.۵ آن را نمیپذیرد. مقدار max_tokens برابر با ۱۰۰۰ است؛ هرچند پاسخها بسیار کوتاهاند، توکنهای استدلال نیز در این محدودیت حساب میشوند. کد دو کنترل دیگر هم دارد: اگر دلیل توقف refusal یا max_tokens باشد، خطا ایجاد میشود تا پاسخ ناقص بیصدا پذیرفته نشود. سپس بلوکهای متنی بر اساس نوعشان خوانده میشوند، زیرا پاسخ ممکن است با بلوک استدلال شروع شود، و در نهایت متن به JSON تبدیل میشود.
در این مثال، عمداً از خروجی JSON استفاده شده است، نه از تحمیل فراخوانی ابزار. هایکو ۵.۵ از فراخوانی اجباری ابزار پشتیبانی میکند، اما اوپوس ۵.۵ چنین درخواستی را با خطای ۴۰۰ رد میکند. بنابراین، برای مقایسه هر سه مدل در گام سوم، خروجی JSON گزینهای سازگارتر است. البته یک محدودیت وجود دارد: خروجی JSON برای هایکو ۵.۵ در آمازون بدراک در دسترس نیست. در بدراک باید قالب مورد نظر را در متن درخواست توضیح دهید و اعتبار نتیجه را خودتان بررسی کنید. برای اجرای برنامه، دستور زیر را وارد کنید:
python haiku_tasks.pyبخش __main__ سه پیام را دستهبندی میکند و اطلاعات یک فاکتور را استخراج میکند؛ سپس تعداد توکنهای مصرفشده و هزینه استخراج را چاپ میکند. انتظار میرود برای هر پیام یک دستهبندی و برای فاکتور یک دیکشنری شامل پنج فیلد دریافت کنید.
گام دوم: عاملهای فرعی
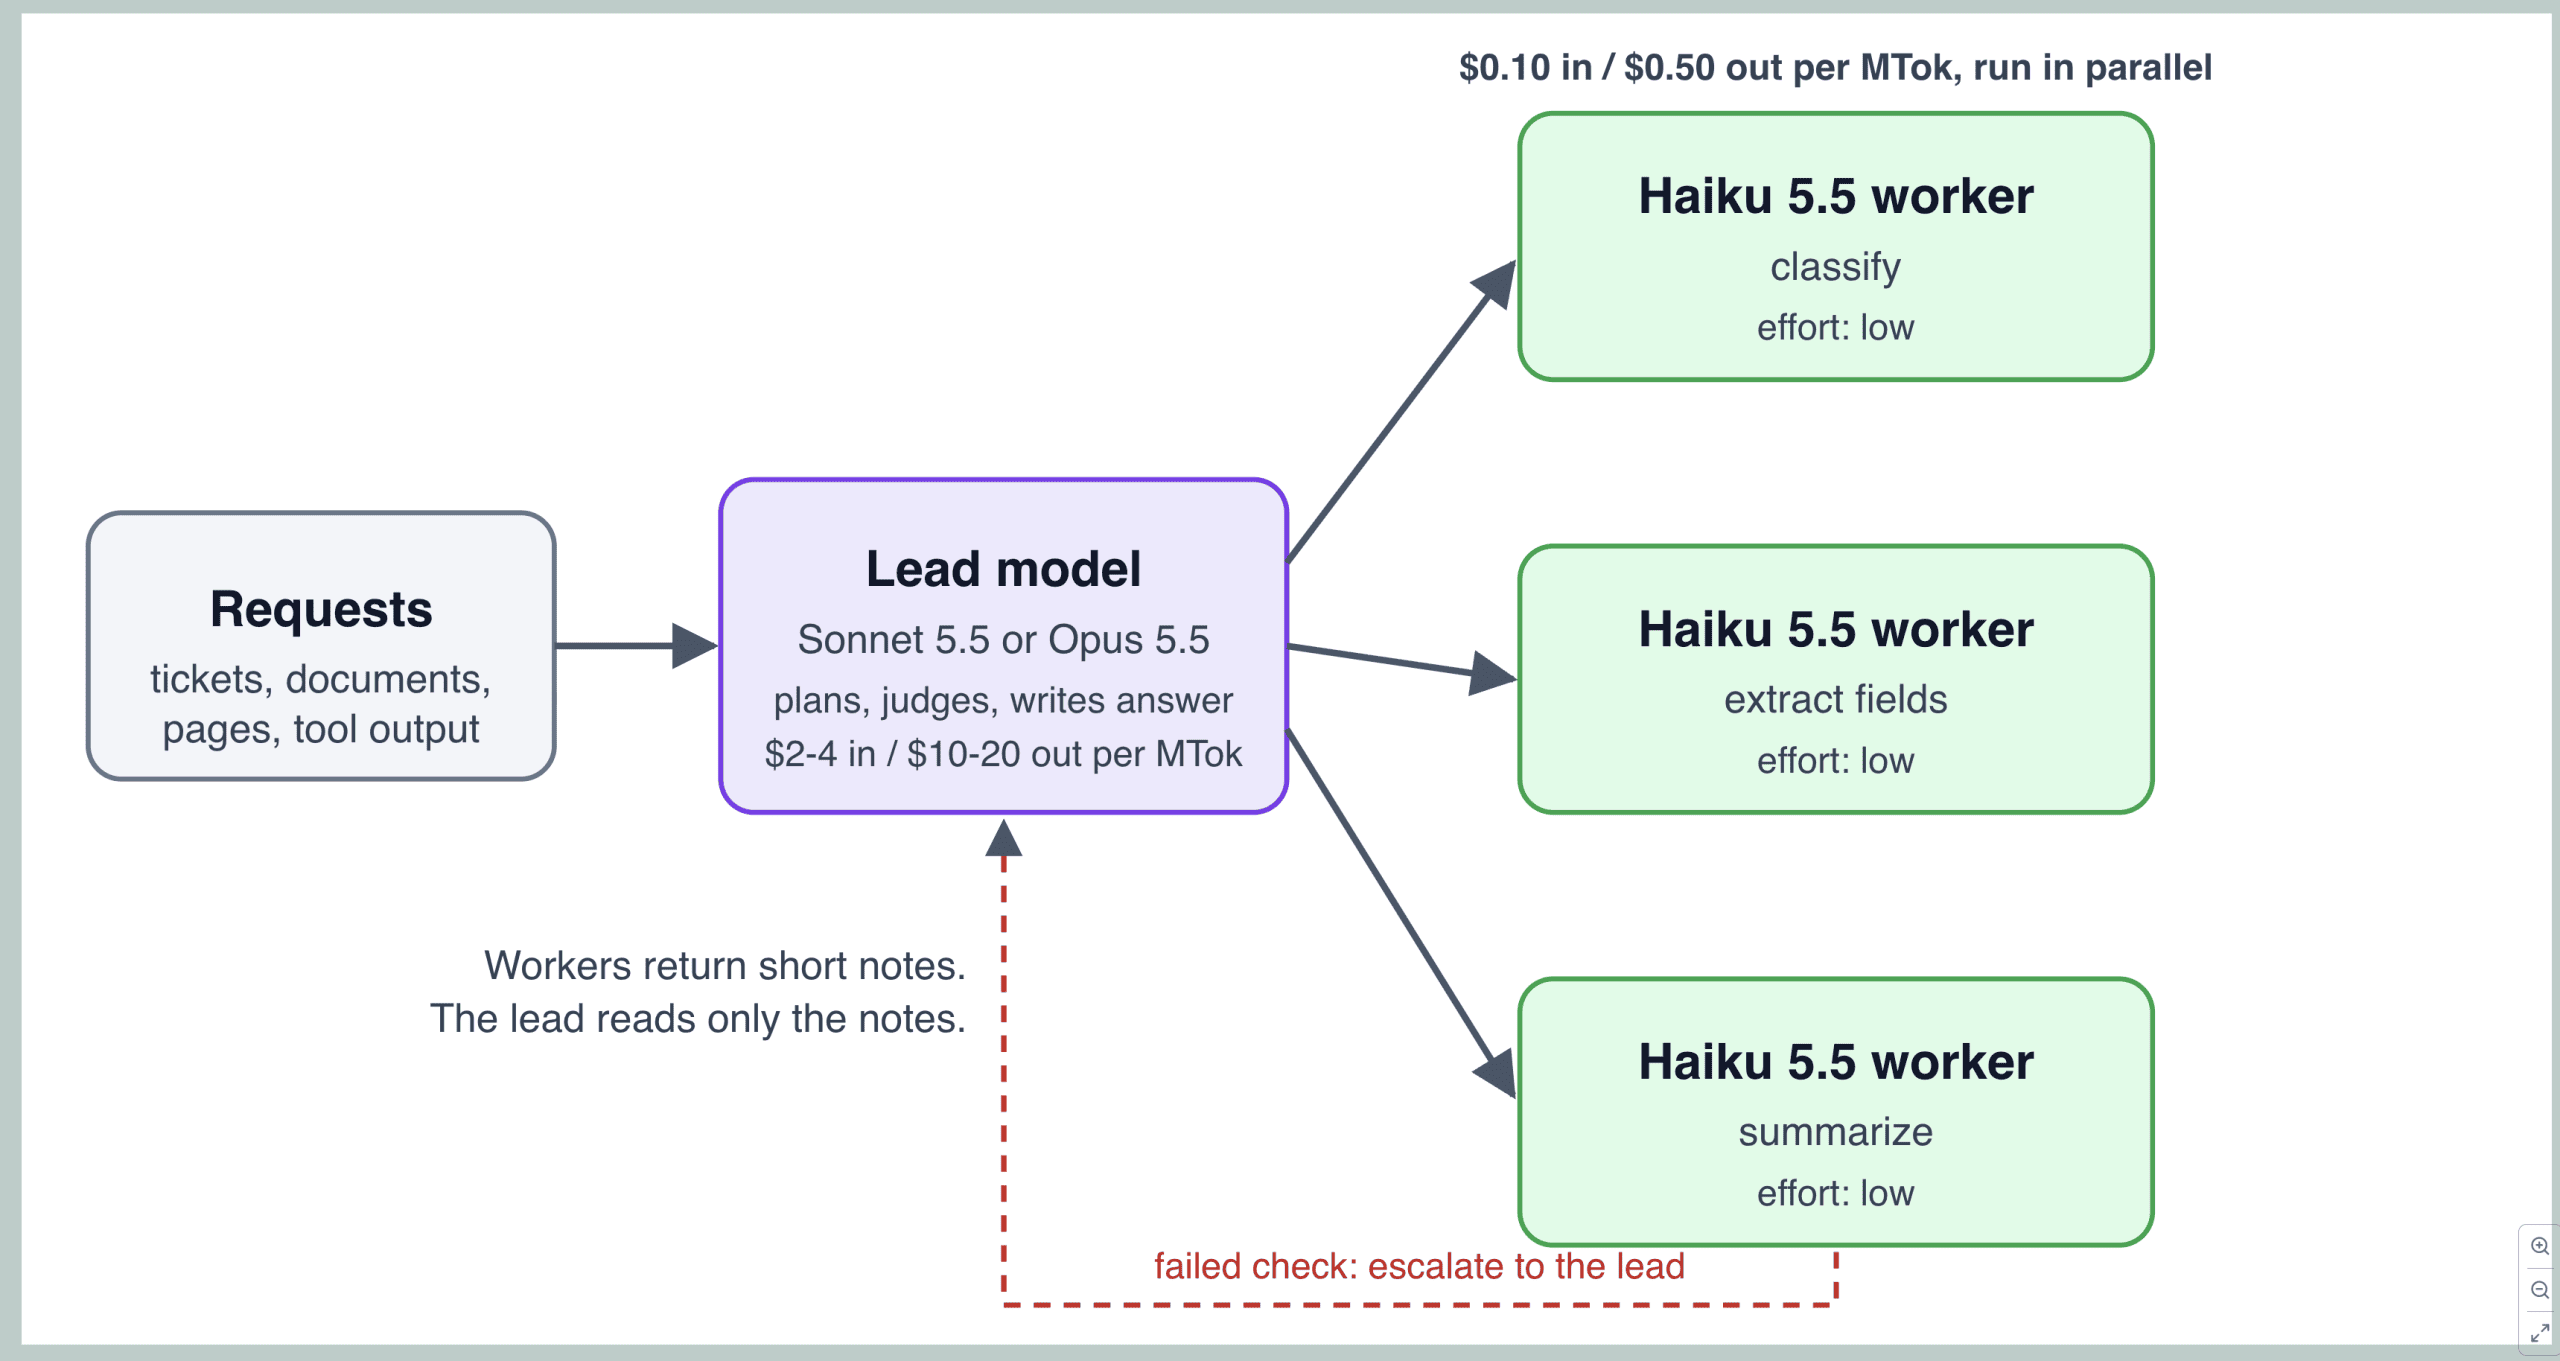
در معماری عاملهای فرعی، کار میان چند بخش تقسیم میشود. یک مدل بزرگتر تصمیم میگیرد چه کاری باید انجام شود و پاسخ نهایی را مینویسد، درحالیکه تعداد زیادی عامل هایکو وظایف محدود و تکراری را بهصورت موازی انجام میدهند. آنتروپیک همین الگو را برای هایکو پیشنهاد میکند. شرکت Cognition نیز گزارش کرده است که در سامانه Devin Fusion از هایکو ۵.۵ بهعنوان عامل کمکی و از اوپوس ۵.۵ بهعنوان مدل اصلی استفاده میکند.
# subagents.py
"""A lead model delegates narrow jobs to parallel Haiku 5.5 workers, then writes the answer."""
import asyncio
import anthropic
from haiku_tasks import MODEL as WORKER, cost_usd

LEAD = "claude-sonnet-5-5"
client = anthropic.AsyncAnthropic()


def text_of(reply):
 return "".join(block.text for block in reply.content if block.type == "text")


async def summarize(name, document, limit):
 async with limit: # cap how many workers run at once
 reply = await client.messages.create(
 model=WORKER,
 max_tokens=1500,
 system="Summarize the document in two sentences. Keep names, dates and amounts exact.",
 messages=[{"role": "user", "content": document}],
 output_config={"effort": "low"},
 )
 return name, text_of(reply), cost_usd(WORKER, reply.usage)


async def answer(documents, question):
 limit = asyncio.Semaphore(8)
 notes = await asyncio.gather(*(summarize(n, d, limit) for n, d in documents.items()))
 worker_cost = sum(cost for _, _, cost in notes)

 brief = "\n".join(f"[{name}] {summary}" for name, summary, _ in notes)
 reply = await client.messages.create(
 model=LEAD,
 max_tokens=2000,
 system="You are the lead analyst. Answer using only the worker notes.",
 messages=[{"role": "user", "content": f"Question: {question}\n\nWorker notes:\n{brief}"}],
 output_config={"effort": "medium"},
 )
 return text_of(reply), worker_cost, cost_usd(LEAD, reply.usage)


if __name__ == "__main__":
 documents = {
 "contract-a": "Northwind renewed its support contract on 3 March 2026 for 48,000 USD per year.",
 "contract-b": "Contoso signed a 12-month license on 9 May 2026. The fee is 15,500 USD, billed quarterly.",
 "contract-c": "Fabrikam's agreement ends on 30 June 2026 and renews only if either party gives notice.",
 }
 text, worker_cost, lead_cost = asyncio.run(answer(documents, "Which agreements need action before July 2026?"))
 print(text)
 print(f"workers: ${worker_cost:.6f} lead: ${lead_cost:.6f}")
تابع summarize یکی از عاملهای اجرایی است. این تابع از هایکو میخواهد با سطح تلاش پایین، سند را در دو جمله خلاصه کند و سپس نام سند، خلاصه و هزینه پردازش آن را برمیگرداند. Semaphore تعداد عاملهایی را که همزمان اجرا میشوند محدود میکند تا از سقف نرخ درخواستها فراتر نروید. تابع answer همه عاملها را با استفاده از asyncio.gather بهطور همزمان اجرا میکند، هزینه کار آنها را جمع میزند و سپس فقط خلاصههای کوتاه را به مدل اصلی میفرستد؛ در این مثال، مدل اصلی سونت ۵.۵ است که با سطح تلاش متوسط کار میکند. مدل اصلی متن کامل اسناد را نمیخواند و صرفهجویی هزینه از همینجا حاصل میشود. این تابع پاسخ نهایی و هزینه هر دو بخش را برمیگرداند تا بتوانید محل مصرف هزینه را بررسی کنید.
گام سوم: مقایسه هزینه و تأخیر پاسخ
اعداد منتشرشده تنها بخشی از تصویر را نشان میدهند. اسکریپت زیر یک وظیفه دستهبندی یکسان را با هر سه مدل اجرا میکند و دقت، زمان پاسخ و هزینه را در حساب کاربری خودتان اندازه میگیرد.
# compare_models.py
"""Run the same classification task on three models and compare accuracy, latency and cost."""
import statistics
import time
from haiku_tasks import classify, cost_usd

MODELS = ["claude-haiku-5-5", "claude-sonnet-5-5", "claude-opus-5-5"]

TICKETS = [
 ("I was charged twice for my last order.", "billing"),
 ("Please send me a copy of my invoice.", "billing"),
 ("Where is my package? It was due on Monday.", "shipping"),
 ("My order was delivered to the wrong building.", "shipping"),
 ("The app crashes every time I open settings.", "technical"),
 ("I cannot log in even after resetting my password.", "technical"),
 ("Can you tell me about your company history?", "other"),
 ("My card was declined but the money left my account.", "billing"),
]


def run(model):
 seconds, cost, hits, output_tokens = [], 0.0, 0, 0
 for text, label in TICKETS:
 start = time.perf_counter()
 category, usage = classify(text, model)
 seconds.append(time.perf_counter() - start)
 hits += category == label
 cost += cost_usd(model, usage)
 output_tokens += usage.output_tokens
 n = len(TICKETS)
 return hits / n, statistics.median(seconds), cost / n * 1000, output_tokens / n


if __name__ == "__main__":
 print(f"{'model':<20}{'accuracy':>9}{'median s':>10}{'$/1k calls':>12}{'out tok':>9}")
 for model in MODELS:
 try:
 accuracy, median_s, per_thousand, out_tokens = run(model)
 except Exception as error: # for example, a model or platform that rejects the request
 print(f"{model:<20} failed: {error}")
 continue
 print(f"{model:<20}{accuracy:>9.0%}{median_s:>10.2f}{per_thousand:>12.3f}{out_tokens:>9.0f}")
تابع run هر یک از هشت پیام آزمایشی را با مدل انتخابشده به تابع classify میفرستد و زمان اجرا، هزینه، درستی پاسخ و تعداد توکنهای خروجی را ثبت میکند. متغیر per_thousand هزینه میانگین را به هزینه هزار درخواست تبدیل میکند. بخش اصلی برنامه هایکو، سونت و اوپوس را بهترتیب اجرا میکند و برای هر کدام یک ردیف نتیجه چاپ میکند. اگر مدل یا پلتفرم درخواست را نپذیرد، اسکریپت خطا را چاپ میکند و به سراغ مدل بعدی میرود. هشت پیام فقط برای بررسی اولیه مناسباند؛ پیش از تصمیمگیری، آنها را با نمونههایی از درخواستهای واقعی خود جایگزین کنید.
python compare_models.pyتا زمانی که نتایج حساب خودتان آماده شود، میتوان از قیمتهای رسمی برای مقایسه استفاده کرد. فرض کنید هر درخواست دستهبندی شامل ۳۰۰ توکن ورودی و ۳۰ توکن خروجی باشد و توکنهای استدلال را نیز نادیده بگیریم. بر اساس قیمتهای منتشرشده، هزینه به این صورت خواهد بود:
| مدل | قیمت هر یک میلیون توکن ورودی و خروجی | هزینه هزار درخواست |
|---|---|---|
| هایکو ۵.۵ | ۰٫۱۰ و ۰٫۵۰ دلار | ۰٫۰۴۵ دلار |
| سونت ۵.۵ | ۲٫۰۰ و ۱۰٫۰۰ دلار | ۰٫۹۰ دلار |
| اوپوس ۵.۵ | ۴٫۰۰ و ۲۰٫۰۰ دلار | ۱٫۸۰ دلار |
هزینه هزار درخواست از فرمول زیر به دست میآید: (۳۰۰ × قیمت ورودی + ۳۰ × قیمت خروجی) ÷ ۱٬۰۰۰٬۰۰۰ × ۱٬۰۰۰. این ارقام محاسباتی بر اساس قیمتهای فهرستشدهاند، نه اندازهگیری واقعی. از آنجا که هر سه مدل از خانواده توکنساز یکسانی استفاده میکنند، تعداد توکنهای آنها قابل مقایسه است. آنتروپیک میگوید هایکو ۵.۵ در حالت سرعت استاندارد، سریعترین مدل این شرکت است؛ هرچند مدلهای اوپوس در حالت سریع یا Fast Mode سرعت بیشتری دارند. گزارش مشتریان نیز از بهبود سرعت حکایت دارد: آسانا اعلام کرده است که در مقایسه با مدلی که اکنون استفاده میکند، زمان تأخیر وظایف بیش از ۳۰ درصد کاهش یافته و باکس نیز زمان تأخیری حدود نصف هایکو ۴.۵ اندازهگیری کرده است.
چه زمانی از هایکو استفاده کنیم و چه زمانی نه؟
هایکو ۵.۵ برای وظایف محدود، پردازشهای پرتعداد یا موقعیتهایی که کاربر منتظر پاسخ است، انتخاب مناسبی است؛ از جمله دستهبندی، مسیردهی درخواستها، استخراج اطلاعات، خلاصهسازی، فشردهسازی محتوا و اجرای وظایف بهعنوان عامل فرعی. شرکت آلفاسنس گزارش کرده است که هایکو ۵.۵ در وظیفه پاسخگویی به پرسشهای مربوط به اسناد، از هایکو ۴.۵ بهتر عمل کرده و امتیاز ۰٫۸۴ را در برابر ۰٫۷۶ به دست آورده است. این وظیفه در سامانهای اجرا میشود که هفتهای حدود ۸ میلیون درخواست دارد. برای برنامهنویسی عاملمحور پیچیده، بهتر است همچنان از سونت ۵.۵ یا اوپوس ۵.۵ استفاده کنید؛ آنتروپیک میگوید مدلهای بزرگتر در این زمینه همچنان انتخاب بهتری هستند. نتایج آزمونهای بالا نیز این تفاوت را نشان میدهند. یک قاعده کاربردی آن است که ابتدا در تمام مراحل پرتعداد از هایکو استفاده کنید، عملکرد آن را روی نمونهای از دادههای واقعی خود بسنجید و فقط در بخشهایی که نتیجه رضایتبخش نیست به مدل قویتری روی بیاورید.
جمعبندی
هایکو ۵.۵ نسبت به مدل قبلی، دوره پشتیبانی طولانیتری نیز دارد. آنتروپیک زودترین تاریخ بازنشستگی آن را ۷ اکتبر ۲۰۲۷ اعلام کرده است؛ درحالیکه زودترین تاریخ اعلامشده برای هایکو ۴.۵، ۱۵ اکتبر ۲۰۲۶ است؛ یعنی امروز. بااینحال، هایکو ۴.۵ همچنان در فهرست مدلهای فعال قرار دارد و آنتروپیک متعهد شده است پیش از بازنشسته کردن هر مدل، از قبل اطلاعرسانی کند. همچنین، SDKها اکنون پشتیبانی آزمایشی از قابلیت کار با رایانه و مرورگر را ارائه میکنند؛ وظایفی که به گفته آنتروپیک با یک مدل سریع و کمهزینه تناسب دارند. به ارزیابی نویسنده، احتمال دارد در آینده بخش بیشتری از کارهای عاملمحور به مدلهای کوچک سپرده شود تا بهصورت موازی و زیر نظر یک مدل برنامهریز بزرگتر فعالیت کنند؛ شواهد اولیه حاصل از تجربه مشتریان آنتروپیک نیز در همین جهت است. البته این صرفاً یک پیشبینی است، نه تضمینی درباره آینده.
در مجموع، هایکو ۵.۵ برای بیشتر درخواستها قیمتهای فهرستشده را ۹۰ درصد کاهش میدهد و قابلیتهایی مانند استدلال تطبیقی، پنجره زمینه یکمیلیونتوکنی و بهبود چشمگیر نتایج آزمونهای آنتروپیک را ارائه میکند. برای مهاجرت به این مدل باید پارامترهای نمونهگیری و پیشپرکردن پاسخ دستیار را حذف کنید، بلوکهای محتوا را بر اساس نوعشان بخوانید و افزایش تعداد توکنها را در محاسبات خود در نظر بگیرید. از هایکو برای دستهبندی، استخراج اطلاعات و اجرای عاملهای فرعی استفاده کنید، عملکرد آن را با سونت و اوپوس روی دادههای خود بسنجید و تنها در صورت ناکافی بودن نتایج به مدل قویتر مراجعه کنید.
شیتو اولومیده مهندس نرمافزار و نویسنده حوزه فناوری است که به بهرهگیری از فناوریهای پیشرفته برای خلق روایتهای جذاب علاقه دارد. او به جزئیات توجه ویژهای دارد و در سادهسازی مفاهیم پیچیده مهارت دارد. همچنین میتوانید او را در توییتر دنبال کنید.