
چگونه دیپگرام پردازش صوت مبتنی بر هوش مصنوعی را در مقیاس گسترده با AWS Trainium بهینه کرد
با تبدیلشدن صدا به یکی از شیوههای اصلی تعامل با هوش مصنوعی، مدلهای دیپگرام طیف گستردهای از کاربردها، از تبدیل گفتار به متن و متن به گفتار گرفته تا عاملهای صوتی هوش مصنوعی، را پوشش میدهند. این مدلها اکنون سالانه کوادریلیونها توکن صوتی را برای بیش از ۲۰۰ هزار توسعهدهنده و ۱۴۰۰ سازمان پردازش میکنند. مشتریان میتوانند از طریق API دیپگرام به این مدلها دسترسی داشته باشند یا آنها را در محیطهای اختصاصی خود، از جمله Amazon SageMaker AI، اجرا کنند.
برای دیپگرام، بهرهوری در ارائه خدمات تعیین میکند که با بودجه مشخص زیرساختی چه میزان داده صوتی قابل پردازش است. بارهای کاری دستهای با حجم بالا فشار زیادی بر این بودجه وارد میکنند؛ بنابراین، هرچه از هر ساعت کار شتابدهنده بهتر استفاده شود، همان زیرساخت میتواند حجم بیشتری از صدا را پردازش کند. به همین دلیل، بهینهسازی بهرهوری استنتاج به یکی از اهداف اصلی دیپگرام تبدیل شد و این شرکت برای دستیابی به آن به سراغ تراشههای هوش مصنوعی AWS رفت. دیپگرام با همکاری AWS، مدل تبدیل گفتار به متن Nova-3 را برای اجرا روی AWS Trainium2 آماده کرد تا بارهای کاری دستهای آفلاین، مانند تحلیل تماسهای مراکز ارتباط با مشتری و پیادهسازی متون پزشکی، با کارایی بیشتری پردازش شوند.
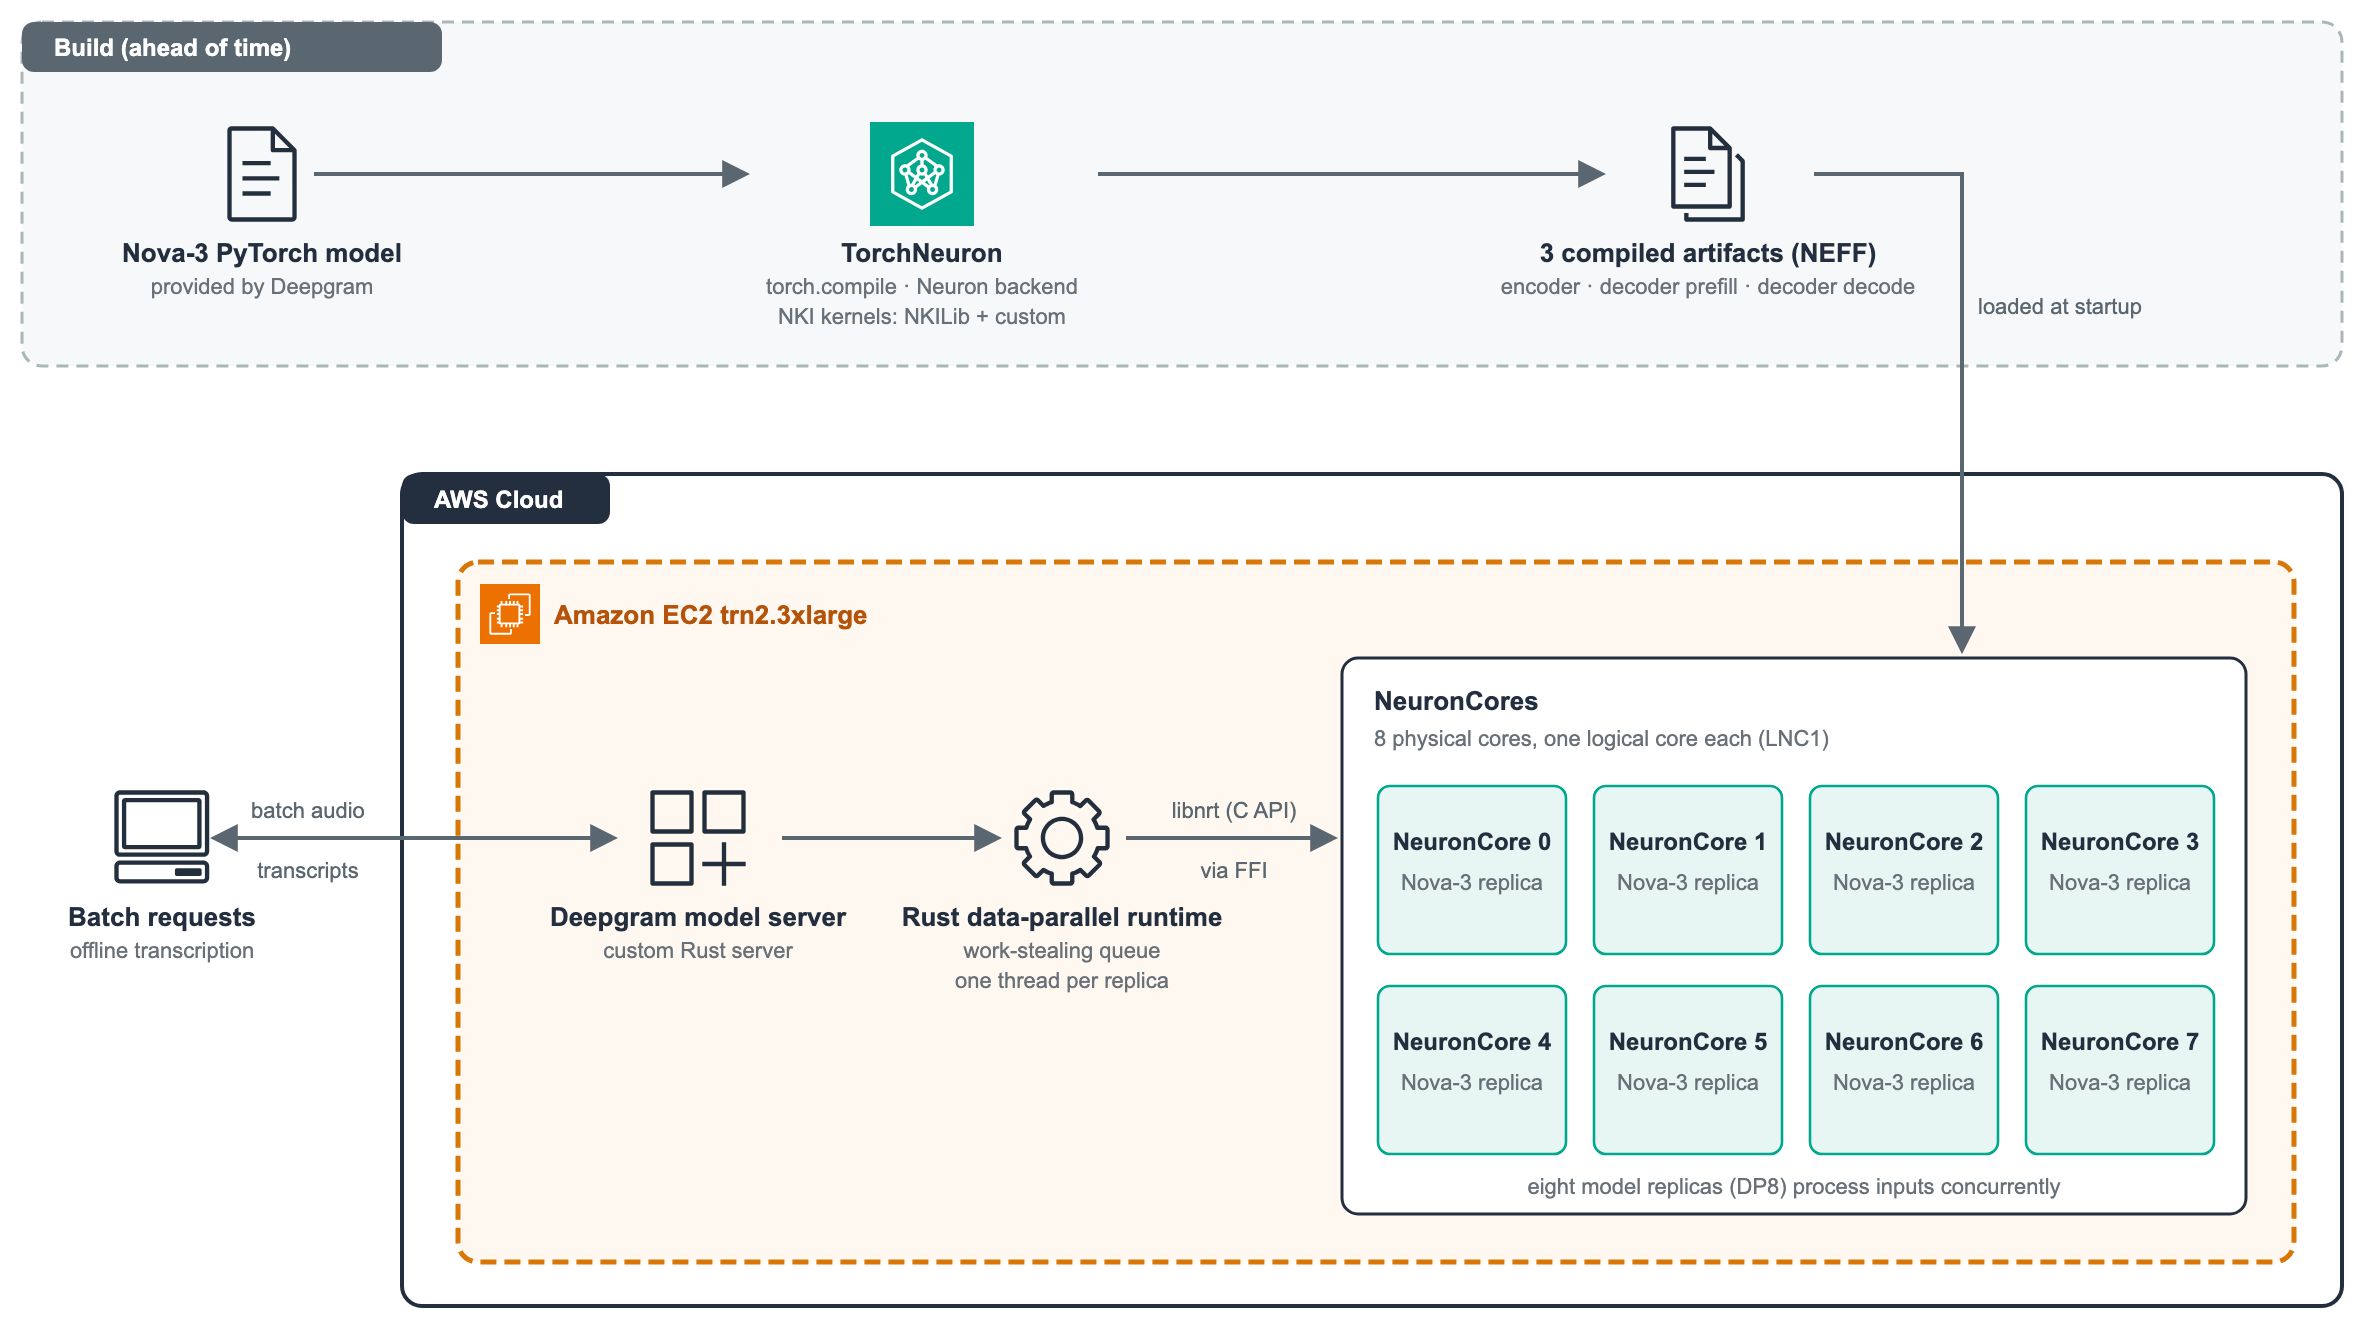
این همکاری با ارائه نسخه استاندارد مدل Nova-3 مبتنی بر PyTorch از سوی دیپگرام آغاز شد. طی چند ماه، دیپگرام و تیم مهندسی استقرار میدانی AWS یا FDE، مدل را با استفاده از بازسازی در PyTorch به Trainium2 منتقل کردند و آن را برای سختافزار جدید بهینه ساختند. پیکربندی نهایی، هشت نسخه از مدل را روی یک نمونه trn2.3xlarge از سرویس Amazon Elastic Compute Cloud (Amazon EC2) اجرا میکند. در بارهای کاری دستهای آفلاین دیپگرام که بر توان عملیاتی بالا متمرکز هستند، این پیکربندی در مقایسه با گزینههای محاسباتی مورد استفاده قبلی این شرکت، بهازای هر دلار ۱۱ تا ۷۰ درصد داده صوتی بیشتری پردازش کرد. این ارقام بر اساس قیمت نمونههای محاسباتی در زمان ارزیابی محاسبه شدهاند. چنین بهبودهایی به دیپگرام کمک میکنند فعالیتهای خود را با بهرهوری بیشتری گسترش دهد، مدلهای بهتر را سریعتر عرضه کند و آنها را با قیمت پایینتری در اختیار مشتریان بگذارد. مشتریانی که مدلهای دیپگرام را در ابر خصوصی مجازی (VPC) خود و با استفاده از Amazon SageMaker AI میزبانی میکنند نیز میتوانند از این مزایا بهرهمند شوند. دیپگرام و AWS در این زمینه همچنان روی سادهترکردن راهاندازی، افزایش قابلیت اطمینان و بهبود مشاهدهپذیری سیستم کار میکنند.
در این مقاله، فرایند کامل بهینهسازی استنتاج روی Trainium شرح داده میشود: انتقال Nova-3 به پشته نرمافزاری AWS Neuron، تنظیمات سطح کرنل، توسعه محیط اجرای موازی دادهای با زبان Rust برای اتصال سرور مدل دیپگرام به Trainium و نتایج اندازهگیریشده از نظر توان عملیاتی و هزینه در پردازش دستهای گفتار.
بهینهسازی Nova-3 برای Trainium2 با PyTorch بومی
کار را با کد استاندارد PyTorch آغاز کردیم و از TorchNeuron، یکپارچهسازی بومی PyTorch با کامپایلر Neuron، استفاده کردیم که هم اجرای فوری و هم torch.compile را پشتیبانی میکند. ابتدا Nova-3 را در حالت اجرای فوری روی Trainium2 اجرا کردیم و بررسی کردیم کدام عملیات به پردازنده مرکزی (CPU) واگذار میشوند. سپس مدل را با torch.compile کامپایل کردیم. در مسیر اجرای کامپایلشده، تمام عملیات مدل روی Trainium2 انجام شدند و هیچ موردی از بازگشت اجرا به CPU مشاهده نشد.
رمزگذار و رمزگشا را با استفاده از torch.compile بهصورت دو گراف مستقل با شکلهای ثابت کامپایل کردیم. در تمام مراحل، دقت عددی را در دو سطح بررسی کردیم: سازگاری خروجی هر لایه با خروجی CPU و نرخ خطای کلمات (WER) در کل فرایند، که باید با مقادیر مرجع دیپگرام و هدف تعیینشده برای این معیار مطابقت میداشت.
پس از دستیابی به یک پیکربندی پایه قابل اتکا، فرایند بهینهسازی را با جایگزینکردن چند لایه با کرنلهای ادغامشده از کتابخانه عمومی NKI یا NKILib آغاز کردیم. این کتابخانه مجموعهای از کرنلهای مرجع ازپیشآماده است که با استفاده از رابط Neuron Kernel Interface یا NKI نوشته شدهاند. کرنلهای مورد استفاده، عملیاتی مانند فرافکنیهای ادغامشده QKV، لایههای ادغامشده شبکه پیشخور (FFN) و کانولوشن یکبعدی عمقی را پوشش میدادند.
هدف ما افزایش توان عملیاتی و در نتیجه بهبود بهرهوری هزینه در بارهای کاری استنتاج آفلاین دیپگرام بود. توان عملیاتی بهصورت میزان بهبود نسبی در مقایسه با پیکربندی پایه گزارش شده است، نه بهصورت حجم مطلق صدای پردازششده در هر ثانیه. همچنین، اندازه دستههای پردازشی را از ۱ تا ۱۲۸ تغییر دادیم تا اندازهای را پیدا کنیم که بیشترین توان عملیاتی را فراهم میکند.
تنظیم کرنلها با Neuron Explorer و NAD
فعالکردن کرنلها فقط نخستین گام در چرخه تکرارشونده بهینهسازی است: ابتدا یک کرنل NKI، چه سفارشی و چه برگرفته از NKILib، فعال میشود؛ سپس بار کاری را پروفایلگیری میکنیم و بر اساس یافتهها، یا کرنل موجود را بهینه میسازیم یا آن را با کرنلی جدید جایگزین میکنیم. این چرخه تا دستیابی به هدف عملکردی ادامه مییابد. در هر مرحله، بخش متفاوتی از پشته Neuron به تسریع کار کمک میکند: NKILib کرنلهای جایگزین آماده استفاده ارائه میدهد، Neuron Explorer ابزار اصلی پروفایلگیری بارهای کاری Neuron است و مجموعه ابزار توسعه عاملمحور Neuron (NAD) با قابلیتهای پروفایلگیری و نگارش کرنل، تحلیل نتایج و تنظیم کرنلها را سرعت میبخشد.
در پروژه ما، کرنلهای NKILib بخش عمده مسیر بهینهسازی را پوشش دادند، اما نتایج پروفایلگیری نشان داد که در برخی موارد، کرنلهای دستنویس عملکرد بهتری خواهند داشت. هر بار، قابلیتهای پروفایلگیری NAD به ما کمک کردند از دادههای پروفایل Neuron Explorer به علت اصلی مشکل برسیم و قابلیتهای نگارش کرنل در NAD نیز برای تولید کرنلهای جایگزین به کار رفتند.
| لایه | یافتهها و تغییرات اعمالشده | میزان بهبود |
|---|---|---|
| شبکه پیشخور (FFN) | برنامه زمانبندی تقسیمبندی محاسبات در کرنل مرجع، برای هر بخش از توکنها، مجموعه کامل وزنهای فرافکنی را دوباره از حافظه خارج از تراشه بارگذاری میکرد. در نتیجه، با افزایش تعداد توکنها، پهنای باند حافظه به عامل محدودکننده توان عملیاتی تبدیل میشد. در کرنل تنظیمشده بهصورت دستی، هر بخش از وزنها فقط یک بار بارگذاری میشود و در چند بخش از توکنها مورد استفاده مجدد قرار میگیرد؛ همچنین، خواندن وزنها با محاسبات روی تراشه بهصورت خط لولهای همزمان شده است. | کاهش ۲ برابری تأخیر در مقایسه با کرنل مرجع، در اندازه دسته ۹۶ |
| کانولوشن یکبعدی عمقی (Depthwise Conv1D) | کرنل آزمایشی NKILib این عملیات را بهشکل یک ضرب ماتریسی عمومی ضمنی (GEMM) پیادهسازی میکرد که باعث میشد میزان استفاده از موتور تانسوری پایین بماند. ما آن را به یک حلقه ضرب و انباشت با پخش دادهها روی موتور برداری بازنویسی کردیم. این تغییر استفاده کامل از ظرفیت موتور را ممکن ساخت و بهاندازهای مؤثر بود که توان عملیاتی اوج پایینتر موتور برداری را جبران کرد. | افزایش ۱٫۵ برابری سرعت در مقایسه با کرنل مرجع، در اندازه دسته ۹۶ |
| کانولوشن دوبعدی (Conv2D) | لایههای Conv2D مدل به گلوگاهی در فرایند کامپایل تبدیل شده بودند: در اندازه دستههای بزرگتر از ۳۲، این لایهها مانع کامپایل کل مدل بهصورت یک گراف واحد میشدند. از آنجا که NKILib کرنلی برای Conv2D نداشت، کرنلی را از ابتدا با NKI نوشتیم. این کرنل در چند مرحله، با استفاده از اطلاعات پروفایلگیری و بر اساس چرخه بهینهسازی شرحدادهشده در بالا، اصلاح شد و امکان استفاده از اندازه دستههای بزرگتر از ۳۲ را فراهم کرد. | بهبود عملکرد تا ۵۰ برابر در ماژول کانولوشن، برای اندازه دستههای حداکثر ۳۲ |
محیط اجرای موازی دادهای با Rust
هر دستگاه Trainium2 دارای هشت NeuronCore فیزیکی است که بهطور پیشفرض به شکل چهار NeuronCore منطقی (LNC2) در اختیار نرمافزار قرار میگیرند. از آنجا که هر نمونه از مدل Nova-3 بهراحتی روی یک هسته فیزیکی جا میگیرد، تعداد هستههای فیزیکی اختصاصیافته به هر هسته منطقی را به یک کاهش دادیم (LNC1). این پیکربندی امکان میزبانی هشت نسخه از مدل (DP8) را روی هر دستگاه Trainium2 فراهم میکند. ورودیها بهطور همزمان پردازش میشوند تا توان عملیاتی هر دستگاه به حداکثر برسد. محیط اجرای موازی دادهای نیز بر صفی مبتنی است که وظایف را میان رشتهها توزیع میکند و هر نسخه از مدل یک رشته اختصاصی دارد.
از آنجا که پشته ارائه خدمات تولیدی دیپگرام با Rust نوشته شده است، انتقال Nova-3 به Trainium2 صرفاً به کامپایل مدل محدود نمیشد؛ مدل باید بدون استفاده از Python یا PyTorch در مسیر ارائه خدمات نیز اجرا میشد. به همین دلیل، محیط اجرای سبکی ساختیم که در آن Rust نسخههای مدل را از طریق یک صف مشترک با قابلیت واگذاری وظایف میان رشتهها هماهنگ میکند. یک لایه C فایلهای اجرایی Neuron با قالب NEFF را که از پیش کامپایل شدهاند، مستقیماً از طریق رابط برنامهنویسی Neuron Runtime API و کتابخانه libnrt بارگذاری و اجرا میکند. این محیط اجرا مستقیماً با معماری ارائه خدمات دیپگرام یکپارچه شده است و در تمام اندازههای دسته آزمایششده، دقیقاً همان توالی توکنهای مرجع را تولید کرد.
عملکرد این محیط را با دو محیط اجرای موازی دادهای مبتنی بر Python مقایسه کردیم: یکی چندرشتهای (MT) و دیگری چندپردازهای (MP). در مقایسه با پیکربندی پایه چندپردازهای، محیط Rust سربار مفسر Python را بهطور کامل حذف میکند. در مقایسه با پیکربندی چندرشتهای نیز محدودیت ناشی از قفل سراسری مفسر (GIL) را کاهش میدهد؛ در نتیجه، فراخوانیهای ارسال کار از سوی رشتههای همزمان دیگر در یک فرایند واحد برای دسترسی به مفسر با یکدیگر رقابت نمیکنند. این بهبودها اهمیت زیادی دارند، زیرا Nova-3 برای هر قطعه صوتی، مجموعهای از فراخوانیهای کوچک رمزگشا را اجرا میکند و در اندازههای کوچک دسته، ارسال درخواست از سمت میزبان به گلوگاه تبدیل میشود. به همین دلیل، افزایش توان عملیاتی در این اندازهها بیشترین مقدار را دارد، هرچند در اندازه دستهای که بیشترین توان عملیاتی را فراهم میکند نیز همچنان قابل توجه است. در این اندازه، محیط اجرای Rust توان عملیاتی را در مقایسه با پیکربندی پایه چندپردازهای Python به میزان ۷٫۵ درصد افزایش داد.
تأثیر بر کاهش هزینه
عملکرد نسبت به هزینه را بر اساس میزان صدای پردازششده بهازای هر دلار اندازهگیری کردیم. در بارهای کاری دستهای آفلاین دیپگرام که بر توان عملیاتی بالا متمرکز هستند، پیکربندی تکدستگاهی Trainium2 با نمونه trn2.3xlarge، در مقایسه با گزینههای محاسباتی مورد استفاده قبلی این شرکت، بهازای هر دلار ۱۱ تا ۷۰ درصد داده صوتی بیشتری پردازش کرد.
جمعبندی
در این پروژه نشان دادیم که دیپگرام و تیم FDE شرکت AWS چگونه مدل Nova-3 مبتنی بر PyTorch را برای تبدیل گفتار به متن، با استفاده از TorchNeuron به سختافزار Trainium منتقل کردند. TorchNeuron یکپارچهسازی بومی چارچوب PyTorch با AWS Trainium را فراهم میکند. برای افزایش عملکرد، برخی لایهها را مستقیماً با کرنلهای آماده NKILib جایگزین کردیم. سپس با Neuron Explorer عملکرد را ارزیابی کردیم و از قابلیتهای پروفایلگیری Neuron Agentic Development یا NAD برای بررسی دادههای پروفایل و تسریع عیبیابی عملکرد استفاده کردیم. بر اساس این یافتهها، کد منبع کرنلها را با کمک قابلیتهای نگارش کرنل NAD تغییر دادیم. در نهایت، یک محیط اجرای سبک برای پردازش موازی دادهها با Rust ساختیم که از طریق آن میتوان رابط Neuron Runtime API را از Rust فراخوانی کرد. نتایج این پیکربندی، صرفهجویی در هزینه را در سناریوهای آفلاین با تمرکز بر توان عملیاتی بالا نشان داد و تأیید کرد که AWS Trainium گزینهای عملی و کارآمد برای بارهای کاری استنتاج دیپگرام است.
برای آزمایش این رویکرد روی مدلهای خود، کار را با مطالعه مستندات AWS Neuron آغاز کنید. این مستندات اطلاعات مربوط به کامپایلر، محیط اجرا و چارچوبهای پشتیبانیشده را در اختیار شما قرار میدهد. راهنمای Neuron Kernel Interface (NKI) نحوه نوشتن کرنلهای شرحدادهشده در این مقاله را توضیح میدهد و مخزن نمونههای NKI شامل کرنلهای مرجعی است که کار را با آنها آغاز کردیم. همچنین، مستندات ابزارهای توسعه Neuron ابزارهای پروفایلگیری و توسعه عاملمحور مورد استفاده در این پروژه، از جمله Neuron Explorer و Neuron Agentic Development، را معرفی میکند. برای اطلاع از اندازه نمونهها و قیمتگذاری نیز به صفحه نمونههای Amazon EC2 Trn2 مراجعه کنید. برای دریافت کمک در ارزیابی و برنامهریزی انتقال مدلی مشابه، با تیم مهندسی استقرار میدانی AWS تماس بگیرید.