
آزمون COBOL اوپنایآی: دقت GPT-6.1 Sol از ۵٫۴ به ۸۶٫۶ درصد رسید
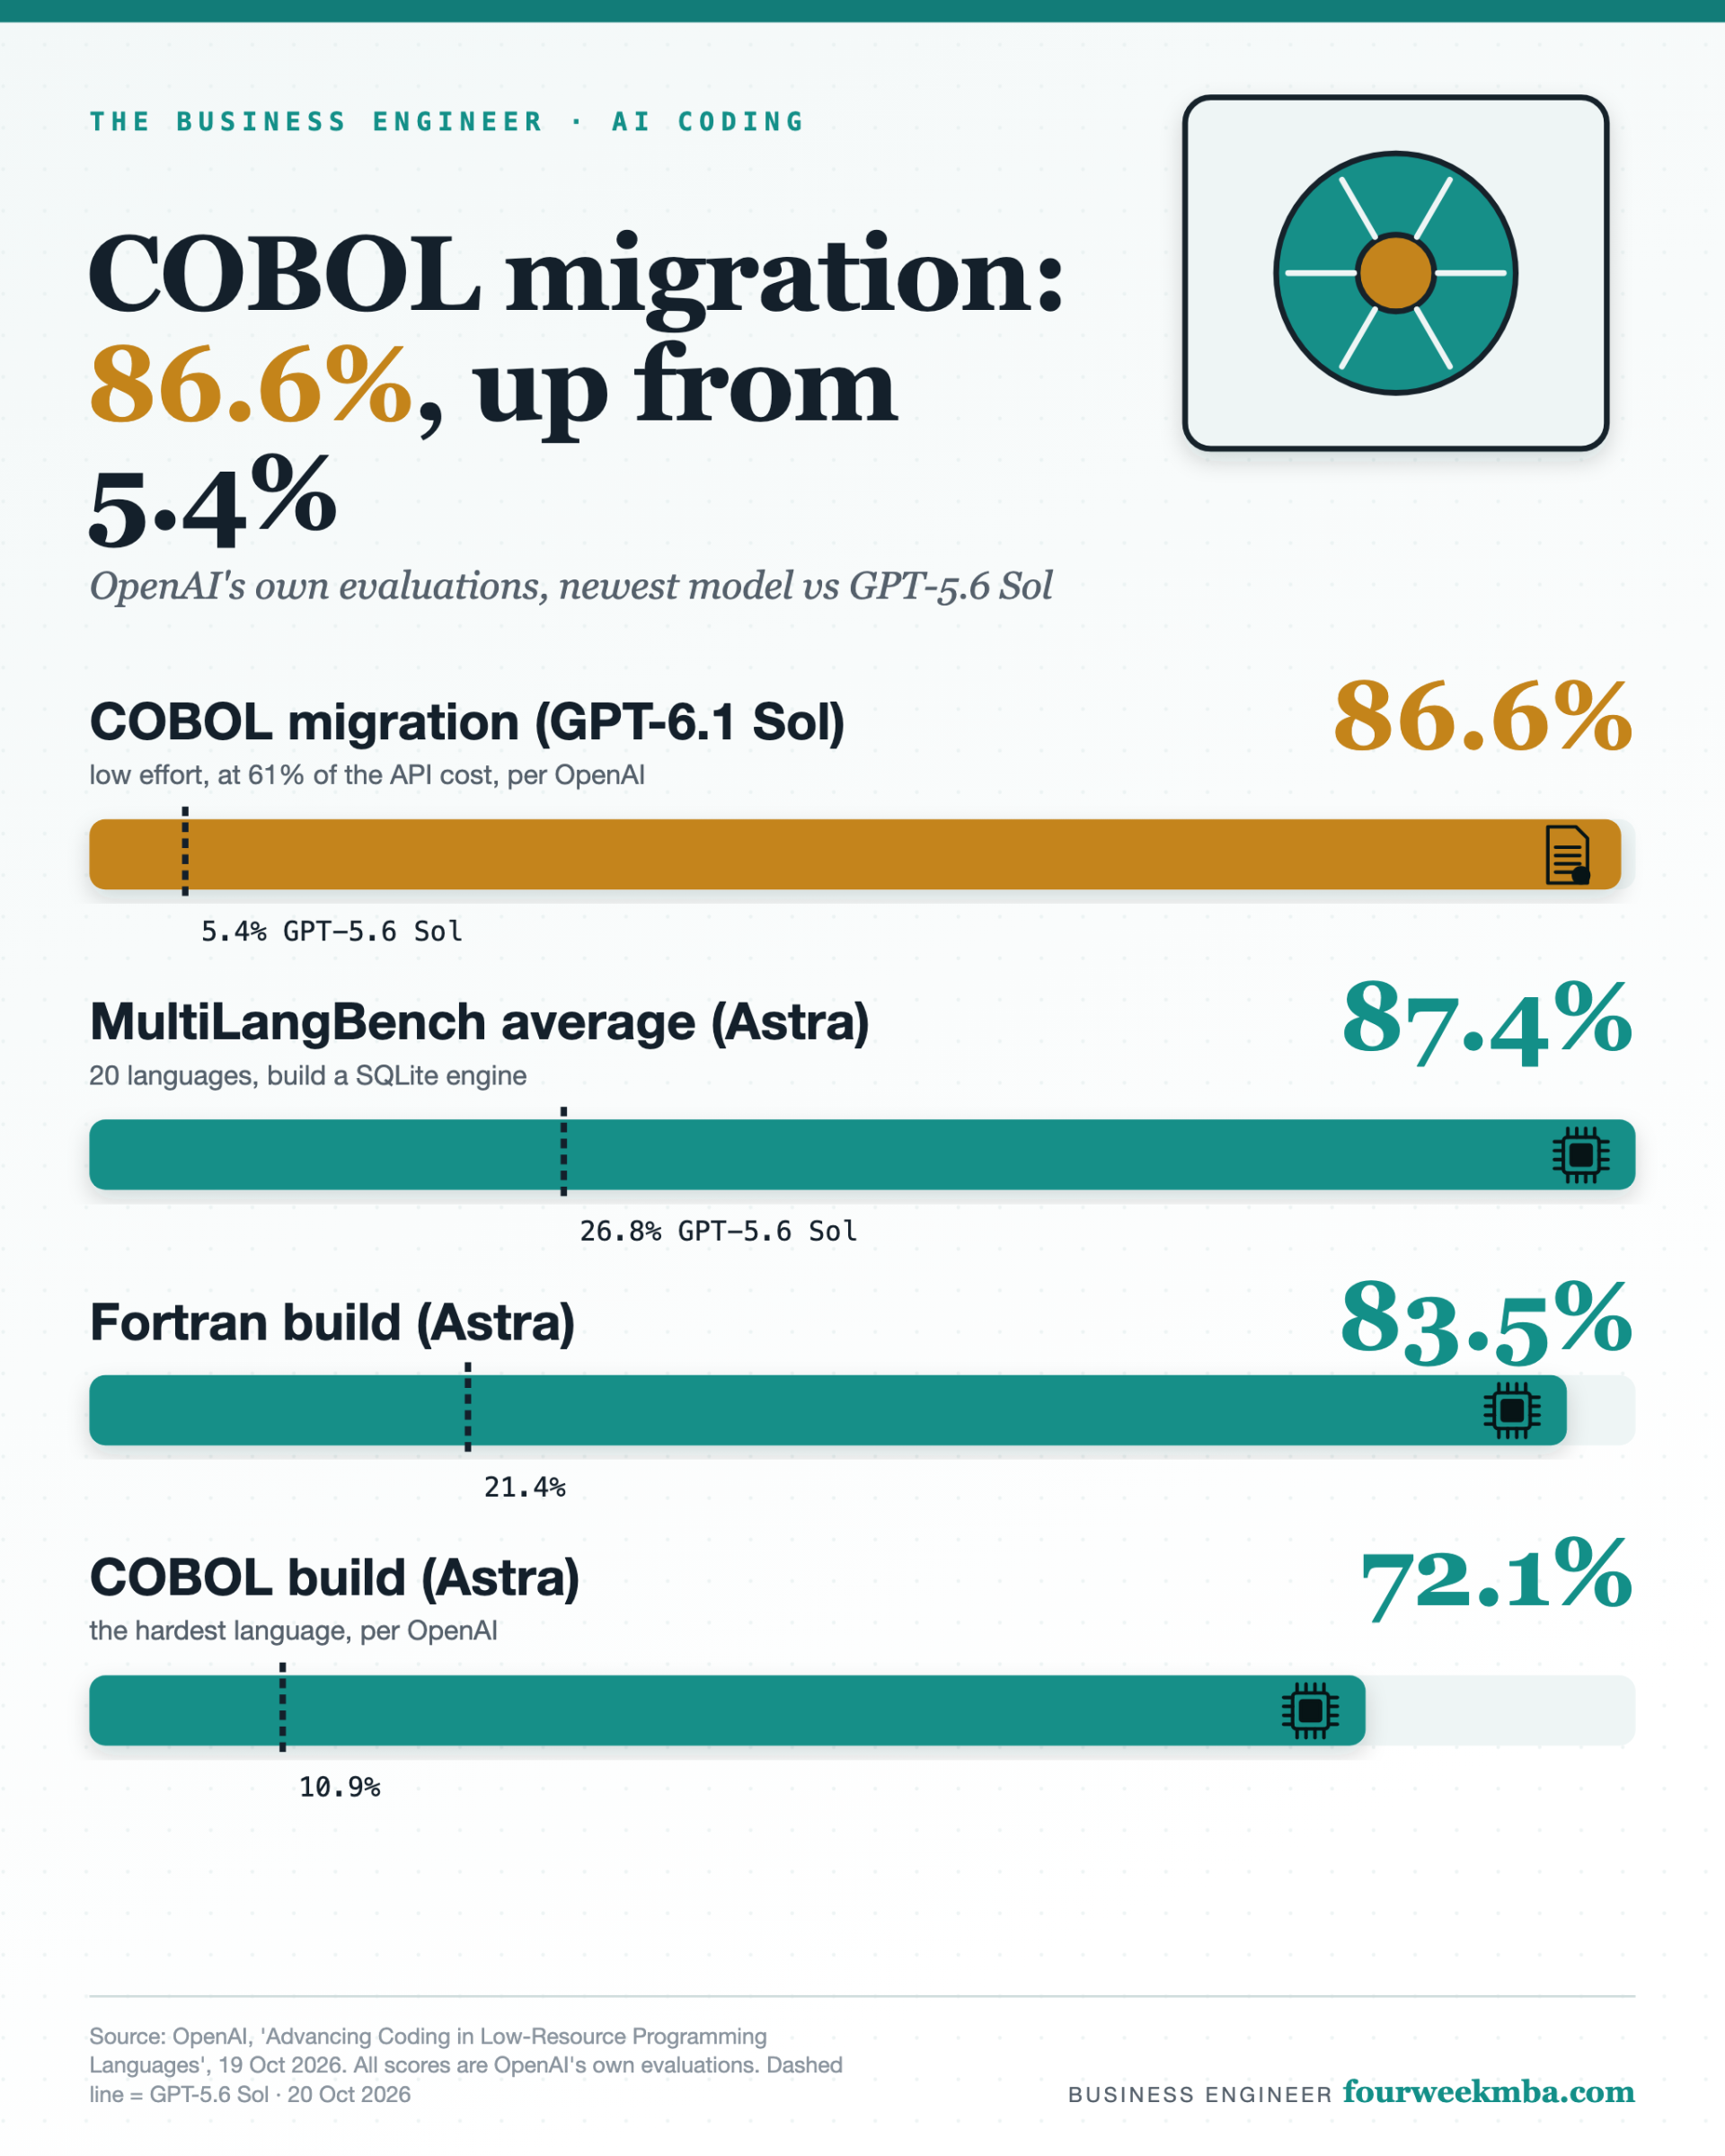
اوپنایآی در ۱۹ اکتبر ۲۰۲۶ اعلام کرد که مدلهای جدید این شرکت در توسعه و انتقال نرمافزارهای نوشتهشده به زبانهای برنامهنویسی کممنبع، مانند COBOL، فورترن و ویژوال بیسیک، عملکرد بهتری دارند. بر اساس ارزیابی اختصاصی این شرکت برای مهاجرت برنامههای COBOL، مدل GPT-6.1 Sol با سطح استدلال پایین به دقت ۸۶٫۶ درصد دست یافته است؛ درحالیکه این رقم برای GPT-5.6 Sol فقط ۵٫۴ درصد بوده است.
اوپنایآی نتایج را در مطلبی با عنوان «پیشبرد برنامهنویسی در زبانهای برنامهنویسی کممنبع» منتشر کرد و ساعت ۲۲:۳۰ به وقت هماهنگ جهانی (UTC) آن را در شبکه اجتماعی ایکس به اشتراک گذاشت. تمام امتیازهای مطرحشده در این گزارش، از ارزیابیهای خود اوپنایآی به دست آمدهاند.
اوپنایآی چه چیزی منتشر کرد؟
اوپنایآی توضیح داد که در مقایسه با زبانهایی مانند پایتون و جاوااسکریپت، کدها و مستندات کمتری برای آموزش مدلها در زبانهای کممنبع وجود دارد؛ بااینحال، این زبانها همچنان زیربنای زیرساختهای حیاتی و خدمات ضروری هستند. این شرکت با استناد به آمار IBM نوشت که COBOL در بیش از ۴۰ درصد سامانههای بانکداری آنلاین، ۸۰ درصد تراکنشهای حضوری با کارت اعتباری و ۹۵ درصد تراکنشهای خودپردازها نقش دارد.
به گفته این شرکت، توسعه قابلیتهای جدید با توجه به بازخورد برنامهنویسان و مشتریان سازمانی انجام شده است؛ مشتریانی که گفتهاند مدلهای برنامهنویسی هوش مصنوعی اغلب در کار با این زبانها با مشکل روبهرو میشوند. اوپنایآی برای ارزیابی عملکرد مدلها دو آزمون طراحی کرده است: MultiLangBench که توانایی مدل را در ساخت یک موتور پایگاه داده سازگار با SQLite از ابتدا و در ۲۰ زبان برنامهنویسی میسنجد، و یک آزمون اختصاصی برای مهاجرت کدهای COBOL.
اوپنایآی در ایکس چه گفت؟
پیشرفتهای حاصل از توسعه مدلهای جدید ما، قابلیتهای قویتری برای ساخت و مهاجرت نرمافزار در زبانهای برنامهنویسی کممنبعی مانند COBOL، فورترن و ویژوال بیسیک فراهم میکند.
این زبانها زیربنای نرمافزارهایی هستند که بانکها، دولتها و کسبوکارها به آنها وابستهاند. پیشرفت در این حوزه به معنای درک منطق کسبوکارهایی است که طی چندین دهه شکل گرفتهاند و کمک به برنامهنویسان برای نوسازی این سامانهها، بدون از دست دادن قابلیتهایی که بهدرستی کار میکنند.
ما این قابلیتها را بر اساس چالشهایی توسعه میدهیم که برنامهنویسان و مشتریان سازمانی با ما در میان میگذارند. اگر تیم شما با چنین سامانههایی کار میکند، به ما بگویید در مرحله بعد باید روی کدام زبانها و فرایندهای کاری تمرکز کنیم.
https://openai.com/index/low-resource-programming-languages/
اوپنایآی در پست خود که در ۱۹ اکتبر ساعت ۲۲:۳۰ به وقت UTC منتشر شد، اعلام کرد که مدلهای جدید این شرکت توانایی بیشتری برای ساخت و انتقال نرمافزار در زبانهای کممنبع مانند COBOL، فورترن و ویژوال بیسیک دارند. این شرکت همچنین از تیمهای توسعه خواست زبانها و فرایندهای کاری موردنیاز خود را برای تمرکزهای بعدی معرفی کنند. امتیازهای مطرحشده در این گزارش از ارزیابیهایی گرفته شدهاند که همراه با همین اعلام منتشر شدند.
آزمون مهاجرت COBOL
به گفته اوپنایآی، در آزمون مهاجرت، مدلها باید برنامههای نوشتهشده به زبان COBOL را به یکی از زبانهای ++C، جاوا، کاتلین، پایتون یا راست منتقل کنند، بیآنکه عملکرد اصلی برنامه تغییر کند. این آزمون از تستهای پنهانی استفاده میکند که لازم است خروجیهای قابل مشاهده را بایتبهبایت با خروجیهای برنامه اصلی مطابقت دهند. مهاجرت فقط زمانی موفق محسوب میشود که تمام آزمونها با موفقیت پشت سر گذاشته شوند.
اوپنایآی اعلام کرد که GPT-6.1 Sol با سطح استدلال پایین به دقت ۸۶٫۶ درصد رسیده است؛ درحالیکه امتیاز GPT-5.6 Sol با همان تنظیمات ۵٫۴ درصد بود. هزینه اجرای مدل جدید از طریق API نیز ۶۱ درصد هزینه مدل قبلی اعلام شده است. این شرکت افزود که با افزایش سطح استدلال، دقت GPT-6.1 Sol به ۹۷٫۹ درصد میرسد؛ رقمی که نشان میدهد عملکرد مدل در این آزمون به سقف ارزیابی نزدیک شده است.
اوپنایآی تأکید کرد که استفاده از این قابلیتها در نرمافزارهای عملیاتی «همچنان به بررسی کارشناسی و آزمون در برابر قواعد کسبوکار و وابستگیهای سامانه نیاز دارد».
آزمون MultiLangBench به تفکیک زبان
اوپنایآی اعلام کرد که GPT-6 Astra در بالاترین سطح استدلال، میانگین نرخ موفقیت ۸۷٫۴ درصد را در ۲۰ زبان برنامهنویسی ثبت کرده است؛ درحالیکه این میانگین برای GPT-5.6 Sol برابر با ۲۶٫۸ درصد بود. طبق نتایج منتشرشده، امتیاز COBOL از ۱۰٫۹ به ۷۲٫۱ درصد، فورترن از ۲۱٫۴ به ۸۳٫۵ درصد، ویژوال بیسیک از ۲۷٫۵ به ۸۹٫۴ درصد و OCaml از ۲۵٫۶ به ۸۵٫۸ درصد افزایش یافته است.
بر اساس این گزارش، امتیاز Astra در ۱۹ زبان از مجموع ۲۰ زبان بالاتر از ۸۳ درصد است و COBOL با امتیاز حدود ۷۲ درصد همچنان دشوارترین زبان در این آزمون به شمار میرود. مدل کمهزینهتر GPT-6 Luna نیز به امتیاز ۴۰٫۳ درصد رسیده است. میانگین هزینه تخمینی هر نمونه در API برای این مدل ۰٫۷۷ دلار اعلام شده، درحالیکه این رقم برای GPT-5.6 Sol برابر با ۳٫۴۸ دلار است؛ یعنی طبق محاسبات اوپنایآی، هزینه مدل Luna حدود ۷۸ درصد کمتر است.
اوپنایآی اعلام کرد که چارچوب ارزیابی MultiLangBench و مجموعه آزمونهای آن را به همراه نتایج تفکیکشده هر زبان در گیتهاب منتشر میکند.
ابزارهای نوسازی سامانههای مینفریم که هماکنون عرضه میشوند
شرکتهای ارائهدهنده خدمات ابری و سامانههای مینفریم نیز در حال عرضه ابزارهای هوش مصنوعی برای انجام همین نوع کار هستند. در صفحه محصول آمازون که در ۱۹ اکتبر ۲۰۲۶ بررسی شده، آمده است که سرویس AWS Transform for mainframe از هوش مصنوعی عاملمحور استفاده میکند تا فرایندهای نوسازی چندساله سامانهها را به چند ماه کاهش دهد.
در صفحه محصول IBM برای watsonx Code Assistant for Z نیز که در همان روز بررسی شد، آمده است که این ابزار با استفاده از هوش مصنوعی مولد، تبدیل COBOL به جاوا را از چند ماه به چند دقیقه کاهش میدهد. بااینحال، هیچیک از این دو صفحه امتیازی بر اساس آزمونهای اوپنایآی ارائه نمیکنند؛ بنابراین نمیتوان نتایج آنها را مستقیماً با یکدیگر مقایسه کرد.
محاسبات بر اساس ارقام منتشرشده
بر اساس محاسبات این گزارش، امتیاز آزمون مهاجرت COBOL به میزان ۸۱٫۲ واحد درصد، از ۵٫۴ به ۸۶٫۶ درصد افزایش یافته است. میانگین امتیاز MultiLangBench نیز ۶۰٫۶ واحد درصد، از ۲۶٫۸ به ۸۷٫۴ درصد رسیده است. این ارقام اختلاف میان امتیازهای اعلامشده از سوی خود اوپنایآی را نشان میدهند و حاصل اندازهگیری مستقل نیستند.
اهمیت ساختار آزمون
یکی از نکات مهم در طراحی این ارزیابی، معیار سختگیرانه موفقیت در مهاجرت کد است. اوپنایآی میگوید مهاجرت تنها زمانی پذیرفته میشود که تستهای پنهان، تطابق بایتبهبایت خروجیهای قابل مشاهده را تأیید کنند. این شرکت همچنین به گرد کردن ارقام در نتایج مالی اشاره کرده است؛ رفتاری که ممکن است در بازنویسی برنامهها بیسروصدا تغییر کند و به تفاوت در نتایج منجر شود.
بر اساس ارقام منتشرشده، اوپنایآی مدعی است که مدلهای جدیدتر با هزینه کمتر به دقت بالاتری میرسند. این شرکت هزینه اجرای GPT-6.1 Sol با سطح استدلال پایین را معادل ۶۱ درصد هزینه API مدل GPT-5.6 Sol اعلام کرده است. همچنین هزینه هر نمونه در آزمون MultiLangBench برای GPT-6 Luna برابر با ۰٫۷۷ دلار و برای GPT-5.6 Sol برابر با ۳٫۴۸ دلار گزارش شده است.
بااینحال، این نتایج حاصل آزمونهای اوپنایآی روی مدلهای خود این شرکت هستند و در آنها امتیازی برای مدلهای رقیب ارائه نشده است. بنابراین، این ارقام بیشتر نمایانگر توانمندیهایی هستند که اوپنایآی برای کار با سامانههای مینفریم مطرح میکند، نه رتبهبندی مستقیمی در مقایسه با ابزارهای AWS یا IBM.
اوپنایآی، ۱۹ اکتبر ۲۰۲۶: «استفاده از این قابلیتها در نرمافزارهای عملیاتی همچنان به بررسی کارشناسی و آزمون در برابر قواعد کسبوکار و وابستگیهای سامانه نیاز دارد.»
سه نکته اصلی
امتیاز آزمون COBOL: اوپنایآی برای GPT-6.1 Sol در ارزیابی مهاجرت COBOL، با سطح استدلال پایین دقت ۸۶٫۶ درصد و با سطح استدلال بالاتر دقت ۹۷٫۹ درصد را گزارش کرده است. امتیاز GPT-5.6 Sol در سطح استدلال پایین ۵٫۴ درصد بود.
آزمون ۲۰ زبان: میانگین امتیاز GPT-6 Astra در آزمون MultiLangBench به ۸۷٫۴ درصد رسیده است؛ درحالیکه این رقم پیشتر ۲۶٫۸ درصد بود. اوپنایآی اعلام کرده است که مجموعه آزمون این ارزیابی را در گیتهاب منتشر میکند.
محدودیت استفاده عملیاتی: اوپنایآی میگوید استفاده از این مدلها در محیط عملیاتی همچنان مستلزم بررسی کارشناسان و آزمودن کد در برابر قواعد کسبوکار و وابستگیهای هر سامانه است.
نگاه چارچوب Business Engineer
این موضوع با چارچوب «هوش مصنوعی سازمانی: از نرمافزار تا زیرساخت پایه» از مجموعه Business Engineer ارتباط مفهومی دارد.
این چارچوب استدلال میکند که هزینه تغییر سامانه در سازمانها صرفاً ناشی از دشواری انتقال دادهها نیست، بلکه از این واقعیت ناشی میشود که «۴۷ سامانه دیگر اکنون وجود شما را مفروض میدانند».
از این منظر، سامانههای COBOL میتوانند چنین نقش زیربناییای داشته باشند و آزمون مهاجرت اوپنایآی نیز بررسی میکند که آیا بازنویسی کد، رفتار برنامه موجود را حفظ میکند یا خیر. این چارچوب در دسامبر ۲۰۲۵ منتشر شده است و به پست اوپنایآی درباره این نتایج نمیپردازد.
چه چیزهایی هنوز اثبات نشدهاند؟
ارزیابیهای منتشرشده، آزمونهای خود اوپنایآی روی مدلهای خود این شرکت هستند و نتایج مدلهای شرکتهای دیگر را در بر نمیگیرند. اوپنایآی نام مشتریان سازمانیای را که بازخوردشان در توسعه این قابلیتها نقش داشته اعلام نکرده است. همچنین مشخص نکرده که مدلهایش روی کدهای عملیاتی هیچیک از مشتریان چه عملکردی دارند.
جمعبندی نهایی
اوپنایآی در ۱۹ اکتبر ۲۰۲۶ اعلام کرد که GPT-6.1 Sol در ارزیابی اختصاصی مهاجرت COBOL با سطح استدلال پایین به امتیاز ۸۶٫۶ درصد رسیده است؛ درحالیکه امتیاز GPT-5.6 Sol برابر با ۵٫۴ درصد بود. همچنین GPT-6 Astra در آزمون MultiLangBench، میانگین امتیاز ۸۷٫۴ درصد را در ۲۰ زبان برنامهنویسی ثبت کرد؛ درحالیکه میانگین قبلی ۲۶٫۸ درصد بود. این نتایج متعلق به ارزیابیهای خود اوپنایآی هستند و این شرکت اعلام کرده است که مجموعه آزمون MultiLangBench را در گیتهاب منتشر میکند.
منابع: اوپنایآی، ۱۹ اکتبر ۲۰۲۶؛ اوپنایآی در ایکس، ۱۹ اکتبر ۲۰۲۶؛ صفحه محصول AWS Transform for mainframe، بررسیشده در ۱۹ اکتبر ۲۰۲۶؛ صفحه محصول IBM watsonx Code Assistant for Z، بررسیشده در ۱۹ اکتبر ۲۰۲۶.
یادداشت درباره منابع: این گزارش بر اساس مطلب اوپنایآی در ۱۹ اکتبر ۲۰۲۶ و پست این شرکت در ایکس تهیه شده است. تمام امتیازها مربوط به ارزیابیهای اوپنایآی از مدلهای خودش هستند. توضیحات مربوط به AWS و IBM از صفحات محصولات این شرکتها گرفته شدهاند. اختلافهای بیانشده بر حسب واحد درصد، محاسبات نویسنده گزارش هستند. این مطلب پیشبینی آینده نیست و توصیه مالی یا سرمایهگذاری محسوب نمیشود.