
ارجاعات ساختگی تولیدشده با هوش مصنوعی، مقالهای داوریشده درباره زد-لایبرری را زیر سؤال برد
نویسنده: النا وارگا
در پژوهشی درباره کتابخانههای سایه که در مجله New Review of Academic Librarianship منتشر شده، ارجاعاتی وجود دارد که به نظر میرسد واقعی نیستند؛ از جمله مقالهای ساختگی منتسب به وبسایت TorrentFreak و مقالاتی که عنوان یا مشخصات انتشار آنها بهاشتباه به نشریات علمی نسبت داده شده است. نویسندگان این پژوهش استفاده از ابزارهای هوش مصنوعی Consensus و ChatGPT را تأیید کردهاند و انتشارات تیلور و فرانسیس بررسی اخلاقی این پرونده را آغاز کرده است.
مقالهای داوریشده درباره زد-لایبرری که همین ماه در مجله New Review of Academic Librarianship منتشر شده، دستکم ۱۰ منبع را در فهرست ارجاعات خود آورده است که پژوهشگران نتوانستهاند آنها را پیدا کنند. این مطالعه را دو کتابدار شاغل در دانشگاههای نیجریه نوشتهاند و در آن بررسی کردهاند که آیا این کتابخانه سایه به دموکراتیکتر شدن دسترسی به دانش کمک میکند یا به اصول اخلاقی مرتبط با حق نشر آسیب میزند.
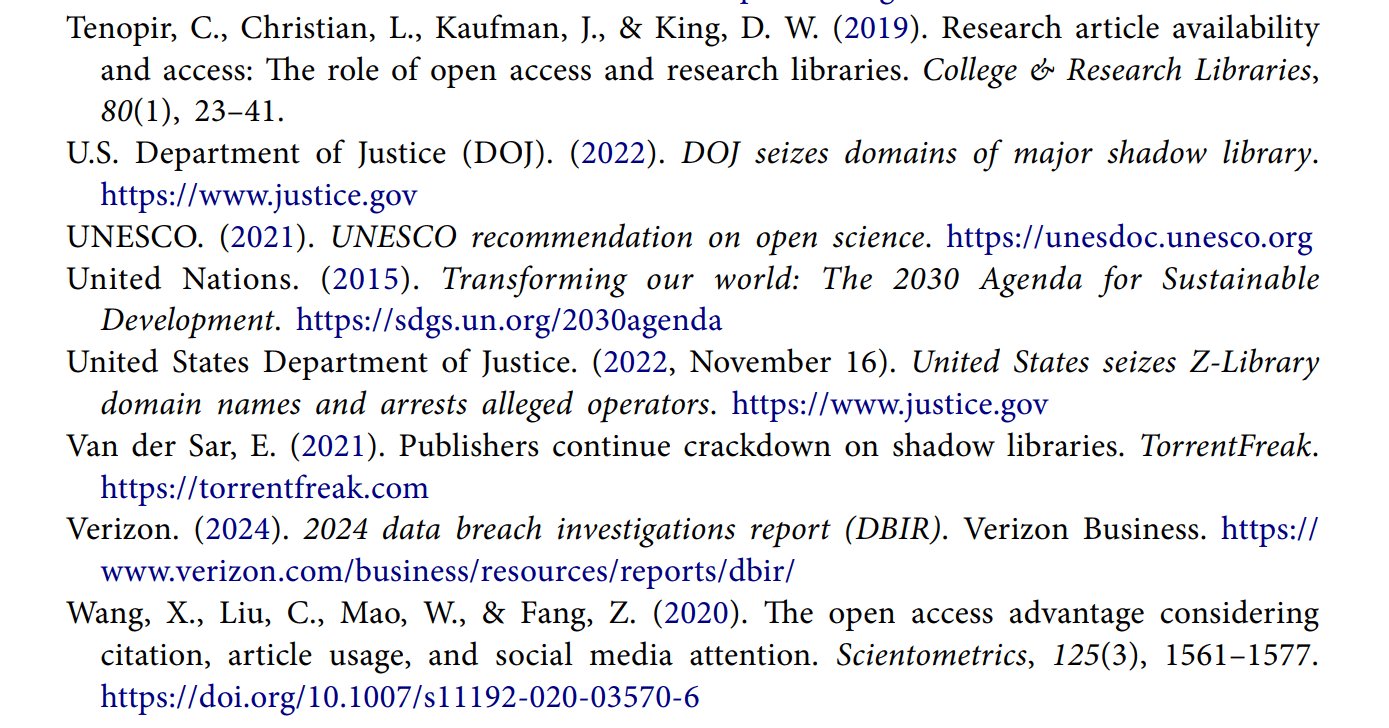
نخستین مورد به وبسایت TorrentFreak مربوط میشود. نویسندگان در بخشی درباره اقدامات قضایی و اجرایی علیه کتابخانههای سایه ادعا میکنند که ناشران بزرگی، از جمله الزویر و اشپرینگر نیچر، علیه زد-لایبرری اقدام قانونی کردهاند. آنها برای اثبات این ادعا به مقالهای منتسب به سال ۲۰۲۱ با عنوان «ناشران به سرکوب کتابخانههای سایه ادامه میدهند» استناد کردهاند؛ اما چنین مقالهای هرگز در TorrentFreak منتشر نشده است. پیوند درجشده در ارجاع نیز به صفحه اصلی این وبسایت میرسد و اقدام قضایی توصیفشده با هیچ پرونده گزارششدهای مطابقت ندارد. TorrentFreak پیشتر درباره دستورهای مسدودسازی وبسایت Sci-Hub در بریتانیا و تعلیق موقت دامنههای زد-لایبرری گزارش داده بود، اما پرونده قضایی مشخصی را که در مقاله ادعا شده، پوشش نداده است.
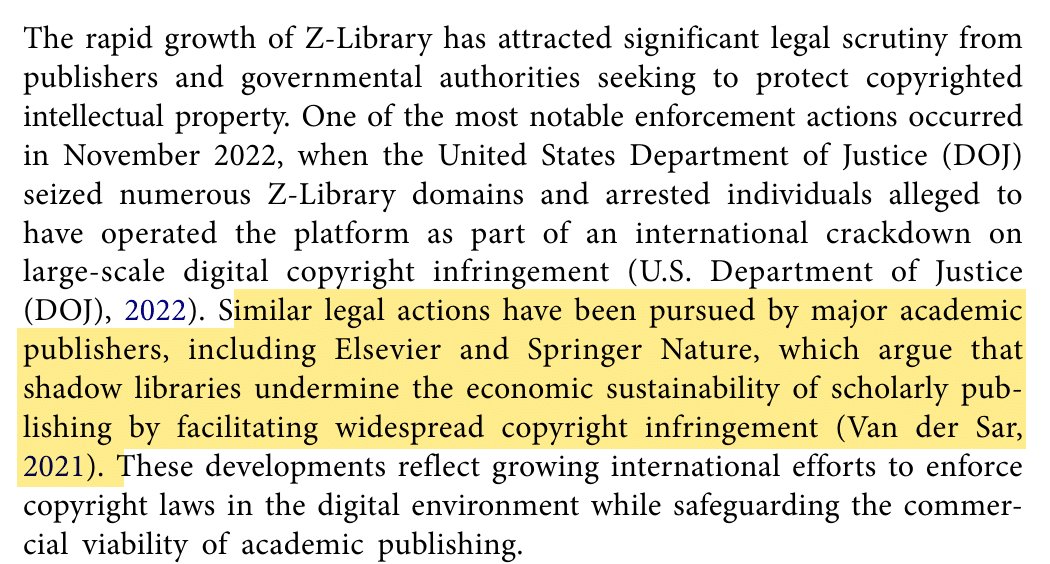
نویسندگان در توصیف پرونده وزارت دادگستری ایالات متحده نیز اطلاعات را نادرست بازتاب دادهاند. در مقاله آمده است که مقامها در سال ۲۰۲۲ افرادی را «بازداشت کردند»، اما اطلاعیه مطبوعاتی وزارت دادگستری توضیح میدهد که بازداشتها در آرژانتین و به درخواست ایالات متحده انجام شدهاند. عنوانی هم که نویسندگان برای آن اطلاعیه ذکر کردهاند، وجود خارجی ندارد.
از دیگر ارجاعات مشکوک میتوان به مقالهای منتسب به سال ۲۰۱۹ در مجله Harvard Journal of Law & Technology اشاره کرد که نام دانیل ژروه، استاد حقوق مالکیت فکری، بهعنوان نویسنده آن آمده است. عنوان ادعایی مقاله «آینده مالکیت فکری در سایه کتابخانههای سایه» است، اما چنین مقالهای در شماره مورد استناد وجود ندارد و شماره صفحات ذکرشده به مقالات دیگری تعلق دارند. همچنین، مقالهای که به سال ۲۰۱۹ و مجله College & Research Libraries نسبت داده شده و نام کارول تنوپیر و همکارانش را دارد، در شماره مورد اشاره پیدا نمیشود. تنوپیر در همان سال در پژوهشی با موضوعی مرتبط مشارکت داشته، اما آن پژوهش در مجلهای دیگر و با عنوانی متفاوت منتشر شده است. منابع مفقود دیگری نیز شامل مقالاتی منتسب به بیورن برمز و نویسندگانی با نامهای اسمیت، پایپر، اوکیکه و آرونسون، و همچنین گزارشی از کسپرسکی درباره خطرات پنهان کتابخانههای سایه هستند.
بخش قدردانی مقاله سرنخی درباره منشأ احتمالی این مشکل به دست میدهد. نویسندگان نوشتهاند که برای بررسی منابع علمی و استخراج اطلاعات از ابزار هوش مصنوعی Consensus استفاده کردهاند. آنها همچنین گفتهاند ChatGPT در بهبود زبان بخشهایی از دستنوشته به کار رفته است. چتباتهای هوش مصنوعی گاهی ارجاعاتی با عنوانهای باورپذیر و نام پژوهشگران واقعی تولید میکنند؛ الگویی که با موارد مشاهدهشده در این مقاله مطابقت دارد. ابزار تشخیص محتوای تولیدشده با هوش مصنوعی Pangram نیز به چکیده و نتیجهگیری مقاله امتیاز ۱۰۰ درصد داده است. البته چنین ابزارهایی ممکن است نتایج مثبت کاذب ارائه دهند، اما این نتیجه با وجود ارجاعات ساختگی همخوانی دارد.
تناقض ماجرا از این هم فراتر میرود. نویسندگان هشدار میدهند که زد-لایبرری درآمد ناشران را تهدید میکند؛ درآمدی که به گفته آنها هزینه داوری علمی و ویرایش را تأمین میکند. بااینحال، آنها اشاره نمیکنند که داوران علمی بدون دریافت دستمزد کار میکنند؛ نکتهای که در دعاوی حقوقی اخیر علیه ناشران بزرگ، از جمله تیلور و فرانسیس، جایگاه مهمی داشته است. از سوی دیگر، صاحبان حقوق آثار نیز از شرکتهای هوش مصنوعی بهدلیل آموزش مدلهایشان با استفاده از کتابخانههای سایهای مانند زد-لایبرری شکایت کردهاند. اکنون این احتمال مطرح است که مقالهای داوریشده درباره همین کتابخانه، برای تولید ارجاعات خود به هوش مصنوعی متکی بوده باشد.
انتشارات تیلور و فرانسیس اعلام کرده است که این موضوع را به تیمهای سردبیری و اخلاق و سلامت نشر ارجاع داده است. سخنگوی این انتشارات گفت: «میتوانم تأیید کنم که این موضوع به تیمهای سردبیری و اخلاق و سلامت نشر ما ارجاع شده است؛ این تیمها نگرانیهایی را که مطرح کردهاید بررسی خواهند کرد.» ناشر تا پایان بررسی از ارائه توضیحات بیشتر خودداری کرده است. نویسنده اصلی مقاله نسخه اولیه آن را در اختیار گزارشگر قرار داده، اما به پرسشهای تکمیلی درباره ارجاعات پاسخ نداده است. ژروه، برمز و تنوپیر نیز به پرسشها درباره مقالاتی که به آنها نسبت داده شده بود، پاسخی ندادهاند.
هنوز مشخص نیست که مجله این پژوهش را اصلاح خواهد کرد یا آن را پس خواهد گرفت. مقاله با عنوان «زد-لایبرری و دسترسی به متن کامل: دموکراتیکسازی دانش یا تضعیف اخلاق حق نشر؟» از طریق وبسایت مجله در دسترس است.
منبع: TorrentFreak