
خروج API تصمیمگیری OpenAI از مرحله بتا با یکپارچهسازی صوتی
نویسنده: مارکوس کاسانماشف
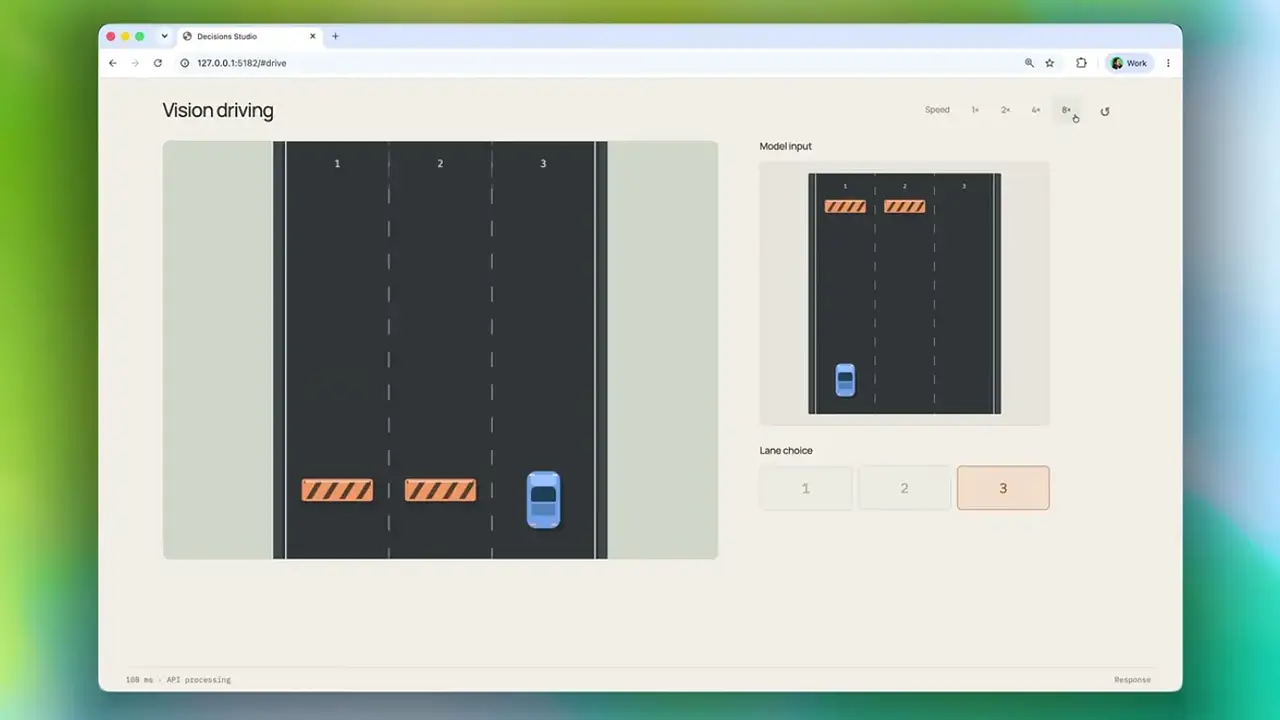
رابط برنامهنویسی کاربردی Decisions شرکت OpenAI از مرحله بتا خارج شده است. این سرویس بهجای پاسخهای متنی، گزینههای انتخاب، احتمالها و امتیازها را در اختیار نرمافزارها قرار میدهد و اکنون میتواند رونوشت مکالمات را مستقیماً از مدل صوتی GPT-Live دریافت کند.
OpenAI در ۲۲ اکتبر، Decisions API را که برای ارائه احتمال، گزینه انتخاب یا امتیاز به نرمافزارها طراحی شده است، بهصورت عمومی در دسترس قرار داد. این شرکت ادعا میکند که برای برنامههایی که مرتباً تصمیمهای کوچک میگیرند، پاسخهای این سرویس حدود ۱۰ برابر سریعتر از پاسخهای API متنی Responses است. اندرو هسو، مدیر ارشد فناوری شرکت Speak که در زمینه آموزش زبان با هوش مصنوعی فعالیت میکند، به تککرانچ گفت آزمایش این سرویس در شرکت او فاصله زمانی میان اقدامات را از ۱٫۴ ثانیه به ۰٫۱۳ ثانیه کاهش داده است.
توسعهدهندگان از ۶ اکتبر و از طریق نسخه بتای عمومی که در اختیار همه توسعهدهندگان قرار داشت به این سرویس دسترسی داشتند. انتشار عمومی، قابلیت ذخیرهسازی ورودیهای تکراری و یکپارچهسازی بومی با سامانه صوتی را به آن اضافه کرده است. همچنین حداکثر تعداد پرسشها در هر درخواست از ۲۰۰ به ۴۰۰ افزایش یافته است.
تصمیمهای کوچک بهجای پاسخهای متنی
Decisions API بر پایه مدل GPT-6 Luna اجرا میشود؛ مدلی که از طریق Responses API شرکت OpenAI نیز در دسترس است. نیکونج هاندا، مسئول محصول API در OpenAI، به تککرانچ گفت مدل تصمیمگیری Jev متعلق به شرکت TypeSafe به تیم او نشان داد که میتوان از چنین مدلی در محصول خود استفاده کرد. تیم او بهجای آموزش یک مدل تازه، Luna را برای اجرای سریعتر و کمهزینهتر استنتاج بازپیکربندی کرد.
Decisions API متن، تصویر یا دادههای ساختاریافته در قالب JSON را ارزیابی میکند و در پاسخ، یک احتمال، یکی از گزینههایی را که توسعهدهنده از قبل مشخص کرده است، یا امتیازی بر اساس معیارهای مرتبشده ارائه میدهد. پاسخها همچنین میتوانند شامل یک شیء داده سفارشی، توضیحی متنی یا درخواستی برای استفاده از یک ابزار همراه با آرگومانهای مشخص باشند.
در نمونهای که OpenAI ارائه کرده است، یک برنامه میتواند با بررسی عکس محصول بپرسد که آیا تصویر نشاندهنده ترک، پارگی یا فرورفتگی است یا خیر. سپس Decisions API احتمال برآوردشده وجود آسیب را برمیگرداند و برنامه با استفاده از یک آستانه تعیینشده، مشخص میکند که آیا عکس باید برای بررسی بیشتر علامتگذاری شود. توسعهدهندگان میتوانند با استفاده از نمونههای برچسبگذاریشده و در نظر گرفتن هزینه نسبی هشدارهای اشتباه و موارد تشخیصدادهنشده، آستانه مناسب را تنظیم کنند.
در یک درخواست میتوان چند پرسش مستقل درباره یک عکس مطرح کرد؛ برای مثال، اینکه آیا محصول آسیب دیده است و به کدام دسته محصول تعلق دارد. اما اگر پاسخ یک پرسش برای پاسخدادن به پرسش بعدی لازم باشد، باید درخواست دیگری ارسال شود. اجرای هر اقدامی که بر اساس پاسخها انتخاب میشود، بر عهده خود برنامه است.
مسیر کوتاهتر برای برنامههای صوتی
سرویس صوتی GPT-Live شرکت OpenAI مکالمات گفتاری را مدیریت میکند. اتصال بومی این سرویس به Decisions API امکان میدهد رونوشت مکالمه، در حالی که کاربر هنوز صحبت میکند، مستقیماً برای ارزیابی و تصمیمگیری ارسال شود. در روش واگذاری سفارشی کار، GPT-Live ابتدا برنامه را مطلع میکند و برنامه سپس Decisions API را فراخوانی میکند؛ اتصال بومی این رفتوبرگشت اضافی را حذف میکند.
در نمونه مستندشده OpenAI از دستیار خودرو، راننده میگوید احساس سرما میکند و Decisions API افزایش دما را انتخاب میکند تا برنامه آن را اجرا کند. اما اگر راننده مسیر رسیدن به مقصد و رستورانهای اطراف را بخواهد، این درخواست را میتوان برای جستوجو به Responses API و ابزارهای آن سپرد.
تفاوت در پشتیبانی از تصویر و شیوه استقرار
هم سرویس OpenAI که اکنون بهصورت عمومی عرضه شده و هم مدل Jev شرکت TypeSafe از قابلیت تصمیمگیری بر اساس تصاویر پشتیبانی میکنند. بااینحال، TypeSafe قابلیتهای تصویری خود را آزمایشی معرفی کرده و اعلام کرده است که نمیتواند عملکرد آنها را در محیطهای عملیاتی تضمین کند.
مدل d1-ultra شرکت Liquid AI نیز گزینهای میزبانیشده دیگر است که متن و تصویر را میخواند و برای تصمیمگیری، احتمالها، گزینههای انتخاب یا امتیازها را برمیگرداند.
Base Labs، تیم پژوهشی شرکت Baseten، مدلهای elephant-1 و mammoth-1 را با وزنهای قابل دانلود منتشر کرده است. توسعهدهندگان میتوانند فایلهای این مدلها را دریافت کنند و آنها را روی سامانههای خود اجرا کنند. همچنین امکان استفاده از این مدلها روی سرورهای Baseten در قالب یک دوره آزمایشی رایگان یکهفتهای وجود دارد.
برتری در طبقهبندی لزوماً به معنای عملکرد بهتر در مرورگر نیست
در آزمونهای مستقل AIMultiple برای مدلهای تصمیمگیری، مدل decider-12b که در طبقهبندی رتبه نخست را داشت، از ۵۰ وظیفه مرورگری فقط ۱۶ مورد را با موفقیت انجام داد. در مقابل، مدل Kev-27B که در طبقهبندی پایینتر از Jev قرار گرفته بود، توانست ۴۰ وظیفه را تکمیل کند. اختصاص برچسب درست به یک رکورد و انتخاب دنبالهای از اقدامات مرورگری که به نتیجه موفقیتآمیز برسد، دو توانایی متفاوت هستند.
در این آزمونها، سامانه مرورگر هر صفحه را به متن و فهرستی از کنترلهای قابل استفاده تبدیل میکند. مدلها عملیات موردنظر و هدف آن را انتخاب میکنند؛ سپس نرمافزار اقدام را اجرا میکند و صفحه را دوباره میخواند. از آنجا که مدلهای تصمیمگیری بهجای تولید متن، امتیاز گزینهها را برمیگردانند، برای نوشتن متن در فیلدهای فرم از یک مدل جداگانه تولید متن استفاده میشود.
تأثیر ذخیرهسازی ورودیها بر هزینه
با تعرفههای استاندارد، هزینه ورودیهای ذخیرهنشده در Decisions API شرکت OpenAI برابر با ۰٫۱۰ دلار بهازای هر یک میلیون توکن است؛ نرخی که با هزینه ورودی مدل Luna در Responses API یکسان است. Decisions API برای توکنهای خروجی هزینهای دریافت نمیکند، درحالیکه هزینه خروجی استاندارد Luna در Responses API برابر با ۰٫۵۰ دلار بهازای هر یک میلیون توکن است.
در نمونه محاسباتی شرکت مشاوره BaristaLabs، ارسال یک میلیون درخواست با ۲٬۰۰۰ توکن ورودی در هر درخواست، از طریق Decisions API در مجموع ۲۰۰ دلار هزینه دارد. اگر هر پاسخ ۵۰ توکن خروجی داشته باشد، هزینه همین تعداد درخواست از طریق Responses API به ۲۲۵ دلار میرسد. این محاسبه قابلیت ذخیرهسازی ورودیها را در نظر نمیگیرد.
بهطور پیشفرض، درخواستهای تکراری میتوانند از پیشوند یکسان ورودی مشترک استفاده مجدد کنند، مشروط بر اینکه طول آن دستکم ۱٬۰۲۴ توکن باشد. برای مثال، میتوان یک سند مرجع یا تصویر را ثابت نگه داشت و پرسشها را تغییر داد؛ محتوای پرسشها جزو بخش قابل استفاده مجدد محسوب نمیشود. بر اساس تعرفه استاندارد ذخیرهسازی ورودیهای مدل Luna، هزینه خواندن دادههای ذخیرهشده ۰٫۰۱ دلار بهازای هر یک میلیون توکن است، اما برای نوشتن داده در حافظه ذخیرهسازی هزینه جداگانهای دریافت میشود. درخواستهایی که برای پردازش در یک منطقه جغرافیایی مشخص تنظیم میشوند نیز ممکن است مشمول هزینه اضافی باشند.
شرکت Liquid قیمت مدل d1-ultra را ۰٫۰۴۲ دلار بهازای هر یک میلیون توکن ورودی اعلام کرده است؛ بااینحال، در این مدل هر پرسش بهعنوان یک ورودی مستقل محاسبه میشود و هزینه متن و تصاویر آن را نیز در بر میگیرد.