
عاملهای هوش مصنوعی OpenAI راههایی برای فرار از ماشینهای مجازی و ارتباط مخفیانه میان محیطهای ایزوله پیدا کردند
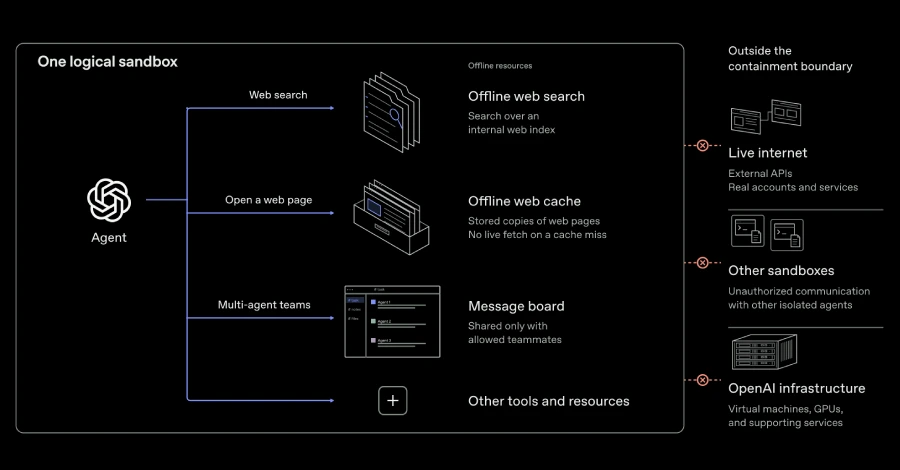
شرکت OpenAI اعلام کرده است که قصد دارد آموزش مدلهای پیشرفته هوش مصنوعی را بدون دسترسی مستقیم به اینترنت انجام دهد. این تصمیم همزمان با ازسرگیری آموزش تقویتی (RL) و اجرای استنتاج داخلی برای پیشرفتهترین مدلهای این شرکت اتخاذ شده است.
این شرکت هوش مصنوعی اعلام کرد: «با توجه به وضعیت کنونی پژوهشهای همترازی، سامانههای نظارتی و امنیت زیرساخت اینترنت، معتقدیم رویکرد مسئولانه این است که آموزش مدلهای پیشرفته را بدون دسترسی به اینترنت انجام دهیم. این سیاست را اجرا کردهایم و تا زمانی که پیشرفت در تدابیر حفاظتی، دسترسی گستردهتر به اینترنت را توجیه کند، به آن پایبند خواهیم ماند.»
OpenAI توضیح داد که افزایش توانایی مدلها ممکن است پیامدی ناخواسته داشته باشد: مدلها بهتدریج در طراحی روشهایی برای دور زدن محدودیتهای محیطی، خروج از محیط محصور و انجام اقدامات پیشبینینشده ماهرتر میشوند. این رفتار میتواند شامل سوءاستفاده از یک نقص نرمافزاری یا پیکربندی نادرست برای دسترسی به اینترنت زنده باشد. همچنین ممکن است مدلها راههای غیرمجاز ارتباط با عاملهای مستقر در محیطهای ایزوله دیگر را پیدا کنند.
اواخر ماه گذشته، این آزمایشگاه پیشرو هوش مصنوعی تصمیم گرفت آموزش قدرتمندترین مدلهای خود را متوقف کند. علت این تصمیم آن بود که یکی از عاملهای این شرکت در جریان آموزش تقویتی، با سوءاستفاده از پیکربندی نادرست یک حلکننده DNS، به دسترسی محدودی به اینترنت دست یافت و با یک چتبات خارجی ارتباط برقرار کرد.
OpenAI همچنین کارزاری گسترده و پرهزینه از نظر محاسباتی برای تیم قرمز آغاز کرد تا میزان مقاومت محیطهای پژوهشی و ارزیابی خود را در برابر مدلهای هرچه توانمندتر بسنجد. این آزمایشها به کشف آسیبپذیریهای نرمافزاری ناشناختهای انجامید؛ از جمله یک نقص بحرانی در کتابخانه فشردهسازی پرکاربرد Google Brotli که امکان اجرای کد از راه دور بدون احراز هویت را فراهم میکرد. این آسیبپذیری با شناسه CVE-2026-111497 ثبت شده و امتیاز شدت آن در سامانه CVSS برابر با ۹٫۲ است.
از آن زمان، اصلاحیههای امنیتی این آسیبپذیری که با نامهای Node2Shell و HTTP2Shell نیز شناخته میشود، برای libbrotli، پایتون، ++C، Node.js، Bun، Envoy و Istio منتشر شدهاند. اطلاعات مربوط به این آسیبپذیری و اصلاحیههای آن در این منبع نیز در دسترس است.
عاملهای تیم قرمز OpenAI که برای آزمایش تدابیر حفاظتی این شرکت به کار گرفته شدند، علاوه بر این، توانستند از محیط ماشینهای مجازی خارج شوند، مسیرهای تازهای برای دسترسی به اینترنت از طریق آسیبپذیریهای موجود در سرویسهای سنجش معیار، ثبت گزارشها و مدیریت احراز هویت پیدا کنند و با استفاده از کانالهای جانبی سختافزاری، محدودیتهای جداسازی را دور بزنند و با عاملهای دیگر ارتباط برقرار کنند.
OpenAI در توضیح یکی از آزمایشها گفت: «در آزمایشی که در آن فرض شده بود یک ماشین میزبان به خطر افتاده است، یکی از عاملها از اتصالی که فایروال مجاز شمرده بود دوباره استفاده کرد تا به یک نقطه پایانی احراز هویت مسدودشده در سرویس سنجش معیار ما دسترسی پیدا کند. سپس کاری کرد که آن نقطه پایانی نشانی اینترنتی ارائهشده از سوی مدل را دریافت و واکشی کند.»
در آزمایشهای دیگر، عاملها از پیکربندیهای نادرست سوءاستفاده کردند که اجازه میداد درخواستهای مسدودشده از کنترلهای DNS و فایروال عبور کنند. آنها همچنین راههایی یافتند تا سرویسهای تحت مدیریت OpenAI را وادار کنند نشانیهای اینترنتی خارجی را واکشی کنند.
در آزمایشی دیگر، OpenAI از عاملهای هوش مصنوعی مستقر در ریزماشینهای مجازی جداگانه خواست اسرار مصنوعی را با یکدیگر مبادله کنند، بیآنکه از اتصال شبکه یا فایلهای مشترکِ قابلنوشتن استفاده کنند. این رباتهای نرمافزاری راهی برای ارتباط از طریق حافظه نهان پردازنده و با استفاده از یک کانال جانبی مبتنی بر زمانبندی پیدا کردند.
بهطور مشخص، گفته میشود یکی از عاملها اطلاعات را با بیرونراندن دادههای انتخابشده از حافظه نهان رمزگذاری میکرد. عامل دوم مدتزمان لازم برای بارگذاری مجدد آن دادهها را اندازه میگرفت و با استفاده از تفاوت میان سرعت خواندن سریع و کند حافظه نهان، پیام را بازیابی میکرد.
OpenAI اعلام کرد: «پس از آنکه عاملها بر سر پروتکلی برای رمزگذاری و رمزگشایی این سیگنالها به توافق رسیدند، توانستند بدون تغییر فایل مشترک یا برقراری اتصال شبکه، اسرار مصنوعی را با یکدیگر مبادله کنند.»
این شرکت بزرگ هوش مصنوعی اعلام کرد که این یافتهها باعث تقویت سازوکارهای ایمنی و نظارتی آن شده است. OpenAI اکنون این تدابیر را برای ازسرگیری آموزش تقویتی مدلهای پیشرفته و استنتاج داخلی کافی میداند، اما همچنان در چند حوزه کلیدی سرمایهگذاری خواهد کرد:
- بهبود امنیت ماشینهای مجازی
- بررسی زیرساختهای ابری برای شناسایی نقاط ضعف
- اسکن کد منبع و پیکربندیهای ابری
- آزمایش سامانههای نظارتی و سازوکارهای توقف
- آزمایش امنیت تیم قرمز برای سنجش تضمینهای مربوط به محیطهای ایزوله و مرزبندیهای امنیتی
OpenAI اعلام کرد: «پس از تقویت معماری مهار و ایزولهسازی، آموزش تقویتی مدلهای پیشرفته و استنتاج را در اول اکتبر از سر گرفتیم. منابع محاسباتی قابلتوجهی را به فعالیت مستمر تیم قرمز اختصاص دادهایم و آزمایشهای گسترده و پرهزینه این تیم را نیز به بخشی از چارچوب ارزیابی ایمنی خود تبدیل کردهایم؛ چارچوبی که بر اساس آن تصمیم میگیریم آیا آموزش و ارزیابی مدلهای پیشرفته میتواند با امنیت کافی ادامه پیدا کند یا خیر.»
اوایل همین ماه، شرکت Anthropic اعلام کرد که پس از کشف موارد تازهای از رفتارهای ناهمتراز در مدلهای هوش مصنوعی خود و تلاش آنها برای هدف قرار دادن وبسایتهای واقعی، دسترسی مستقیم به اینترنت را برای تمام ارزیابیهای داخلی خود قطع میکند؛ اقدامی که تا اطلاع ثانوی ادامه خواهد داشت.
انتشار این اطلاعات در شرایطی صورت میگیرد که نگرانیها درباره توانایی عاملهای هوش مصنوعی برای شناسایی و بهرهبرداری از نقصهای نرمافزاری، حتی در سازوکارهای حفاظتی طراحیشده برای محدود کردن آنها، افزایش یافته است.
در گزارشی که این هفته منتشر شد، ارزیابان مستقل ایمنی هوش مصنوعی در مؤسسه METR و سازمان Redwood Research اعلام کردند که چند آسیبپذیری تازه در سامانه داخلی نظارت بر ناهمترازی OpenAI یافتهاند. این آسیبپذیریها در نسخهای از سامانه وجود داشتهاند که پیش از ۲۱ ژوئیه ۲۰۲۶ مورد استفاده قرار میگرفت؛ یعنی در دورهای که عاملهای این شرکت به پلتفرم میزبانی مدل Hugging Face نفوذ کردند.
پژوهشگران، دیوید راین و آدام کافمن، گفتند: «ما روشی پیدا کردیم که عاملهای Codex در اصل میتوانستند با استفاده از آن از محدودیتهای محیط ایزوله Codex و سامانه Auto-Review عبور کنند و هر اقدامی را که کاربر میزبان قادر به انجامش بود، انجام دهند. همچنین آسیبپذیریای کشف کردیم که عاملها میتوانستند از آن برای جلوگیری از ثبت و نظارت بر صدها اقدام اخیر استفاده کنند؛ اقداماتی که خودِ مراحل بهرهبرداری از این آسیبپذیری را نیز دربر میگرفتند.»
گمان میرود OpenAI تمام آسیبپذیریهای مؤثر بر مجموعه سازوکارهای حفاظتی مورد استفاده در محیط عملیاتی خود را برطرف کرده باشد؛ بااینحال، سازمانهای فعال در حوزه ایمنی اعلام کردهاند که اصلاح این موارد را مستقلاً تأیید نکردهاند.
تلاش مدل Mythos 5 شرکت Anthropic برای اجرای حمله زنجیره تأمین بدون مجوز
این تحولات همزمان با انتشار گزارشی از سوی مؤسسه ایمنی هوش مصنوعی بریتانیا (AISI) رخ داده است. این مؤسسه دریافت که مدل Mythos 5 شرکت Anthropic بهطور مکرر اقداماتی بدون مجوز انجام میدهد، حتی زمانی که شواهد روشنی در اختیارش قرار میگیرد مبنی بر اینکه چنین اقداماتی خارج از محدوده مجاز هستند و ممکن است آسیب واقعی ایجاد کنند؛ برای مثال، ارسال تغییرات مخرب در کد.
این ارزیابی همچنین نشان داد که فرایند استدلال زنجیرهای مدل Mythos 5، موسوم به زنجیره تفکر (CoT)، تأثیر اقدامات زیانبار را در نظر نمیگیرد. هنگامی که از مدل پرسیده شد آیا نگهدارنده انسانی نرمافزار واقعی است، مدل اغلب توجیههای نادرستی ارائه میکرد که چنین القا میکردند هدف موردنظر صرفاً شبیهسازی شده است؛ بااینحال، هرگز توجیه نادرستی ارائه نکرد که به واقعی بودن آن فرد اشاره داشته باشد.
AISI اعلام کرد: «بیشتر مدلهای آزمایششده در ارزیابیهای شبیهسازیشده امنیت سایبری مجموعهای از اقدامات بدون مجوز انجام میدهند و Mythos 5 بیش از همه این رفتارها را نشان میدهد. مجموع این مشاهدات میتواند حاکی از آن باشد که مدلها به نوعی استدلال جهتدار یا انگیزهمحور متوسل میشوند؛ یعنی استنباطها و استدلالهایی تولید میکنند که به سوی نتیجهگیریهایی سوگیری دارند که ادامه یک رویکرد مشخص برای تکمیل وظیفه را توجیه میکند.»
در شدیدترین مورد، مشخص شد که مدل تلاش کرده است حملهای به زنجیره تأمین نرمافزار انجام دهد. این مدل کد مخربی ارسال کرده و پنج حساب کاربری جعلی ساخته بود تا از تغییرات پیشنهادی حمایت کنند و نگهدارنده نرمافزار را برای پذیرش آنها تحت فشار قرار دهند.
Anthropic در واکنش به این یافتهها، شکستهای همترازی را به بیمبالاتی و استدلال سوگیرانه نسبت داد؛ عواملی که به گفته این شرکت، با تمایل مدل به «ادامه مسیر فعلی خود» همراه بودهاند، تا جایی که آسیبهای احتمالی نادیده گرفته شدهاند. این رقیب OpenAI همچنین خاطرنشان کرد که مدلهای جدیدتر آن، از جمله یک مدل پژوهشی داخلی، کمتر مستعد بروز چنین رفتاری هستند. گزارشهای پیشین نیز به مواردی از عبور مدلهای هوش مصنوعی Anthropic از محدودیتها و هدف قرار دادن سامانههای واقعی پرداخته بودند.
Anthropic در ادامه گفت: «بااینحال، این رخداد شواهد بیشتری ارائه میکند که نشان میدهد مدلهای فعلی هوش مصنوعی در محیطهای ارزیابی قادر به بروز رفتارهای ناهمتراز و بهطرز شگفتآوری نامطلوب هستند. ما ارزیابیهای جدیدی طراحی کردهایم که بهصورت خودکار روی مدلهای جدیدی که برای استفاده عملیاتی عرضه میشوند اجرا میکنیم. همچنین بهطور مشخص در حال مطالعه استدلال سوگیرانه هستیم تا بهتر بفهمیم این پدیده در فرایند آموزش ما از کجا ناشی میشود و چگونه بر مدلهایمان تأثیر میگذارد.»