
مقایسه Kimi K3.1 Pro و Claude Fable 5.1؛ یکپنجم قیمت و دو امتیاز بالاتر در شاخص مستقل
راهنماها و تحلیلها
نویسنده: روآن استرلینگ
تاریخ انتشار: ۲۵ اکتبر ۲۰۲۶
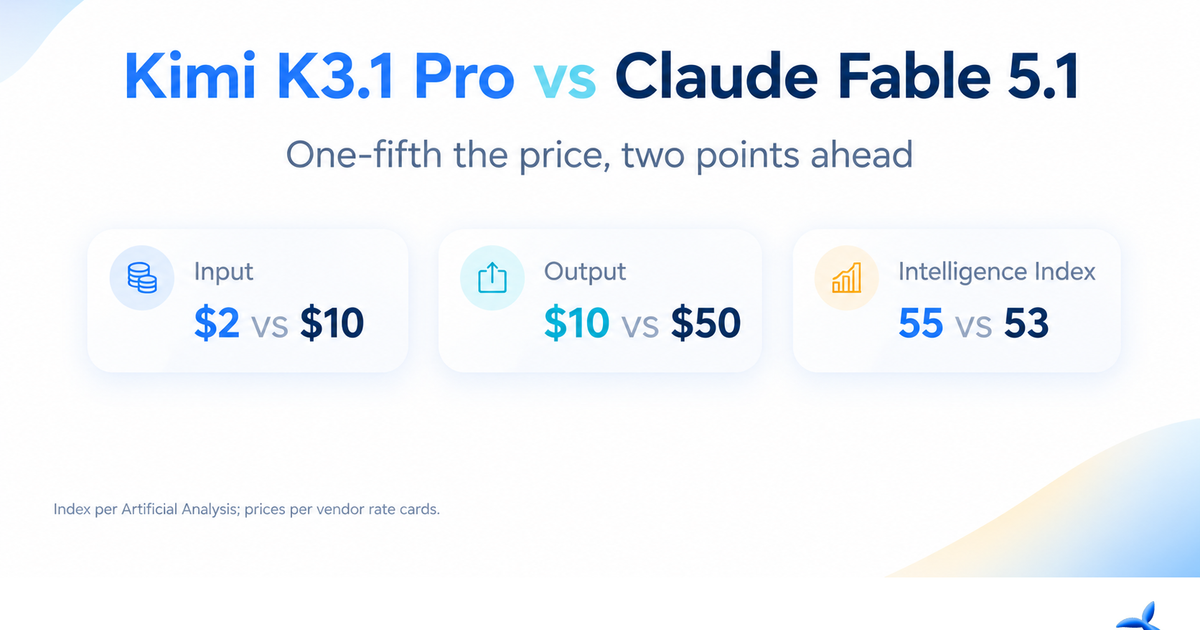
مدل Claude Fable 5.1 گرانترین مدلی است که Anthropic عرضه میکند: هزینه هر یک میلیون توکن ورودی ۱۰ دلار و هر یک میلیون توکن خروجی ۵۰ دلار است؛ نرخهایی که نسبت به Fable 5، منتشرشده در ۱ سپتامبر ۲۰۲۶، تغییری نکردهاند. در مقابل، Kimi K3.1 Pro یکپنجم این هزینه را دارد. در شاخص مستقلی که هر دو مدل با آن سنجیده میشوند، مدل ارزانتر دو امتیاز بالاتر کسب کرده است: Artificial Analysis به Kimi K3.1 Pro امتیاز ۵۵ و به Claude Fable 5.1 امتیاز ۵۳ داده است. این تفاوت نتیجه مقایسه را در نگاه نخست وارونه میکند، اما یک نکته مهم وجود دارد: Fable 5.1 بهعنوان مدلی معرفی میشود که باید زمانی سراغ آن رفت که Opus کافی نیست؛ بااینحال، در همین شاخص، Opus امتیاز ۵۸ دارد و پنج امتیاز از Fable بالاتر است.
پس کدام عدد اشتباه است؟ احتمالاً هیچکدام. این شاخص میانگینی از نتایج ۱۰ ارزیابی است، درحالیکه جایگاه Fable به نوع محدودتری از کارها مربوط میشود: وظایف عاملی طولانیمدت که در آنها مدل باید طی چندین ساعت یک برنامه منسجم را دنبال کند. یک شاخص عمومی ممکن است این توانایی را بهخوبی منعکس نکند. برای خریداران، دو واقعیت مهمتر از این تناقض ظاهری است: قابلیتهای اندازهگیریشده دو مدل گران و ارزان به یکدیگر نزدیکاند، اما قیمت آنها پنج برابر تفاوت دارد و سقف خروجی هر پاسخ نیز در حد یک مرتبه بزرگی متفاوت است.
دو جدول قیمت
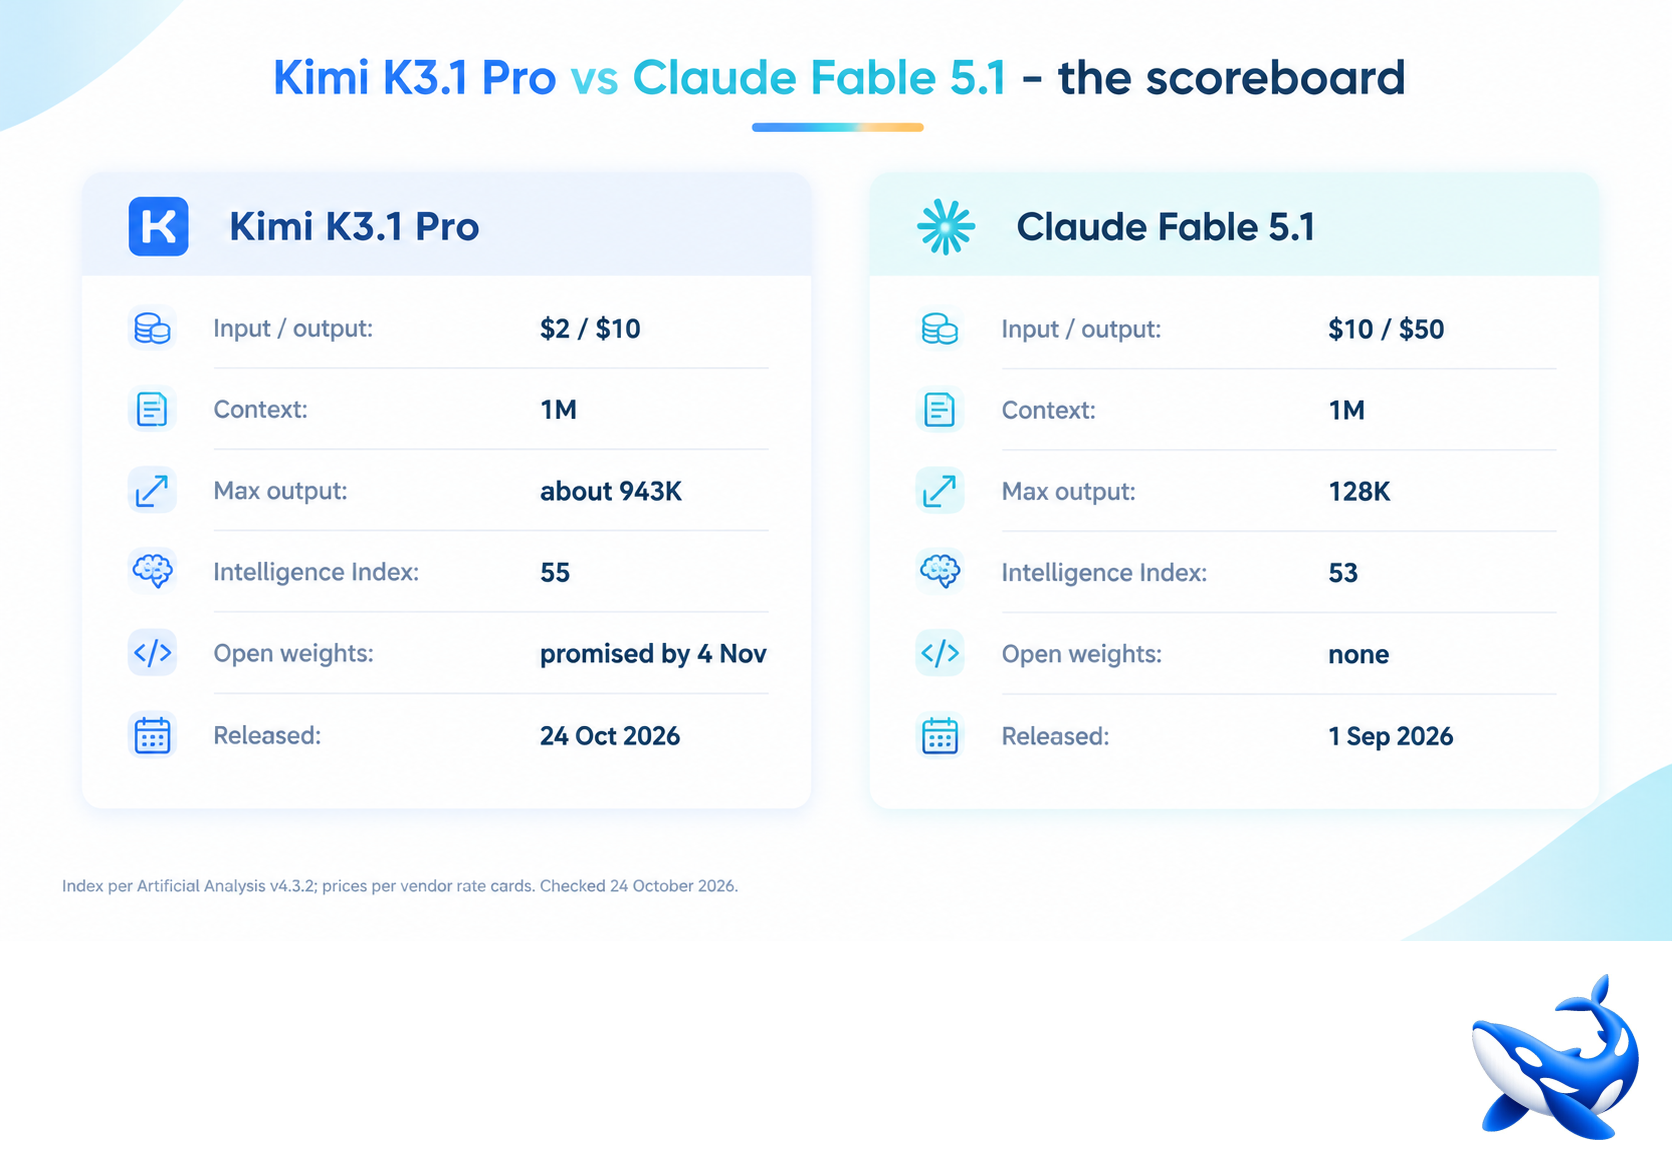
- توکن ورودی: هزینه هر یک میلیون توکن در Kimi K3.1 Pro برابر با ۲ دلار و در Claude Fable 5.1 برابر با ۱۰ دلار است.
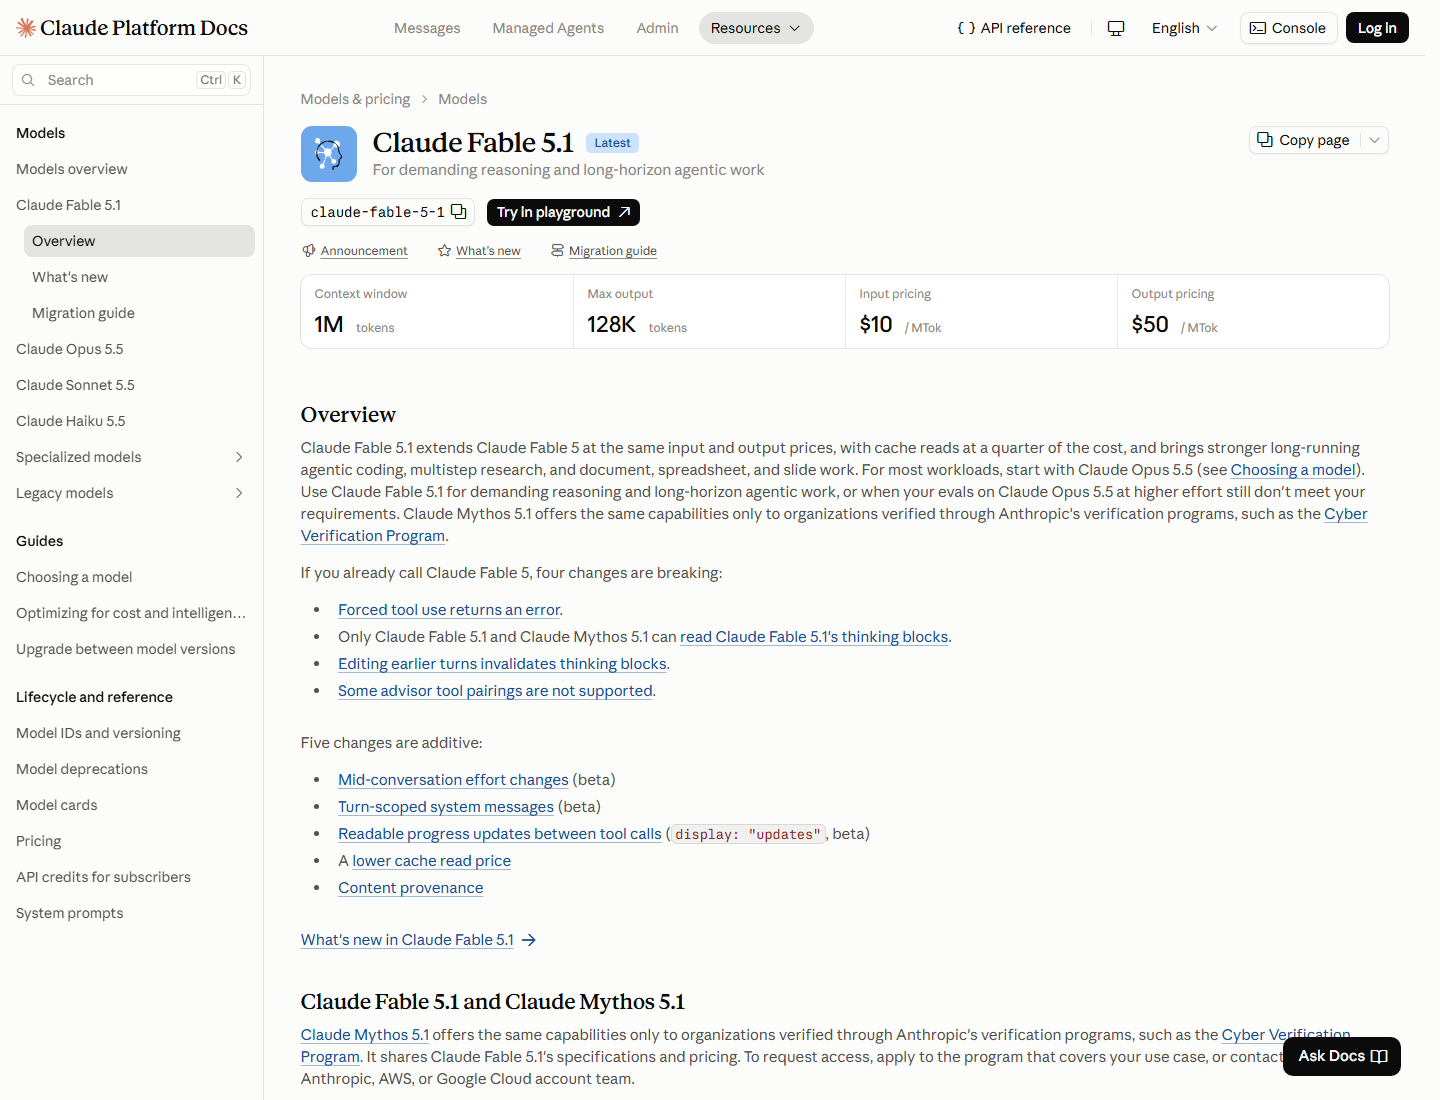
- توکن خروجی: هزینه هر یک میلیون توکن بهترتیب ۱۰ و ۵۰ دلار است. Anthropic اعلام کرده هزینه خواندن توکنهای ذخیرهشده در حافظه نهان (cache) در Fable 5.1 یکچهارم هزینه آن در Fable 5 است. این تخفیف واقعی است، اما نرخ پایه همچنان پنج برابر نرخ Kimi باقی میماند.
- پنجره زمینه: هر دو مدل از ۱٬۰۴۸٬۵۷۶ توکن پشتیبانی میکنند؛ بنابراین ظرفیت زمینه آنها عملاً یکسان است.
- حداکثر خروجی: سقف خروجی Kimi K3.1 Pro برابر با ۹۴۳٬۷۱۸ توکن است، درحالیکه این مقدار برای Claude Fable 5.1 به ۱۲۸٬۰۰۰ توکن میرسد.
- وزنهای مدل: انتشار کامل وزنهای Kimi K3.1 Pro تا ۴ نوامبر ۲۰۲۶ وعده داده شده است. برای Fable 5.1 برنامهای جهت انتشار وزنهای باز اعلام نشده است.
پردازش درخواستی که یک میلیون توکن را میخواند و ۲۰۰ هزار توکن خروجی تولید میکند، در Kimi K3.1 Pro چهار دلار و در Fable 5.1 بیست دلار هزینه دارد. برای خط پردازش اسنادی که ماهانه یک میلیارد توکن ورودی را پردازش میکند، هزینه ورودی بهتنهایی پیش از درنظرگرفتن هرگونه تفاوت کیفیت، در Kimi دو هزار دلار و در Fable ده هزار دلار خواهد بود.
Anthropic میگوید Fable برای چه کاری ساخته شده و شاخص مستقل چه چیزی را نشان میدهد؟
راهنمای رسمی Anthropic درباره انتخاب مدل، بهطور غیرمعمولی صریح است: برای بیشتر کاربردها ابتدا Claude Opus 5.5 را انتخاب کنید و به سراغ Claude Fable 5.1 بروید اگر به استدلال دشوار و کارهای عاملی طولانیمدت نیاز دارید، یا اگر ارزیابیهای شما نشان میدهند که Claude Opus 5.5 حتی با تنظیم تلاش استدلالی در سطح بالاتر، همچنان پاسخگوی نیازهایتان نیست. این جایگاهگذاری، Fable را نه گزینه پیشفرض، بلکه مرحله بعدی معرفی میکند؛ مدلی که برای شرایطی عرضه شده است که نسخه ارزانتر در آنها ناکام میماند.
اما شاخص Artificial Analysis چنین برتری مشخصی را نشان نمیدهد. این شاخص به Fable 5.1 امتیاز ۵۳، به Opus 5.5 امتیاز ۵۸ و به Kimi K3.1 Pro امتیاز ۵۵ داده است. یا ارزیابیهای این شاخص رفتار بلندمدتی را که Fable برای آن بهینه شده، بهاندازه کافی نمیسنجند، یا دامنه برتریای که در معرفی تجاری این مدل مطرح میشود، محدودتر از آن چیزی است که تبلیغات القا میکنند. هر دو احتمال معقولاند؛ این شاخص از ۱۰ ارزیابی در حوزههای دانش، استدلال و وظایف عاملی تشکیل شده است و هیچیک از آنها ساعتها ادامه پیدا نمیکند.
همچنین مدل مشابهی وجود دارد که دسترسی به آن محدود شده است. Claude Mythos 5.1 قابلیتهایی مشابه Fable 5.1 دارد، اما فقط در اختیار سازمانهایی قرار میگیرد که از طریق برنامههای Anthropic، از جمله برنامه تأیید امنیت سایبری این شرکت، احراز صلاحیت شده باشند. Fable نسخهای از این قابلیتهاست که دسترسی به آن برای طیف گستردهتری از کاربران فراهم شده و Anthropic آن را بهعنوان محصولی ممتاز قیمتگذاری کرده است.
چه چیزی قیمت Fable 5.1 را توجیه میکند؟
سه عامل وجود دارد که نمیتوان آنها را با یک امتیاز شاخص خلاصه کرد.
نخست، توانایی انجام کارهای عاملی مستمر و طولانیمدت است. Fable 5.1 قابلیتهای Fable 5 را در زمینه برنامهنویسی طولانیمدت، پژوهش چندمرحلهای و کار با اسناد گسترش میدهد. راهنمای Anthropic نیز صراحتاً به کاربردهایی اشاره میکند که در آنها Opus، حتی با سطح تلاش استدلالی بالا، پاسخگوی نیاز نیست. اگر مسئله شما مهاجرتی ششساعته است، نه پاسخگویی به یک درخواست منفرد، سنجش عملکرد بر مبنای هر وظیفه در یک شاخص عمومی، معیار مناسبی برای مقایسه نخواهد بود.
دوم، سازوکارهای فنی و عملیاتی پیرامون مدل است. Fable 5.1 تغییرات ناسازگار با نسخههای قبلی دارد که بخشی از آنها به این دلیل اعمال شدهاند که تیمها با نسخه پیشین کارهای پیچیدهای انجام میدادند. بلوکهای مربوط به فرایند استدلال به مدلی وابستهاند که آنها را تولید کرده است؛ استفاده اجباری از ابزار اکنون خطا برمیگرداند؛ ویرایش نوبتهای قبلی مکالمه بلوکهای استدلال را نامعتبر میکند و برخی ترکیبهای ابزار مشاور نیز پشتیبانی نمیشوند. این موارد نشانههای اکوسیستمی هستند که در محیط عملیاتی واقعی به کار گرفته شده است. برای سازمانهایی که تحت مقررات فعالیت میکنند، مستندبودن حالتهای شکست و محدودیتها ارزشی دارد که مدلی که تازه عرضه شده، هنوز نمیتواند ارائه کند.
سوم، امکانات مدیریت زمینه و کنترل فرایند استدلال است. Anthropic برای این مدل امکان تغییر سطح تلاش استدلالی در میانه مکالمه، فعلاً در مرحله آزمایشی، و استفاده از پیامهای سیستمی مختص هر نوبت را مستند کرده است. این قابلیتها زمانی اهمیت پیدا میکنند که یک عامل هوش مصنوعی در جریان یک نشست طولانی ناچار باشد عمق استدلال خود را افزایش یا کاهش دهد. در Kimi K3.1 Pro، سطح تلاش بهصورت یک فیلد در سطح اصلی درخواست تنظیم میشود و در عمل طی نشست ثابت میماند؛ تغییر آن باعث میشود تطبیق با پیشوند ذخیرهشده در حافظه نهان (prefix cache) از اعتبار بیفتد.
برتریهای Kimi K3.1 Pro بر اساس واقعیتهای قابلاندازهگیری، نه جایگاهگذاری تجاری
قیمت، آشکارترین مزیت است و تفاوت آن بههیچوجه ناچیز نیست. مزیت کمتر آشکار، سقف خروجی است: ۹۴۳٬۷۱۸ توکن در برابر ۱۲۸٬۰۰۰ توکن. این تفاوت به مدل اجازه میدهد یک فایل بزرگ کامل، مجموعه تغییرات مربوط به یک مهاجرت نرمافزاری یا سندی طولانی را در یک مرحله تولید کند، بیآنکه لازم باشد برنامه سمت کاربر خروجی چندین درخواست را به هم متصل کند. در پردازش انبوه اسناد و تولید محتوایی در مقیاس کل پایگاه کد، این محدودیت خروجی میتواند بیش از هر امتیاز معیار سنجش، معماری سامانه را تعیین کند.
مزیت سوم، انتشار وزنهای باز است. این وزنها هنوز منتشر نشدهاند و تاریخ وعدهدادهشده برای انتشار ۴ نوامبر است، اما این تعهد علنی شده است. سابقه K3 نیز الگویی مشخص در اختیار میگذارد: وزنهای آن در ۲۷ ژوئیه با مجوزی منتشر شدند که استفاده، اصلاح، توزیع و تنظیم دقیق مدل را مجاز میکرد. اگر استقرار شما بهگونهای است که امکان فراخوانی یک رابط برنامهنویسی کاربردی میزبانیشده را ندارید، همین ردیف جدول بهتنهایی میتواند تعیینکننده باشد.
در مقابل، Kimi K3.1 Pro هنوز سابقه سهماهه فعالیت عملیاتی Fable 5.1، فهرست مستند تغییرات ناسازگار با نسخههای قبلی یا امکانات سازمانی Anthropic را ندارد. مدلی که همین هفته منتشر شده، هنوز فرصت نداشته است در استفاده عمومی با شکستهایی روبهرو شود که دیگران آنها را گزارش کنند.
کدام مدل را اجرا کنیم و چگونه وظایف را میان آنها تقسیم کنیم؟
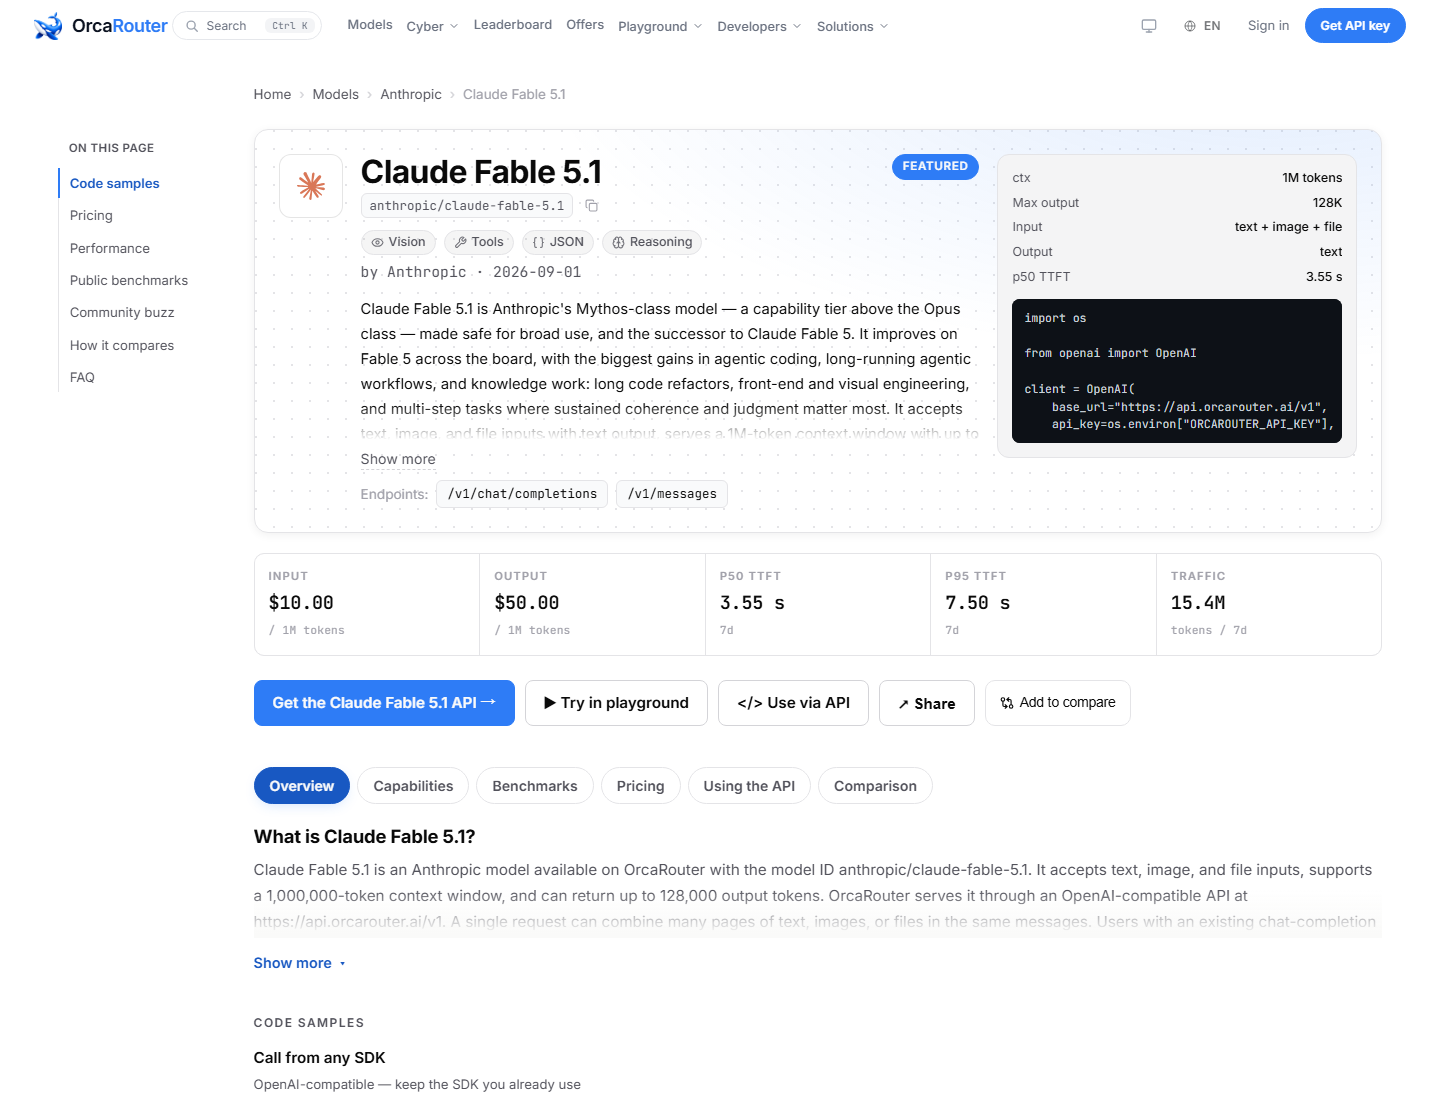
هر دو مدل از طریق OrcaRouter و با همان قیمتهای اعلامشده از سوی ارائهدهندگانشان، بدون هزینه اضافی این مسیریاب، قابل فراخوانی هستند: برای Kimi K3.1 Pro، ورودی ۲ دلار و خروجی ۱۰ دلار؛ و برای Claude Fable 5.1، ورودی ۱۰ دلار و خروجی ۵۰ دلار بهازای هر یک میلیون توکن. هر دو از یک کلید و سه قالب یکسان برای درخواستها پشتیبانی میکنند؛ بنابراین میتوان سیاستی برای هدایت درخواستها میان دو مدل تنظیم کرد، بدون آنکه نیازی به تغییر کد برنامه باشد.
بر اساس شواهد موجود، تقسیم وظایف به این صورت منطقی است: کارهای عاملی طولانیمدت و وظایفی که به سازوکارهای بلوک استدلال و تنظیم سطح تلاش در Anthropic نیاز دارند، به Fable 5.1 سپرده شوند؛ در مقابل، تولید محتوای پرتعداد، پردازش اسناد و تولید خروجی در مقیاس کل پایگاه کد به Kimi K3.1 Pro واگذار شود. با توجه به پنجبرابر بودن قیمت Fable، حتی اگر ۲۰ درصد ترافیک به مدل گرانتر هدایت شود، هزینه ترکیبی همچنان حدود ۸۰ درصد کمتر از حالتی خواهد بود که تمام درخواستها با Fable پردازش شوند.
تنها کاری که نباید انجام داد، این است که برتری Kimi در شاخص را مدرکی قطعی برای بهتر بودن آن بدانیم. این نتیجه صرفاً نشان میدهد اختلاف قابلیتهای اندازهگیریشده آنقدر کم است که انتخاب نهایی باید بر اساس نوع کاربرد شما انجام شود، نه رتبهبندی یک جدول. با چنین فاصله قیمتی، بهتر است مدل ارزانتر گزینه پیشفرض باشد، مگر آنکه ارزیابیهای اختصاصی شما خلاف آن را نشان دهند.