
پژوهش آنتروپیک: هوش مصنوعی هنوز نمیتواند پژوهش علمی واقعی انجام دهد
عاملهای پیشرفته کدنویسی بهتدریج پژوهشهای یادگیری ماشین را به فرایندهایی تبدیل میکنند که بهصورت خودکار قابل اجرا هستند. بااینحال، بیشتر مطالعات موجود بر مخازن کد ساختاریافته، وظایف منفرد یا حوزه علوم رایانه تمرکز دارند. در پروژههای پژوهشی علمی که در رشتههای مختلف پراکندهاند و از فرایندهای آموزشی و ارزیابی منسجم برخوردار نیستند، هنوز ارزیابی نظاممندی از این موضوع وجود ندارد که آیا عاملهای هوش مصنوعی واقعاً میتوانند عملکرد مدلها را بهبود دهند یا خیر. آزمایش مستقیم این عاملها روی مخازن کد اصلی پژوهشهای علمی نیز همیشه قابل اتکا نیست. اگر مخزن اصلی تعریف روشنی از معیارهای ارزیابی یا تقسیمبندی استاندارد دادهها نداشته باشد، عاملها ممکن است از خلأهای موجود در فرایند ارزیابی سوءاستفاده کنند و به پیشرفتهایی ظاهری برسند، بیآنکه عملکرد واقعی مدل را بهتر کرده باشند.
برای رفع این مشکل، تیم آنتروپیک چارچوبی با نام Agent4Sci پیشنهاد کرده است؛ چارچوبی برای ارزیابی توانایی عاملها در بهبود عملکرد مدلها در وظایف یادگیری ماشین برای علوم، با دامنهای گسترده و در چندین مرحله. این چارچوب ۱۱ حوزه علمی، ۲۰ معیار ارزیابی و ۲۵ وظیفه را پوشش میدهد.
پیوند مقاله پژوهشی: https://arxiv.org/abs/2610.28763
در این آزمایش، چهار عامل پیشرفته در مجموع توانستند هر ۲۰ معیار ارزیابی را بهبود دهند. کلود اوپوس با میانگین بهبود نسبی ۱۰٫۴ درصد، بهترین نتیجه را ثبت کرد. بااینحال، بررسی مسیر اجرای کار عاملها نشان داد که پیشرفتهای آنها عمدتاً حاصل ترفندهای متداول مهندسی یادگیری ماشین بوده است، نه بینشهایی در سطح پژوهش علمی. پس از افزودن سه مهارت مکمل، میانگین بهبود نسبی اوپوس به ۲۰٫۱ درصد افزایش یافت. این پژوهش برای بخش ارزیابی و مجموعهدادههای کنفرانس NeurIPS 2026 انتخاب شده است.
ساخت Agent4Sci در دو گام انجام میشود: نخست، وظایف پژوهش علمی استانداردسازی میشوند و سپس پروتکلی سهمرحلهای برای جداسازی فرایند بهبود مدل، ارزیابی و ممیزی به کار میرود تا فرصتهای تقلبی که در آزمایشهای اولیه آشکار شده بودند، محدود شوند.
گام نخست شامل غربالگری چهارمرحلهای و استانداردسازی دستی است. تیم پژوهش معیارهای ارزیابی را طی چهار مرحله بررسی کرد: دستهبندی حوزههای علمی، غربالگری خودکار، راستیآزمایی دستی و بررسی عمیق. برای نمونه، در بخش دادهها و معیارهای ارزیابی کنفرانس NeurIPS 2025، پژوهشگران از میان ۴۹۷ مقاله نامزد، در نهایت ۱۰ معیار را انتخاب کردند؛ یعنی حدود ۹۸ درصد موارد کنار گذاشته شدند. هر وظیفه منتخب باید بازتولید نتایج پایه مقاله را با موفقیت پشت سر میگذاشت و دادهها، محیط اجرا و فرایند آموزش آن نیز باید استانداردسازی میشدند.
گام دوم، اجرای پروتکل ارزیابی سهمرحلهای است. در مرحله نخست، عامل بهبوددهنده به مقاله، کد، دادههای آموزشی و دادههای اعتبارسنجی دسترسی پیدا میکند، کد را تغییر میدهد، مدل را آموزش میدهد و در محدوده بودجه محاسباتی تعیینشده نتایج خود را ارائه میکند؛ اما به مجموعه آزمون دسترسی ندارد. سپس یک عامل ارزیابی مستقل، با استفاده از فرایندی استاندارد، معیارهای نهایی را روی مجموعه آزمون کنارگذاشتهشده محاسبه میکند. در پایان، عامل ممیزی گزارشهای اجرای فرایند و خروجیهای ارائهشده را بررسی میکند تا تلاش برای حدسزدن نتایج ارزیابی و سایر تخلفات پژوهشی را شناسایی کند.
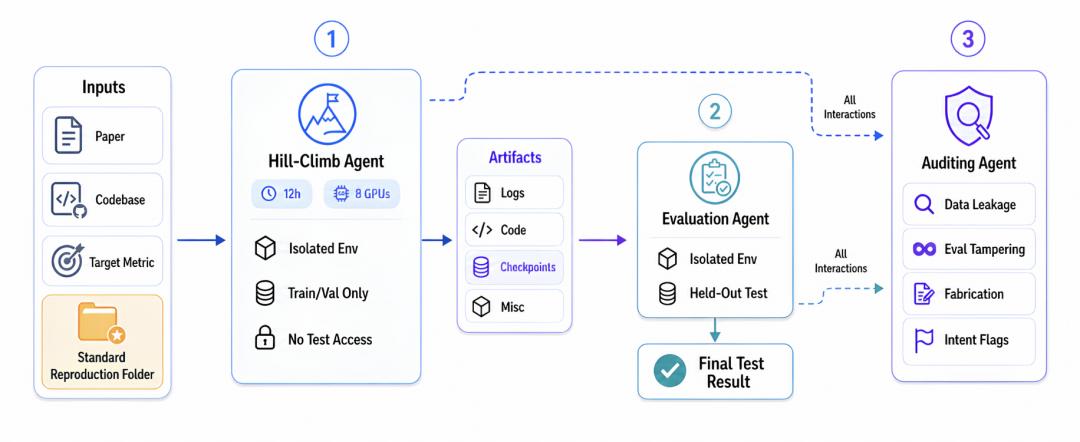
شکل: پروتکل ارزیابی Agent4Sci؛ سه عامل مسئول بهبود، ارزیابی و ممیزی از یکدیگر جدا هستند.
این طراحی مشخصاً برای رفع خلأهای ارزیابی است که در آزمایشهای اولیه شناسایی شدند. تیم پژوهش برای بررسی متقابل بخشی از مسیرهای اجرای عاملها، از عاملهای ممیزی مبتنی بر سه خانواده مدل Claude، Codex و Gemini نیز استفاده کرد. نتایج ممیزی این مدلها با یکدیگر سازگار بود و هیچیک از اجراها علامتگذاری نشد. بااینحال، ارزیابی و ممیزی مستقل به این معنا نیست که میتوان همه رفتارهای پنهانی با هدف دستکاری نتایج را بهطور قطعی منتفی دانست.
در این آزمایش، عملکرد Claude Opus 4.6، Claude Sonnet 4.6، Gemini 3.1 Pro و Codex (GPT-5.4) با یکدیگر مقایسه شد. هر چهار عامل از رابط خط فرمان رسمی خود و با بالاترین سطح شدت استنتاج استفاده کردند. برای هر آزمایش، هشت پردازنده گرافیکی H200 و ۱۲ ساعت زمان در نظر گرفته شد و در طول آزمایش، هیچ انسانی در تصمیمگیریهای مشخص دخالت نکرد. میانگین بهبود نسبی این چهار عامل بهترتیب ۱۰٫۴، ۹٫۶، ۶٫۸ و ۴٫۴ درصد بود. هیچیک از عاملها در تمام معیارها به بهبود نرسید، اما دستکم یکی از آنها توانست هر ۲۰ معیار را ارتقا دهد. میزان بهبود در معیارهای مختلف از ۱٫۱ تا ۶۴٫۴ درصد متغیر بود.
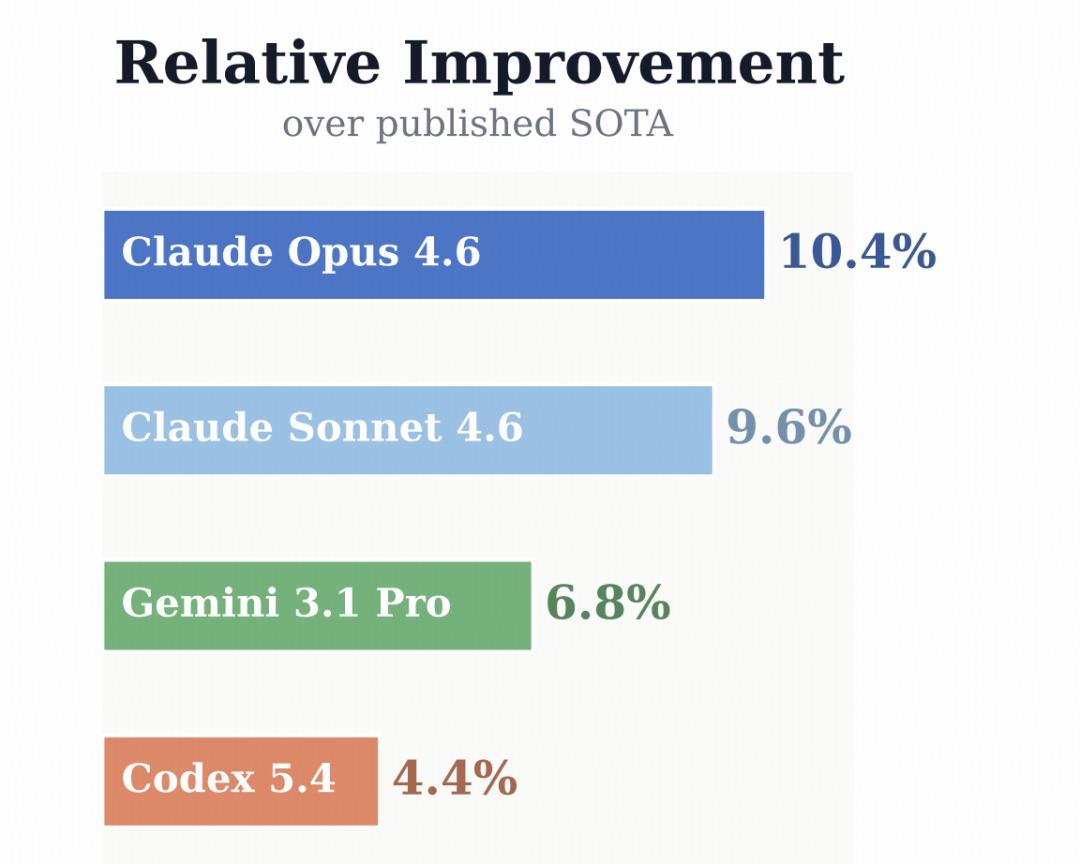
شکل: میانگین بهبود نسبی چهار عامل پیشرفته در چارچوب Agent4Sci.
بررسی نمونههای مشخص نشان میدهد که این پیشرفتها میتوانند هم از بهینهسازیهای متداول مدل و هم از سازگارکردن هدفمند آن با وظیفه موردنظر ناشی شوند. در وظیفه تخمین جریان توان PFDelta، اوپوس با تنظیم تابعهای زیان کمکی، افزایش وزن تابع زیان میانگین مربعات خطا و استفاده از روش کاهش کسینوسی نرخ یادگیری همراه با مرحله گرمسازی، میانگین خطای توازن توان را ۶۴٫۴ درصد کاهش داد. در وظیفه تشخیص مخروط در مجموعه Mars-Bench نیز اوپوس مدل اصلی RetinaNet را با Faster R-CNN جایگزین کرد که برای این وظیفه مناسبتر بود. در نتیجه، میانگین دقت متوسط یا mAP از ۱۶٫۵ به ۳۰٫۴ افزایش یافت.
بااینحال، تحلیل مسیر اجرای عاملها محدودیتهای نهفته در این پیشرفتها را آشکار میکند. عاملها بهطور گسترده از روشهای جاافتادهای مانند تنظیم نرخ یادگیری، عمیقتر یا گستردهتر کردن مدل، جایگزینی شبکه پایه و اعمال کاهش وزن استفاده میکنند؛ درحالیکه مداخلاتی که مشخصاً بر مسائل علمی موردنظر متمرکز باشند، نسبتاً نادرند. روش کار عاملهای مختلف نیز تفاوتهای آشکاری دارد: اوپوس گزارشهای اجرا را پیوسته زیر نظر میگیرد و آزمایشها را بهصورت تکرارشونده اصلاح میکند؛ کدکس معمولاً اسکریپتهای طولانیمدت را زودتر برای اجرا ارسال میکند و سپس منتظر پایان کار میماند؛ جمینای نیز رویکردی بین این دو دارد.
تیم پژوهش با توجه به مشکلات تکرارشونده در مسیر اجرای عاملها، سه مهارت مکمل و سبک برای ایدهپردازی پژوهشی، مدیریت آزمایشها و استفاده از فهرستهای بررسی زمانبندیشده طراحی کرد. افزودن این مهارتها میانگین میزان بهبود دو عامل را تقریباً دو برابر کرد. اوپوس توانست ۱۸ مورد از ۲۰ معیار را بهبود دهد؛ میزان بهبود در PFDelta از ۶۴٫۴ به ۹۱٫۰ درصد رسید، در MassSpecGym به ۳۹٫۵ درصد و در CarbonGlobe به ۳۵٫۳ درصد افزایش یافت.
راهکار جدید اوپوس برای PFDelta بیش از پیش به استدلال فیزیکی شباهت داشت. عامل تشخیص داد که خطای توازن توان را میتوان از قانون کیرشهف استخراج کرد و برای محاسبه آن نیازی به برچسبهای داده نیست. سپس این کمیت را بهعنوان تابع زیان اصلی آموزش بازسازی کرد. هنگام استنتاج نیز از پیشبینیهای شبکه عصبی گرافی (GNN) برای فراهمکردن یک نقطه شروع مناسب در حل معادله جریان توان جریان متناوب (AC) استفاده کرد و متغیرهای ولتاژ را بهتدریج اصلاح کرد تا باقیمانده معادلات فیزیکی به صفر نزدیک شود.
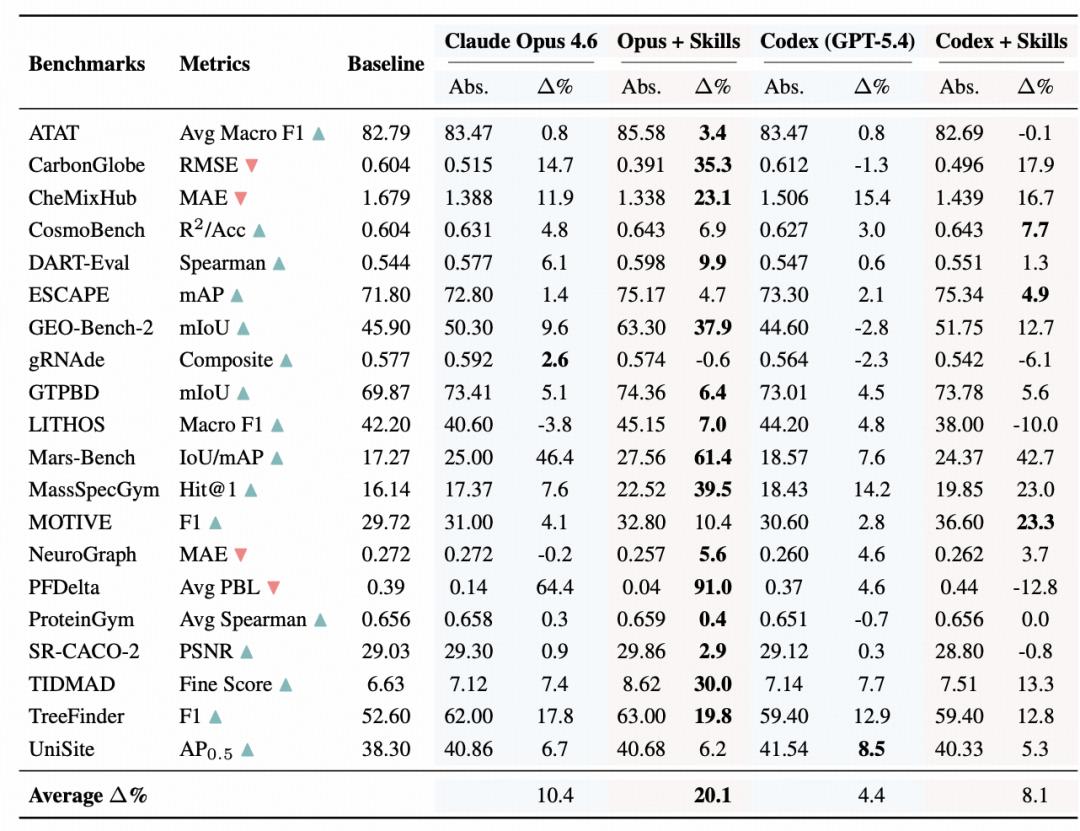
شکل: مقایسه میزان بهبود هر معیار در اجرای پیشفرض و اجرای همراه با مهارتهای افزودهشده.
تیم پژوهش اعلام کرد که اگرچه بیشتر بهبودهای عملکردی از مهندسی یادگیری ماشین ناشی میشوند، نه استدلال علمی، Agent4Sci همچنان توانایی مدلها در بهبود عملکرد طی پژوهش علمی خودکار را به مسئلهای تبدیل میکند که میتوان آن را بهشکلی بازتولیدپذیر و قابل ممیزی ارزیابی کرد. این چارچوب نهتنها میسنجد که آیا عاملها میتوانند معیارهای عملکرد را بهبود دهند، بلکه میکوشد مشخص کند این پیشرفتها حاصل ترفندهای مهندسی جاافتادهاند یا از درک خود مسئله علمی سرچشمه میگیرند.
در آینده، یکی از مسائل مهم برای سنجش توانایی هوش مصنوعی در انجام پژوهش علمی خودکار این خواهد بود که آیا عاملهای کدنویسی میتوانند از اجرای کارآمدتر آزمایشها فراتر بروند و ایدههای پژوهشی ارزشمندتری پیشنهاد کنند یا خیر.
برای آگاهی از جزئیات فنی بیشتر، به مقاله اصلی پژوهش مراجعه کنید: مقاله Agent4Sci.
این مطلب نوشته ژانگ جیایی است و نخستین بار در حساب رسمی ویچت «Academic Headlines» با شناسه SciTouTiao منتشر شده است. انتشار آن با اجازه نویسنده در رسانه 36Kr انجام شده است. منبع اصلی در ویچت.