
اوپنایآی صدها مسئله ریاضی را حل کرد؛ سپس ریاضیدانان را با انبوهی از مشکلات تنها گذاشت
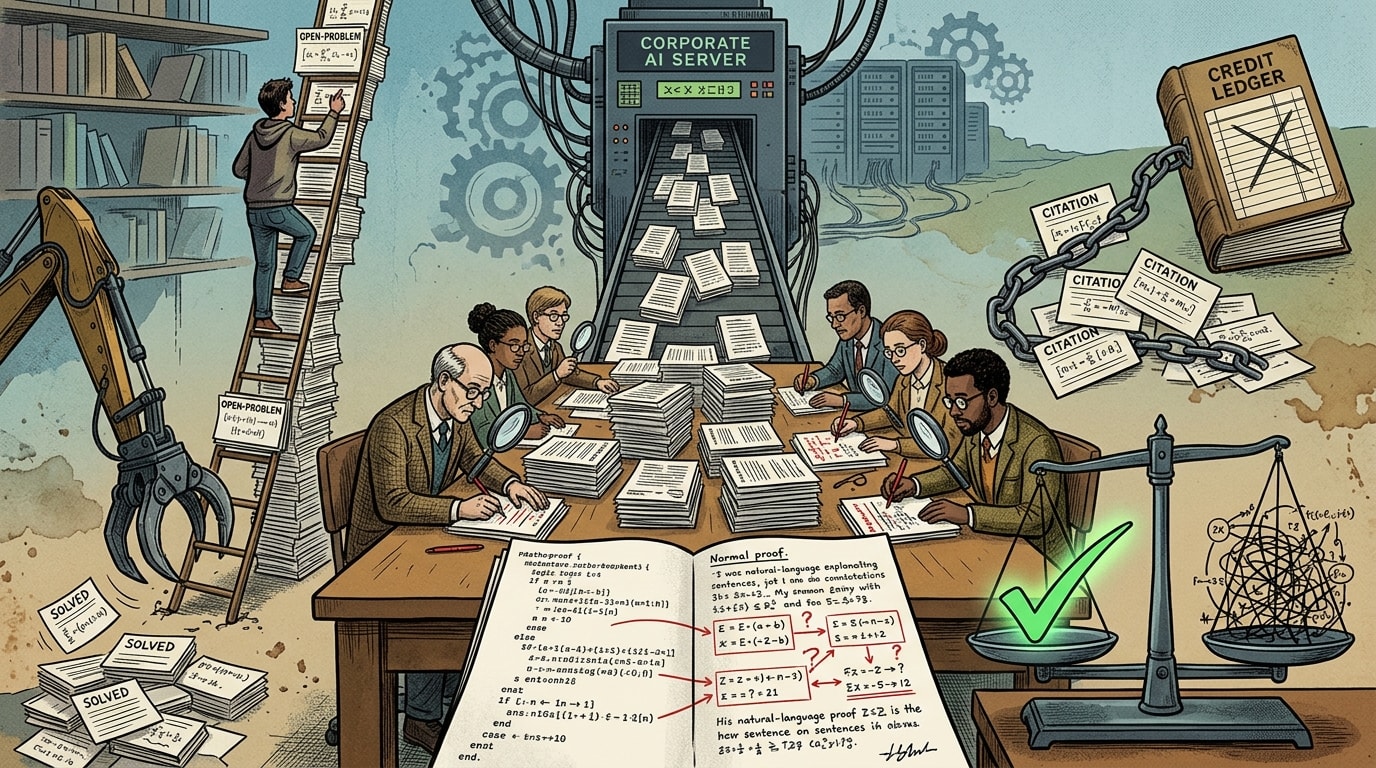
اوپنایآی در اکتبر ۲۰۲۶، تعداد ۷۲۲ دستنوشته ریاضی تولیدشده با هوش مصنوعی منتشر کرد. پس از آنکه خطاهای نمادین در برخی از این آثار آشکار شد، چندین دستنوشته تقریباً بلافاصله پس گرفته شدند و در هفتههای بعد نیز تعدادی دیگر اصلاح یا از دسترس خارج شدند. اگر این اتفاق را صرفاً از منظر «افزایش دانش» ارزیابی کنیم، با دستاوردی چشمگیر روبهرو هستیم: صدها مسئله حلنشده بررسی شدهاند. حتی نتیجهای که نادرست از آب دربیاید، میتواند ارزشمند باشد؛ زیرا مشخص شدن اینکه یک مسیر به نتیجه نمیرسد، خود نوعی دستاورد است. بااینحال، جامعه ریاضی از این اتفاق استقبال نکرد. ترنس تائو این خروجی را «زباله سمی» نامید. یو دنگ پرسش صریحتری مطرح کرد: ایدههای کاربران به آموزش مدل کمک کردهاند، مدل نیز از همان ایدهها برای حل مسائل باز استفاده کرده است؛ پس «ما، بهعنوان کاربران، چه چیزی به دست میآوریم؟» اختلاف بر سر نحوه عرضه دستاوردهای اوپنایآی به جامعه ریاضی است و اینکه آیا این شیوه، شرایط لازم برای افزایش واقعی دانش را تضعیف میکند یا نه.
مثالی که شما درباره اثبات ذاتی چرن مطرح کردهاید، به قلب این مسئله میزند. دانش ریاضی در روشهایی نهفته است که بتوان آنها را فهمید، دوباره به کار گرفت و از طریق آنها سطح مفهومی یک حوزه را ارتقا داد. یک اثبات زمانی به دانش ریاضی تبدیل میشود که دیگران بتوانند آن را درک کنند، آموزش دهند، بسط دهند و پژوهشهای بعدی را بر پایه آن پیش ببرند. اثبات ابتدایی قضیه اعداد اول، در مقایسه با اثبات مبتنی بر آنالیز مختلط، از دقت کمتری برخوردار است؛ اما ارزش آن در گشودن مسیری تازه و قابل استفاده برای حل مسائل نهفته است. اوپنایآی فرایند حل مسئله را از بستر درک و فهم جدا کرد و محصول این جداسازی را در مقیاسی صنعتی به جامعه ریاضی تحویل داد.
نخستین گسست در شیوه انتشار این آثار رخ داد. این ۷۲۲ دستنوشته داوری همتا نشده بودند و در آرکایو یا دیگر بسترهای رایج انتشار پیشچاپ نیز قرار نگرفتند؛ بلکه مستقیماً در مخزن گیتهاب شرکت بارگذاری شدند. بیانیه یک انجمن ریاضی این مسئله را بهصراحت بیان کرد: «ریاضیدانان درخواست چنین آثاری را نکرده بودند. انتشار بیش از ۷۰۰ سند بهصورت همزمان، ارائهای علمی نیست، بلکه نمایشی از قدرت است.» مسئله، مخالفت با انتشار پیشچاپ نیست؛ فرهنگ انتشار پیشچاپ مدتهاست در ریاضیات رواج دارد. مشکل به توافق نانوشتهای مربوط میشود که این فرهنگ بر آن استوار است. نویسندگان معمولاً پیش از انتشار عمومی دستنوشته، آن را تا حدی سامان میدهند که همکارانشان بتوانند بررسی آن را ادامه دهند؛ همچنین آمادهاند اثر خود را توضیح دهند و خطاهایش را اصلاح کنند. اوپنایآی این توافق را وارونه کرد: صدها سند با سازماندهی ناکافی و نرخ قابلتوجهی از خطا را یکجا منتشر کرد و سپس با استناد به ضرورت «فرایند تکرارشونده و تدریجی»، بار غربالگری، اصلاح و فهم این آثار را به جامعه ریاضی منتقل کرد.
یک ریاضیدان دانشگاه نورثوسترن ابعاد این انتقال مسئولیت را چنین توصیف کرد: جامعه ریاضی اکنون «باید دهها هزار صفحه از نتایج ریاضی را با دقت بررسی کند»، درحالیکه سازوکاری که معمولاً این کار را انجام میدهد، یعنی داوری همتا، «دیگر وجود ندارد». یک خطای نمادین باعث شد سه دستنوشته بهصورت زنجیرهای با مشکل مواجه شوند. تاونزند، از دانشگاه کرنل، نیز صریحاً گفت که «خطاهای بیشتری پیدا خواهند شد». این مشکل ویژگی چنین شیوهای از تولید است. وقتی سرعت تولید خروجی بسیار بیشتر از توان جامعه علمی برای فهم و راستیآزمایی آن باشد، افزایش دانش در ظاهر رشد میکند، اما همزمان هزینهای بیرونی ایجاد میشود که ریاضیدانان باید زمان بسیار زیادی را صرف پاکسازی آن کنند. تعبیر «زباله سمی» تائو دقیقاً به این دلیل گویاست که مسئله را در عرضه پسماندِ تصفیهنشده در قالب نتیجه علمی میبیند، نه در وجود خود پسماند. خطا در ریاضیات امری عادی است؛ اما عرضه انبوه خطاهای بررسینشده بهعنوان خروجی علمی، عادی نیست.
مشکل عمیقتر به این پرسش مربوط میشود که چه چیزی را باید دانش ریاضی دانست. حتی دستنوشتهای که از نظر صوری درست است، لزوماً از همان نوع دانشی نیست که شما توصیف میکنید؛ یعنی دانشی که سطح مفهومی یک حوزه را بالا میبرد و میتوان آن را در مسائل دیگر به کار گرفت. اوپنایآی برای اثبات خود درباره معادلات ناویه–استوکس، صورتبندی رسمیای با زبان لین (Lean) ارائه کرد که در نگاه نخست، پشتوانه راستیآزمایی ماشینی را در اختیار میگذاشت. بااینحال، بررسیای در اکتبر ۲۰۲۶ یک گسست اساسی را آشکار کرد: نسخه لین و نسخه به زبان طبیعی که برای خوانندگان انسانی نوشته شده بود، انطباق دقیقی با یکدیگر نداشتند. در اثبات مکتوب، لم ۸.۶ مستلزم کنترل عملگر معکوس با استفاده از مشتقهای ورودی تا مرتبه m+4 است؛ اما قضیه متناظر در لین فقط به m+5 نیاز دارد. به این ترتیب، شرط مسئله ضعیفتر شده است. همچنین، استدلال یکتایی در معادله ۱۰.۱۹ در کد با نامساویای جایگزین شده که تفاوت اساسی با آن دارد. گروه هنسن در دانشگاه کمبریج به این نتیجه رسید که موفقیت در راستیآزمایی صوری، تضمین نمیکند که اثبات به زبان طبیعیِ متناظر با آن نیز بهدرستی بررسی شده باشد.
این یافته از مسئله درستی یک اثبات خاص فراتر میرود و نوعی جابهجایی معرفتشناختی را آشکار میکند. لین میتواند مشخص کند که یک رشته از نمادها از نظر منطقی قابل استنتاج است؛ اما نمیتواند تشخیص دهد که آیا آن رشته، گزاره ریاضی موردنظر ریاضیدان را بهدرستی بیان میکند یا نه. وقتی شرکتهای هوش مصنوعی راستیآزمایی ماشینی را محور اصلی اعتبار ادعاهای خود قرار میدهند، صحت برنامه را جایگزین درک ریاضی میکنند. اثباتی در لین که شرایط آن تضعیف شده باشد، ممکن است از نظر صوری کاملاً بینقص باشد؛ بااینحال، گزارهای که در متن طبیعی به آن نسبت داده میشود، دیگر لزوماً همان گزاره معناداری نیست که قرار بود اثبات شود. برای تولید آنچه شما روشهای ذاتی مینامید، چنین جایگزینی ویرانگر است. قابلیت استفاده مجدد از یک روش به درک محتوای مفهومی آن وابسته است. گزارهای که هنگام ترجمه بیسروصدا تضعیف شده باشد، نمیتواند بینشی ساختاری فراهم کند که به مسائل دیگر نیز قابل انتقال باشد.
لایه سوم مسئله به مقیاس زمانی مربوط میشود. شما بهدرستی اشاره میکنید که دانستن درست یا نادرست بودن یک گزاره ارزشمند است، زیرا از صرف زمان برای دنبال کردن مسیرهای اشتباه جلوگیری میکند. بااینحال، جامعه ریاضی مسائل حلنشده را به شیوهای مصرف نمیکند که بتوان ذخایر سنگ معدن را مصرف کرد. بسیاری از مسائل بازِ کوچکتر و با دشواری متوسط، در درجه نخست برای حل شدن وجود ندارند؛ آنها بستری برای آموزش نسل بعدی ریاضیدانان هستند. تائو برای توصیف اتفاقی که در حال رخ دادن است، از اصطلاح «معدنکاویِ تمامعیار» یا «استخراج بیرویه» (strip-mining) استفاده میکند. مسائل خوب را میتوان منابعی تجدیدناپذیر دانست و مسائل کوچکتر و آسانتر «میتوانند به آموزش نسل بعدی ریاضیدانان کمک کنند». استخراج بیتمایز و خودکار این مسائل ممکن است «زیستبومی را نابود کند که نسل بعدی روشها، مسائل و پژوهشگران ریاضی در آن شکل میگیرند».
بحثهای اکتبر ۲۰۲۶ به این نگرانی بُعدی عینی بخشید. یک دانشجوی دکتری در دانشگاه ایالتی مونتانا از همین حالا این پرسش را مطرح کرده است که اگر هوش مصنوعی بتواند مقالههای دانشگاهی در سطح تحصیلات تکمیلی را بهصورت انبوه تولید کند، «آیا مدرکی که در سال ۲۰۲۸ اعطا میشود، بهاندازه مدرکی که در سال ۲۰۲۳ اعطا شده ارزش خواهد داشت؟» تائو مسئله را مستقیمتر بیان میکند: اگر هوش مصنوعی جایگزین دانشجویان تحصیلات تکمیلی شود، میتواند مقالههایی در سطح تحصیلات تکمیلی تولید کند، اما «در نتیجه این کار، نسل بعدی دانشجویان را نخواهیم داشت». این رابطه علت و معلولی را میتوان دقیقاً توضیح داد. پژوهشگر جوان هنگام تلاش برای حل مسئلهای با دشواری متوسط، یاد میگیرد چگونه مسئله طرح کند، چگونه به بنبستها پی ببرد و چگونه شکست را به مسیری تازه برای پژوهش تبدیل کند. اگر هوش مصنوعی در چنین مسائلی زودتر به نتیجه برسد، پژوهشگر جوان مسیر ضروری شکلگیری قضاوت ریاضی خود را از دست میدهد. در این صورت، دانشی که اوپنایآی به مجموعه دانش موجود میافزاید، به بهای تضعیف توانایی تولید دانش در آینده به دست میآید.
نظریه یو دنگ درباره دو مرز، چارچوبی یکپارچه برای فهم این مشکلات فراهم میکند. در ریاضیات سنتی فقط یک مرز وجود دارد: مرز مسائلی که اثبات آنها در دسترس است. از آنجا که در روال سنتی «اگر اثباتی وجود داشته باشد، کسی باید آن را بفهمد»، این دو مرز کاملاً بر هم منطبقاند. هوش مصنوعی مرز دومی ایجاد میکند: اثباتی وجود دارد، اما فقط هوش مصنوعی آن را میداند و انسانها از درک آن عاجزند. این مرز خطرناک است؛ زیرا شمار زیادی از اثباتهای صوریِ درست بیرون از محدوده فهم انسان قرار میگیرند و اثباتهایی که از این مرز عبور میکنند، اغلب پیوند خود را با سرچشمههای انسانی اندیشه قطع میکنند.
تائو یادآوری میکند که مدلهای هوش مصنوعی گنجینهای از متون و آثار انسانی را که طی هزاران سال شکل گرفتهاند جذب میکنند، اما هنگام ارائه اثباتها، «منطق استدلال و منابع مورد استناد مبهماند». این فرایند جعبهسیاه، زنجیره انتقال فکری در محیط دانشگاهی را قطع میکند و وابستگی هوش مصنوعی به دستاوردهای پیشین انسانها را پنهان میسازد. اختلاف بر سر تقدم علمی در پرونده ناویه–استوکس، نمونه روشنی از این مشکل است. باکمستر، ریاضیدان دانشگاه نیویورک، گفت مسیری پژوهشی که او و همکارانش دنبال میکردند، پیش از انتشار عمومی به اوپنایآی درز کرده بود و این شرکت سپس با بهکارگیری منابع محاسباتی عظیم، برای ارائه سریع یک اثبات کامل تلاش کرد. اوپنایآی حتی در جریان مذاکرات درخواست کرده بود یکی از همکاران این گروه که با آنتروپیک همکاری داشت، از فهرست نویسندگان کنار گذاشته شود. موضع دنگ بر یک اصل استوار است: اگر اثباتی که بعداً منتشر میشود از ایدههای پیشین بهره برده باشد، باید بتوان منشأ آن ایدهها را ردیابی کرد؛ کاری که «نهتنها میتواند از اختلاف بر سر تقدم علمی جلوگیری کند، بلکه امکان میدهد سهم هوش مصنوعی و سهم انسانها را نیز بهدقت از یکدیگر متمایز کنیم». وقتی چنین امکان ردیابیای وجود نداشته باشد، نظام اعتباردهیای که جامعه ریاضی به آن وابسته است، بنیان خود را از دست میدهد. این نظام مشخص میکند چه کسی چه ایدهای را مطرح کرده، چه کسی شایسته تقدیر است و مسئولیت کارهای بعدی بر عهده چه کسی قرار دارد. افزایشی در دانش که تبار فکری و منشأ دستاوردهای آن قابل ردیابی نباشد، از نظر علمی ناقص و از نظر اخلاقی بالقوه بهرهکشانه است.
اکنون به داوری اولیه شما بازگردیم: هوش مصنوعی باید مکملی سودمند برای ریاضیات انسانی تلقی شود، نه جایگزین آن. این داوری در اصل درست است. نه دنگ و نه تائو منکر ظرفیتهای ریاضی هوش مصنوعی نیستند. دنگ میپذیرد که اثباتهای تولیدشده با هوش مصنوعی «شگفتانگیزند» و «ایدههای جدید بسیار خوبی» در خود دارند. او این روند را «همتکاملی انسان و هوش مصنوعی» توصیف میکند. تائو نیز مدتهاست از هوش مصنوعی برای جستوجوی منابع علمی، تولید کد و آزمودن ایدهها استفاده میکند و وضعیت کنونی را گذار از «کمبود اثبات» به «فراوانی اثبات» میداند. هیچکس با اصل استفاده از هوش مصنوعی بهعنوان مکمل مخالفت ندارد.
محور اصلی اختلاف این است که چه نوع عملکردی شایسته نام مکمل است. ابزاری که از داوری همتا عبور میکند، از دست رفتن معنا در ترجمه مفهومی را پنهان میسازد، مجموعه مسائل آموزشی را تهی میکند و امکان ردیابی منشأ ایدهها و انتساب آنها را از بین میبرد، مکمل ریاضیات نیست. چنین رویکردی جایگزین هنجارهایی میشود که جامعه ریاضی به کمک آنها دانش قابل اعتماد تولید میکند، نسل بعدی تولیدکنندگان دانش را آموزش میدهد و اعتبار علمی را حفظ میکند. اعتراضهای مطرحشده در این مناقشه از همین هنجارها دفاع میکنند. بحران پاییز ۲۰۲۶ بحثی درباره مفید بودن یا نبودن هوش مصنوعی نیست؛ مسئله این است که آیا یک شیوه تجاریِ تولید خروجی باید شرایط تولید دانش ریاضی را از نو تعریف کند یا نه. روشهای قابل استفاده مجدد و ارتقای سطح مفهومی که شما به آنها اشاره میکنید، خودبهخود پدید نمیآیند؛ بهویژه اگر هزینه راستیآزمایی بدون محدودیت به دیگران منتقل شود، صحت صوری از صحت مفهومی جدا بماند، منابع آموزشی بیرویه استخراج شوند و پیوندهای تاریخی و فکری دستاوردها از میان بروند. تحقق این اهداف به جامعهای نیاز دارد که آماده باشد نتایج را بررسی و درک کند، منشأ ایدهها را ردیابی کند، دانش را آموزش دهد و بر پایه آن مسیرهای تازهای بگشاید. خواسته اصلی منتقدان این است که خروجی هوش مصنوعی به شیوهای وارد این جامعه شود که به هنجارها و نیازهای آن احترام بگذارد. این تنها شکل واقعبینانهای از همان مکمل سودمندی است که شما امیدوارید هوش مصنوعی فراهم کند.