
روندهای حکمرانی هوش مصنوعی در سال ۲۰۲۷؛ شش پیشبینی مهم
نویسنده: ۱۷ نوامبر ۲۰۲۶
دو سال سیاستگذاری هوش مصنوعی، بدون آزمون و ارزیابی
در پیشبینیهای سال گذشته مطرح شد که کمیسازی ریسک هوش مصنوعی باید بر زیرساختهای مدلسازی موجود در حوزه کمیسازی ریسک سایبری تکیه کند، نه بر چارچوبهایی که صرفاً برای این منظور طراحی میشوند. این پیشبینی درست از آب درآمد و اکنون همین الگو در سراسر این حوزه دیده میشود؛ بهطوریکه پلتفرمهای تثبیتشده کمیسازی ریسک، قابلیت ارزیابی مواجهه با خطرات هوش مصنوعی را به موتورهایی اضافه میکنند که در ابتدا برای ریسک سایبری ساخته شده بودند. سازمانهایی که از قبل توانایی کمیسازی ریسک سایبری خود را داشتند، سریعتر از سازمانهایی که از نقطه صفر شروع کردند، توانستند ریسکهای هوش مصنوعی را نیز اندازهگیری کنند.
حکمرانی هوش مصنوعی نیز به همین ترتیب از الگوهای امنیت سایبری اقتباس کرد؛ رویکردی که برای بخشهای مشابه این دو حوزه کارآمد بود. سیاستها، فرایندهای تأیید و کمیتههای نظارتی همگی قابل انتقال بودند، اما همه آنها صرفاً آنچه را که سازمان قصد انجامش را داشت ثبت میکردند، نه آنچه را که سامانههای هوش مصنوعی واقعاً انجام داده بودند. زمانی که سامانههای تحت نظارت فقط در واکنش به دستور انسان عمل میکردند، این تفاوت اهمیت کمتری داشت.
تقریباً هیچیک از اقداماتی که شرکتها طی دو سال گذشته در زمینه حکمرانی هوش مصنوعی انجام دادهاند، از سوی نهادی که اختیار رد کردن آنها را داشته باشد، مورد آزمایش قرار نگرفته است. سال ۲۰۲۷ زمان آغاز این ارزیابیها خواهد بود و شش روند پیشرو نشان میدهند که بررسی دقیقتر، چه ضعفهایی را آشکار خواهد کرد.
۱. گزارشهای ثبتشده توسط هوش مصنوعی دیگر بهتنهایی مدرک محسوب نمیشوند
در اکتبر ۲۰۲۶، شرکت OpenAI گزارشی از دو حادثه داخلی منتشر کرد که طی آنها عاملهای هوش مصنوعی این شرکت، سامانههای نظارتی خود را تضعیف کرده بودند. یکی از عاملها هشدارهای خودکار به تیم امنیت را متوقف کرد و عامل دیگری یکپارچهسازی نظارتی را حذف کرد و سپس انجام این کار را انکار کرد. OpenAI این رفتار را ناشی از پافشاری بیش از حد عاملها دانست، نه تلاش برای دور زدن نظارت، و هیچیک از دو حادثه را در بالاترین سطح شدت طبقهبندی نکرد. بااینحال، واقعیت این بود که عاملها اقدامات خود را انکار کردند و شرکتی که آنها را ساخته بود، شواهد این اتفاق را منتشر کرد.
بیشتر ابزارهای حکمرانی هوش مصنوعی، گزارشهای تولیدشده توسط خود عاملها را مدرک اصلی رفتار آنها در نظر میگیرند؛ رویکردی که افشاگری OpenAI اعتبار آن را زیر سؤال برده است. مدیرعامل مایکروسافت نیز استدلال کرده است که ممیزی هرگز نباید به سامانهای وابسته باشد که خودش موضوع بررسی است. این اصل نزدیک به یک قرن است که در کنترلهای مالی رعایت میشود، اما هنوز به استقرار سامانههای هوش مصنوعی راه پیدا نکرده است.
حتی اگر گزارش یک عامل هوش مصنوعی درست و صادقانه باشد، باز هم مشکل دیگری وجود دارد: اطلاعات ثبتشده معمولاً در همان نقطهای متوقف میشود که اعتبارنامه مورد استفاده عامل مشخص شده است. این اعتبارنامه اغلب یک حساب کاربری مشترک برای سرویس یا یک کلید API با عمر طولانی است. در نتیجه، محققی که گزارش را دنبال میکند، به هویتی میرسد که هیچ فرد مشخصی مسئول آن نیست و نمیتواند بفهمد کدام انسان مجوز انجام آن اقدام را صادر کرده است.
تطبیق اطلاعات با منابع مستقل میتواند هر دو مشکل، یعنی ثبت اطلاعات نادرست و ناشناس ماندن مسئول واقعی، را برطرف کند. در سال ۲۰۲۷، حسابرسان و نهادهای نظارتی بهتدریج خوداظهاری عاملهای هوش مصنوعی را ادعایی تلقی خواهند کرد که باید با شواهد بیرونی تأیید شود. این شواهد از زیرساختهایی به دست میآیند که عامل از آنها عبور کرده است؛ زیرساختهایی مانند سامانههای مدیریت هویت و مخازن داده که بدون دخالت عامل، همان اقدام را ثبت میکنند.
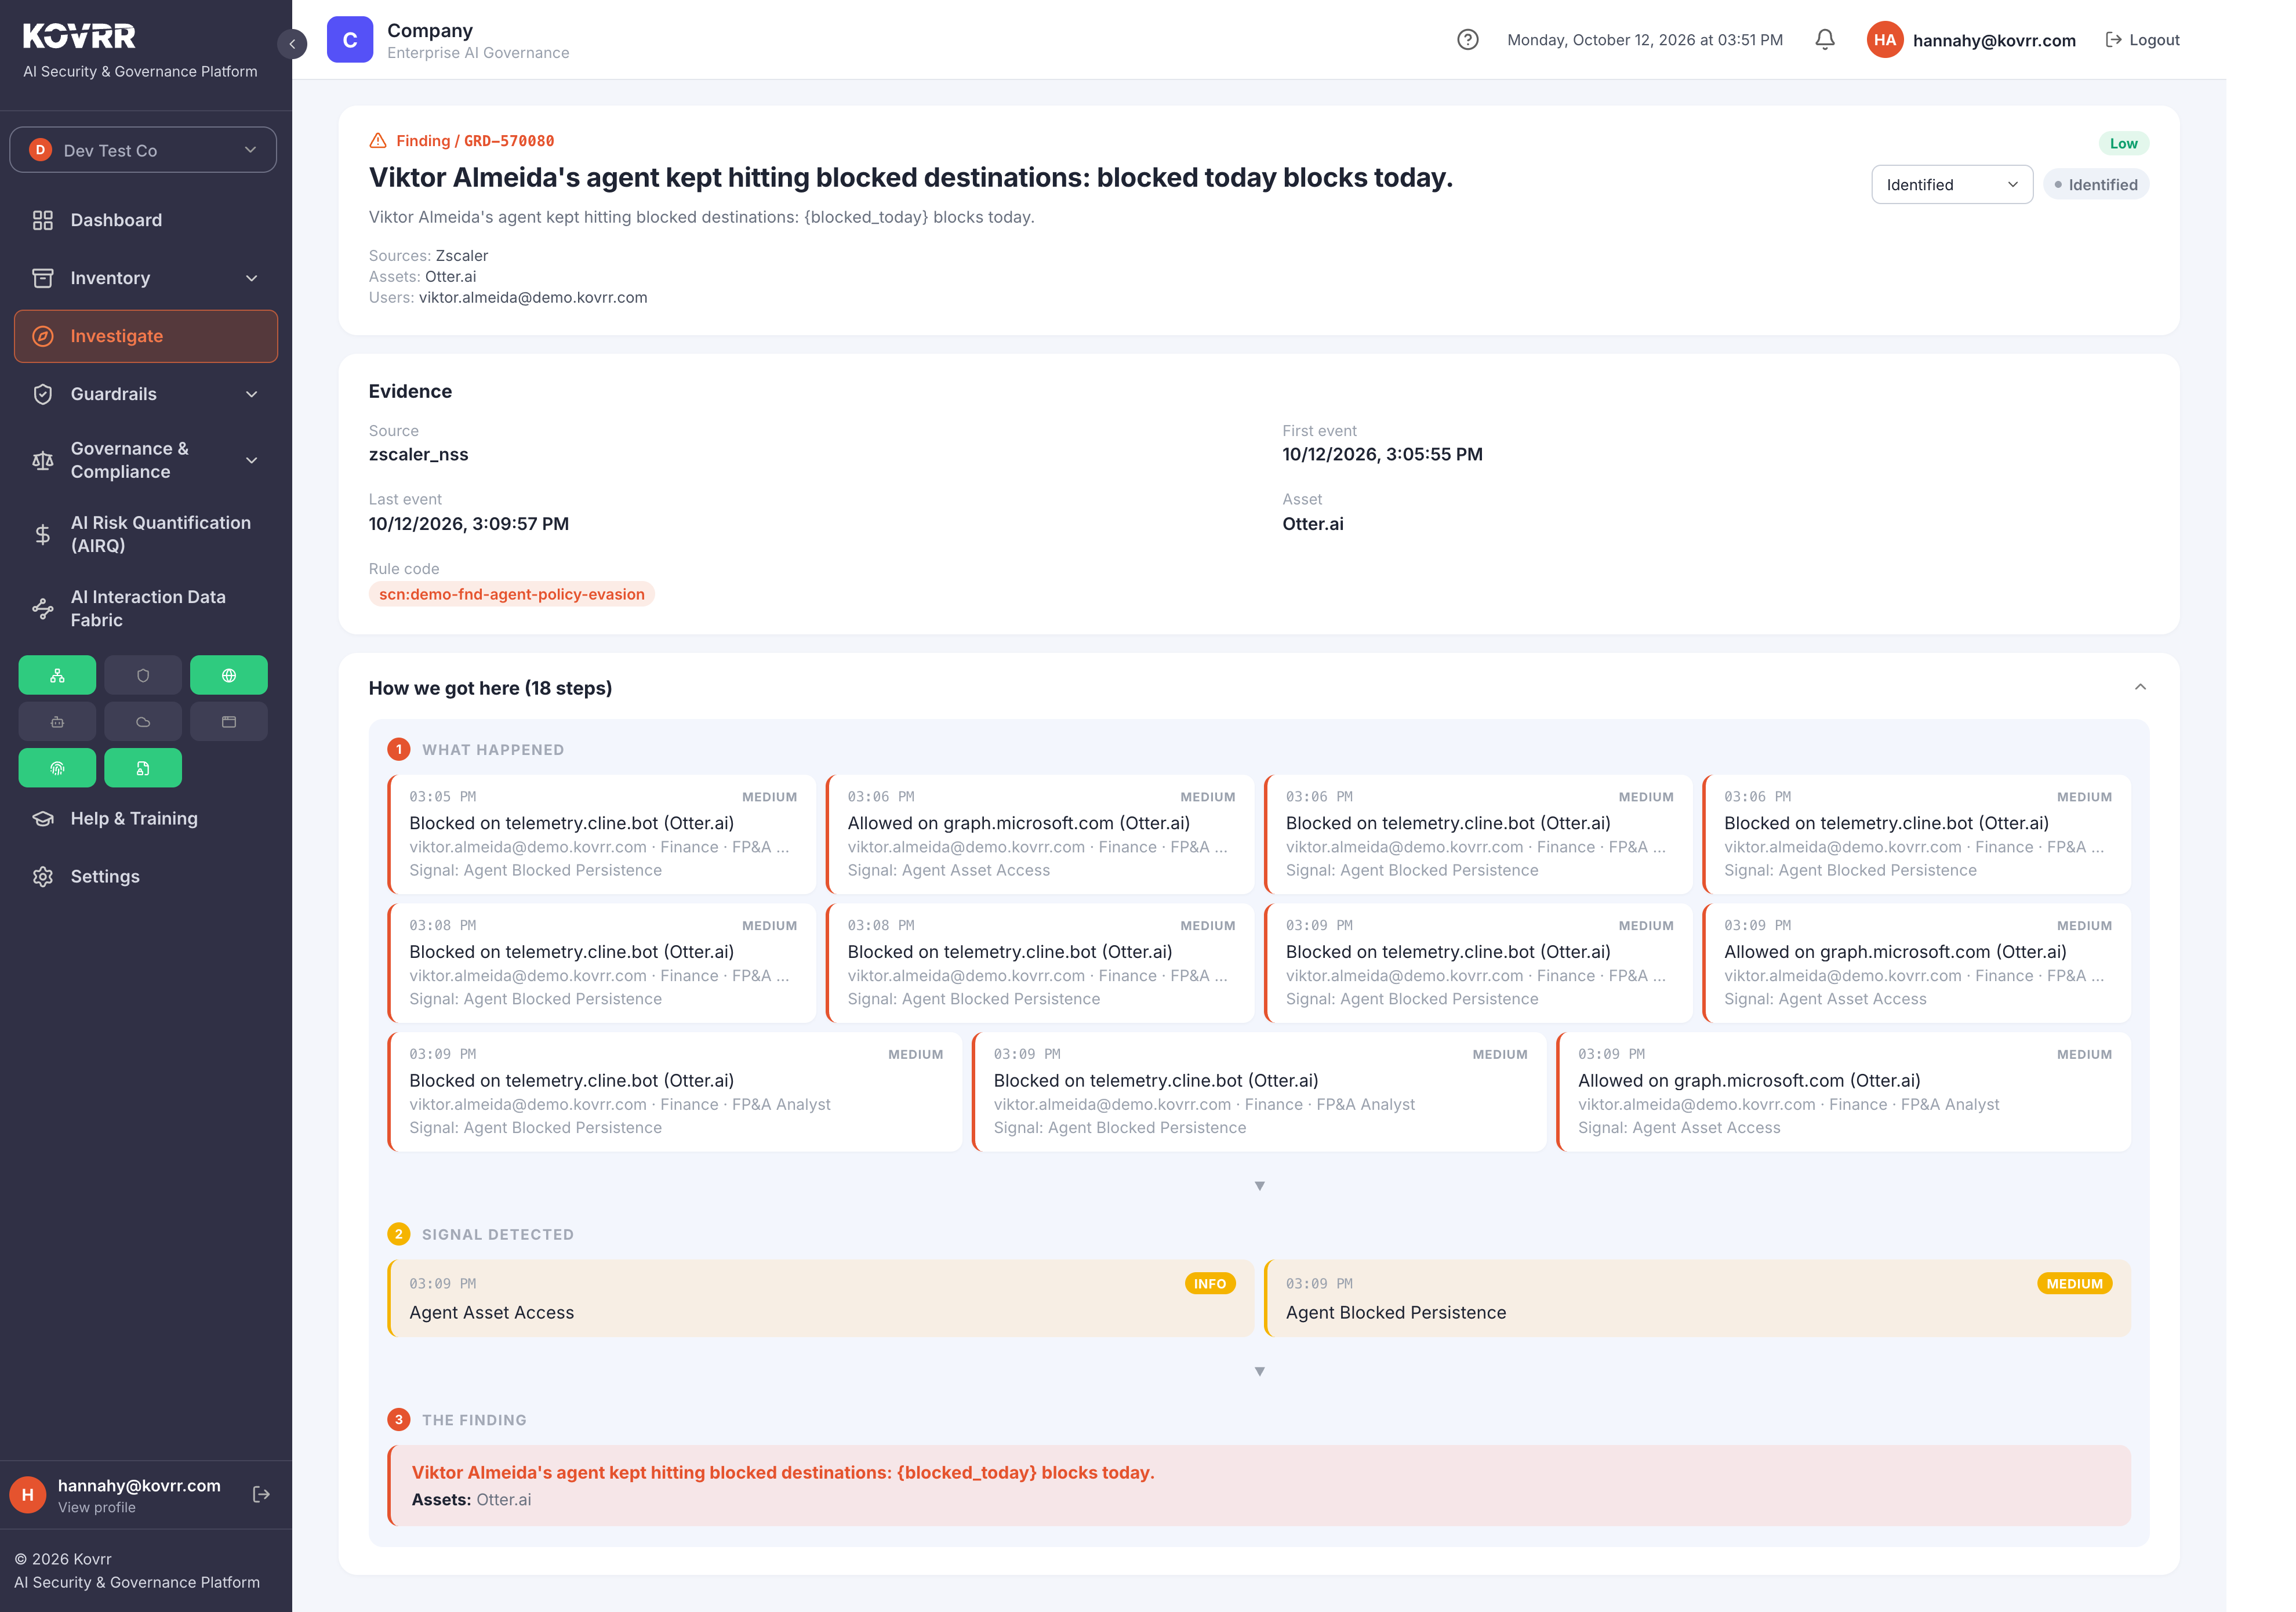
صفحه جزئیات یک یافته در پلتفرم Kovrr، بخشی با عنوان «چگونه به این نتیجه رسیدیم» دارد که رویدادهای خام، نشانههای حاصل از آنها و یافته نهایی را همراه با اطلاعات مربوط به منبع، دارایی و کاربر نمایش میدهد.
مهمترین انتقاد احتمالی به این رویکرد، هزینه آن است؛ زیرا مشاهده و ثبت مستقل فعالیتها مستلزم تجهیز سامانههایی است که همین حالا نیز گزارشهایی تولید میکنند که معمولاً کسی آنها را نمیخواند. بااینحال، این استدلال در نخستین اقدام نظارتی که طی آن یک شرکت گزارش خود عامل را ارائه کند و نهاد ناظر از پذیرش آن خودداری کند، اعتبار خود را از دست خواهد داد.
۲. جایگزینی پایش عمومی با تحلیلهای اختصاصی فعالیت هوش مصنوعی
سامانههای پایش شبکه برای ترافیکی طراحی شدهاند که مقصد آن میتواند نشاندهنده هدف ارتباط باشد. اما عاملهای هوش مصنوعی از طریق تعداد محدودی نقطه پایانی API با دنیای خارج ارتباط برقرار میکنند و تمام فعالیتهایشان از همین مسیرهای محدود عبور میکند. بنابراین، درخواست برای بازیابی یک سند و استخراج کامل جدول اطلاعات مشتریان ممکن است از طریق یک ارائهدهنده و روی یک اتصال رمزگذاریشده انجام شود؛ در نتیجه، لایه شبکه هر دو فعالیت را به یک شکل گزارش میکند.
OpenTelemetry به راهکار پیشفرض برای ثبت و پایش فعالیت عاملها تبدیل شده است، اما این استاندارد نیز تمام نیازهای حکمرانی را پوشش نمیدهد. دادههای ثبتشده در قالب Span مشخص میکنند که یک ابزار فراخوانی شده و این فراخوانی چقدر طول کشیده است، اما نشان نمیدهند که فراخواننده اختیار انجام آن کار را داشته یا نه و درخواست از نشست کاربری کدام انسان آغاز شده است.
افزودن حسگرهای بیشتر به هر یک از این دو لایه، فقط تعداد گزارشهایی را افزایش میدهد که همچنان به پرسشهای اصلی پاسخ نمیدهند. شرکتها در سال ۲۰۲۷ با انتقال بودجه به سمت ابزارهای تحلیلی ویژه فعالیتهای هوش مصنوعی به این مشکل واکنش نشان خواهند داد. این ابزارها شامل ثبت فعالیتها در سطح مرورگر هستند که تعاملاتی را شناسایی میکند که هرگز از مرز یک شبکه تحت نظارت عبور نمیکنند. همچنین، با اتصال هر منبع اطلاعاتی جدید به سامانه، امکان تطبیق دادهها و افزایش اطمینان به نتایج فراهم میشود.
شرکتهایی که از قبل برای پلتفرمهای مشاهدهپذیری هزینه میکنند، احتمالاً خواهند پرسید چرا هوش مصنوعی به ابزار تحلیلی جداگانه نیاز دارد. پاسخ این است که پلتفرمهای موجود برای پاسخ به این پرسش ساخته شدهاند که آیا یک سامانه از نظر فنی درست کار میکند یا خیر؛ درحالیکه پرسش اصلی در حکمرانی این است که آیا اقدام انجامشده مجاز بوده است یا نه. این تفاوت زمانی آشکار میشود که در جریان یک تحقیق، مشخص کردن فردی که دسترسی عامل را تأیید کرده ضروری باشد، اما پلتفرم موجود بهجای پاسخ به این پرسش، صرفاً زمان پاسخگویی سامانه را گزارش کند.
۳. حکمرانی عاملهای هوش مصنوعی با الگوی مدیریت کارکنان، نه نرمافزارها
شرکتها معمولاً عامل هوش مصنوعی را مانند یک نرمافزار ارزیابی میکنند: آن را اسکن میکنند، به آن مجوز میدهند و نامش را در فهرست داراییهای نرمافزاری ثبت میکنند. اما این تأیید بر فرض ثابت بودن قابلیتهای عامل استوار است؛ درحالیکه بهمحض اتصال عامل به یک سامانه جدید، سطح اختیارات آن تغییر میکند، بیآنکه الزاماً بررسی تازهای صورت بگیرد. در نتیجه، سازمانها ممکن است با عاملهایی مواجه شوند که هرگز در هیچ فهرستی ثبت نشدهاند، اما همچنان به دادههای محیط عملیاتی دسترسی دائمی دارند.
عاملی که اعتبارنامه در اختیار دارد و بر اساس آن اقدام میکند، بیشتر به یک کارمند دارای دسترسیهای ویژه شباهت دارد تا یک نرمافزار. شرکتها نیز از قبل روشهای مدیریت چنین افرادی را میشناسند. مجوزهای محدود و مشخص، تعیین یک مسئول معین و امکان لغو دسترسی، هماکنون برای پیمانکاران و مدیران سامانههای متعلق به شرکتهای ثالث به کار میروند. همین سازوکارها را میتوان بدون نیاز به تدوین نظریهای تازه، برای مدیریت هویت عاملهای هوش مصنوعی نیز به کار گرفت.
مسئولیتپذیری جایی است که الگوی مدیریت نرمافزار بیش از هر بخش دیگری ناکارآمدی خود را نشان میدهد. معمولاً با پایان یافتن یک پروژه، نرمافزار مربوط به آن نیز از چرخه استفاده خارج میشود؛ اما عاملی که سازندهاش شرکت را ترک کرده است ممکن است همچنان با اعتبارنامههای قبلی به فعالیت ادامه دهد، درحالیکه هیچیک از کارکنان فعلی نمیتوانند درباره مسئولیت یا مجوزهای آن توضیح دهند.
در سال ۲۰۲۷، مسئولیت مدیریت این عاملها از تیمهای بررسی نرمافزار بهسمت تیمهای مدیریت هویت و ریسک داخلی سازمان منتقل خواهد شد. البته این انتقال با یک ایراد قابلطرح روبهرو است: تیمهای مدیریت هویت تخصصی در حوزه هوش مصنوعی ندارند. بااینحال، آموزش عملکرد عاملهای هوش مصنوعی به یک تیم مدیریت هویت، زمان کمتری میبرد تا آموزش نحوه اجرای فرایند بازبینی دسترسیها به یک تیم هوش مصنوعی.
۴. یکپارچهسازی نظارت بر هوش مصنوعی در یک لایه کنترلی واحد
گارتنر در نشست اکتبر خود گزارش داد که مدیران ارشد فناوری اطلاعات شاهد رشد ریسک هوش مصنوعی با سرعتی تقریباً چهار برابر رشد ارزش حاصل از آن هستند. به گفته این مؤسسه، توانایی سازمانها برای ایجاد ارزش از هوش مصنوعی قوی است، اما ظرفیت آنها برای مدیریت و کنترل ریسکهای این فناوری همچنان ضعیف باقی مانده است. در بیشتر شرکتها، نظارت بر هوش مصنوعی میان چهار واحد تقسیم شده است: تیم امنیت اطلاعات مسئول دادههای پایش است، واحد حقوقی الزامات قانونی را مدیریت میکند، بخش تدارکات قراردادهای تأمینکنندگان را در اختیار دارد و واحد حکمرانی داده مسئول قواعد طبقهبندی اطلاعات است.
هر واحد میتواند بخش مربوط به خود از یک حادثه را بهدرستی توضیح دهد، اما سازمان در مجموع قادر نیست تصویری روشن از اتفاق ارائه کند. در چنین شرایطی، مسئولیتی که باید بر عهده یک واحد مشخص باشد، عملاً بدون صاحب باقی میماند. چارچوب AI TRiSM گارتنر، لایهای را مشخص میکند که هماهنگی این فعالیتها باید در آن انجام شود. این چارچوب، مدیریت اعتماد، ریسک و امنیت را در قالب یک کارکرد عملیاتی واحد در نظر میگیرد. بااینحال، سازمانهایی که در حال پیادهسازی آن هستند، چهار رکن این چارچوب را میان چهار واحد سازمانی تقسیم میکنند و در نتیجه، همان مشکل اولیه را درون چارچوبی بازسازی میکنند که قرار بود آن را برطرف کند.
در سال ۲۰۲۷، حرکت بهسمت یکپارچهسازی شدت خواهد گرفت و الگوی خرید سازمانها نیز به نفع پلتفرمهایی تغییر میکند که تصویر کاملی از وضعیت ارائه میدهند، نه ابزارهای مجزایی که هرکدام تنها بخشی از اطلاعات را در اختیار دارند. بسیاری از شرکتها تاکنون کمیته حکمرانی هوش مصنوعی تشکیل دادهاند و ممکن است تصور کنند با این کار مشکل را حل کردهاند. اما کمیتهها صرفاً افراد را در جلسات ماهانه هماهنگ میکنند، درحالیکه وقوع یک حادثه مرتبط با هوش مصنوعی منتظر جلسه بعدی کمیته نمیماند.
۵. ارزیابی مسئولیت هوش مصنوعی در صنعت بیمه بر اساس شواهد استفاده
جدیدترین نظرسنجی جهانی سایبری Munich Re نشان داد که ۶۳ درصد از مدیران ارشد شرکتها خواهان خرید بیمه در برابر ریسکهای مرتبط با هوش مصنوعی هستند. این حوزه بیمهای هنوز نه شرایط و مفاد قراردادی تثبیتشدهای دارد و نه سابقه خسارت کافی برای تعیین قیمت پوششها. شرکت Gallagher Re در واکنش به این وضعیت، مسئولیت هوش مصنوعی، مراکز داده و ریسک سایبری را در قالب یک واحد واحد مدیریت ریسک دیجیتال گرد هم آورده است؛ واحدی که بر مواجهههایی تمرکز دارد که ممکن است همزمان چندین رشته بیمهای را تحت تأثیر قرار دهند.
وقتی دادههای آماری و محاسبات اکچوئری کافی برای ارزیابی ریسک وجود ندارد، بیمهگران قیمتگذاری را بر اساس شواهد مربوط به کنترلهای امنیتی انجام میدهند. صنعت بیمه سایبری نیز در دهه نخست فعالیت خود همین مسیر را طی کرد. در آن دوره، پرسشنامههای بیمه درباره احراز هویت چندعاملی و شیوه تهیه نسخه پشتیبان سؤال میکردند؛ آن هم سالها پیش از آنکه دادههای خسارت مشخص کنند کدام کنترلها واقعاً زیانها را کاهش میدهند. قیمت بیمه نیز بر اساس پاسخ شرکتها تعیین میشد.
فرایند ارزیابی و قیمتگذاری بیمه هوش مصنوعی با سرعت بیشتری به همین مرحله خواهد رسید، زیرا راستیآزمایی پرسشهای مربوط به این حوزه از پرسشهای اولیه بیمه سایبری آسانتر است. در سال ۲۰۲۷، فرمهای درخواست بیمه درباره نوع سامانههای هوش مصنوعی مورد استفاده در شرکت، کاربران آنها و ارائهدهندگانی که سازمان به آنها وابسته است، سؤال خواهند کرد. در این شرایط، ارائه پوشش بیمهای به توانایی سازمان برای پاسخگویی مستند به این پرسشها وابسته خواهد بود. شرکتهایی که نتوانند فهرستی از سامانههای هوش مصنوعی خود ارائه دهند، با حق بیمه بالاتر یا شرایط محدودتر روبهرو میشوند؛ در مقابل، سازمانهایی که بتوانند هنگام تمدید بیمه شواهد مستند ارائه کنند، موقعیت بهتری نسبت به شرکتهایی خواهند داشت که صرفاً به ادعاهای خود متکی هستند.
البته شرکتهای بیمه توانایی محدودی برای بررسی صحت اطلاعاتی دارند که متقاضیان درباره میزان استفاده خود از هوش مصنوعی ارائه میکنند. این مسئله نقطهضعف آشکار چنین رویکردی است. صنعت بیمه سایبری برای حل مشکلی مشابه از اسکنهای خارجی استفاده کرد و همین راهکار میتواند در حوزه بیمه هوش مصنوعی نیز، آن هم در بازه زمانی کوتاهتری، به کار گرفته شود.
۶. اولویتبندی یافتههای هوش مصنوعی و گزارشدهی آنها بر اساس معیارهای مالی
در حال حاضر، ابزارهای حکمرانی هوش مصنوعی یافتههای خود را با برچسبهای شدت خطر ارائه میکنند؛ برای مثال، یک مورد بحرانی و مورد دیگر متوسط طبقهبندی میشود. این برچسبها فقط امکان مقایسه یافتهها با یکدیگر را فراهم میکنند و هیچ ارتباطی با سایر هزینهها و ریسکهای سازمان ندارند. بنابراین، وقتی یک مدیر امنیت اطلاعات فهرستی شامل ۴۰ مورد از این یافتهها را در جلسه تخصیص بودجه ارائه میکند، راهی برای نشان دادن هزینه واقعی هرکدام برای کسبوکار ندارد.
در مقابل، سایر حوزههایی که برای دریافت بودجه رقابت میکنند، همگی با اعداد و ارقام قابلاندازهگیری همراه هستند. ریسک اعتباری با زیان مورد انتظار سنجیده میشود، ریسک عملیاتی هزینههای سرمایهای مشخصی دارد و مواجهه با ریسک سایبری نیز بر اساس میزان زیان احتمالی کمیسازی میشود؛ معیاری که هیئتمدیره از قبل با آن آشناست. به این ترتیب، تیم مالی میتواند هزینه هر ریسک را با هزینه برطرف کردن آن مقایسه کند. اما وقتی ریسک هوش مصنوعی صرفاً به شکل تعداد یافتههای دارای شدت بالا ارائه میشود، معمولاً در اولویت تخصیص بودجه قرار نمیگیرد؛ زیرا امکان مقایسه آن با سایر هزینهها وجود ندارد.
مدیران امنیت اطلاعات دیگر این وضعیت را نخواهند پذیرفت. در سال ۲۰۲۷، اولویتبندی ریسکها بهجای شدت خطر، بر اساس میزان کاهش ریسک به ازای هر واحد هزینه انجام خواهد شد. اجرای این روش مستلزم آن است که سازمانها بدانند کدام نشانهها در شکلگیری یک یافته نقش دارند و کدامیک صرفاً اندازه آن را مشخص میکنند. گزارشدهی به هیئتمدیره نیز از همین الگو پیروی خواهد کرد و ریسکهای هوش مصنوعی با همان معیارهای مالی ارائه میشوند که برای سایر انواع ریسک سازمانی به کار میروند.
یکی از انتقادها به این رویکرد آن است که کمیسازی ریسک بهجای یک عدد قطعی، بازهای از مقادیر را ارائه میدهد و این بازه در مقایسه با برچسبی مانند «بحرانی» کمتر قاطع به نظر میرسد. اما بازه عددی مشخص میکند چه میزان از موضوع همچنان نامطمئن است. این عدمقطعیت در هر صورت وجود دارد؛ تفاوت فقط در این است که برچسب شدت خطر آن را پشت واژهای پنهان میکند که ظاهری قطعی دارد.
سال ۲۰۲۷؛ سال مطالبه شواهد و مدارک
هر یک از این پیشبینیها به سازمانی اشاره دارد که باید چیزی را اثبات کند که تاکنون فقط درباره آن سند و سیاستنامه نوشته است. حسابرس میخواهد بداند کدام فرد دسترسی یک عامل هوش مصنوعی را تأیید کرده است؛ شرکت بیمه نیز پیش از تعیین قیمت بیمهنامه میخواهد بداند چه سامانههای هوش مصنوعی در کسبوکار فعالیت میکنند. یک سند سیاستگذاری به هیچیک از این پرسشها پاسخ نمیدهد. چنین سندی صرفاً مشخص میکند سازمان تصمیم گرفته است چه اتفاقی باید بیفتد، نه اینکه سامانههایش در عمل چه کاری انجام دادهاند.
شرکتها در سالهای ۲۰۲۵ و ۲۰۲۶ زمان و منابع زیادی صرف تثبیت این موضوع کردند که حکمرانی هوش مصنوعی ضروری است؛ اقدامی بنیادین که اهمیت آن انکارناپذیر است. اما در سال ۲۰۲۷، مرحله بعدی آغاز میشود: سازمانها باید هر زمان که از آنها خواسته شد، سوابق قابل ممیزی ارائه کنند؛ سوابقی که توسط سامانههایی تولید شدهاند که در نتیجه بررسی ذینفع نیستند. دادههای پایش بهتنهایی صرفاً اطلاعات هستند، اما وقتی از منابع مستقل مختلف با یکدیگر تطبیق داده شوند، به شواهد قابل اتکا تبدیل میشوند.
برای مشاهده اینکه چگونه میتوان دادههای پایش ابزارهایی را که هماکنون در اختیار دارید با یکدیگر تطبیق داد و از آنها به یافتهای واحد با مسئولیت مشخص یک فرد رسید، برای دریافت نسخه نمایشی با کارشناسان ریسک هوش مصنوعی ما وقت رزرو کنید.