
انتشار Gemini 4 Carbon گوگل دیپمایند تنها دو هفته پس از Argon؛ پیشرفت در طیف گستردهای از معیارها
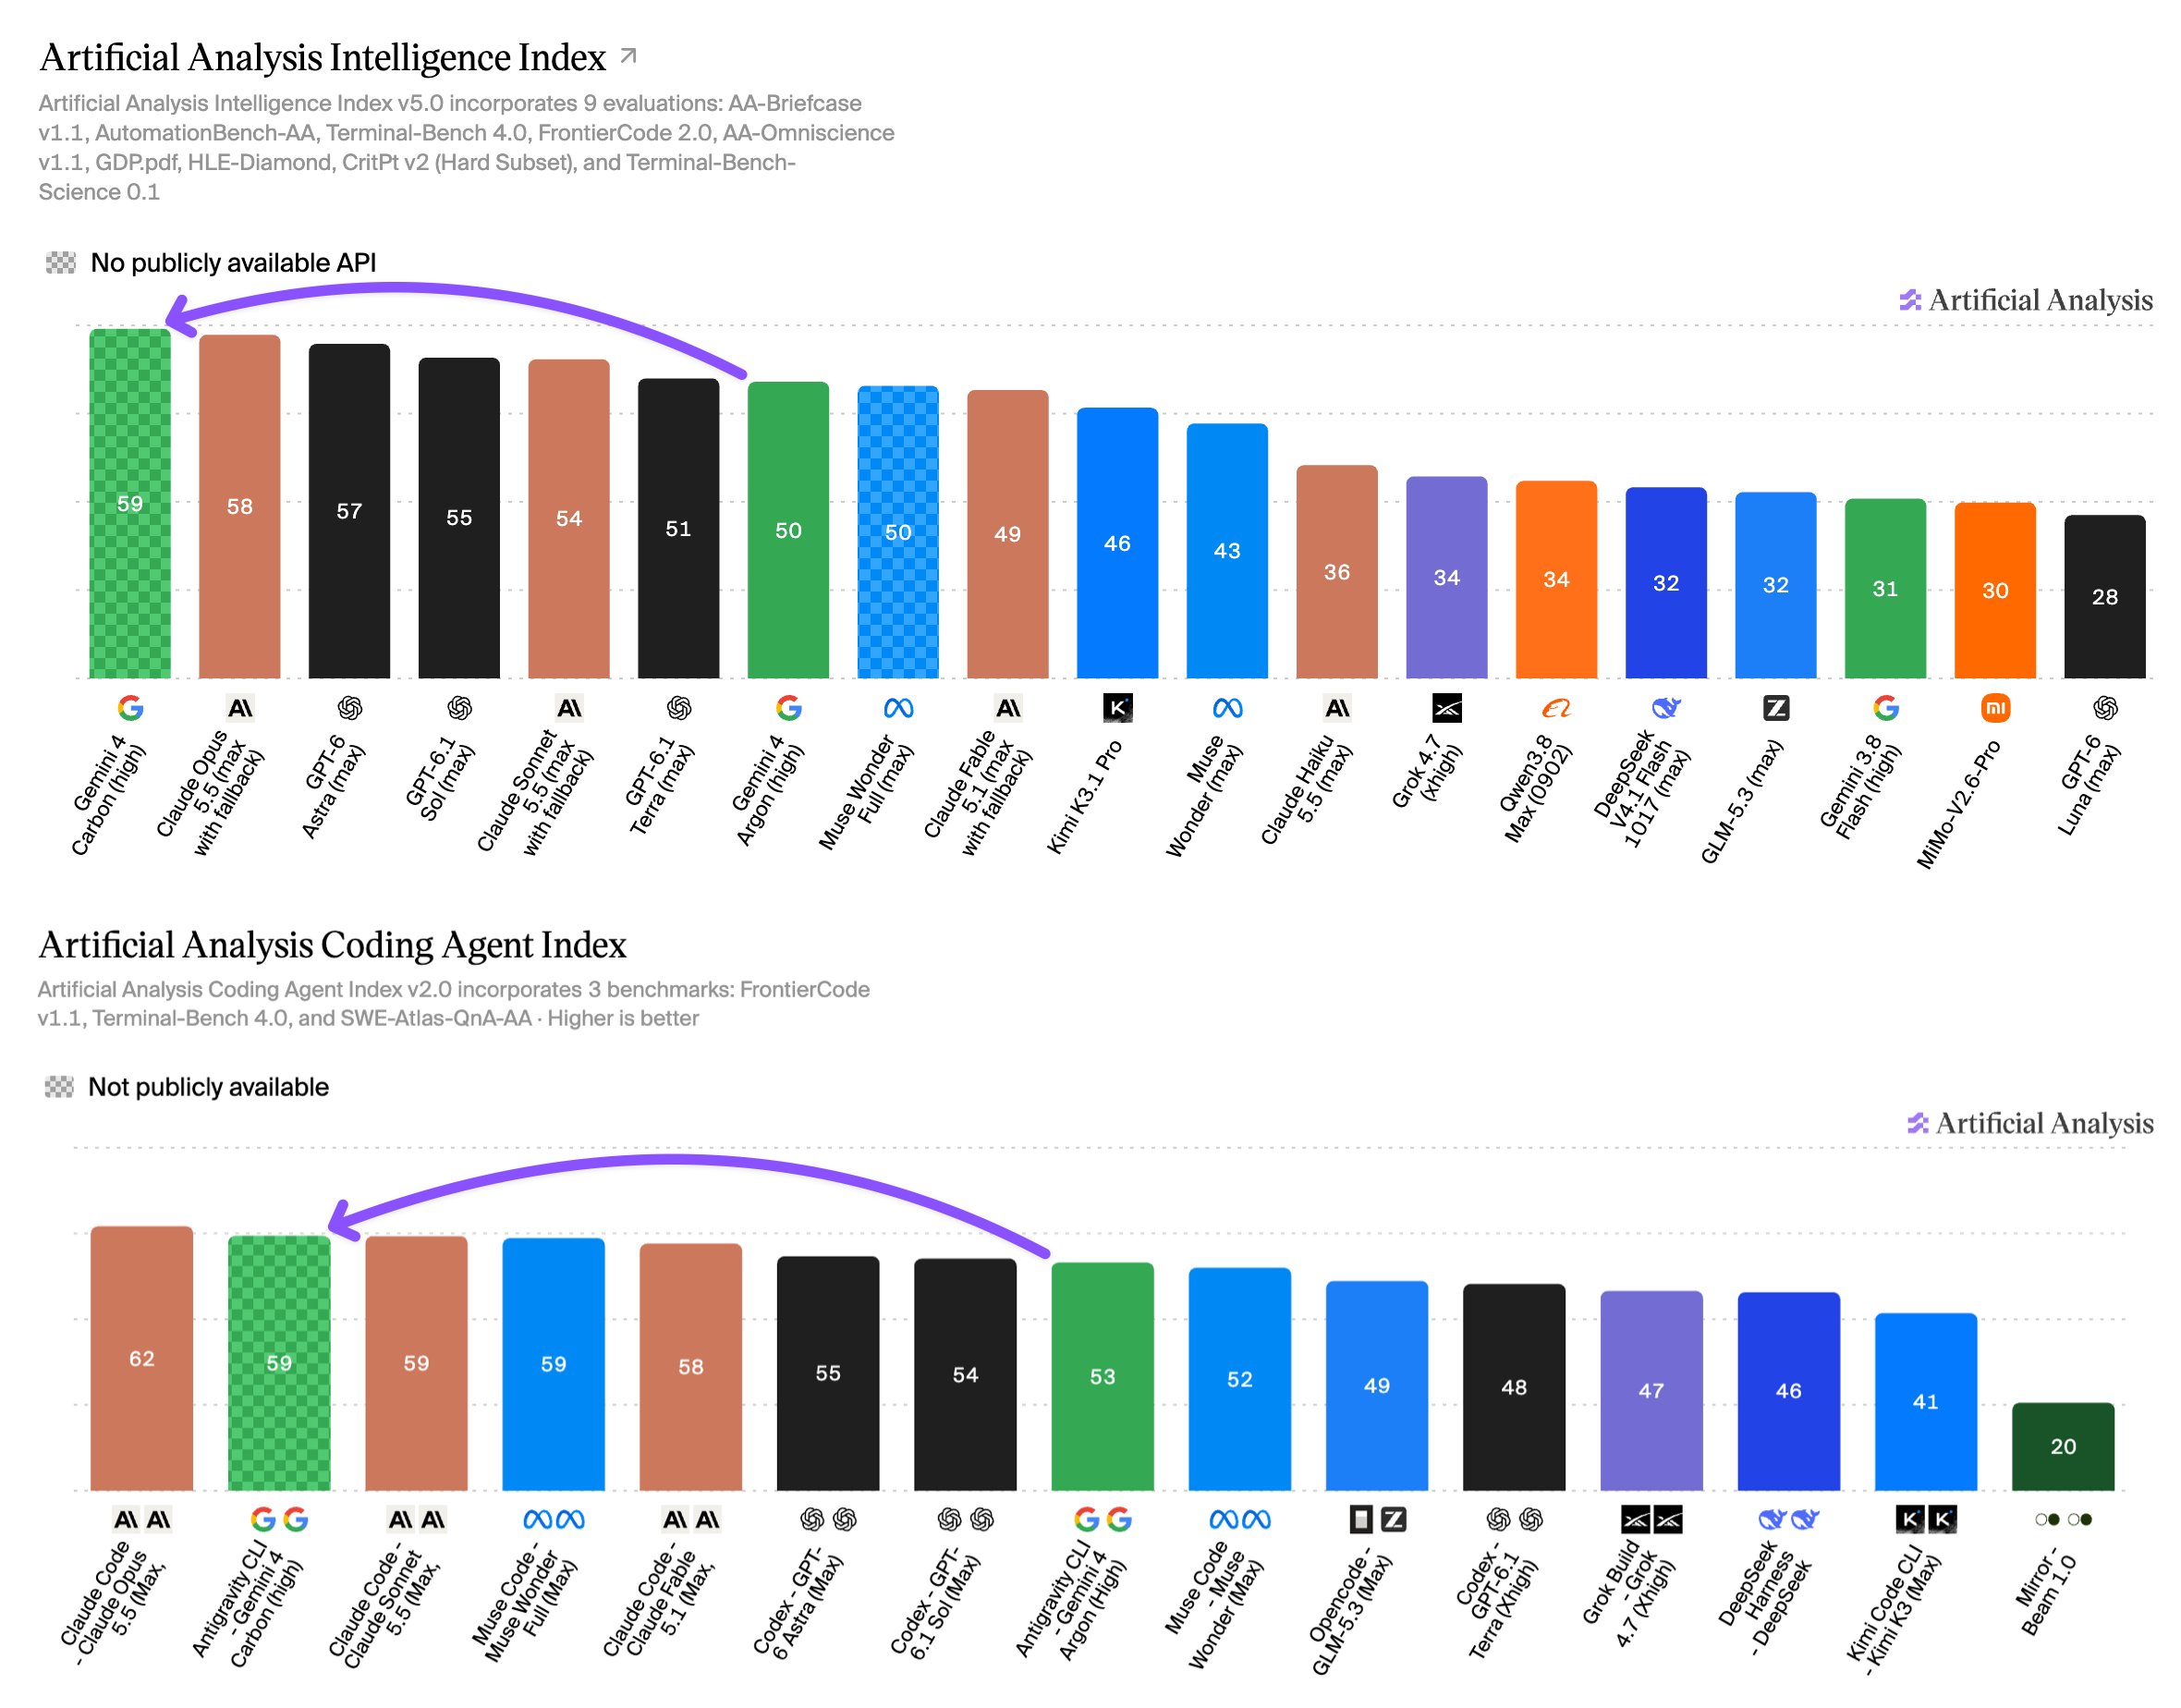
گوگل دیپمایند تنها دو هفته پس از عرضه Gemini 4 Argon، مدل جدید Gemini 4 Carbon را منتشر کرده است؛ مدلی که به رتبه نخست شاخص هوش Artificial Analysis رسیده است.
Carbon در نسخه ۵ شاخص هوش Artificial Analysis که بهتازگی بهروزرسانی شده، ۵۹ امتیاز کسب کرده است؛ درحالیکه مدل قبلی، Argon، با ۵۰ امتیاز در جایگاه پایینتری قرار دارد. گوگل علاوه بر پیشرفت عمومی در انجام وظایف عاملمحور و برنامهنویسی، بر قابلیتهای Carbon در تمام مراحل دفاع سایبری تأکید میکند؛ از شناسایی و اعتبارسنجی آسیبپذیریها گرفته تا برطرف کردن آنها.
طراحیشده برای جلسات برنامهنویسی چندروزه
به گفته گوگل دیپمایند، Carbon برای حل «مسائل مهندسی بسیار دشوارتر و بلندمدت» طراحی شده است؛ مسائلی که به فرایندهای عاملمحور پایدار و مداوم نیاز دارند. گوگل میگوید تیمهای داخلی این شرکت مدل را برای چند روز متوالی به کار گرفتهاند. در این مدت، Carbon بهطور مستقل از بنبستها عبور کرده و وظایف پیچیده و چندمرحلهای، از جمله تحلیل علت ریشهای مشکلات و رفع باگهای ظریف در پایگاههای کد بزرگ و نرمافزارهای سطح پایین، را انجام داده است.
گوگل همچنین بر اساس بازخورد کاربران از پیشرفت در استدلال علمی، درک چندوجهی و توسعه وب فولاستک خبر میدهد. خروجیها و محصولات باکیفیتتر این مدل در توسعه وب، امتیاز آن را در WebDev Arena به میزان ۸۹ امتیاز الو افزایش داده و به ۱۷۶۹ رسانده است؛ امتیازی که جایگاه چهارم را برای Carbon به همراه دارد.
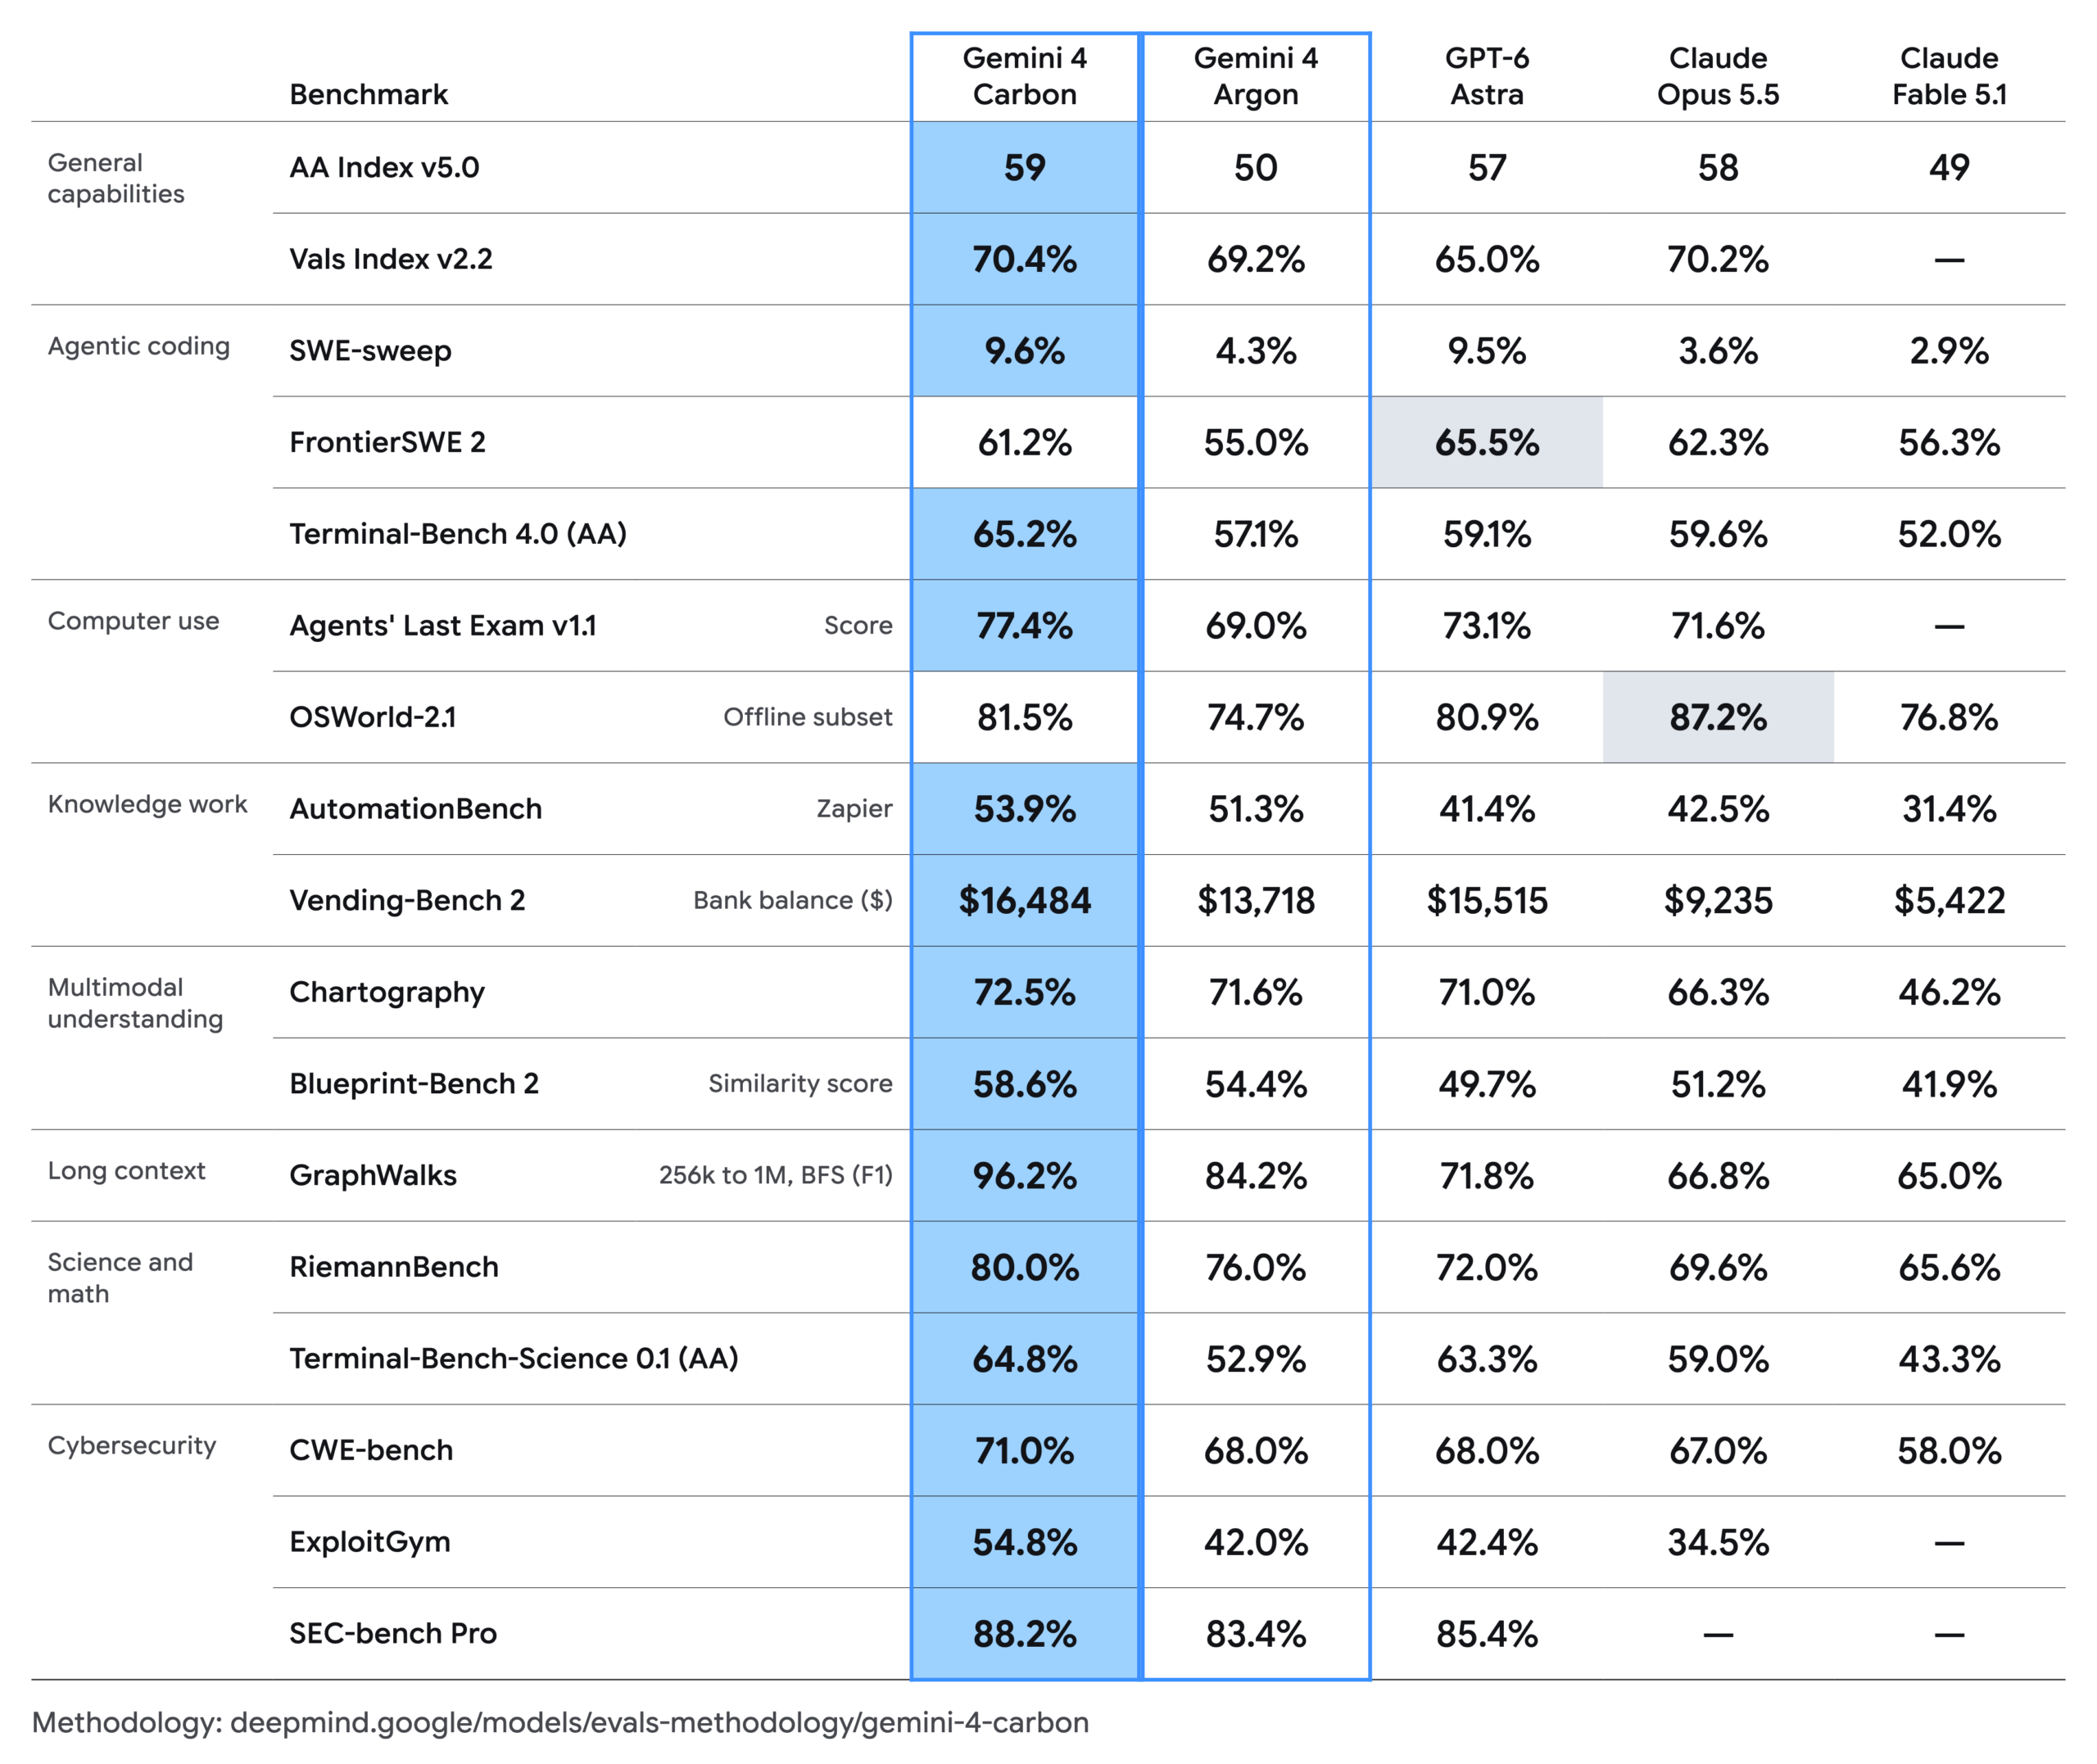
طبق اعلام گوگل، Carbon در آزمون تزریق غیرمستقیم دستور (Indirect Prompt Injection) شرکت Gray Swan، نرخ موفقیت حمله را از ۰٫۷ درصد در Argon به صفر درصد رسانده است؛ به این معنا که تمام تلاشهای دستکاری آزمایششده را مسدود کرده است. البته این نتیجه به معنای حل شدن مسئله تزریق دستور نیست، هرچند به نظر میرسد این آزمون به سقف عملکرد قابل اندازهگیری خود نزدیک شده باشد.
ارزیابیهای مستقل نیز ارقام گوگل را تأیید میکنند
بر اساس ارزیابی Artificial Analysis، Carbon در بالاترین سطح استدلال خود با عنوان «high» عمدتاً بهواسطه امتیازهای برتر در استدلال پیچیده، بازیابی دانش و وظایف علمی، در صدر نسخه پنجم شاخص هوش قرار گرفته است. این مدل در چهار مورد از ۹ ارزیابی مستقل تشکیلدهنده این شاخص، رتبه نخست را به دست آورده است.
در برنامهنویسی عاملمحور روی Antigravity، Carbon با وجود افزایش امتیاز از ۵۳ به ۵۹ نسبت به Argon، همچنان سه امتیاز از Claude Code مجهز به Opus 5.5 عقبتر است. در کارهای دانشی عاملمحور و بر اساس معیار AA-Briefcase، نسخه high مدل Carbon با کسب ۱۶۰۹ امتیاز الو، نسبت به Argon در سطح high که ۱۴۸۳ امتیاز داشت، ۱۲۶ امتیاز پیشرفت کرده است. این بهبود عمدتاً از افزایش ۲۹۳ امتیازی کیفیت ارائهها تا سطح ۱۵۹۸ و رشد ۱۲۰ امتیازی کیفیت تحلیل تا سطح ۱۶۷۱ ناشی میشود. بااینحال، Carbon همچنان از Kimi K3.1 Pro با ۱۶۷۸ امتیاز الو، Muse Wonder در سطح max با ۱۶۵۹ امتیاز و Grok 4.7 در سطح xhigh با ۱۶۳۸ امتیاز عقبتر است.
دقت پاسخگویی Carbon در مقایسه با Argon از ۴۸ به ۵۸ درصد افزایش یافته، اما نرخ توهم آن نیز از ۴ به ۱۱ درصد رسیده است. این نرخ بالاتر است، ولی همچنان دومین نرخ پایین در رتبهبندی محسوب میشود. نسخه max مدل Claude Opus 5.5 و نسخه max مدل GPT-6 Astra هر دو دقت ۵۰ درصدی دارند.
پلتفرم ارزیابی Vals AI نیز Carbon را با دقت ۷۰٫۳۶ درصد در جایگاه دوم قرار داده است. Claude Sonnet 5.5 با دقت ۷۰٫۸۵ درصد در رتبه نخست قرار دارد و Claude Opus 5.5 با ۷۰٫۱۸ درصد پس از Carbon است. Argon نیز با دقت ۶۹٫۲۴ درصد در جایگاه چهارم قرار میگیرد. هزینه استفاده از این مدلها در این مقایسه کمتر است.
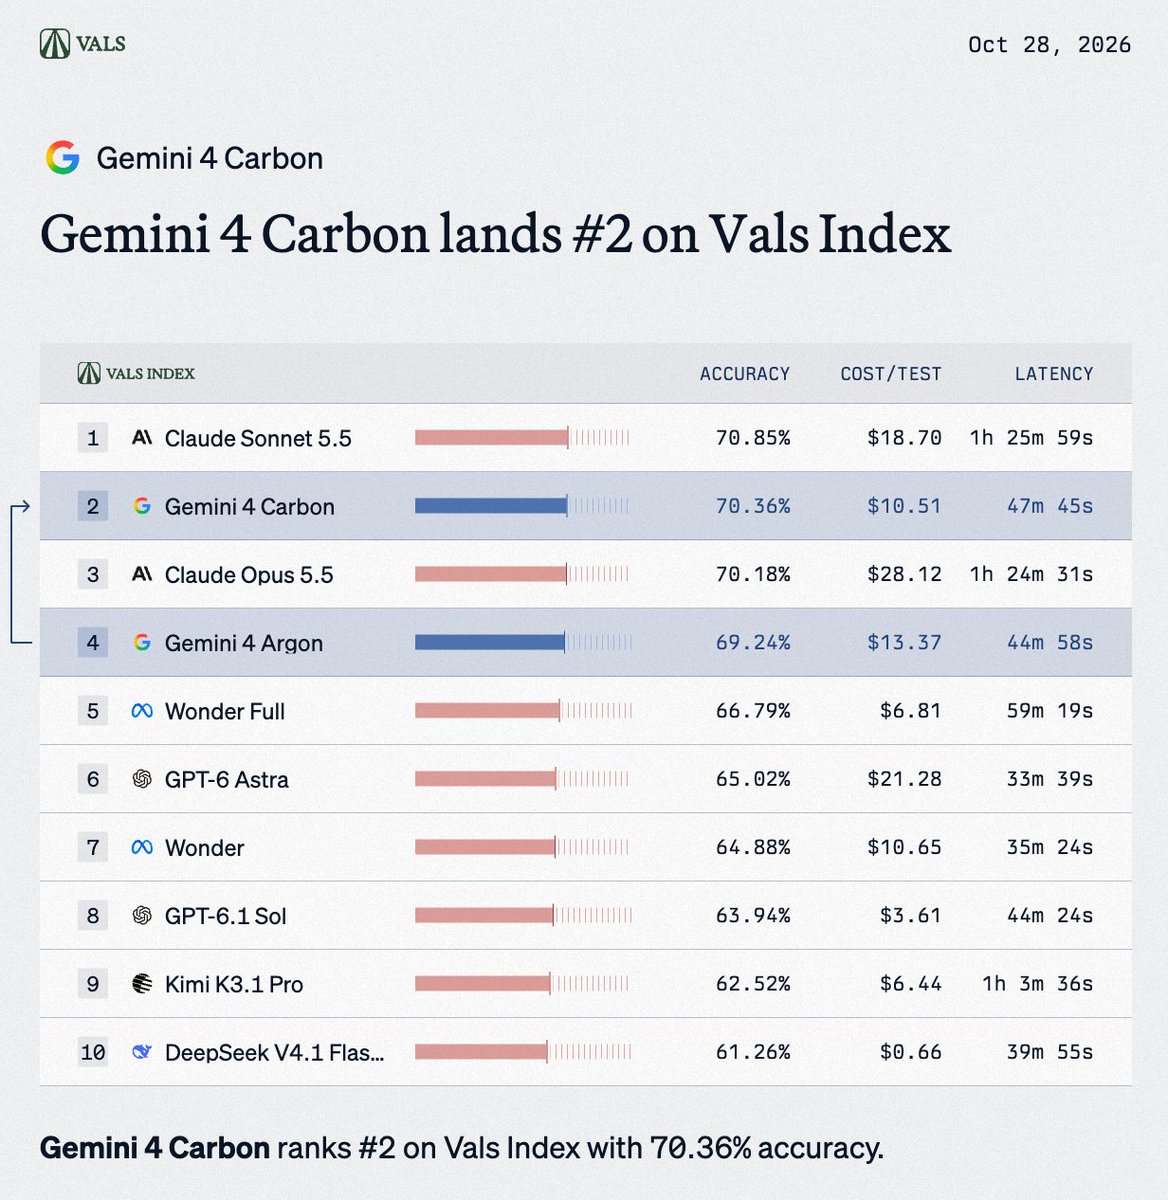
Carbon در شاخص مالی و معیار پژوهش حقوقی Vals.ai نیز رتبه نخست را کسب کرده است. در پژوهش حقوقی، Vals AI گزارش داده که Carbon در مقایسه با Argon حدود ۴۵ درصد منابع بیشتری را ارجاع داده، بیشتر از ابزارها استفاده کرده و پاسخهای طولانیتری تولید کرده است.
بااینحال، انجام وظایف در معیار عامل مالی و مالیاتی بیش از دو برابر زمان موردنیاز Argon طول میکشد و Carbon در پژوهش حقوقی بهطور متوسط برای هر وظیفه بیش از ۵۰ دقیقه زمان صرف میکند. این مدل در مقایسه با Argon، ۲٫۳ برابر توکن استدلالی و ۶۴ درصد توکن خروجی بیشتری تولید میکند؛ بااینحال، تعداد توکنهای خروجی آن هنوز کمتر از نصف میزان تولیدشده توسط Sonnet 5.5 و Opus 5.5 است.
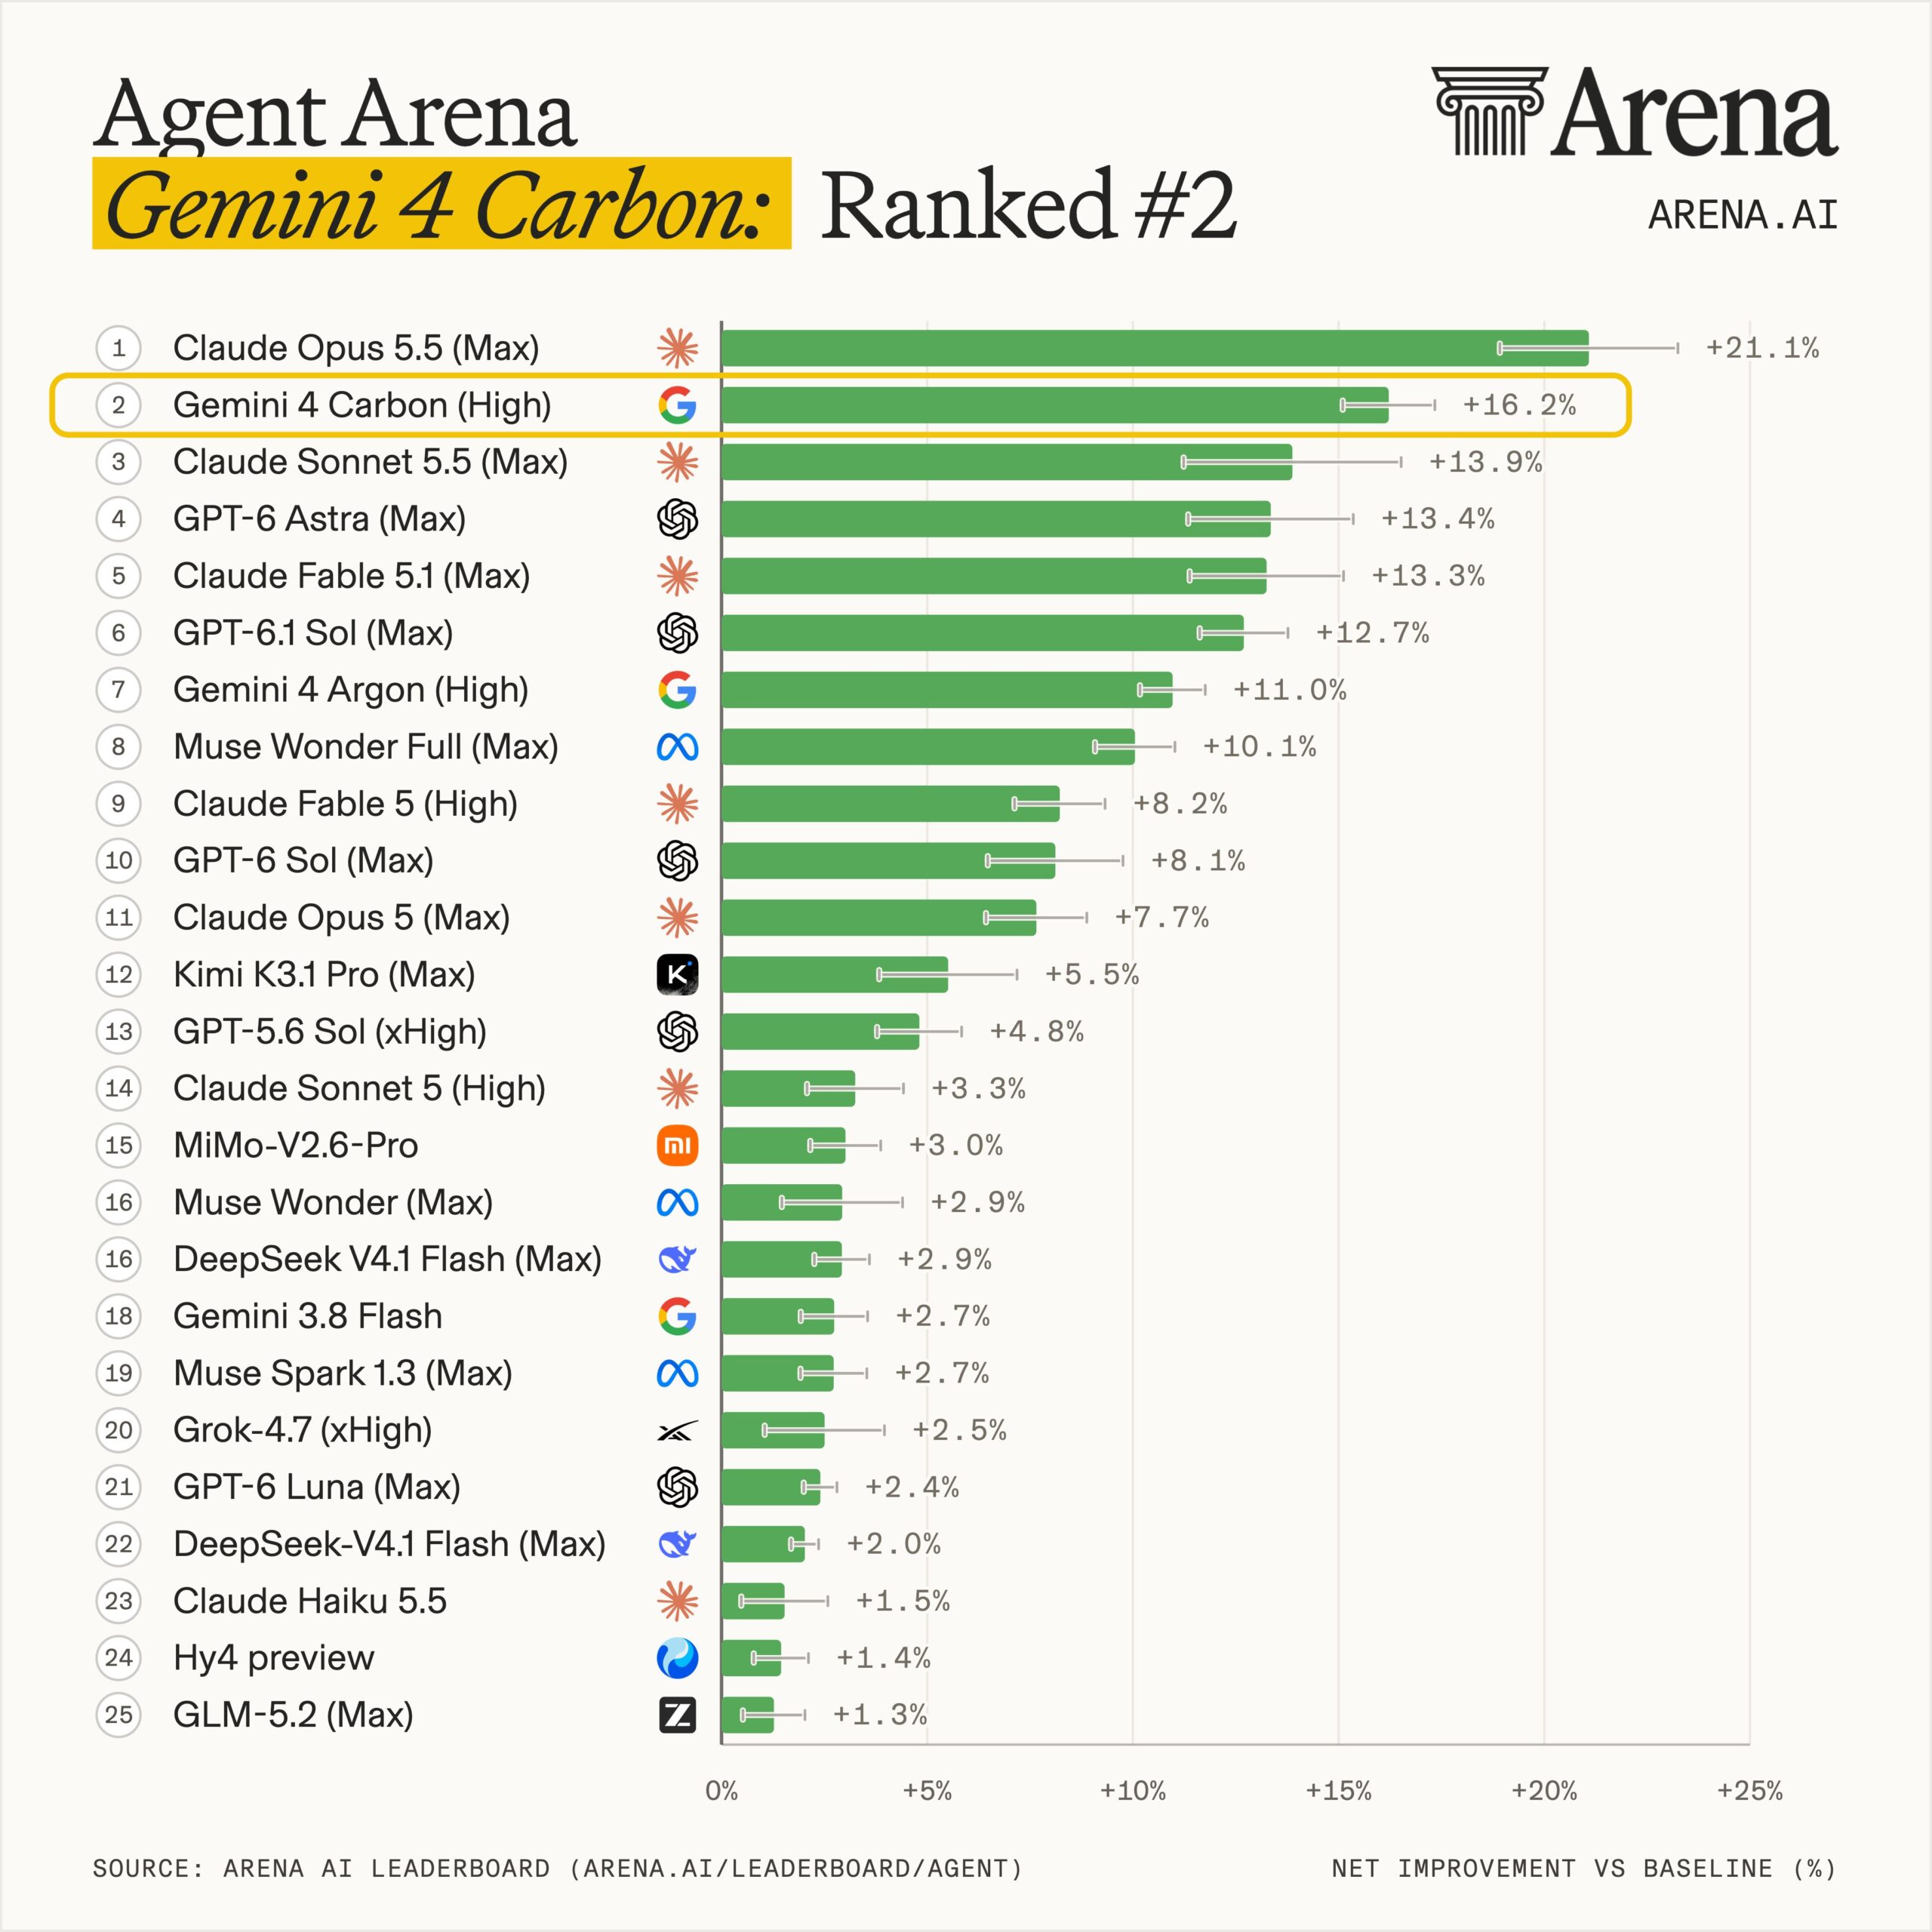
در Arena.ai، نسخه high مدل Gemini 4 Carbon با ۱۵۲۸ امتیاز در صدر Text Arena قرار گرفته و اندکی از Argon با ۱۵۲۰ امتیاز پیشی گرفته است. در Agent Arena، این مدل بر اساس بیش از ۲۱۹۰۰ جلسه واقعی در جایگاه دوم قرار دارد و بالاتر از GPT-6 Astra و Fable-5.1 است. عملکرد خالص آن ۱۶٫۲ درصد بهبود یافته و بالاترین امتیاز هدایتپذیری را با رشد ۱۸٫۶ درصدی به دست آورده است. هزینه میانه هر وظیفه برای این مدل ۱٫۸۰ دلار است؛ رقمی که ۷۲ درصد کمتر از هزینه مدل Claude Opus 5.5 در سطح max، یعنی رتبه نخست این مقایسه، است.
در بخش WebDev از Code Arena، امتیاز Carbon به ۱۷۶۸ رسیده است؛ ۸۹ امتیاز بیشتر از Argon که در جایگاه یازدهم قرار دارد. Carbon در مجموع چهارم است و تنها دو امتیاز با Claude Sonnet 5.5 در سطح xHigh، با امتیاز ۱۷۷۰، فاصله دارد. به این ترتیب، این مدل در هر سه حوزه ارزیابیشده در منحنی پارتو قرار میگیرد.
پیشتازی Carbon در آزمونهای امنیتی بدون محدودیتهای حفاظتی
گوگل چند آزمون امنیتی را با مدلی انجام داده است که سازوکارهای حفاظتی ایمنی آن غیرفعال بودهاند. Carbon در SEC-bench Pro، معیاری برای سنجش کشف خودکار آسیبپذیریها در نرمافزارهای دنیای واقعی، امتیاز ۸۸٫۲ درصد را کسب کرده و در میان تمام مدلهای آزمایششده رتبه نخست را به دست آورده است. این مدل در ExploitGym، که توانایی تبدیل آسیبپذیریهای کشفشده به اکسپلویتهای عملیاتی را میسنجد، به امتیاز ۵۴٫۸ درصد رسیده است. Carbon همچنین در آزمون CWE-Bench برای نوشتن اصلاحیههای امنیتی با فاصلهای چشمگیر در جایگاه نخست قرار دارد.
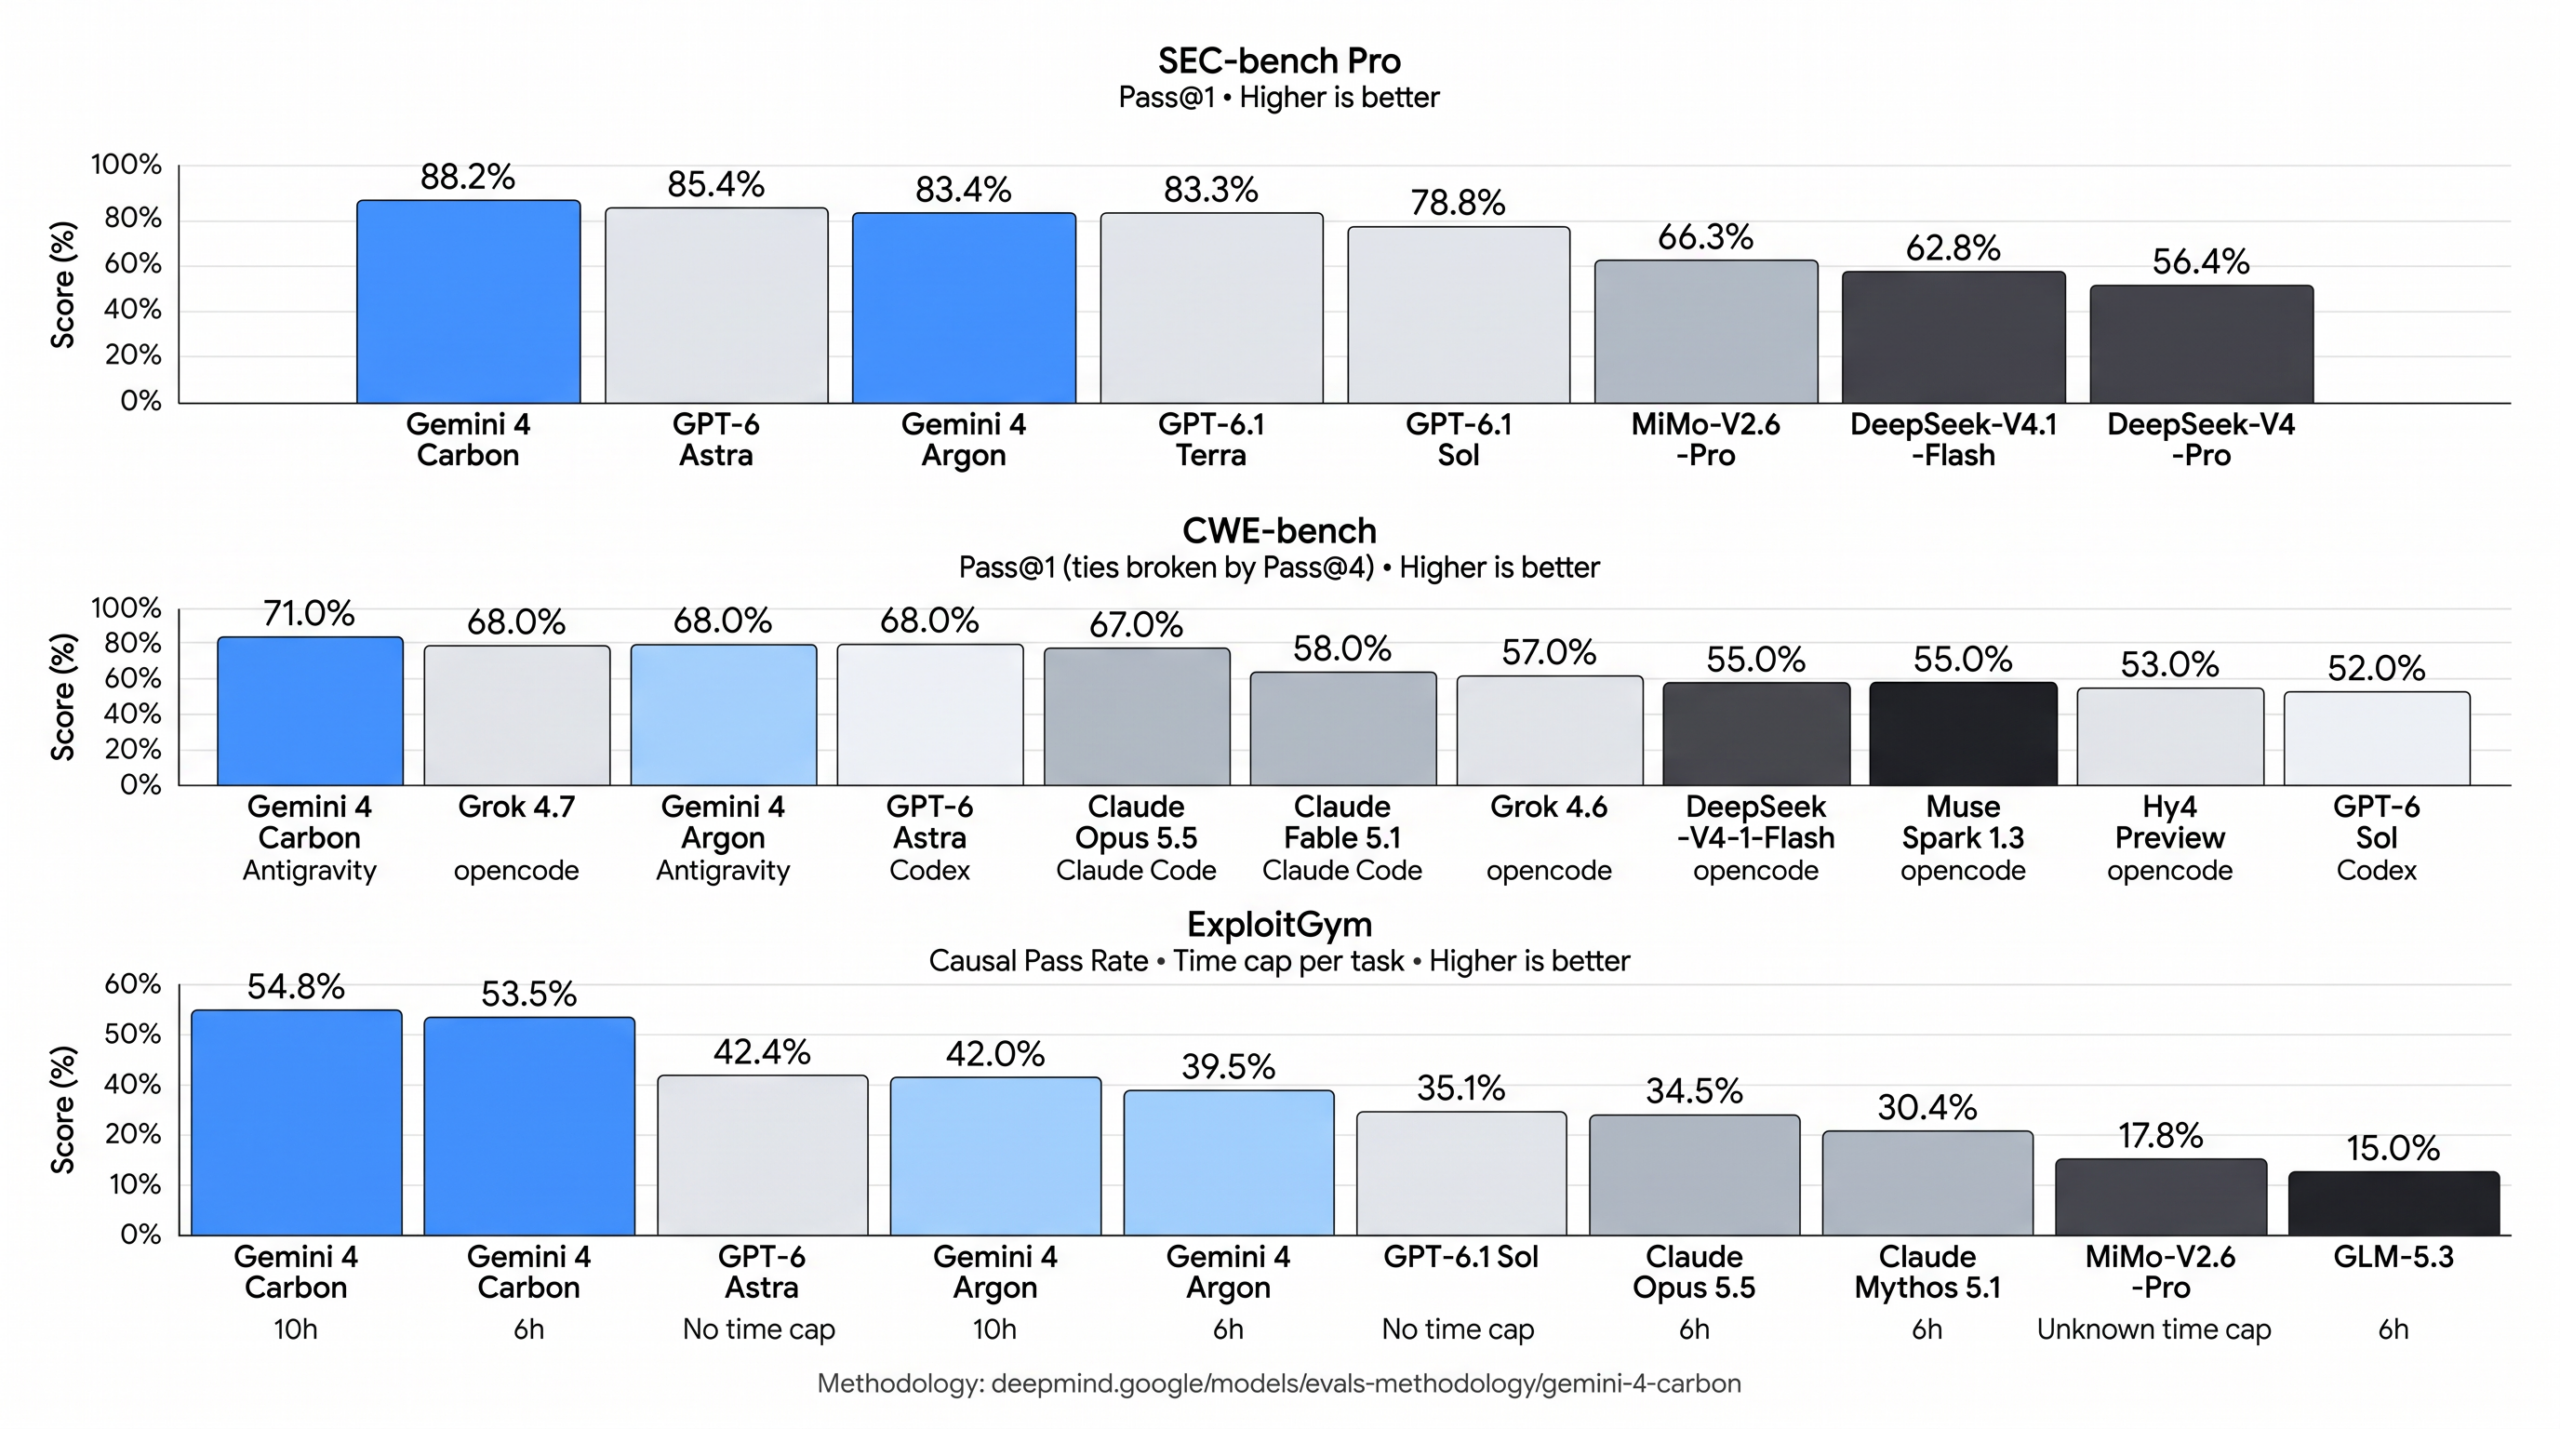
گوگل همچنین به نتایج آزمایشهای داخلی خود استناد میکند که امکان راستیآزمایی مستقل آنها وجود ندارد. بنا بر گزارش این شرکت، Carbon در آزمونهای داخلی بیش از دو برابر Argon کد امن تولید میکند. همچنین، در آزمایشهای تیم Chrome گوگل، عملکرد این مدل در نوشتن اصلاحیههای امنیتی بیش از ۱۰ برابر بهتر از مدل پیشرفته یک رقیب نامشخص بوده است.
دسترسی اولیه برای متخصصان امنیتی
گوگل عرضه Carbon را بهصورت تدریجی انجام میدهد و با استناد به قابلیتهای پیشرفته امنیتی آن، در فرایند ارزیابی پیش از عرضه دولت ایالات متحده مشارکت میکند. از همین هفته، دسترسی به این مدل ابتدا در اختیار گروهی منتخب از متخصصان امنیت سایبری قرار میگیرد. پس از آن، دسترسی از طریق برنامه Fairwind گوگل دیپمایند به شرکای مورداعتماد بیشتری گسترش خواهد یافت.
این شرکت قصد دارد پس از دریافت بازخوردهای بیشتر و تنظیم سازوکارهای حفاظتی ایمنی، مدل را از طریق رابطهای محصولات خود در اختیار توسعهدهندگان، کسبوکارها و کاربران عادی قرار دهد.
Gemini 4 Carbon با همان قیمت اولیه Argon عرضه میشود: ۲ دلار بهازای هر یک میلیون توکن ورودی و ۱۰ دلار بهازای هر یک میلیون توکن خروجی. توکنهای ورودی ذخیرهشده در حافظه نهان نیز از تخفیف ۹۵ درصدی نسبت به قیمت عادی توکنهای ورودی برخوردارند.
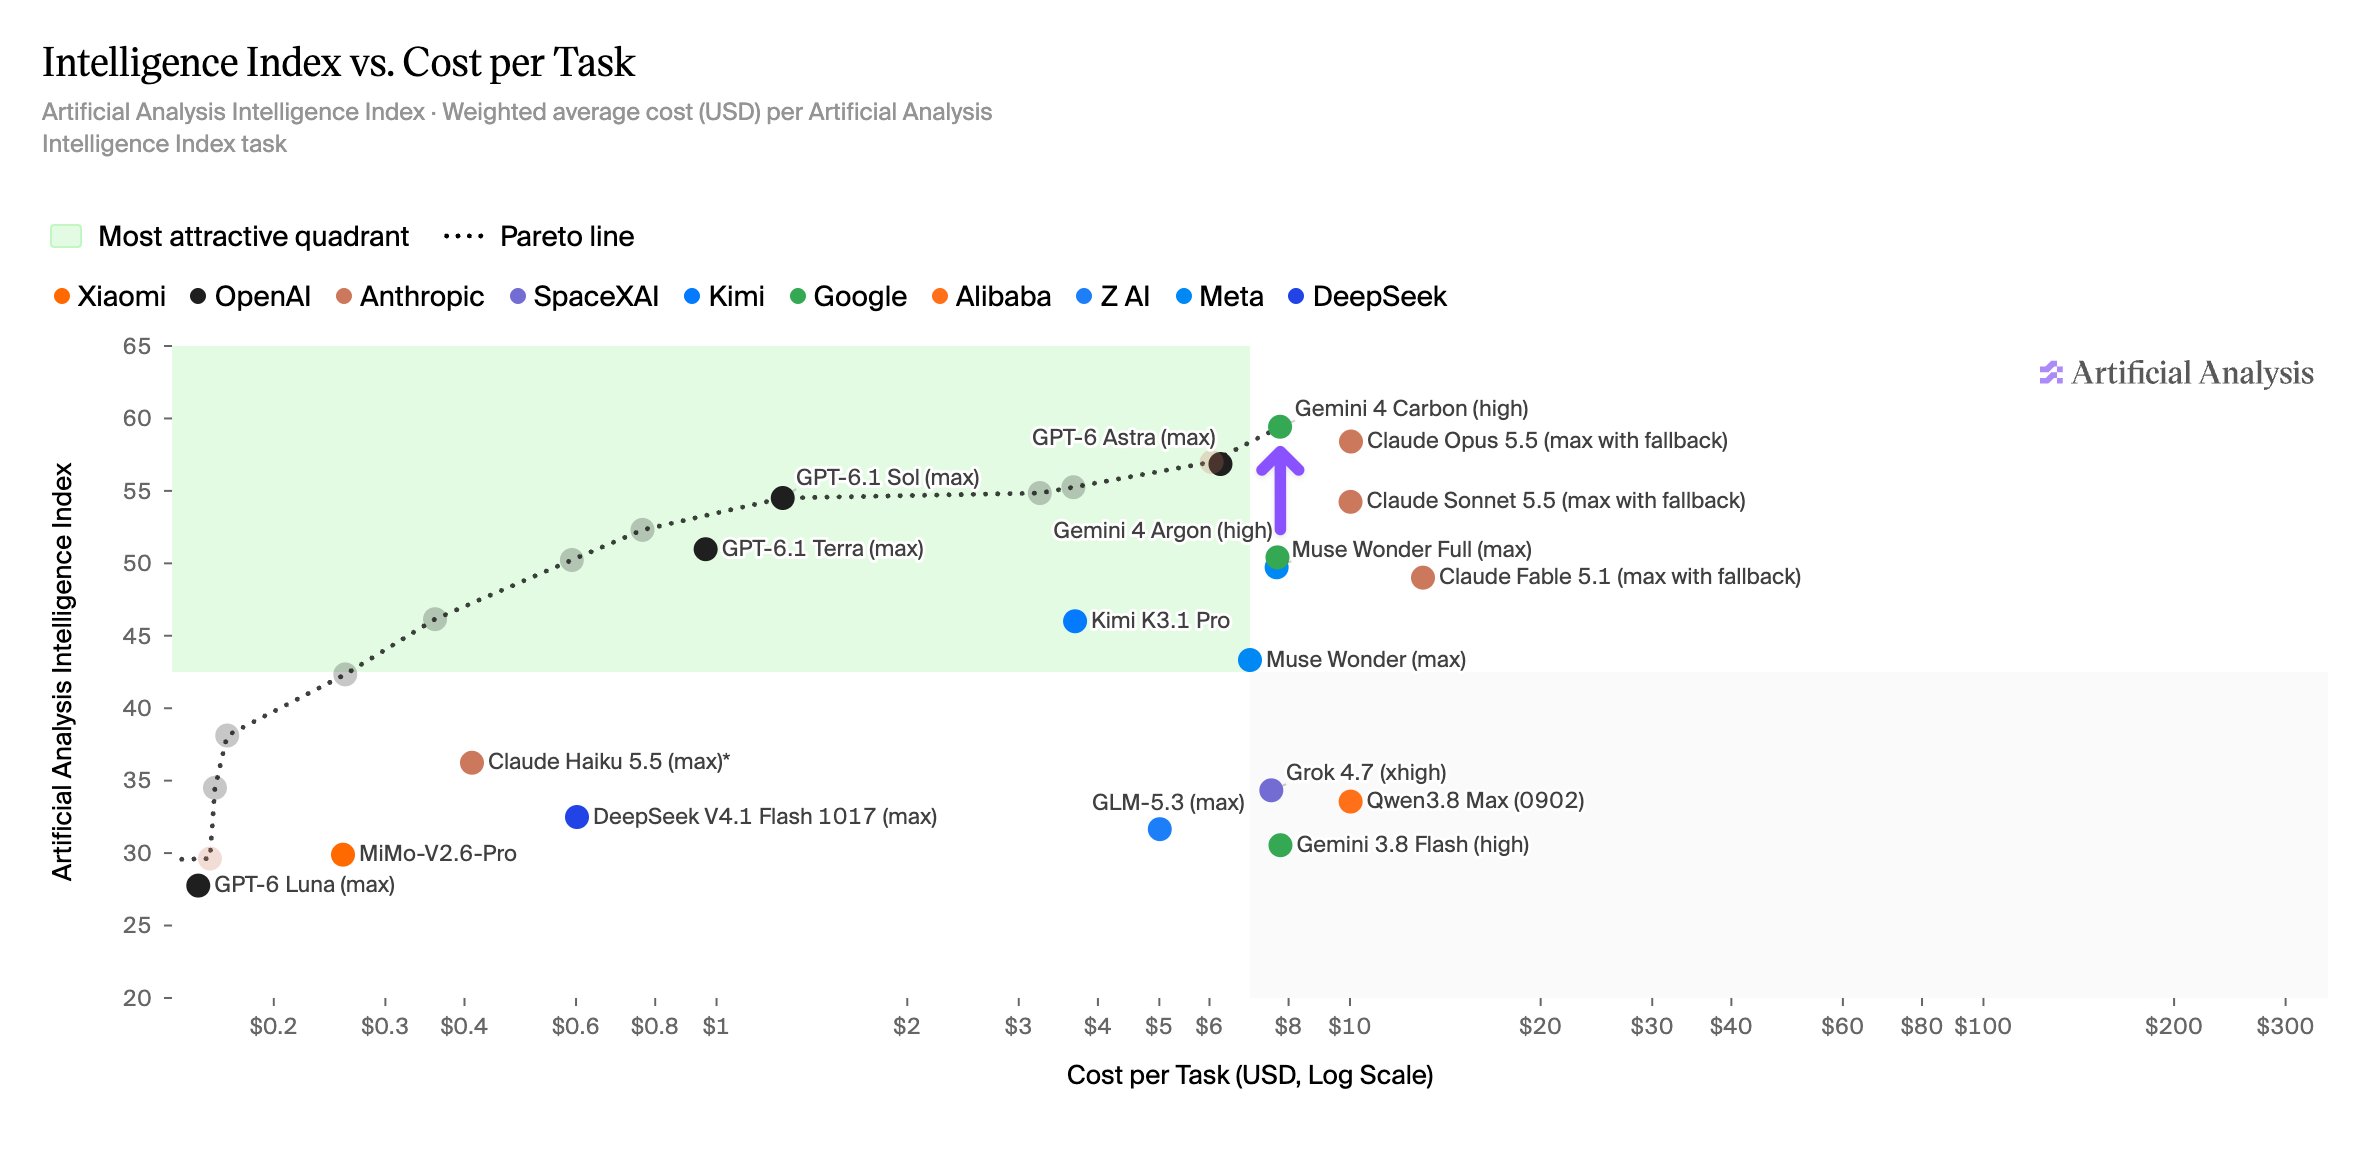
هزینه هر وظیفه Carbon در شاخص هوش Artificial Analysis برابر با ۷٫۷۶ دلار است؛ حدود ۲۳ درصد کمتر از Claude Opus 5.5 در سطح max با هزینه ۱۰٫۰۴ دلار و تقریباً ۱٫۲ برابر هزینه GPT-6 Astra در سطح max با هزینه ۶٫۲۵ دلار. Carbon بهطور متوسط برای هر وظیفه ۱۲۳ هزار توکن خروجی تولید میکند که ۲۹ درصد کمتر از ۱۷۳ هزار توکن مدل Anthropic است. هزینه آن نیز تقریباً با Argon، با رقم ۷٫۶۸ دلار، برابری میکند.
Artificial Analysis محاسبات خود را بر مبنای قیمت فهرست عادی، یعنی ۴ دلار بهازای هر یک میلیون توکن ورودی و ۲۰ دلار بهازای هر یک میلیون توکن خروجی، بهعلاوه ۰٫۲۰ دلار برای هر یک میلیون توکن ورودی ذخیرهشده در حافظه نهان، انجام میدهد. در این محاسبات، تخفیف معرفی ۵۰ درصدی فعلی که تا پایان سال ۲۰۲۶ ادامه دارد، لحاظ نشده است.